上周同事小周接了个活:一个数据处理脚本要跑十几秒,领导嫌慢。小周网上搜了一圈“python 提速”,学了个大招——开线程池。他把主逻辑拆成了 8 份,信心满满地按下运行键,然后表情逐渐凝固:不但没快,反而比原来还慢了一点。
他跑来问我,我说你先去了解一下 GIL。他说:我知道啊,全局解释器锁,面试背过。那你告诉我,它锁的到底是什么?为什么锁了它还能开多线程?为什么有的多线程能快 20 倍?为什么有了 GIL 还要加锁?
他一个都答不上来。很正常,这三个问题就是 GIL 的全部迷惑点。这篇我不打算背概念,直接上实测代码,把这口锅掰开看看里面装的是什么。
1、GIL 到底是什么:一张全工地唯一的通行证
GIL(Global Interpreter Lock,全局解释器锁)是 CPython 解释器里的一把锁。规则简单粗暴:一个进程里,任何时刻只允许一个线程执行 python 字节码。想执行,先抢到这把锁。
可以把 CPython 想成一个工地,线程是想进场的工人,GIL 就是入口闸机上唯一的一张通行证。你 CPU 有 16 个核、开了 8 个线程都没用——工地每次只放一个人进去干活,其他人排着。
这张图就是它的样子:
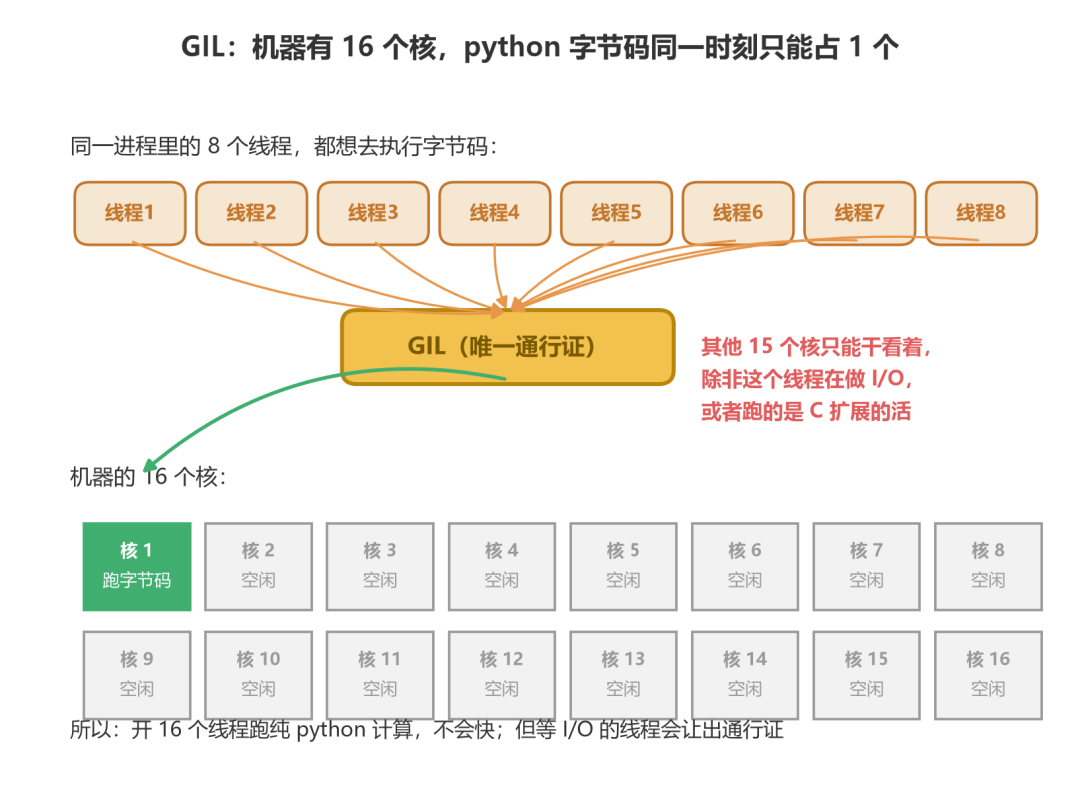
有人会问:那 python 开多线程还有什么意义?问得好,这正是 GIL 最迷惑的地方——这张通行证是会被主动交出来的。往下看。
2、实测第一刀:纯计算,多线程确实白开
先看 CPU 密集的场景。任务是数到 2000 万,总工作量固定,分别用 1、2、8、16 个线程干(Python 3.13,16 核机器,预热后取多次最小值):
import threading, time

def count(n):
    i = 0
    while i < n:
        i += 1

N = 20_000_000
# 1 个线程
t0 = time.perf_counter()
count(N)
print(time.perf_counter() - t0)      # 0.51 s

# 8 个线程,每人分 1/8 的活
ths = [threading.Thread(target=count, args=(N // 8,)) for _ in range(8)]
t0 = time.perf_counter()
for t in ths: t.start()
for t in ths: t.join()
print(time.perf_counter() - t0)      # 0.54 s
实测结果:
| 线程数 |
耗时 |
相对单线程 |
| 1 |
0.51 s |
1.00x |
| 2 |
0.53 s |
0.95x |
| 8 |
0.54 s |
0.94x |
| 16 |
0.57 s |
0.89x |
总工作量完全相同,线程翻 16 倍,耗时纹丝不动,甚至慢了 11%——多出来的时间就是 16 个线程排队换通行证的开销。小周的翻车现场,原理就在这张表里。
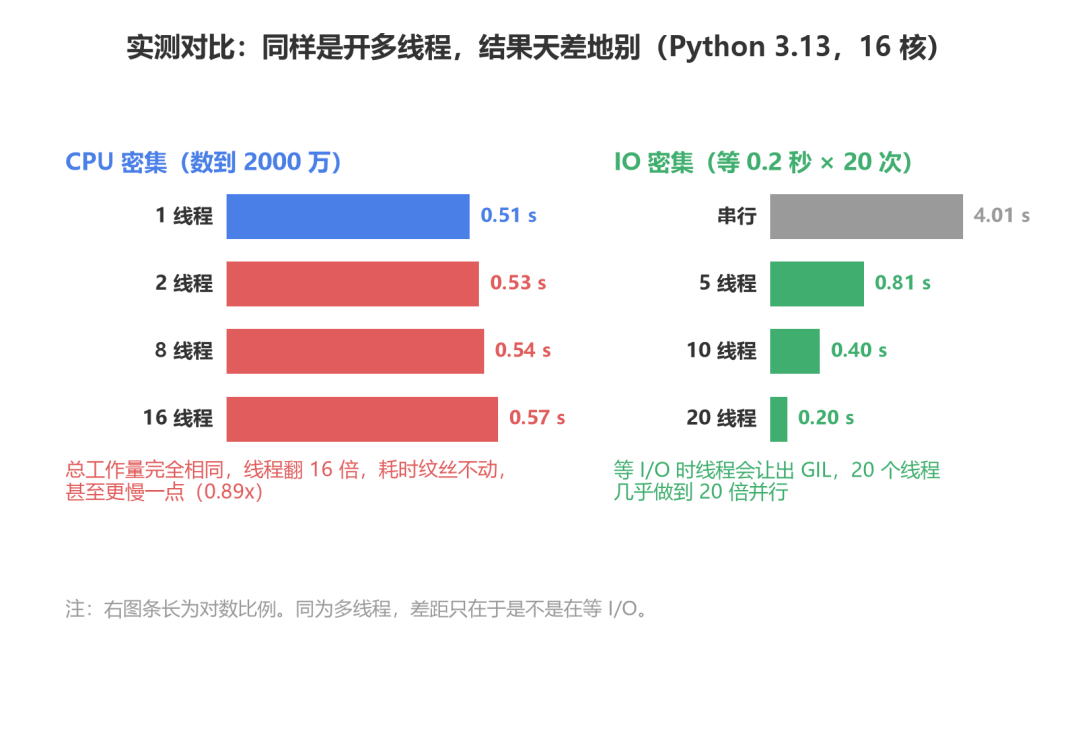
3、实测第二刀:等 I/O 的时候,多线程快 20 倍
先别急着骂 GIL,看另一个实验。任务改成“等 0.2 秒”(模拟等一次网络请求、等一次磁盘读写),连做 20 次:
import time
from concurrent.futures import ThreadPoolExecutor

def io_task(_):
    time.sleep(0.2)        # 模拟等接口

t0 = time.perf_counter()
for _ in range(20):
    io_task(0)
print(time.perf_counter() - t0)      # 4.01 s

with ThreadPoolExecutor(max_workers=20) as ex:
    t0 = time.perf_counter()
    list(ex.map(io_task, range(20)))
print(time.perf_counter() - t0)  # 0.20 s
| 方式 |
耗时 |
提速 |
| 串行 20 次 |
4.01 s |
1.0x |
| 5 线程 |
0.81 s |
5.0x |
| 10 线程 |
0.40 s |
10.0x |
| 20 线程 |
0.20 s |
19.6x |
同样是多线程,一个白开,一个快 20 倍。差别只有一条:任务是在算,还是在等。
4、通行证什么时候会让出来
秘密在于:线程在两种情况下会主动把 GIL 交出去。
第一种:遇到 I/O。 执行网络请求、读写文件、time.sleep 这类操作时,线程知道自己反正要干等,就把 GIL 放出去给别人用。等它等完了,再重新排队抢锁。所以 20 个“纯等待”的线程能几乎完美并行——它们互相之间根本不抢 CPU,抢的是“谁在等”的顺序。
▲ 等复印机出纸的功夫,先把通行证递给下一位——这就是 python 多线程在 I/O 场景下的工作方式
第二种:跑满一个时间片。 就算线程一直在算,它也不能占着锁不放。CPython 给了个切换间隔,默认 5 毫秒:
import sys
print(sys.getswitchinterval())   # 0.005,单位秒
到点没让,解释器会强制它把 GIL 交出来轮换。这个间隔可以调,调小会怎样?实测(4 线程数 2000 万):
sys.setswitchinterval(0.0001)   # 切换勤快 50 倍
# 4 线程耗时 0.63 s
sys.setswitchinterval(0.05)     # 切换懒散 10 倍
# 4 线程耗时 0.51 s
切换越勤,交接成本越高,慢了 22%。所以别手痒去调这个参数,默认值是权衡过的。
另外还有个例外:用 C 写的活会放开 GIL。下一节单独说。
5、C 扩展是“编外人员”,不归闸机管
GIL 只管 python 字节码。如果线程跑进了 C 扩展的代码里——比如 hashlib 算哈希、zlib 压缩、numpy 做矩阵运算——很多库会在进 C 代码前主动把 GIL 放掉,算完再拿回来。这时候多线程是真能吃满多核的。
import hashlib
from concurrent.futures import ThreadPoolExecutor

data = b"x" * 2_000_000

def digest(_):
    return hashlib.sha256(data).hexdigest()

t0 = time.perf_counter()
for _ in range(40):
    digest(0)
print(time.perf_counter() - t0)          # 串行 0.135 s

with ThreadPoolExecutor(max_workers=8) as ex:
    t0 = time.perf_counter()
    list(ex.map(digest, range(40)))
print(time.perf_counter() - t0)      # 8 线程 0.021 s
实测:2 线程 2.0x,4 线程 3.96x,8 线程 6.52x。同样的线程池,数数白开,算哈希真香。zlib 压缩也一样,4 线程 3.91x。
numpy 用起来更快,不过有个细节:它底层的 BLAS 库自己就会开多核,所以有时你单线程跑 numpy 就已经把 CPU 吃满了,再加线程反而不快。
6、有 GIL,还要不要加锁?要
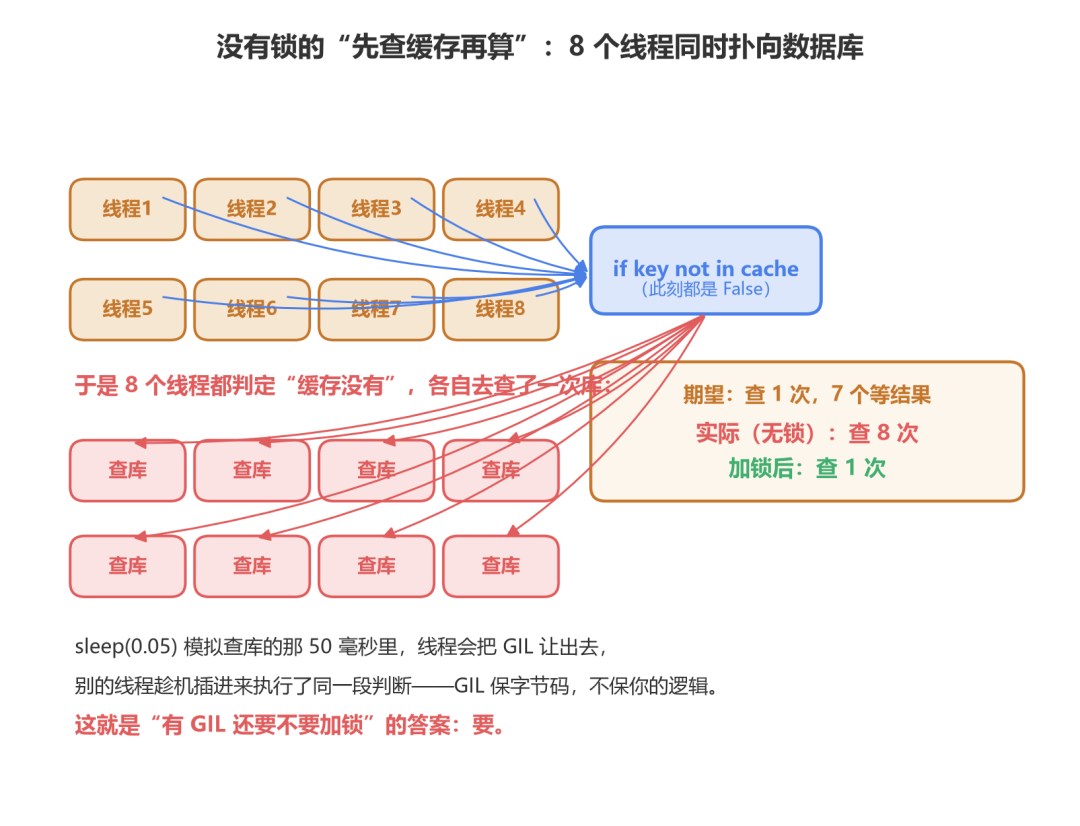
这是 GIL 最大的谣言:“反正同一时刻只有一个线程在跑,我就不用加锁了。”看一个真实的小场景——带缓存的查询函数:
import threading, time

cache = {}
real_hits = 0

def get_user(uid):
    """查一次'昂贵'的数据,然后缓存起来"""
    global real_hits
    if uid not in cache:        # 先查缓存
        time.sleep(0.05)        # 模拟查数据库要 50 毫秒
        cache[uid] = f"用户{uid}"
        real_hits += 1          # 记录真实查询次数
    return cache[uid]

ths = [threading.Thread(target=get_user, args=("1001",)) for _ in range(8)]
for t in ths: t.start()
for t in ths: t.join()
print(real_hits)                # 8
8 个线程同时查同一个用户,期望只查 1 次库,实际查了 8 次。原因看时序:第一个线程查到 uid not in cache 为真后,进 sleep(0.05) 等“数据库”——等待时它把 GIL 让了出去,于是剩下 7 个线程趁机插进来,每一个都执行了同一段判断,每一个都去查了库。这就是缓存击穿。
给判断和写入套上一把锁,就只查 1 次了:
lock = threading.Lock()

def get_user_safe(uid):
    with lock:                  # 判断和写入必须一起完成
        if uid not in cache:
            time.sleep(0.05)
            cache[uid] = f"用户{uid}"
            real_hits += 1
    return cache[uid]
顺带说个有意思的实测结果:上面 real_hits += 1 这种纯计算的自增,我在 3.13 上让 8 个线程各加 50 万次,跑了 400 万次一次都没丢。因为 CPython 只在特定指令边界切换线程,+= 编译出来的一小段字节码恰好不会被从中间打断。但这属于“实现恰好没坑”,不是“语言保证安全”——只要临界区里出现一次 I/O 或函数调用,交错就来了。锁该加还是得加。
7、真要吃满多核,有四条路
第一条:多进程。 每个进程有自己独立的解释器、独立的一把 GIL,互不干涉:
from concurrent.futures import ProcessPoolExecutor

# 总工作量 2 亿
t0 = time.perf_counter()
count(200_000_000)
print(time.perf_counter() - t0)          # 单线程 5.29 s

with ProcessPoolExecutor(max_workers=4) as ex:
    t0 = time.perf_counter()
    list(ex.map(count, [50_000_000] * 4))
print(time.perf_counter() - t0)      # 4 进程 2.17 s
4 个进程提速 2.43 倍——不是理想的 4 倍,因为进程的创建和通信都有成本(Windows 上尤其明显),任务越大越划算。注意 Windows 下多进程代码必须写在 if __name__ == "__main__": 里面,这个坑以前专门写过。
▲ 多进程:四张工作台、四套工具、四个独立的解释器,谁也不等谁
第二条:把重活交给 C 扩展。 hashlib、zlib、numpy 这类库,如上一节实测,多线程直接吃满多核。
第三条:IO 密集换 asyncio。 如果你的活全是等网络,协程比线程更轻,之前那篇协程的文章实测过并发检查网址,可以翻回去看。
第四条:无 GIL 版解释器。 Python 3.13 开始官方提供了实验性的 free-threading 构建(PEP 703),可以去 GIL 运行。可以在代码里查一下自己用的是不是标准版:
import sys
print(sys._is_gil_enabled())   # True = 还有 GIL
我本机是标准构建,返回 True。距离生产环境放心用无 GIL 版本还需要生态跟上,但方向已经定了。
8、一张决策卡
最后把选择逻辑压成几句话:
- 活是纯 python 计算 → 多线程没用(实测 0.89x),用
multiprocessing 开多进程,或者把核心计算换成 numpy 这类 C 库。
- 活在等 I/O(网络、磁盘、数据库) → 线程池随便开,实测接近线性提速;并发量大再考虑 asyncio。
- 多个线程要读写同一份共享数据 → GIL 不保你的业务逻辑,该上
Lock 就上锁,尤其是“先判断再写入”这种两步操作。
- 用了 C 扩展做重活 → 多线程依然有效,它在 C 代码里不归 GIL 管。
总结
GIL 这口锅,拆开就四句话:
- 它是什么:CPython 的全局锁,一个进程同一时刻只放一个线程跑字节码——16 个核只干看。
- 它什么时候让路:线程等 I/O 时主动让;每 5 毫秒强制轮换;跑进 C 扩展时被库主动放开。
- 它不保护什么:不保护你的业务逻辑。“先查再写”两步之间照样被人插队,锁该加还得加。
- 怎么绕开:CPU 密集用多进程或 C 扩展,IO 密集用线程或协程,激进玩家可以试试 3.13 的 free-threading。
多线程不是不能用,而是要先问一句:我的线程是在算,还是在等? 答案不同,选择完全不同。下次优化前,先跑一遍文中的探针代码,比网上任何“万能提速技巧”都靠谱。如果你也有类似的翻车现场,欢迎去云栈社区一起聊聊。
 发表于 14 小时前
|
查看: 4|
回复: 0


