普通 cache 存在的问题
首先我们不妨思考一下,为什么需要 pending cache?普通 cache 存在什么问题?
普通的 cache 是请求的结果计算出来之后,将它缓存下来,以供下一次相同的请求使用。比如下面这个根据 uid 查询用户信息的逻辑(后文都是基于这个根据 uid 查询用户信息的例子):
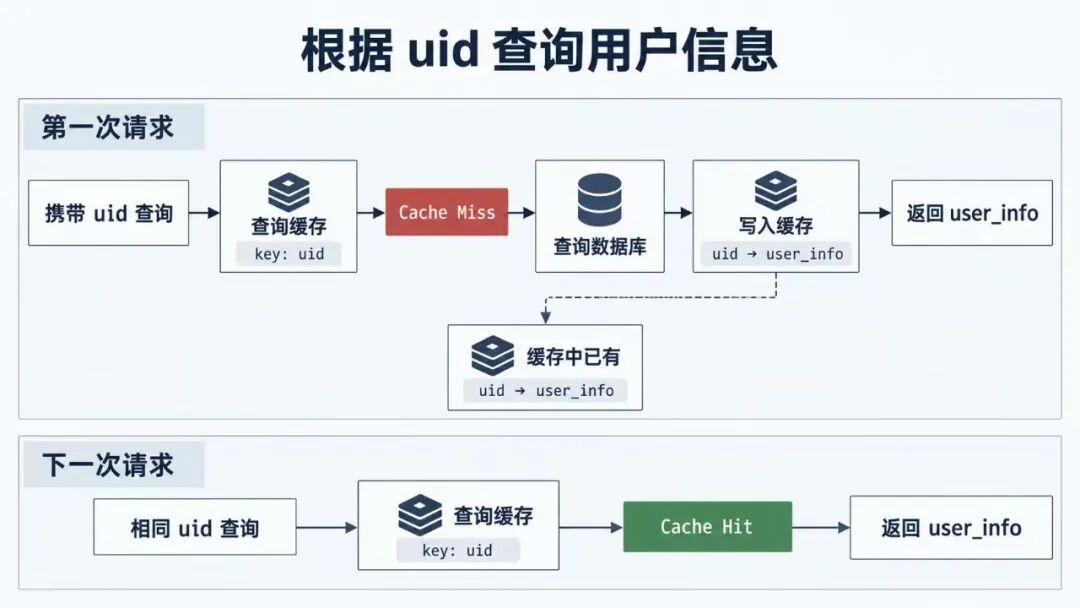
这里存在一个问题——当第一个请求(uid=a)正在查询数据库,但还没有得到结果,此时又来了 100 个请求,查询这个 uid=a 关联的用户信息。由于第一个请求还没有将结果写入缓存,后续请求仍然会看到 Cache Miss,于是所有请求都会一起绕过缓存直接访问数据库,数据库的负载就会变得很高。(面试常问的热点 Key 的缓存击穿问题也可以用 pending cache 解决)
产生上述现象的根源是——普通的 cache 只能知道任务的结果是否存在,无法感知到当前结果是否正在被计算。
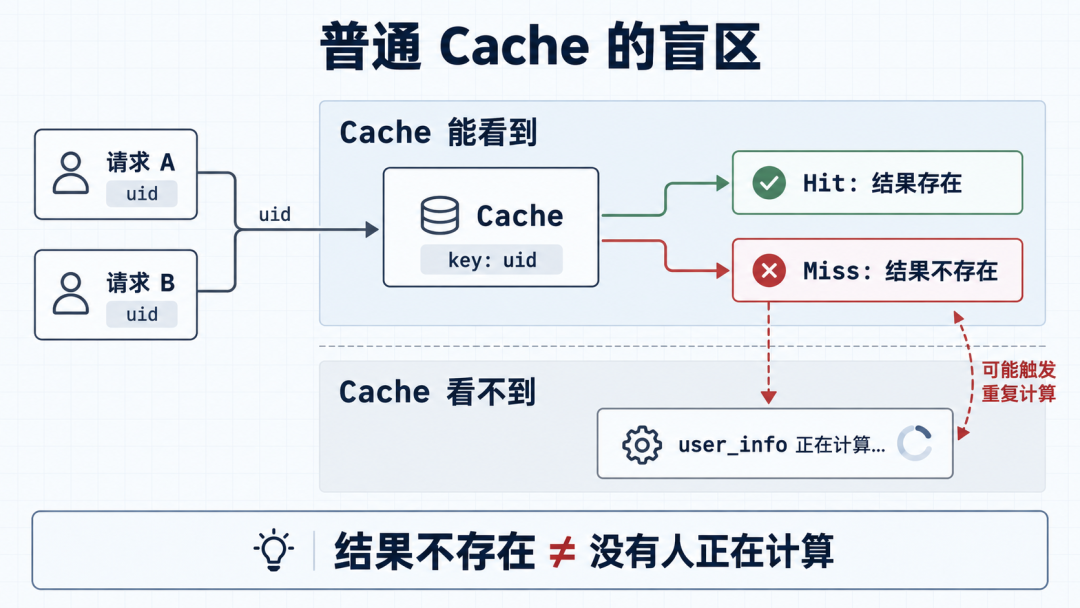
既然问题的根源已经找到了,那么就引出了本文讨论的主角——pending cache。
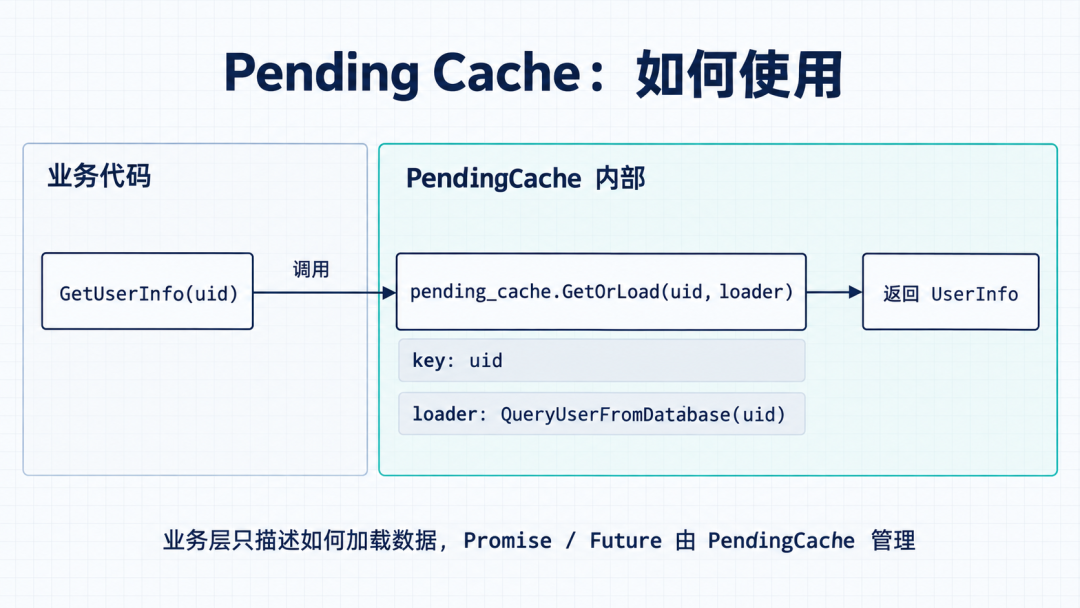
顾名思义,就是只让第一个请求去执行计算,后续相同 uid 的请求都 pending,一直到第一个请求计算完成,所有这些请求都拿着相同的结果返回。
在公开资料中,这种机制更常见的名字是:Request Coalescing、Request Collapsing、In-flight Deduplication、Singleflight。Go 的 singleflight 将它定义为“抑制重复函数调用”的机制。
虽然 Pending Cache 不是一个标准术语,但它很好地表达了这种设计的关键:缓存 Pending 的任务。
实现 pending cache 的思路比较简单,就是在任务开始时往 cache 中插入代表该任务的可等待对象。
因为笔者是写 cpp 的,因此下文会用 cpp 来实现简单的 pending cache。在 cpp 中这个可等待对象可以是 std::shared_future<T>。
std::promise、std::future、std::shared_future 的基本使用
在讲解 pending cache 的具体实现之前,先介绍一下 cpp 标准库中的 std::promise、std::future、std::shared_future。
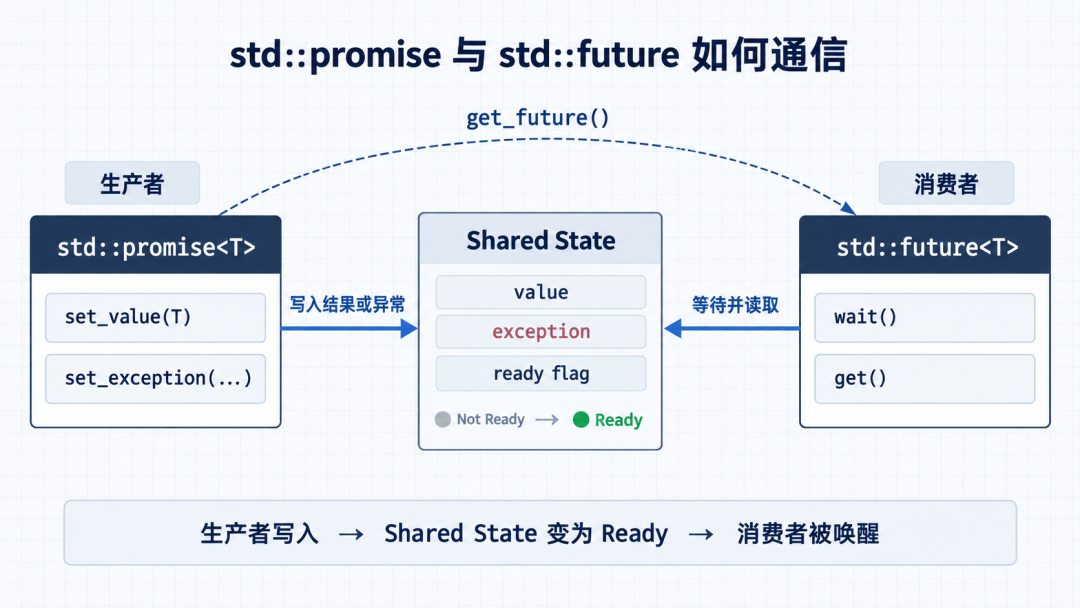
promise 和 future 通常是成对出现的,用来在两个执行单元(线程)之间传递一个未来才会产生的结果。可以简单理解为生产者持有 promise 对象,消费者持有 future 对象,生产者在执行完计算任务之后将结果写入到 promise 中;然后消费者就可以从 future 中拿到关联的 promise 对象中由生产者保存的值。具体的实现原理见下图:
std::future 有两个特性不适合当前 pending cache 这种单生产者多消费者场景:
std::future::get() 获取结果后,该 Future 不再关联共享状态,此时 std::future::valid() 返回 false。再次调用 get() 属于未定义行为(LLVM 在实现的时候实际是:当第一次调用 get 之后,就将共享状态指针置空,第二次调用是在空指针上调用的,是未定义行为)std::future 对象是不可拷贝的对象(拷贝构造函数被 delete 了)。
因此就需要使用到 std::shared_future 类型,可以通过调用 std::future::share() 方法得到。
基本使用例子如下:
#include <iostream>
#include <thread>
#include <future>
#include <chrono>

int main()
{
    std::promise<std::string> prom;
    std::shared_future<std::string> sf = prom.get_future().share();

    std::thread t1([sf] { // 消费者1先拷贝一份
        sf.wait();
        std::cout << "t1: " << sf.get() << "\n";
    });

    std::this_thread::sleep_for(std::chrono::seconds(1));
    prom.set_value("hello"); // 这里生产者去进行 set

    // 关键:set_value 发生之后,过两秒再来一个新线程
    std::this_thread::sleep_for(std::chrono::seconds(2));
    std::thread t2([sf] { // 消费者2现在才拷贝 sf
        std::cout << "t2: " << sf.get() << "\n"; // 立刻返回 "hello",不阻塞
    });

    t1.join();
    t2.join();
}
pending cache 对外暴露的接口分析
在实现 pending cache 之前,我们需要先站在调用方的角度来思考一下:我们希望的好用的 pending cache 是什么样子的?
假设我们需要根据 UID 查询用户信息。调用方并不关心内部使用了 promise、shared_future、mutex,他只希望获得用户信息:UserInfo user = GetUserInfo(uid);。
用户只需要把真正的数据加载逻辑(Loader,这里是查询用户信息的逻辑)和 Key(这里是 uid)一起交给 Pending Cache,就能得到想要的结果了,如下所示:
UserInfo user = pending_cache.GetOrLoad(
    uid,
    [&] {
        return QueryUserFromDatabase(uid);
    }
);
对于调用方来说,这个接口应该具有非常明确的行为:
- 如果相同 UID 的任务正在执行,就等待已有任务;
- 如果相同 UID 的任务不存在,就执行 Loader;
- 相同 UID 的并发请求只执行一次 Loader;
- 不同 UID 的任务可以并发执行;
- Loader 成功时,所有调用方获得相同结果;
- Loader 失败时,所有调用方观察到相同异常;
- 任务结束后,Pending Cache 自动清理内部状态。
如下图所示:
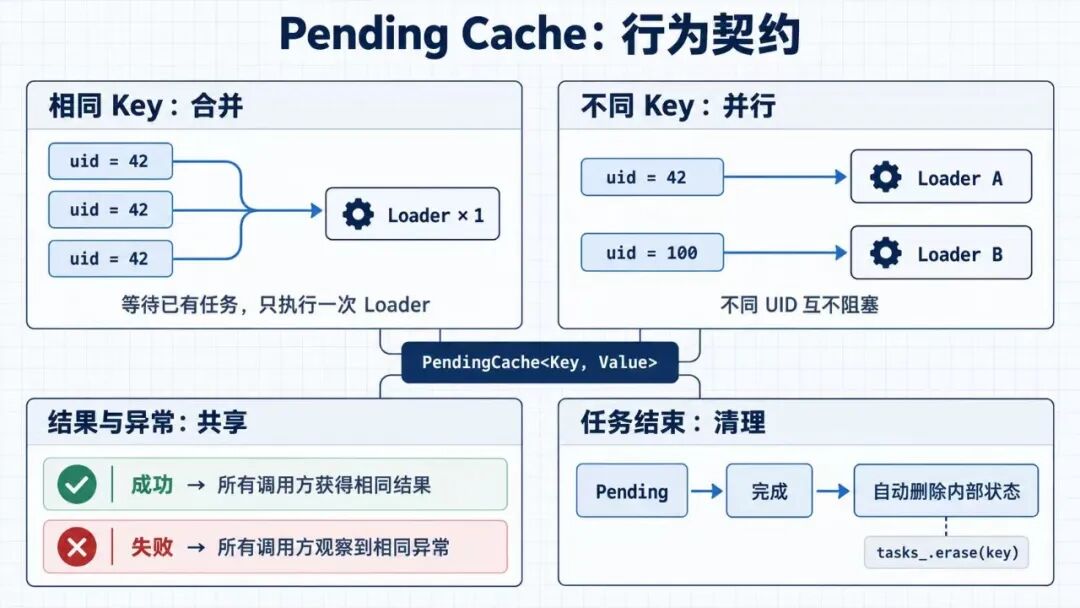
换句话说,调用方只需要提供 Key 和 Loader,然后 pending cache 返回 Loader 的返回值 Value 就可以了。
因此,我们得到的最终接口是:
template<
  typename Key,
  typename Value,
  typename Hash = std::hash<Key>
>
class PendingCache
{
public:
  template<typename Loader>
  Value GetOrLoad(
    const Key& key,
    Loader&& loader
  );
};
有了这份接口契约,我们接下来就需要进行具体的实现了。
简单的 pending cache 实现
前文已经确定,调用方只需要提供 Key 和 Loader:
Value value = pending_cache.GetOrLoad(
    key,
    loader
);
接下来,我们根据这份接口契约,实现一个简单的 Pending Cache。
这个版本只关注最核心的功能:
- 相同 Key 的并发请求只执行一次 Loader;
- 不同 Key 的 Loader 可以并发执行;
- 所有调用方共享 Loader 的结果或异常;
- Loader 执行完成后自动清理内部状态。
这里暂时不考虑 TTL、超时、任务取消和分布式实例之间的协调。
template<
    typename Key,
    typename Value,
    typename Hash = std::hash<Key>
>
class PendingCache
{
private:
    struct State
    {
        std::promise<Value> promise;
        std::shared_future<Value> future;

        State() : future(promise.get_future().share()) {}
    };

public:
    template<typename Loader>
    Value GetOrLoad(
        const Key& key,
        Loader&& loader)
    {
        std::shared_ptr<State> state;
        bool is_leader = false;

        {
            std::lock_guard<std::mutex> lock(mutex_);
            auto it = tasks_.find(key);
            if (it != tasks_.end())
            {
                state = it->second;
            }
            else
            {
                state = std::make_shared<State>();
                tasks_.emplace(key, state);
                is_leader = true;
            }
        }

        // Follower:等待 Leader 的结果
        if (!is_leader)
        {
            return state->future.get();
        }

        // Leader:执行真正的查询
        try
        {
            Value value = std::invoke(std::forward<Loader>(loader));
            state->promise.set_value(value);
            {
                std::lock_guard<std::mutex> lock(mutex_);
                tasks_.erase(key);
            }
            return value;
        }
        catch (...)
        {
            auto error = std::current_exception();
            state->promise.set_exception(error);
            {
                std::lock_guard<std::mutex> lock(mutex_);
                tasks_.erase(key);
            }
            std::rethrow_exception(error);
        }
    }

private:
    std::mutex mutex_;
    std::unordered_map<Key, std::shared_ptr<State>, Hash> tasks_;
};
下面是针对上述实现的,引申出的几个问题的讨论。
Leader 和 Follower 如何协作?
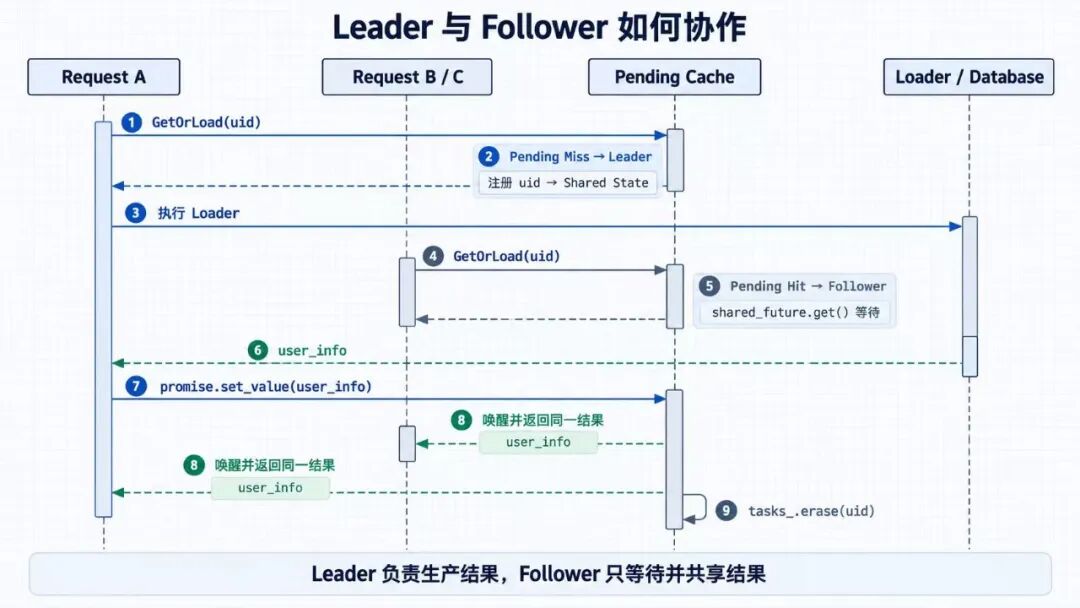
Leader 负责生产结果,Follower 只等待并共享结果。比如某个时间段,服务来了三个请求 A、B、C(uid="42"),请求 A 先到达并率先进入函数 GetOrLoad(),此时 tasks_ 中还没有 "42",因此线程 A 创建一个新的 State,并成为 leader;请求 B、C 后到达,因为 tasks_ 中已经有 "42" 了,因此成为 follower,等待 leader 上的 loader 执行完成。整体流程如下图所示:
为什么 Loader 要在锁外执行?
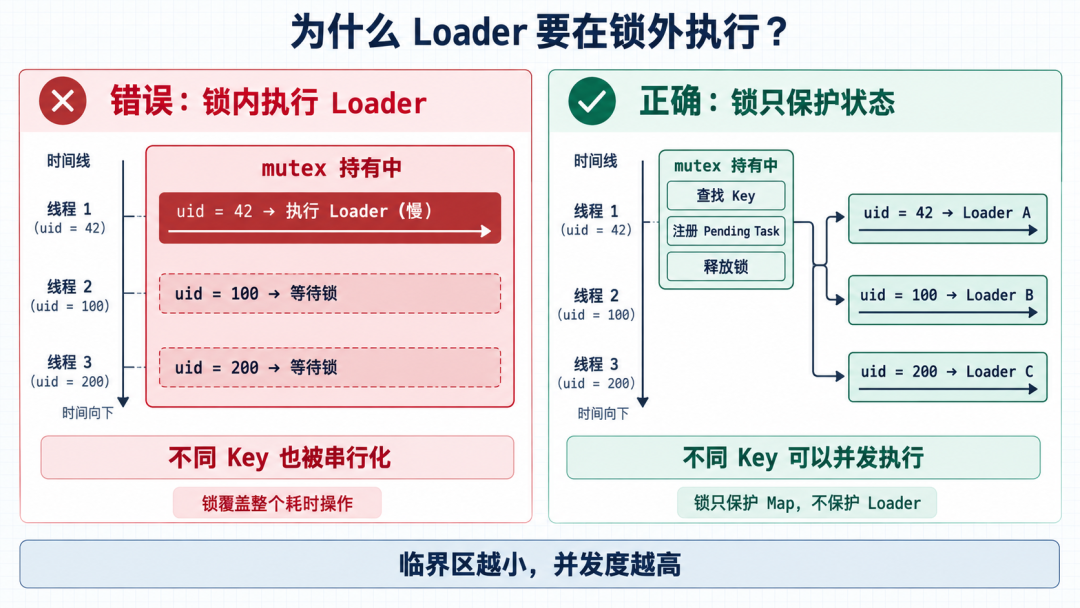
核心原因就是 loader 可能是个比较重的操作,如果在锁范围内执行非常影响性能。并且对于 uid=42 的请求,在执行数据库查询时,如果持有互斥锁,那么也会影响对于不同 uid 的请求查询数据库。我们需要限制的是相同 key 不要重复执行,而不是不同 key 只能串行执行。
如何与普通 Cache 组合?
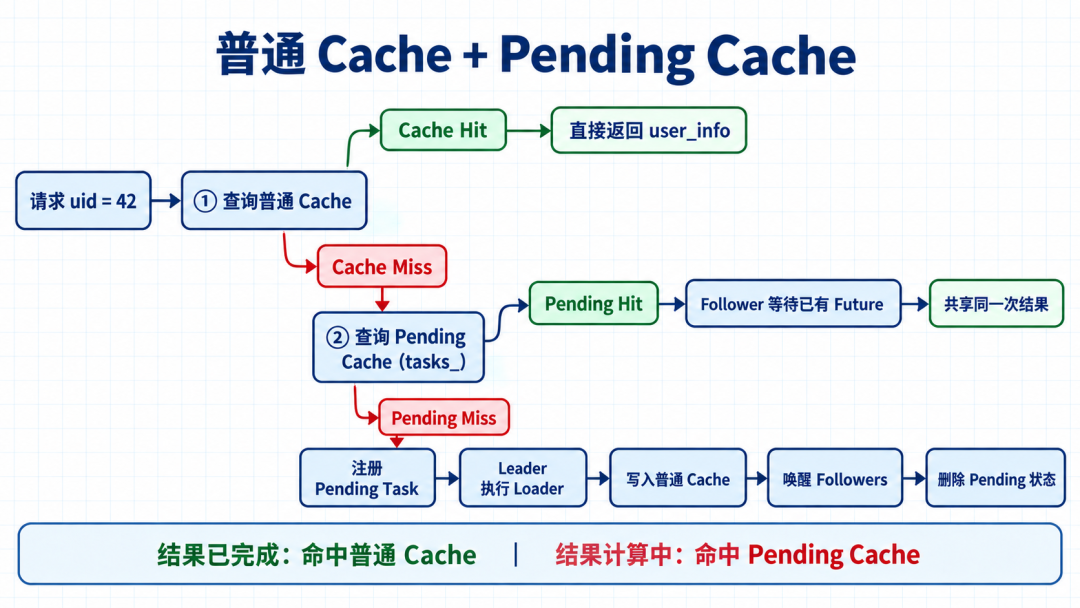
想必读者也注意到了,上述实现只保存正在执行的任务,不负责长期保存已经完成的结果。因此实现上可以在查询 tasks_ 之前,先查询保存任务结果的 result_cache,然后再查询 tasks_,注意并发保护。
总结
普通 Cache 保存的是已经完成的结果:Key → Value
Pending Cache 保存的是正在执行的任务:Key → Future<Value>
它的核心并不复杂:
- 第一个请求创建任务并成为 Leader;
- 后续相同 Key 的请求成为 Follower;
- Follower 通过 Shared Future 等待 Leader;
- Leader 通过 Promise 写入结果或异常;
- 任务完成后删除 Pending 状态。
普通 Cache 解决的是:已经做完的事情,不要再做。
Pending Cache 解决的是:正在做的事情,也不要重复做。
从这个角度看,Pending Cache 与其说是一种传统缓存,不如说是一种按照 Key 组织的并发协调机制。
 发表于 16 小时前
|
查看: 3|
回复: 0


