Google 的 Abseil 和 Meta 的 Folly,两个 C++ 基础库在 GitHub 上合计超过 4.8 万星。这不是为了重造轮子,而是大厂在用实际行动证明:标准库的「通用性」,往往意味着「不够用」。
性能:通用设计的代价
std::unordered_map 在大多数场景下都够用,但当你需要极致的缓存局部性时,它的链表实现会成为瓶颈。Meta 的 Folly 提供了 F14VectorMap,通过开放寻址策略和紧凑的内存布局,在大规模数据集上比 std::unordered_map 快几倍。同样,Google 的 Abseil 中的 flat_hash_map 也走的是类似路线——用连续存储提高缓存命中率,用优化的哈希算法减少重新哈希的开销。
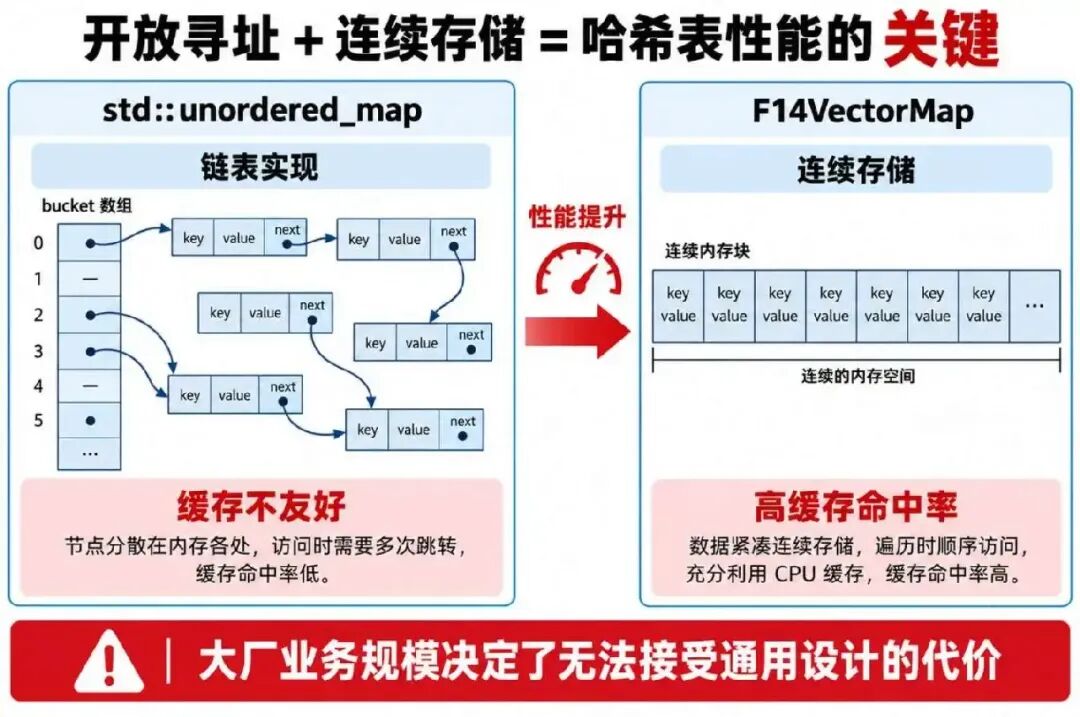
这种差异不是微优化。在服务端高并发场景下,数据结构的性能特征直接决定了资源使用效率。大厂的业务规模决定了它们无法接受 std:: 的「一切为了兼容性让步」。
工程能力:标准库没有的东西
STL 定义了容器和算法,但对「如何写好一个服务」几乎没有提供任何工具。比如:
Folly 的 FBString 采用了协议优化的字符串实现,小字符串直接内联在栈上,大字符串才堆分配,避免了大量短字符串场景下的堆分配开销。Abseil 的 Status 和 StatusOr<T> 封装了错误处理模式,让函数返回值可以明确表达「成功」和「失败」,而不是靠异常或原始指针。Folly 的 Executor 和 Future 框架提供了原子性的异步任务调度,这在 C++20 的 std::future 之前很多年就已经是 Meta 服务器代码的标准配置。
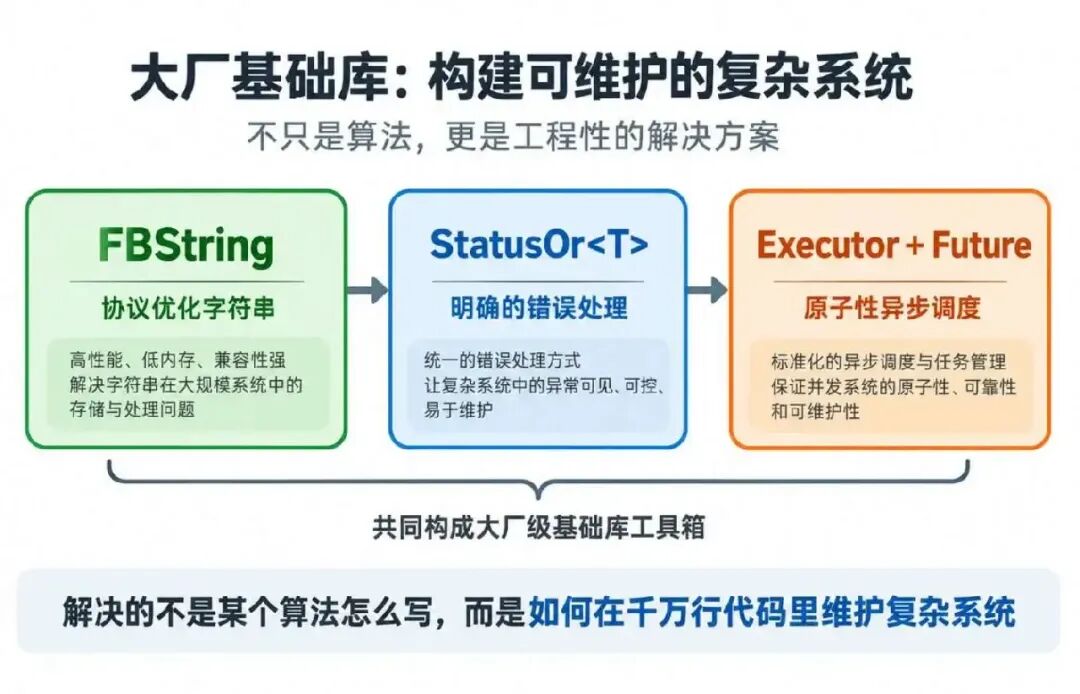
这些组件有一个共同特点:它们解决的不是「某个算法怎么写」,而是「如何在千万行代码里维护复杂系统」。这也是为什么真正做过大规模 C/C++ 工程的人,会更看重基础库的工程化能力,而不只是标准容器和算法。
演进节奏:标准委员会跟不上
C++ 标准的制定是一个慢过程。一项特性从提案到进标准,往往需要多年。C++11 的 std::shared_ptr 很好,但 C++11 是 2011 年发布的。等到 C++17、C++20 逐步补充更多工具时,大厂早已经在生产环境中磨合出了自己的方案。
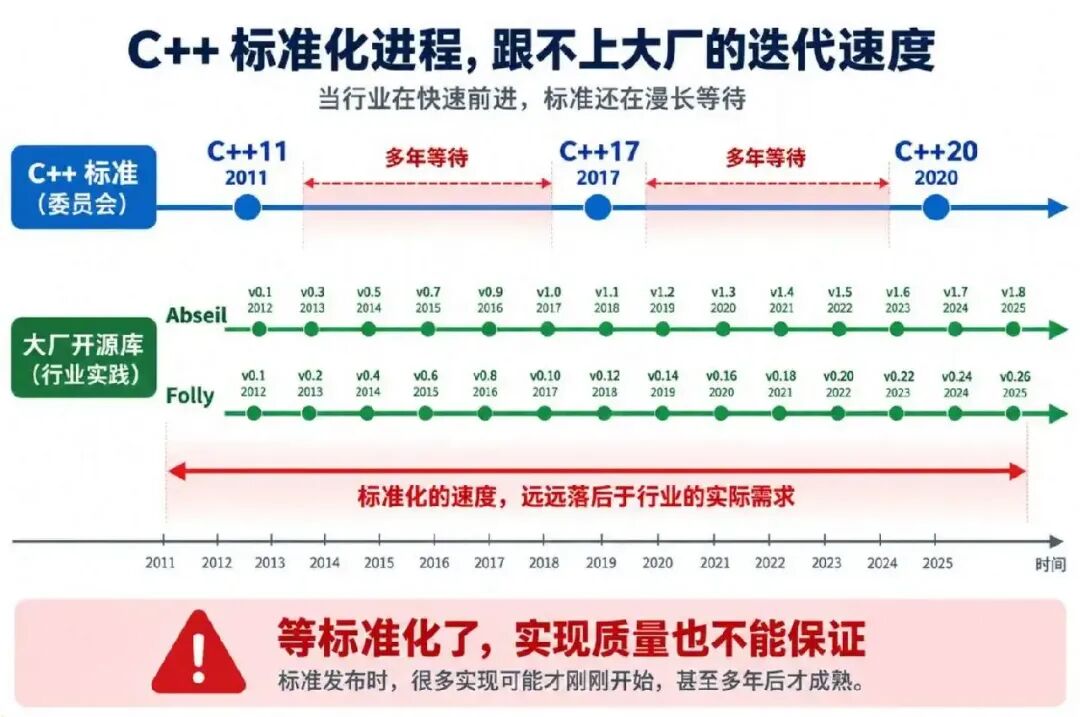
更深层的问题在于,即使标准化了,实现质量也不能保证。各家编译器对 std::regex 的实现性能差距可达数十倍,而这个组件甚至被创始人 Bjarne Stroustrup 自己承认是一个失误。大厂选择自己写,就是为了完全掌控行为和性能特征。
不只是库,还是语言本身
Google 的动作更进一步——它在开发 Carbon,一门旨在成为 C++ 继承者的实验性语言。Carbon 的目标不是用新语法吸引人,而是用更安全的默认行为和更简洁的工程体验来解决 C++ 积累了四十年的兼容性负债。
从 Abseil 到 Carbon,逻辑是一贯的:当一门语言的基础设施无法满足实际需求时,大规模组织会选择自己造轮子,甚至选择换车。
对普通开发者的启示
你不需要在自己的项目里重写一套库。但你需要理解,大厂这些基础库背后的设计思想——当 std:: 不够用时,问题在哪里?怎么补救?
学习 Folly 和 Abseil 的源码,最大的价值不是抱回几个类,而是看到工程实践中的真正难点:如何做到既快又安全,如何在复杂系统里管理错误,如何让代码在十年后仍然可维护。
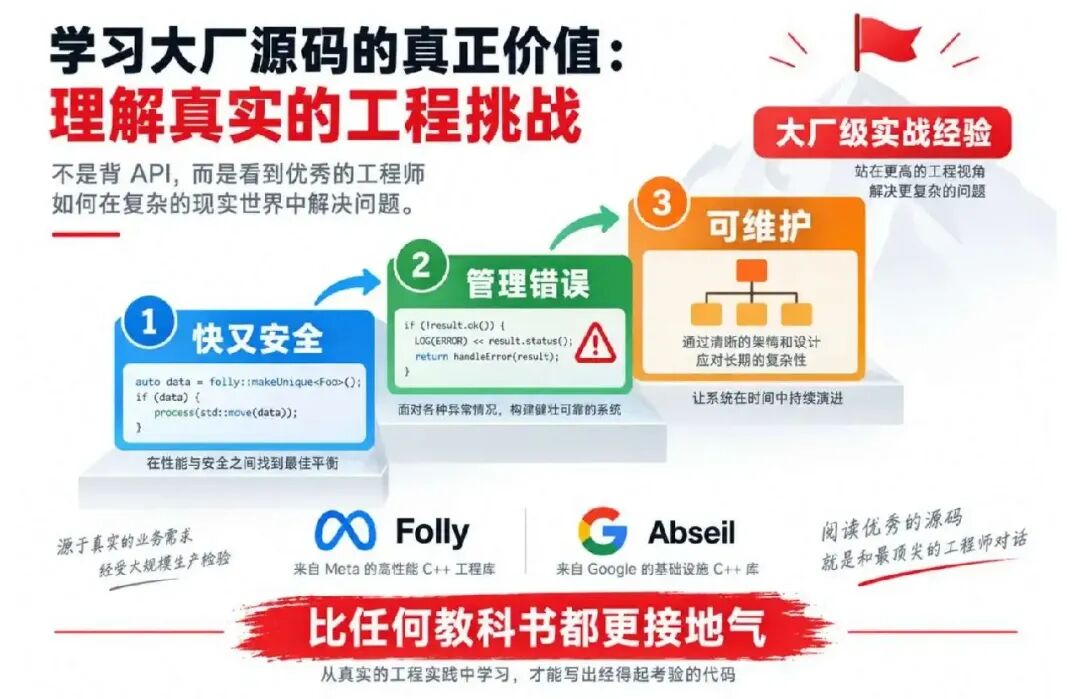
C++ 的学习路径里,这些大厂级实战经验,比任何教科书都更接地气。比起只刷 LeetCode 或死记面试题,去 开源实战 中读一读经过大规模生产检验的代码,更容易看清一个基础库为何这样设计、又要为哪些真实问题做取舍。 |  发表于 2 小时前
|
查看: 4|
回复: 0


