搜索变慢了,你打开监控:CPU 不高,堆内存也没顶满。
“机器还有余量,线程再开多一点?”
如果瓶颈在磁盘,这个动作可能让请求排得更长。另一种常见操作是重启:页面暂时恢复了,可故障线索也断了,分片恢复和缓存重新变热又带来新一轮负担。
Elasticsearch 排障最容易浪费时间的一步,是还没确定谁在忙,就开始改参数。
这篇按现场排查顺序,把磁盘 IO 这条线拆开。示例是排障方法,不是某次生产事故实录。
第一眼先分清:磁盘“满”是哪种满
容量用了 95%,和 iostat 里的 %util 接近 100%,不是一个问题。
前者涉及空间、水位和分片分配;后者表示设备忙碌时间,但在 SSD、RAID 及云盘场景,单看它也不能断言性能已经到顶。
先采几组连续数据:
iostat -x -y 1 10
-y 跳过从开机以来累计的首份报告。重点把读写吞吐、r_await/w_await 和 aqu-sz 放一起看,再对照云盘的 IOPS、吞吐上限及突发额度。字段名会随 sysstat 版本变化。
等待时间和队列一起涨、业务延迟也在涨,才值得沿这条线继续查。disk.used_percent 只能告诉你容量,不能代替 IO 延迟。
第二眼,找出谁在和搜索抢磁盘
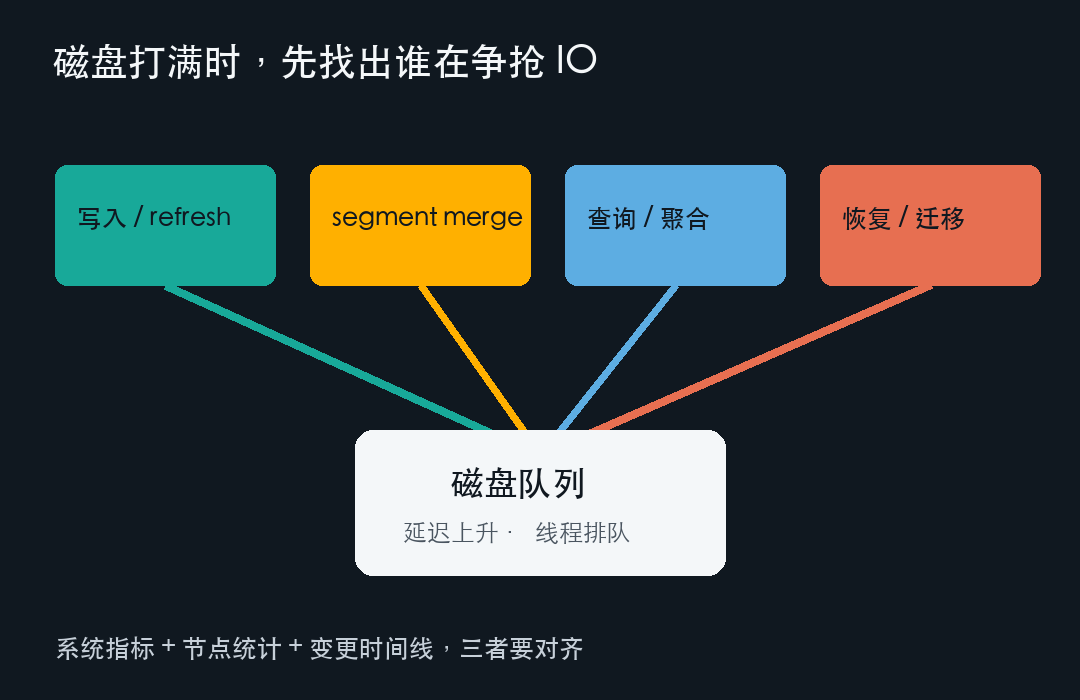
读写、段合并和恢复可能同时争用存储资源。
在 Kibana Dev Tools 里,可以先执行这些只读查询。示例面向自管理集群,托管服务和不同版本的接口权限可能不同。
GET _nodes/stats/fs,indices,jvm,thread_pool

GET _cat/recovery?v&active_only=true

GET _cat/shards?v&h=index,shard,prirep,state,node
第一条不要只保存一张截图。隔一段固定时间再取一次,比较 indices.merges、refresh、indexing、search 等累计计数的变化;节点重启后计数会重置,不能跨重启直接做差。
接着判断更像哪种情况:
| 同一时间出现的信号 |
下一步查什么 |
| 写入突增、merge 持续活跃 |
批次大小、refresh 设置、更新量 |
| 某索引查询上涨、缓存收益下降 |
慢查询 DSL、聚合、读取字段和热点分片 |
| recovery 活跃,刚重启或扩容 |
分片迁移、恢复速率与磁盘争用 |
这些是排查方向,不是看到一个指标就能盖章的根因。
一个容易反直觉的原因:你的磁盘在“整理文件”
Elasticsearch 底层的 Lucene 索引由 segment 组成。segment 不可变,新写入不断形成新段,后台再把小段合成大段,顺带清理部分删除记录。
这个过程要读旧段、写新段,还需要临时空间。查询、写入和合并同时发生,就会争抢同一块存储。
频繁刷新、持续更新和过碎的写入,都值得一起检查。但 refresh 不等于 fsync,也不等于数据已经持久化到磁盘,不能把刷新次数直接当作落盘次数。
如果业务允许新数据稍晚一点被搜到,可以针对写入索引评估增大 refresh_interval。代价也很明确:可搜索的新鲜度会下降。先记录原值、小范围观察,再决定是否保留。
两个“优化”,很容易把现场搞得更糟
一是看到段多,就对活跃索引执行 force merge。
Elastic 明确建议主要对只读索引做强制合并。它会消耗大量资源;合并为单段时,空闲空间需求还可能达到分片大小的三倍。正在持续写入的索引,不适合拿它当一键加速按钮。
二是把空余内存都给 JVM。
搜索还依赖操作系统的文件系统缓存。堆变大了,留给缓存的空间却少了,原本能从内存读取的数据可能更多地走磁盘。Elastic 的性能指南明确强调给文件系统缓存留足内存。
CPU 没跑满,不代表系统有能力再接更多请求;JVM 没用满,也不代表多分一点堆就会快。
最后再决定,是限流、改查询,还是升级磁盘
如果是一次异常批任务把写入压上来,先限制这批任务;如果是某类查询扫得太宽,先处理它的时间范围、排序、聚合和返回字段;如果是恢复碰上高峰,先评估恢复任务与前台请求的资源分配。
只有确认日常负载就长期逼近存储能力,增加 IOPS、换盘或扩容才是有依据的选择。
保存故障时段的三样东西:设备指标、ES 内部统计、发布与任务时间线。 下次再慢,能对上这三条线,比记住十个“万能调优参数”有用。
资料依据:Elastic 官方索引性能、搜索性能、Merge settings 及 Force merge API 文档。
 发表于 3 小时前
|
查看: 3|
回复: 0


