核心思路:用 DPI 快速把 RTL 变成函数,让 RTL 版本和纯 C++ 版本接口一致、结果对齐。
一、为什么是 DPI:绕过信号级的捷径
1.1 传统封装的痛点
想让软件工程师调用 RTL,最直接的做法是在 C++ 里手动推时钟:
Result add(uint32_t a, uint32_t b, uint32_t cin){
    dut_->a = a; dut_->b = b; dut_->cin = cin;
    dut_->start = 1;
    tick();                    // 时钟 1
    dut_->start = 0;
    while (!dut_->done) tick(); // 时钟 2..N
    return { dut_->sum, dut_->cout };
}
tick() 需要手工写,每个模块都要重复一遍while (!dut_->done) 依赖 RTL 内部握手信号- 一旦 RTL 的周期数改变,封装层要跟着改
- 调用者被绑死在 Verilator 的 API 上
1.2 DPI 的核心优势
DPI 让 Verilog 和 C++ 直接对话,不需要在 C++ 里“模拟”时钟:
`ifdef USE_DPI
    import "DPI-C" function longint add_c(input int a, input int b, input int cin);
    assign {cout, sum} = add_c(a, b, cin);   // ⚡ 一个函数调用搞定
`endif
extern "C"long long add_c(int a, int b, int cin){
    return (long long)((uint64_t)(uint32_t)a + (uint32_t)b + (cin & 1));
}
- Verilog 侧只多了一行
import 和一行 assign
- C++ 侧就是一个普通的纯函数,无时钟概念
- 从“推 8 个时钟”变成“调 1 次函数”
- 封装层不再和 RTL 的周期数耦合
1.3 两种封装的对比
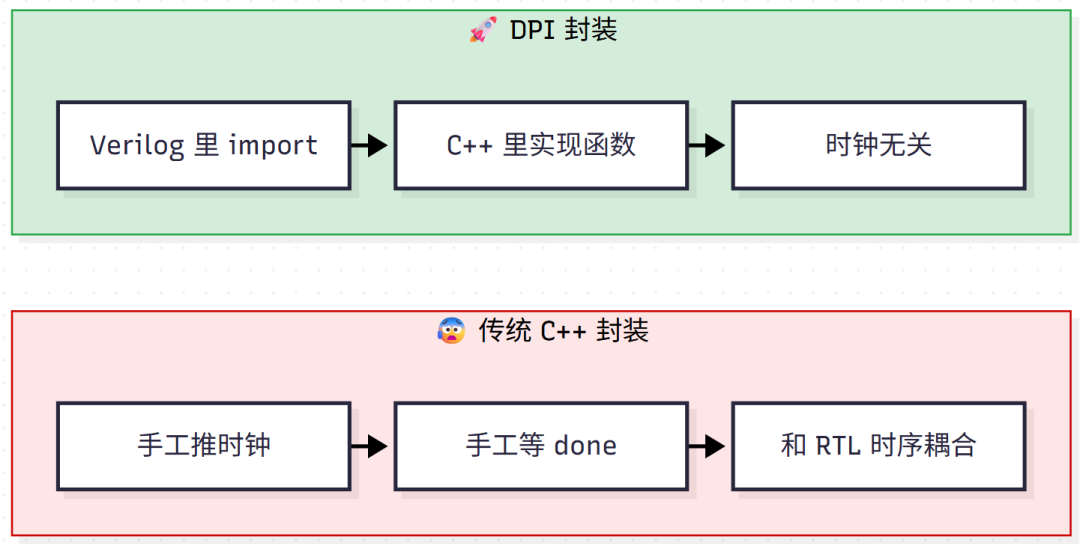
- 传统封装把时序知识写进了 C++
- DPI 封装把时序留在 Verilog,C++ 只做计算
- 结果:C++ 侧代码量减少,可维护性提升
二、DPI 的三种用法
2.1 用法一:纯组合替换(最快)
import "DPI-C" function longint add_c(input int a, input int b, input int cin);
assign {cout, sum} = add_c(a, b, cin);
- 适用于无内部状态的纯算法模块
- 周期语义完全不变,组合逻辑本来就没周期
- 每次
eval() 都会调用一次 DPI 函数
- 外部逻辑看到的接口和原来一致
2.2 用法二:保留时序外壳(周期精确)
always @(posedge clk) begin
    if (busy) begin
        cnt <= cnt + 1;
        if (cnt == 30) {cout_r, sum_r} <= add_c(a, b, cin);  // 第 31 拍才锁存
        if (cnt == 31) busy <= 0;
    end
end
- 适用于外部依赖
done 时序的模块
- 端口、周期数、握手时序全部保持不变
- DPI 只负责“算”,不负责“什么时候算”
- 外部逻辑完全无感
2.3 用法三:完全切换实现(结果对齐)
`ifdef USE_DPI
    import "DPI-C" function longint add_c(...);
    assign {cout, sum} = add_c(a, b, cin);
    assign done = 1'b1;
`else
    // 原时序进位 FSM
`endif
- 适用于外部只关心最终结果、不关心周期数
- 周期语义变了,多周期变为单周期
- 编译期通过
-DUSE_DPI 切换
- 是“快速封装 + 结果对齐”的最简形态
2.4 三种用法决策树
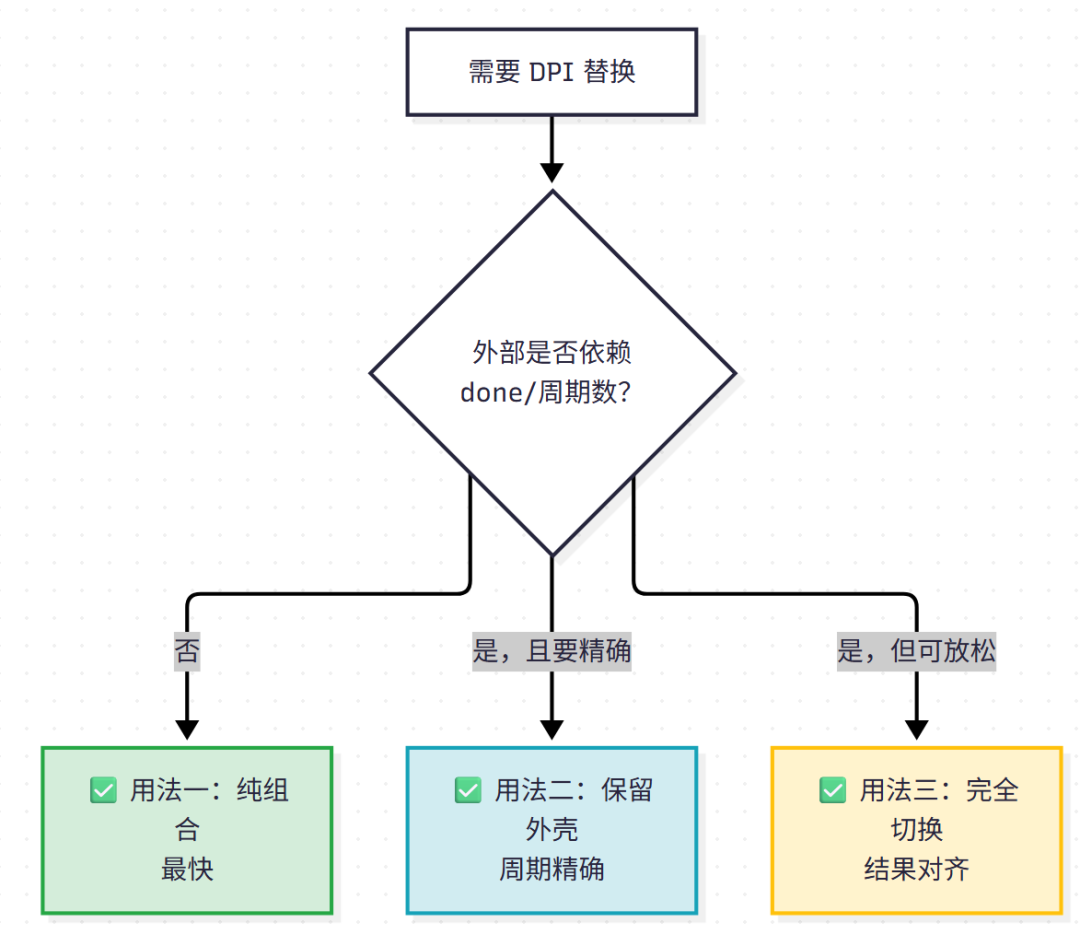
- 用法一最激进,适合算法模块
- 用法二最保守,适合有握手协议的场景
- 用法三居中,适合快速验证
- 三者可以共存于同一份 RTL,用宏切换
三、双版本对齐:工程的核心
3.1 为什么要双版本
单有 RTL 版本,软件团队跑得慢;单有 C++ 版本,跑得快但和 RTL 脱节。两个都要,且接口一致。
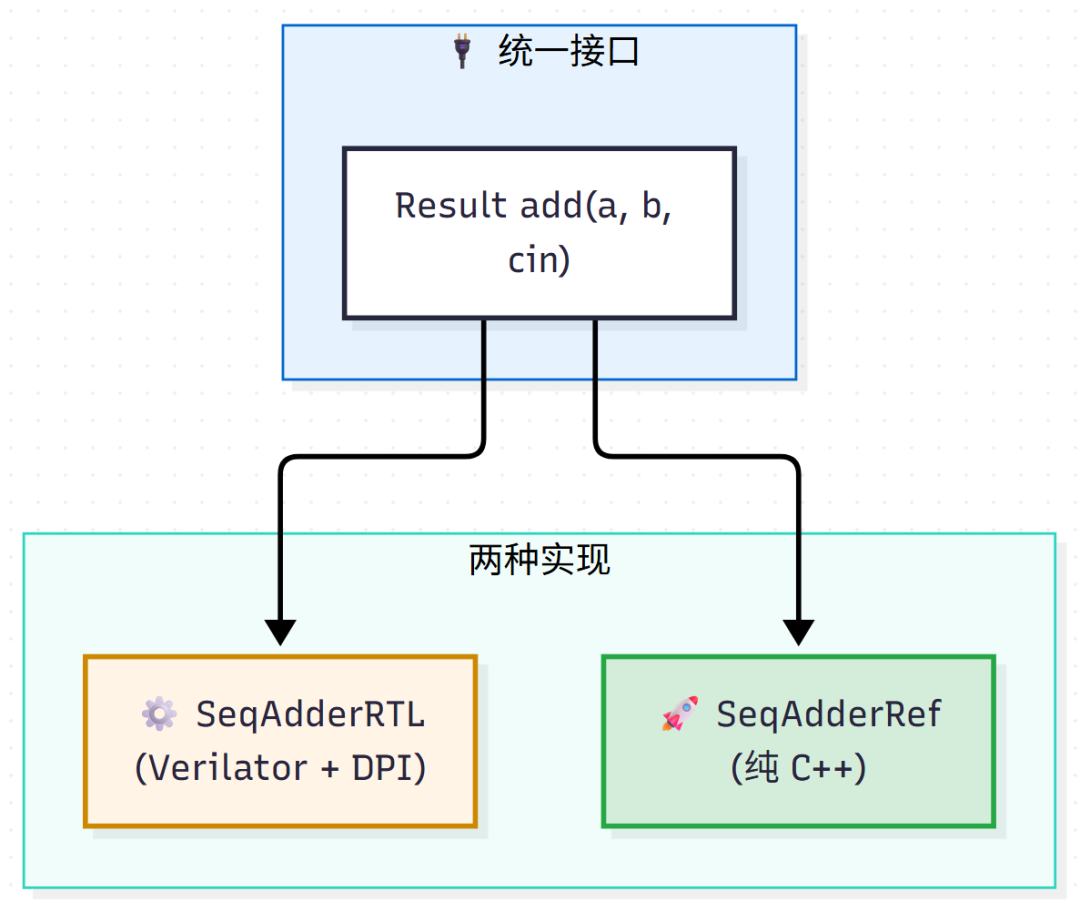
- 软件团队面向统一接口编程
- 日常回归用参考版,适合亿级向量
- 每日构建用 RTL 版,适合百万级
- 两者共享同一份测试代码
3.2 接口设计原则
| 原则 |
✅ 正确 |
❌ 错误 |
| 事务级 |
add(a, b, cin) |
start()、wait_done()、get_sum() |
| 结构体返回 |
Result{sum, cout} |
void add(..., uint32_t* sum, uint32_t* cout) |
| 稳定类型 |
uint32_t |
sc_uint<32> / WIDTH 宏 |
| 隐藏时序 |
内部 tick() |
外部感知 clk / busy |
| 错误处理 |
异常 / 错误码 |
返回 x 传播 |
- 用事务级概念而非信号级概念
- 返回结构体而非多个输出引用
- 类型固定,不随 RTL 参数变化
- 调用者感知不到时钟和握手
3.3 DPI 让接口天然一致
关键洞察:DPI 函数和 C++ 参考模型都是同一个 add() 签名。
// RTL 侧:DPI 函数
extern "C"long long add_c(int a, int b, int cin);

// 参考侧:纯 C++ 函数
inline long long add_native(int a, int b, int cin){
    return (long long)((uint64_t)(uint32_t)a + (uint32_t)b + (cin & 1));
}
- 两个函数体几乎一样
- 因为 DPI 的本质就是“让 C++ 代码在 RTL 里跑”
- 这是对齐的根基:计算逻辑同源
- 差异只在“被谁调用”
3.4 对齐验证流程
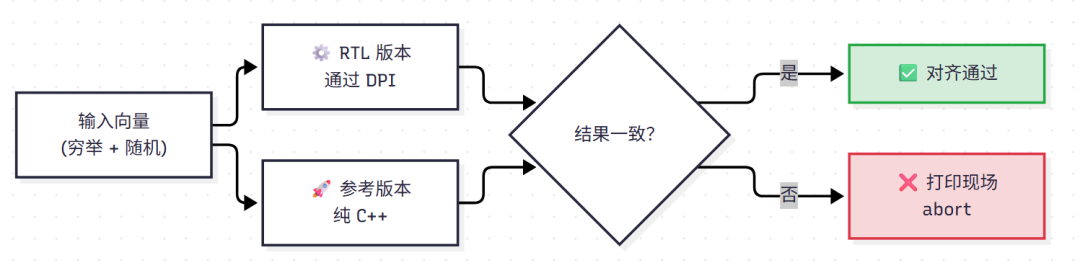
- 输入向量同时喂给两个版本
- 逐组比对
sum / cout
- 不一致立即打印现场并 abort
- 先小位宽穷举,再大位宽随机
四、完整工程示例
4.1 目录结构
project/
├── CMakeLists.txt
├── rtl/
│   └── adder.v              # RTL + DPI 条件编译
├── dpi/
│   └── adder_dpi.cpp        # DPI 的 C++ 实现
├── include/
│   └── adder.h              # 统一接口(软件团队看这个)
├── src/
│   ├── seq_adder_rtl.cpp    # RTL 版封装
│   └── seq_adder_ref.cpp    # 参考版实现
└── tb/
    └── testbench.cpp        # 对拍测试
rtl/ 由硬件团队维护dpi/ 是 RTL 的计算核心include/ 是给软件团队的唯一依赖src/ 是两种实现tb/ 是对拍验证
4.2 统一接口 include/adder.h
#pragma once
#include <cstdint>

struct AddResult {
    uint32_t sum;
    uint32_t cout;
};

class SeqAdder {
public:
    virtual ~SeqAdder() = default;
virtual AddResult add(uint32_t a, uint32_t b, uint32_t cin = 0)= 0;
};

// 工厂函数:返回不同实现
SeqAdder* make_rtl_adder();   // Verilator + DPI
SeqAdder* make_ref_adder();   // 纯 C++
- 抽象基类定义接口,两种实现派生
- 工厂函数让调用者选择实现
- 头文件只依赖
<cstdint>,无 Verilator 细节
- 软件团队看到的就是这个文件
4.3 RTL 侧:DPI 条件编译 rtl/adder.v
module adder (
    input         clk,
    input         rst,
    input         start,
    input  [31:0] a, b,
    input         cin,
    output [31:0] sum,
    output        cout,
    output        done
);

`ifdef USE_DPI
    import "DPI-C" function longint add_c(input int a, input int b, input int cin);
    wire [32:0] add_result = add_c(a, b, cin);
    assign sum  = add_result[31:0];
    assign cout = add_result[32];
    assign done = 1'b1;
`else
    reg [5:0] i;
    reg       carry;
    reg [31:0] sum_r;
    reg       busy;

    assign sum  = sum_r;
    assign cout = carry;
    assign done = ~busy;

    always @(posedge clk or posedge rst) begin
        if (rst) begin
            i <= 0; carry <= 0; sum_r <= 0; busy <= 0;
        end else if (start && !busy) begin
            i <= 0; carry <= cin; busy <= 1;
        end else if (busy) begin
            sum_r[i] <= a[i] ^ b[i] ^ carry;
            carry    <= (a[i]&b[i]) | (a[i]&carry) | (b[i]&carry);
            i <= i + 1;
            if (i == 31) busy <= 0;
        end
    end
`endif
endmodule
- 端口列表在两种实现下完全一致
USE_DPI 时用 longint 打包 33 位结果- 非 DPI 时保留原来的时序进位 FSM
- 用
-DUSE_DPI 编译期切换
4.4 DPI 实现 dpi/adder_dpi.cpp
#include <cstdint>
extern "C"long long add_c(int a, int b, int cin){
    uint64_t r = (uint64_t)(uint32_t)a + (uint32_t)b + (cin & 1);
    return (long long)r;
}
- 无状态,纯函数
- 用 64 位中间值容纳第 32 位进位
extern "C" 防止 C++ 名称修饰- 返回值低 32 位是 sum,第 32 位是 cout
4.5 RTL 版封装 src/seq_adder_rtl.cpp
#include "adder.h"
#include "Vadder.h"
#include "verilated.h"

class SeqAdderRTL : public SeqAdder {
    Vadder* dut_;
void tick(){ dut_->clk = 0; dut_->eval(); dut_->clk = 1; dut_->eval(); }
public:
    SeqAdderRTL() { dut_ = new Vadder; dut_->rst = 1; tick(); dut_->rst = 0; }
    ~SeqAdderRTL() override { dut_->final(); delete dut_; }

    AddResult add(uint32_t a, uint32_t b, uint32_t cin) override{
        dut_->a = a; dut_->b = b; dut_->cin = cin; dut_->start = 1;
        tick(); dut_->start = 0;
        int guard = 0;
        while (!dut_->done && guard++ < 64) tick();
        return { (uint32_t)dut_->sum, (uint32_t)dut_->cout };
    }
};

SeqAdder* make_rtl_adder(){ return new SeqAdderRTL; }
- 构造时复位 DUT
- 析构时清理 Verilator 资源
add() 内部完成握手,对外只返回结果guard 防止 DUT 异常时死循环
4.6 参考版实现 src/seq_adder_ref.cpp
#include "adder.h"
#include <cstdint>

class SeqAdderRef : public SeqAdder {
public:
    AddResult add(uint32_t a, uint32_t b, uint32_t cin) override{
        uint64_t r = (uint64_t)a + (uint64_t)b + (cin & 1);
        return { (uint32_t)r, (uint32_t)(r >> 32) };
    }
};

SeqAdder* make_ref_adder(){ return new SeqAdderRef; }
- 和 DPI 函数体几乎一样
- 一行加法搞定
- 无时钟、无握手、无 Verilator
- 执行速度比 RTL 版快几个数量级
4.7 对拍测试 tb/testbench.cpp
#include "adder.h"
#include <cstdio>
#include <cstdint>

int main(){
    SeqAdder* rtl = make_rtl_adder();
    SeqAdder* ref = make_ref_adder();

    int errors = 0, total = 0;
    const uint32_t vals[] = {
        0, 1, 2, 0xFF, 0x100, 0x7FFFFFFF,
        0x80000000, 0xFFFFFFFF, 0x12345678, 0xDEADBEEF,
    };
    const int N = sizeof(vals) / sizeof(vals[0]);

    for (int ia = 0; ia < N; ia++)
        for (int ib = 0; ib < N; ib++)
            for (int cin = 0; cin < 2; cin++) {
                uint32_t a = vals[ia], b = vals[ib];
                auto r_rtl = rtl->add(a, b, cin);
                auto r_ref = ref->add(a, b, cin);
                total++;
                if (r_rtl.sum != r_ref.sum || r_rtl.cout != r_ref.cout) {
                    printf("MISMATCH: a=0x%08X b=0x%08X cin=%u | "
                           "rtl=(%u,%u) ref=(%u,%u)\n",
                           a, b, cin, r_rtl.sum, r_rtl.cout, r_ref.sum, r_ref.cout);
                    errors++;
                }
            }

    printf("\n%d tests, %d errors\n", total, errors);
    delete rtl; delete ref;
    return errors ? 1 : 0;
}
- 同一份输入喂给两个实现
- 覆盖边界值:0、1、最大正整数、全 1 等
- 逐组比对,不一致打印现场
- 退出码反映是否有错,方便 CI 集成
4.8 CMakeLists.txt
cmake_minimum_required(VERSION 3.16)

if(POLICY CMP0144)
    cmake_policy(SET CMP0144 NEW)
endif()

project(dpi_adder LANGUAGES CXX)

set(CMAKE_CXX_STANDARD 17)
set(CMAKE_CXX_STANDARD_REQUIRED ON)

if(NOT CMAKE_BUILD_TYPE)
    set(CMAKE_BUILD_TYPE Release CACHE STRING "" FORCE)
endif()

find_package(verilator HINTS $ENV{VERILATOR_ROOT} ${VERILATOR_ROOT} REQUIRED)
set(THREADS_PREFER_PTHREAD_FLAG ON)
find_package(Threads REQUIRED)

include_directories(${CMAKE_CURRENT_SOURCE_DIR}/include)

# ---- 参考版(纯 C++,无 Verilator)----
add_library(seq_adder_ref STATIC src/seq_adder_ref.cpp)
target_link_libraries(seq_adder_ref PUBLIC Threads::Threads)

# ---- RTL 版(Verilator + DPI)----
add_library(seq_adder_rtl STATIC src/seq_adder_rtl.cpp dpi/adder_dpi.cpp)

verilate(seq_adder_rtl
    SOURCES       rtl/adder.v
    TOP_MODULE    adder
    VERILATOR_ARGS --no-timing -DUSE_DPI --Wno-fatal
)

target_link_libraries(seq_adder_rtl PUBLIC Threads::Threads)
target_compile_options(seq_adder_rtl PRIVATE -O3 -march=native)

# ---- 对拍测试 ----
add_executable(compare tb/testbench.cpp)
target_link_libraries(compare PRIVATE seq_adder_rtl seq_adder_ref)

enable_testing()
add_test(NAME compare COMMAND compare)
- 两个库独立编译,互不污染
verilate() 是 Verilator 官方 CMake 函数-DUSE_DPI 只在 verilator 进程生效Threads::Threads 是 Verilator 运行时的依赖
4.9 运行
cmake -B build -S .
cmake --build build -j
./build/compare
输出:
100 tests, 0 errors
- RTL 版本和 C++ 版本结果完全对齐
- 退出码为 0 表示全部通过
- 可以集成到 CI 里作为回归测试
五、DPI 的边界与坑
5.1 能用 / 不能用
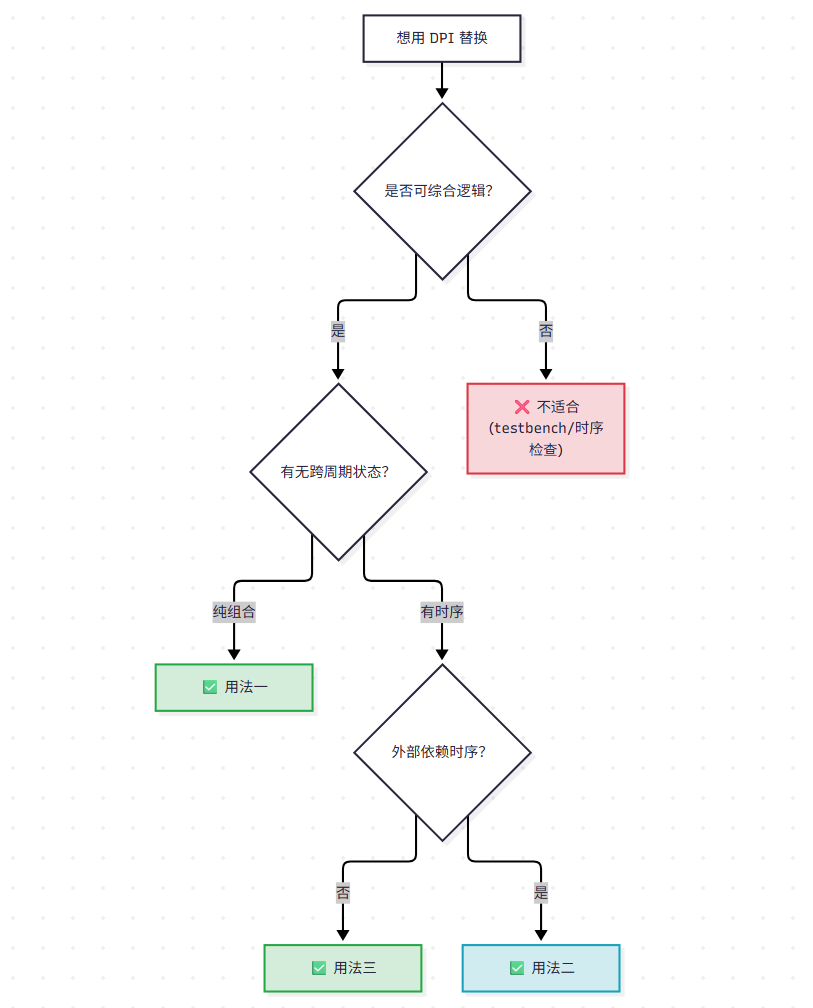
- 可综合逻辑才有对应的 C++ 实现
- 纯组合 → 用法一
- 有时序且外部依赖 → 用法二
- 有时序但外部不依赖 → 用法三
5.2 常见坑
| 坑 |
现象 |
修法 |
用 static 保存状态 |
多实例互相踩、复位清不掉 |
状态放 Verilog reg,通过参数传 |
output 参数当返回值 |
编译报 "Missing argument" |
显式传变量,或用 longint 打包 |
| 位宽不匹配 |
WIDTHEXPAND 警告 |
用 longint / 显式扩展 |
| 多实例共享 DPI |
结果错乱 |
DPI 必须是无状态纯函数 |
# 延迟 |
Verilator 不支持 |
用 always @(posedge clk) + 计数器 |
改 clk 推进时钟 |
无效,DPI 拿不到控制权 |
时钟推进必须在 testbench |
static 是最常见的坑,会导致多实例共享状态output 参数必须显式传变量,不能靠返回值- Verilator 是周期仿真器,不支持
# 延迟
- DPI 函数拿不到时钟控制权,clk 推进只能在 testbench
5.3 无状态原则
DPI 函数必须是纯函数:输出只依赖输入,无 static,无全局变量。
- Verilator 为每个实例独立管理状态
- DPI 不参与状态管理,只做“计算”
- 状态放在 Verilog
reg 里,通过参数进出 DPI
- 这是 DPI 能和 Verilator 和谐共处的根本原因
六、软硬件对齐的完整图景
6.1 三方视角
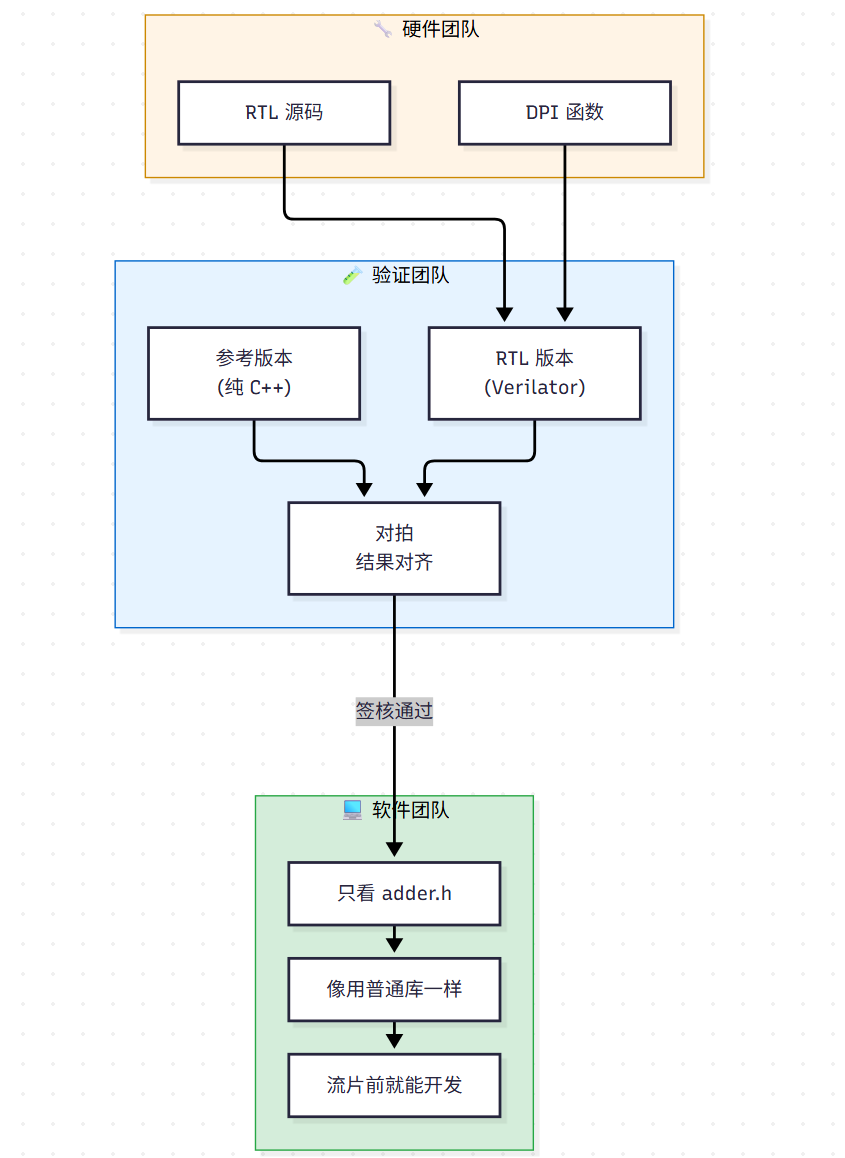
- 硬件团队维护 RTL 和 DPI 函数
- 验证团队跑双版本对拍
- 软件团队只依赖统一头文件
- 对拍通过后软件团队才能安全使用
6.2 三种交付形态
| 形态 |
内容 |
用途 |
| 📚 源码 |
rtl/ + dpi/ + include/ |
硬件团队维护 |
| 📦 静态库 |
libseq_adder_rtl.a + libseq_adder_ref.a |
链接到测试 |
| 🎁 头文件 |
adder.h |
软件团队唯一依赖 |
- 源码交给硬件团队
- 静态库用于构建测试和集成
- 头文件是软件团队唯一需要看的
6.3 核心价值
DPI 让“RTL 版本”和“C++ 版本”共享同一个接口,因为 DPI 的本质就是把 C++ 代码注入 RTL。
- 接口一致:两边都是
Result add(a, b, cin)
- 结果对齐:对拍验证,100% 一致
- 速度可控:软件用参考版,适合亿级向量;验证用 RTL 版,适合百万级
- 周期可选:三种 DPI 用法,按需选择
七、总结
7.1 三步走
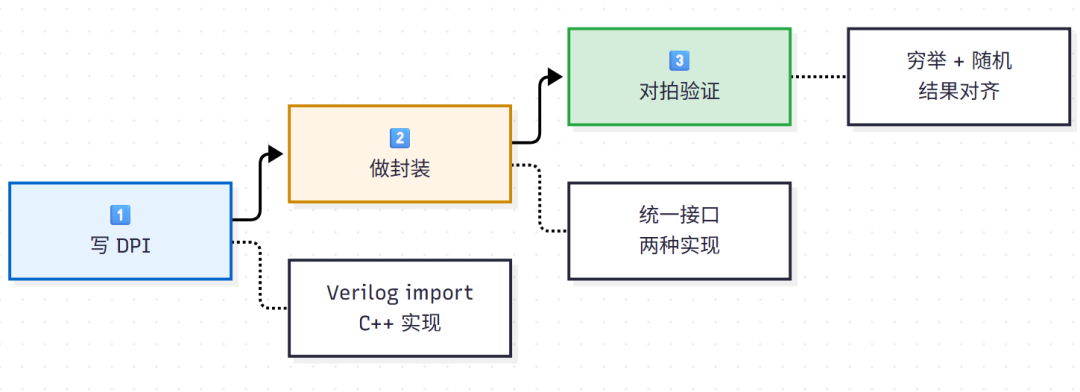
- 第一步:在 RTL 里 import DPI,C++ 侧实现计算
- 第二步:用统一的 C++ 接口包住两种实现
- 第三步:穷举 + 随机对拍,确保结果一致
7.2 关键洞察
| 洞察 |
说明 |
| 🎯 DPI 是捷径 |
不用手工推时钟,直接调函数 |
| 🔑 接口统一是核心 |
RTL 版和 C++ 版共享 add() 签名 |
| ✅ 对拍是保障 |
穷举 + 随机,逐一对齐 |
| ⚙️ 周期语义可选 |
三种用法:纯组合 / 保外壳 / 完全切换 |
| 🚫 DPI 必须无状态 |
状态放 Verilog,计算放 C++ |
- DPI 省掉了手工写握手代码的工作量
- 接口统一是软硬件协同的基础
- 对拍是保证等价性的工程手段
- 周期语义按需选择,不必一刀切
- 无状态是 DPI 能正常工作的前提
7.3 最后一句
仿真器的速度差异是事实,但真正的价值不是“用 C++ 加速仿真”,而是“用 DPI 把 RTL 变成软件工程师可以调用的函数,同时和纯 C++ 版本严格对齐”。
- 软件团队在流片前就跑通代码
- 验证团队用同份测试跑两种实现
- 硬件团队的 RTL 被更早、更多地验证
- 这一切的支点,就是 DPI 那一行
import "DPI-C"
 发表于 2 小时前
|
查看: 7|
回复: 0


