CPU核心越来越多,GPU和NPU也在持续变大,现代SoC正在遇到一个越来越现实的问题:算力堆上去之后,数据怎么在芯片内部高效流动?缓存、片上互连和内存系统,开始直接影响计算单元能释放多少性能。
Snapdragon X2 Elite恰好提供了一个很好的观察样本:18个CPU核心被组织成三个6核集群,并通过共享L2和系统级互连连接起来。从这颗芯片里,可以看到高核心数SoC正在如何处理跨集群通信,以及CPU和GPU争抢内存带宽的问题。
18核背后,难点在于数据通路
Snapdragon X2 Elite Extreme 是目前高通 PC 平台里规模最大的一颗 CPU:最多 18 个第三代 Oryon 核心,最高频率达到 5.0GHz,同时集成 Adreno GPU 和 Hexagon NPU。顶配 X2E-96-100 还配备 192-bit LPDDR5X,理论内存带宽达到 228GB/s。这些参数放在一起看,一个问题就变得很具体:当 CPU、GPU 和 NPU 都在争夺数据时,芯片内部的数据通路能不能跟得上?
这也是分析 X2 Elite 时比单纯比较核心数和频率更有意思的地方。沿着 CPU 往外看,会依次经过 L2 Cache、Cluster、System Fabric 和内存控制器。其中任何一段带宽不足或者延迟过高,都可能让前面的计算单元等数据。高通在 X2 Elite 上做的很多设计,本质上都围绕着这条数据路径展开。
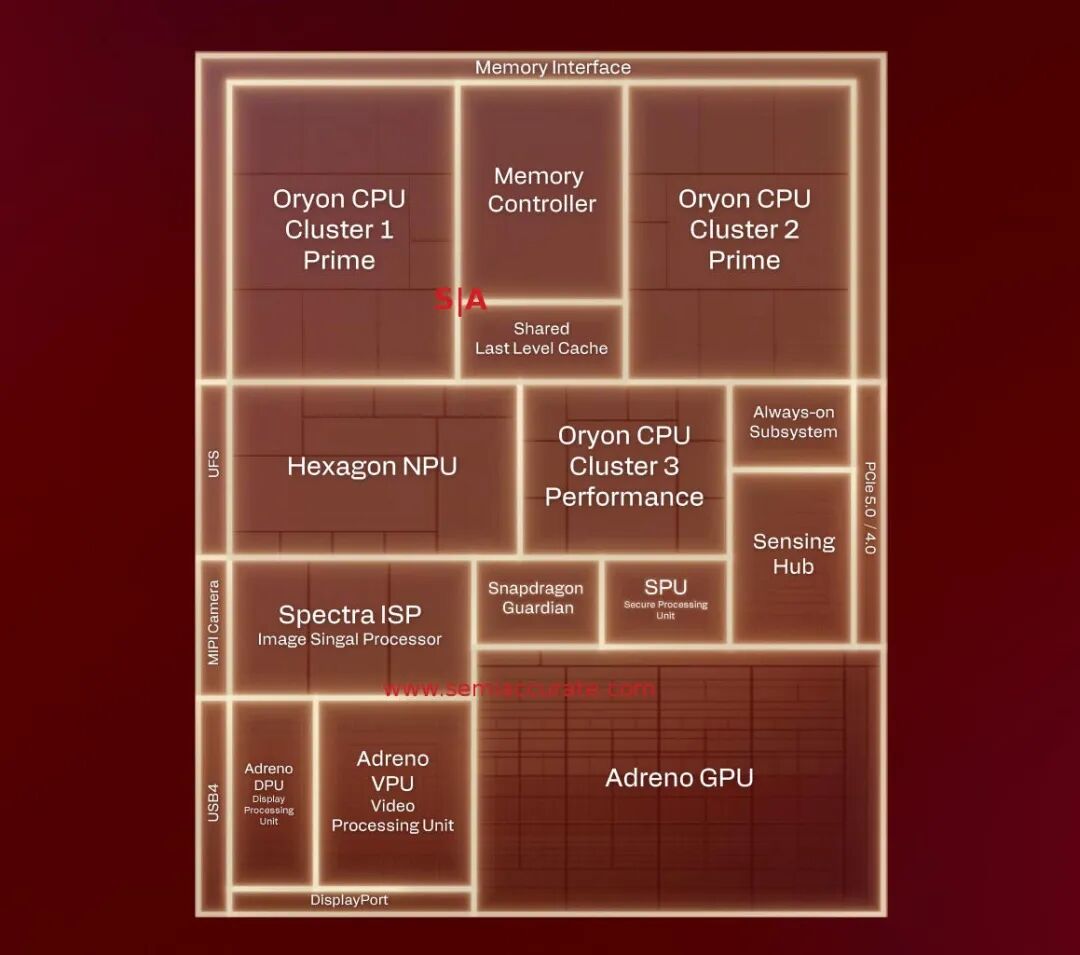
图1|Snapdragon X2 Elite SoC架构示意:三个Oryon CPU集群围绕内存控制器、共享末级缓存、NPU和GPU组织。来源:Qualcomm架构资料 / SemiAccurate
三组6核:先把互连问题拆小
X2 Elite Extreme没有让18个CPU核心直接面对一个庞大的共享互连,而是拆成三个6核集群:两个Prime集群和一个Performance集群。两个Prime集群各自共享 16MB L2,Performance集群共享 12MB L2。
这种组织方式的意义很直接。集群内部的核心先围绕一块共享L2完成大部分数据交换,对系统级互连来说,一个集群更接近一个"大客户端"。互连需要同时服务的节点减少,缓存一致性和仲裁压力也更容易控制。
实测中,Prime和Performance集群的L2访问延迟大约都在 20—21个周期。更关键的是,同一集群内的核心间通信延迟很低。代价也存在:一旦访问跨出集群,就必须经过系统级Fabric,延迟会上升。
这是一种很典型的工程取舍:接受可控的跨集群惩罚,换取集群内部更低的缓存延迟、更高的带宽,以及一个更容易扩展的片上互连。
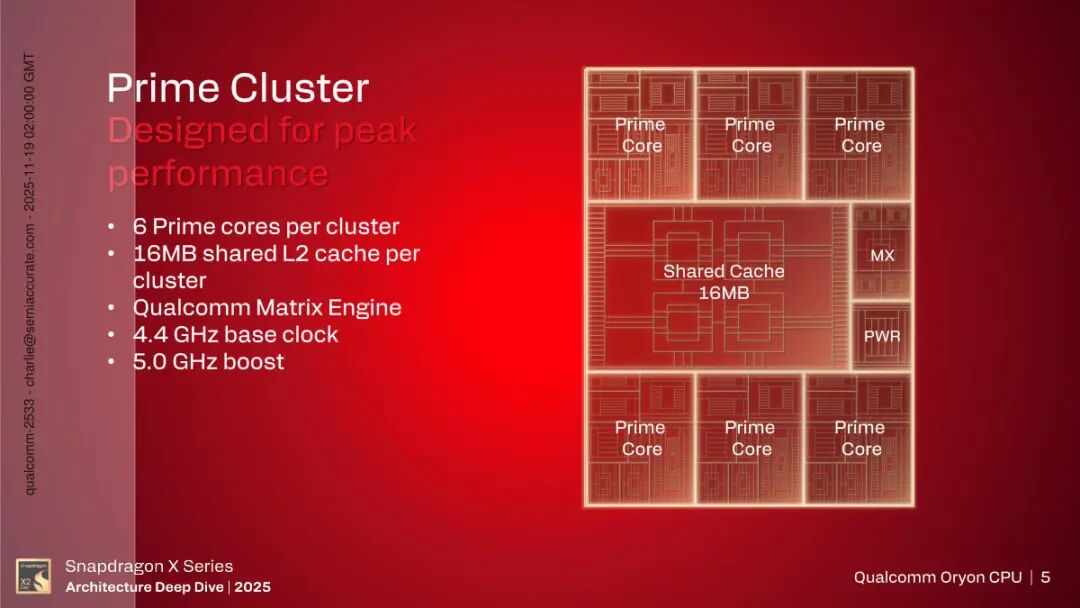
图2|Prime Cluster:6个Prime核心共享16MB L2。来源:Qualcomm架构资料 / SemiAccurate
228GB/s内存带宽,CPU能吃到多少?
顶配X2 Elite Extreme把内存接口扩大到192-bit LPDDR5X-9523,理论带宽228GB/s。Chips and Cheese的测试里,CPU-only读取带宽最高约 176.98GB/s,已经能利用相当大一部分理论带宽;DRAM访问延迟约 115ns,在LPDDR5X平台中也属于比较好的水平。
这个结果有意思的地方在于:内存总线够宽只是第一步,CPU集群到内存控制器之间的片上通路同样必须足够宽。
一些处理器即使拥有256-bit内存接口,CPU侧也未必能把理论DRAM带宽充分利用起来,因为真正卡住数据的可能已经变成CPU集群到系统Fabric之间的接口。
所以看现代SoC,单独比较"内存带宽多少GB/s"越来越不够。更重要的问题是:从核心、L2、系统互连到内存控制器,这条链上的每一段能提供多少带宽,延迟又是多少。
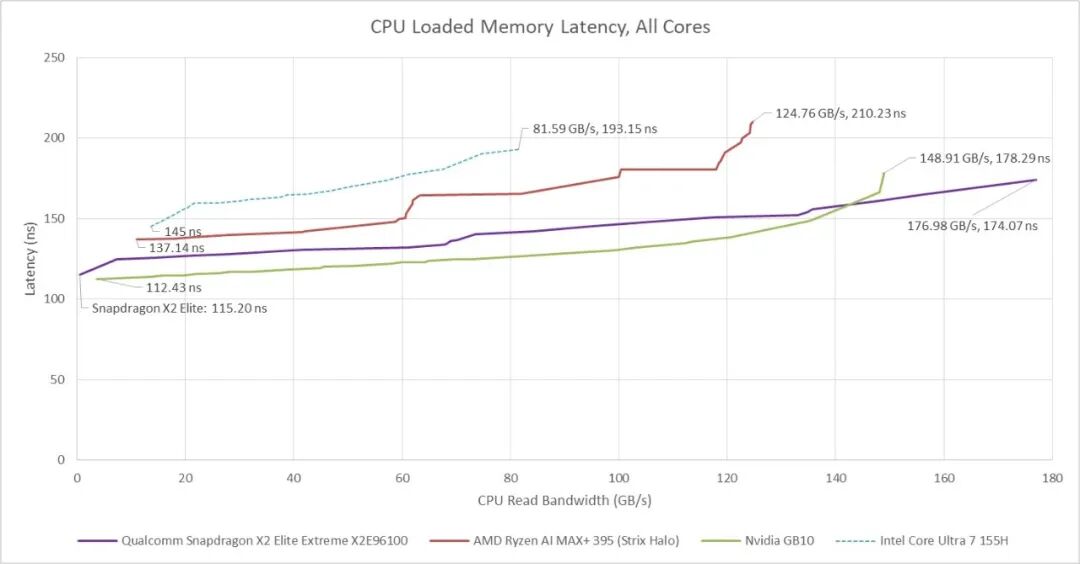
图3|全核加载下的CPU内存延迟与读带宽:X2 Elite Extreme最高达到176.98GB/s。来源:Chips and Cheese
CPU和GPU一起抢内存,才是真正的系统测试
PC SoC里还有一个更现实的问题:CPU从来不是唯一的带宽消费者。GPU、NPU、ISP以及其他模块都会访问内存。
在CPU和GPU同时施加带宽压力时,X2 Elite Extreme实测出现了一个很有意思的结果:GPU约 74.86GB/s,CPU约 94.78GB/s,总带宽约 169.3GB/s。这个数字没有达到228GB/s的理论上限,但高通没有让GPU把CPU一侧的带宽完全挤掉。
这说明系统级互连和内存控制器承担的任务已经不只是"尽量跑满带宽",还包括不同计算单元之间的资源分配。
对于今天的异构SoC,这一点越来越重要。CPU需要低延迟,GPU更容易持续吞吐大块数据,NPU又可能产生另一种访问模式。只追求某一个模块的峰值带宽,很容易让另一个模块的响应时间失控。
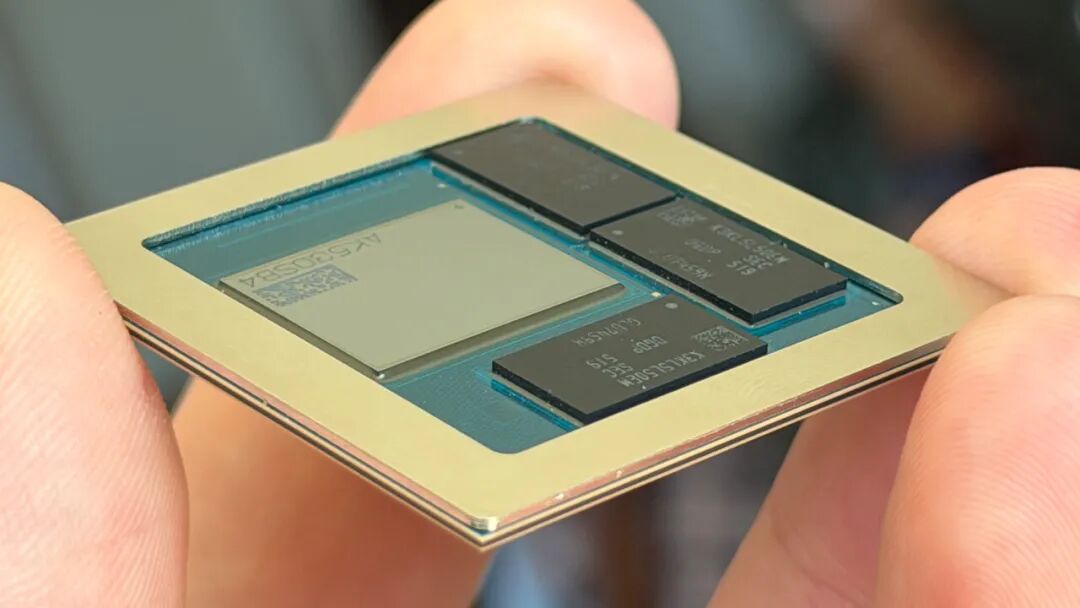
图4|Snapdragon X2 Elite Extreme芯片实物。来源:Qualcomm / ComputerBase
SoC扩展的下一道墙,是数据通路
从X2 Elite可以看到一个越来越明显的趋势:核心数量继续增加以后,SoC扩展已经不能只靠复制更多计算单元。
每增加一组CPU核心、一个更大的GPU或更强的NPU,都会继续增加缓存一致性、片上互连、内存控制器和DRAM的压力。算力增长得越快,数据通路越容易成为系统瓶颈。
这也是为什么今天看CPU架构,已经不能只盯着前端宽度、执行单元、频率和IPC。Cluster怎么划分、L2怎么共享、跨Cluster通信要付出多少代价、System Fabric能提供多少带宽、CPU和GPU如何争用DRAM,这些开始共同决定一颗SoC最终能释放多少性能。
Snapdragon X2 Elite最值得看的地方,也正在这里。18核和5GHz很容易写进规格表,真正决定这些核心能不能一起高效工作的,是规格表背后的那张片上数据网络。
 发表于 2 小时前
|
查看: 7|
回复: 0


