这套笔记讨论的核心问题,是如何把 diffusion / flow models 的思想迁移到大语言模型里。要迈出的第一步,是引入连续时间马尔可夫链(CTMC,Continuous-Time Markov Chain)的数学框架:用 CTMC 模型来描述“逐 token 修改文本”的过程——从噪声出发,一步步走到完整句子,每步尽量只改一个 token,避免训练时的状态空间爆炸。
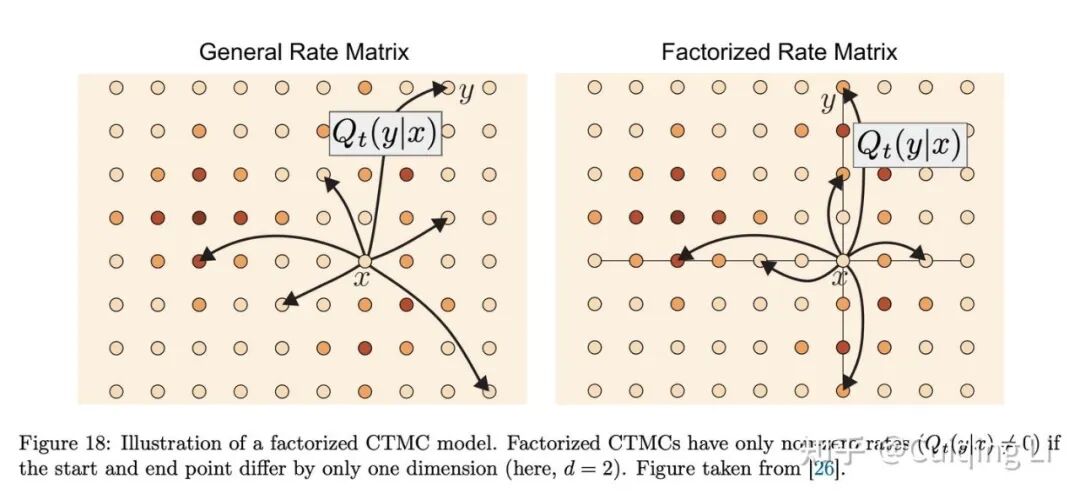
从 CTMC 到因子化速率矩阵
具体数学推导如下。
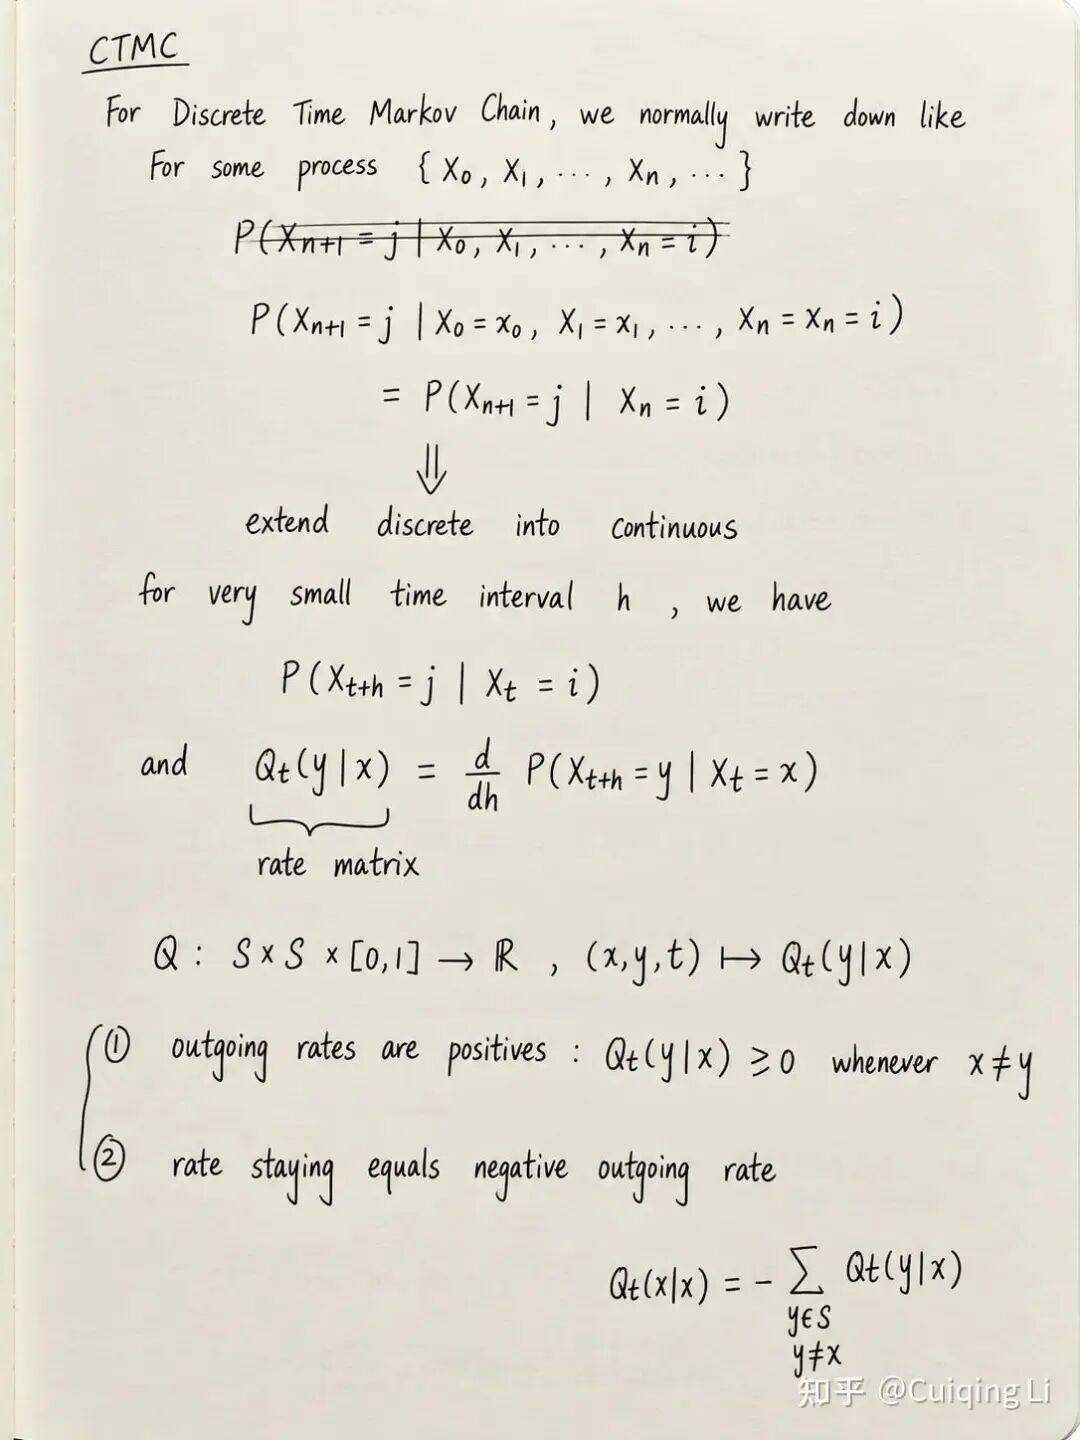
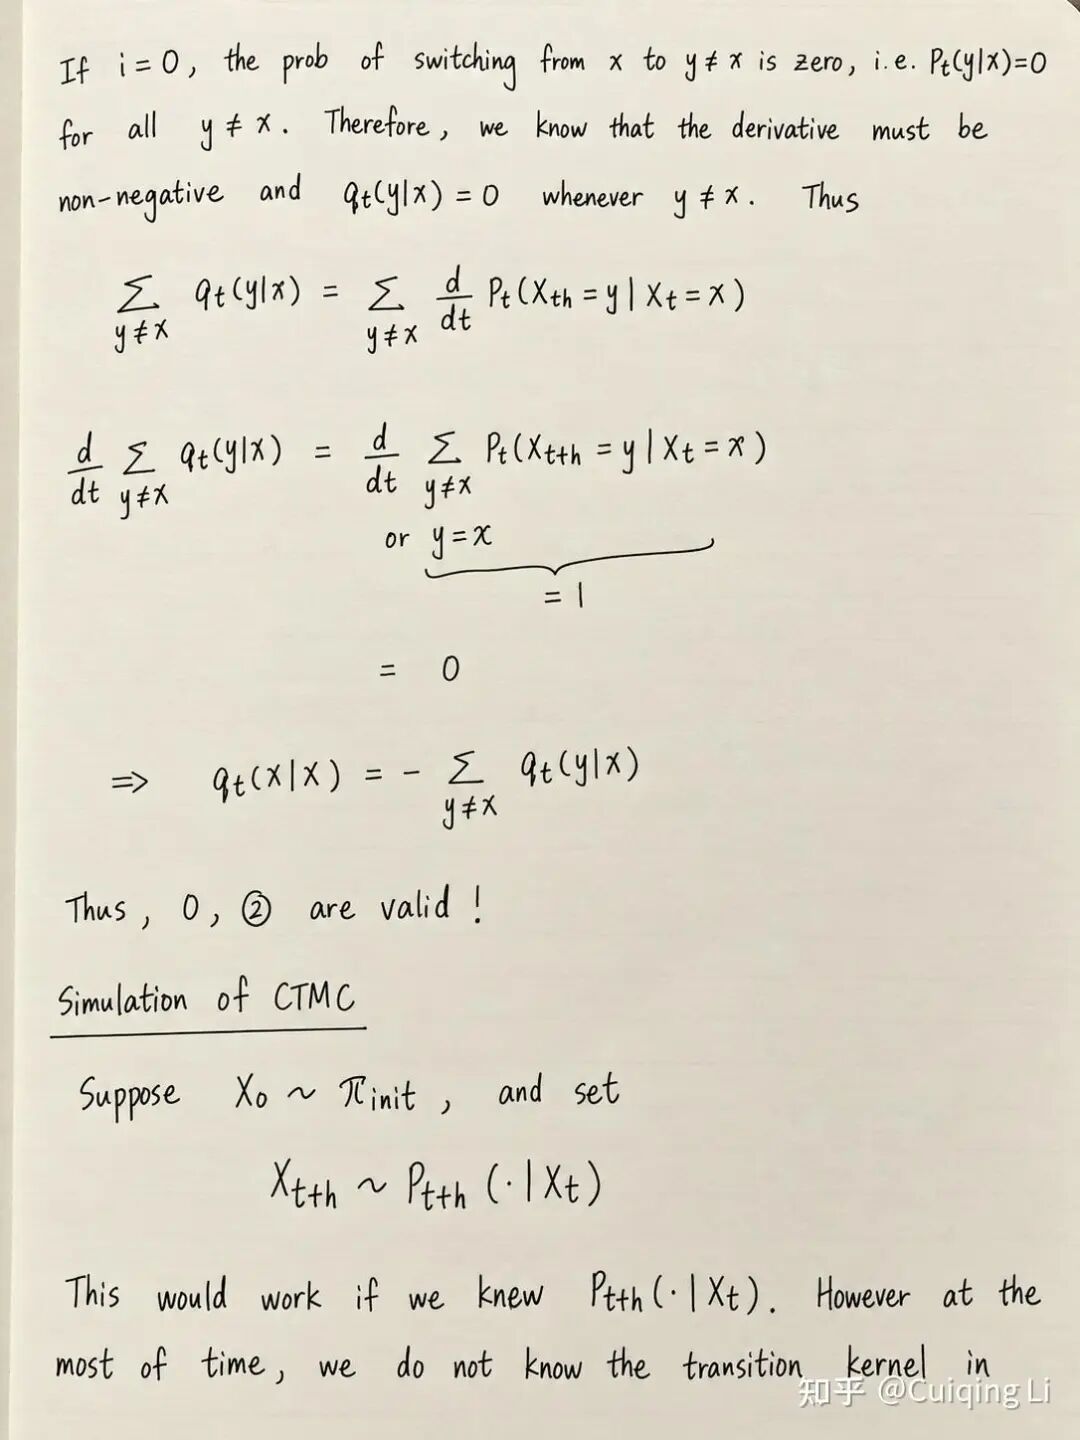
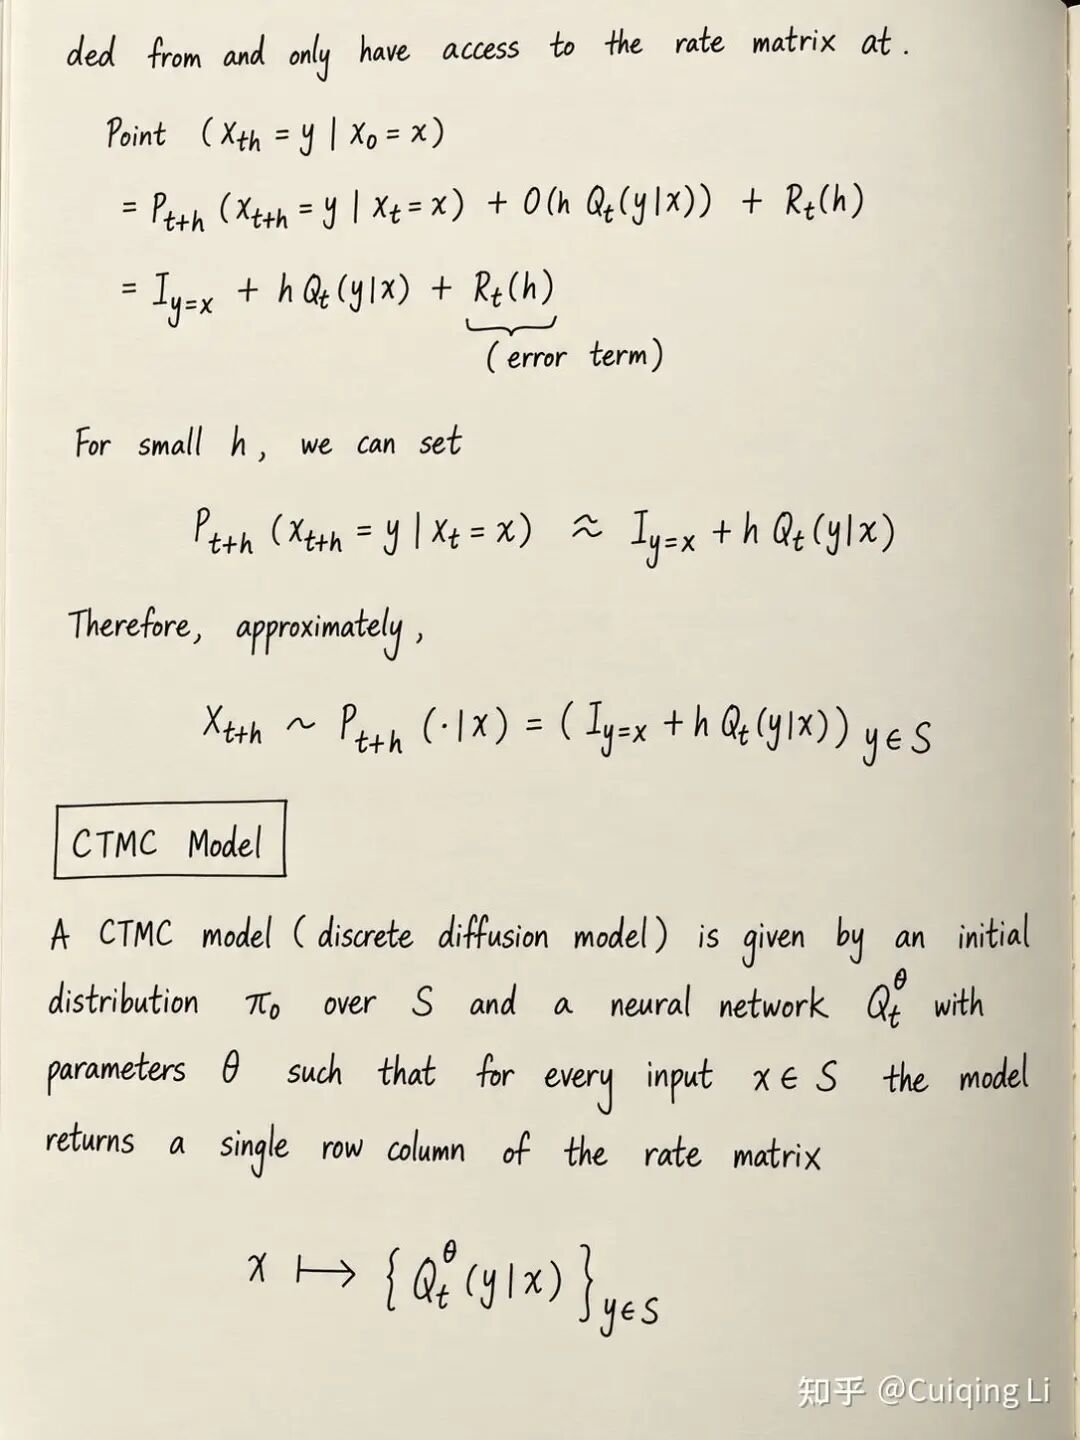
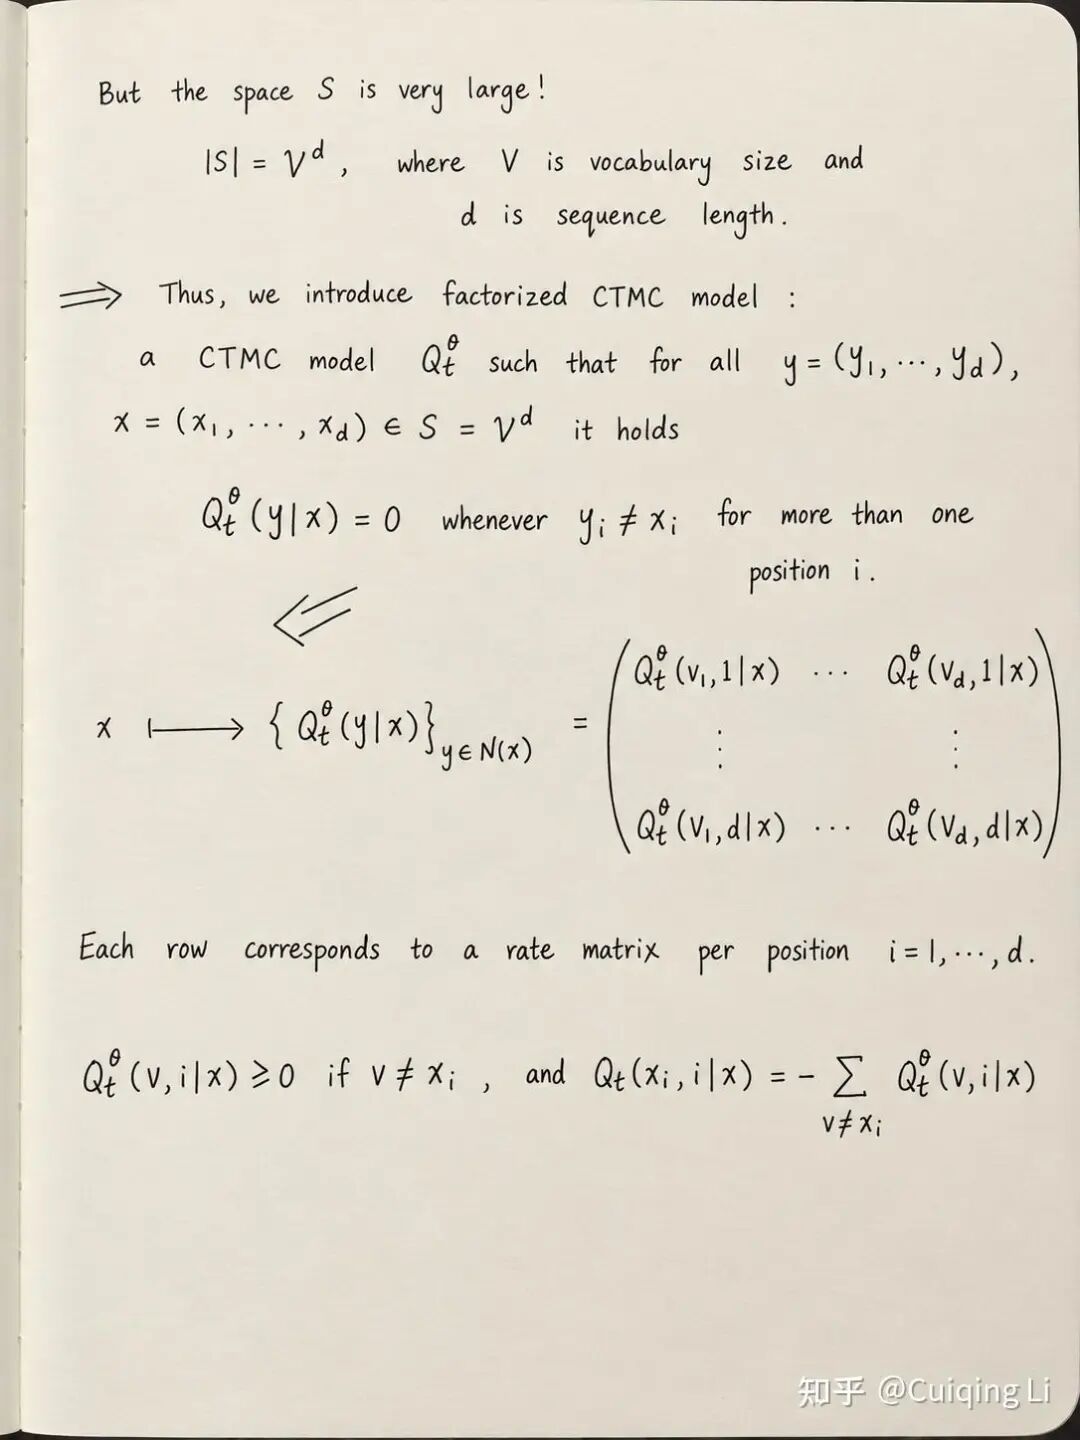
从这些推导可以看出,这里尝试建立的 CTMC 模型,核心是让神经网络去学习速率矩阵(rate matrix),也就是概率质量变化率。正因如此,推理阶段可以使用下面这种并行采样方式。
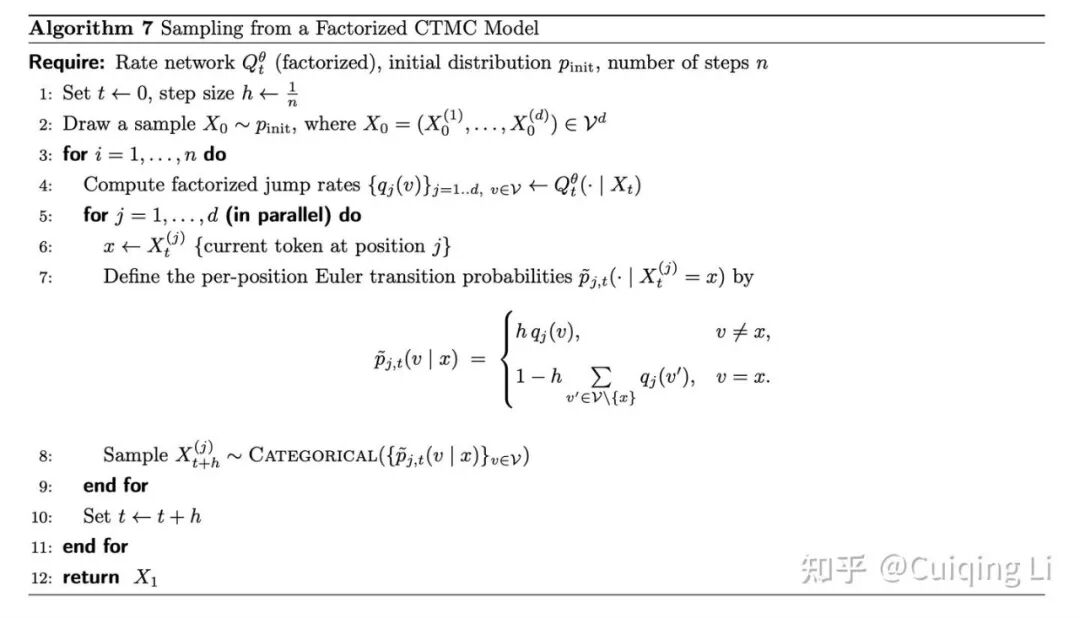
如果离散扩散模型真正 work,就能摆脱 token by token generation 的固定思路:一次推理中 token 可以被并行修改。这更像人类写作——句子写完不代表不再改动,而是会反复擦改错别字、调整语境,直到表达满意。
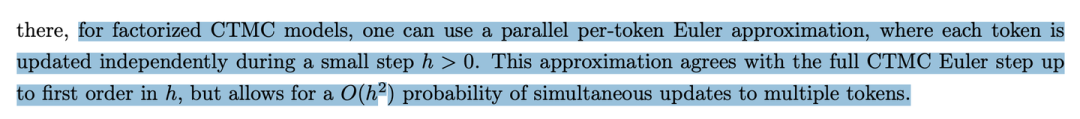
但需要注意:理论建模时假设每次只修改一个 token,而算法层面确实支持多个 token 同时改变。为什么两者仍能匹配?因为在极小的时间步内,两个 token 同时跳变的概率是 $O(h^2)$,几乎可以忽略。教授的原话如下:
训练:从条件概率路径到边际概率路径
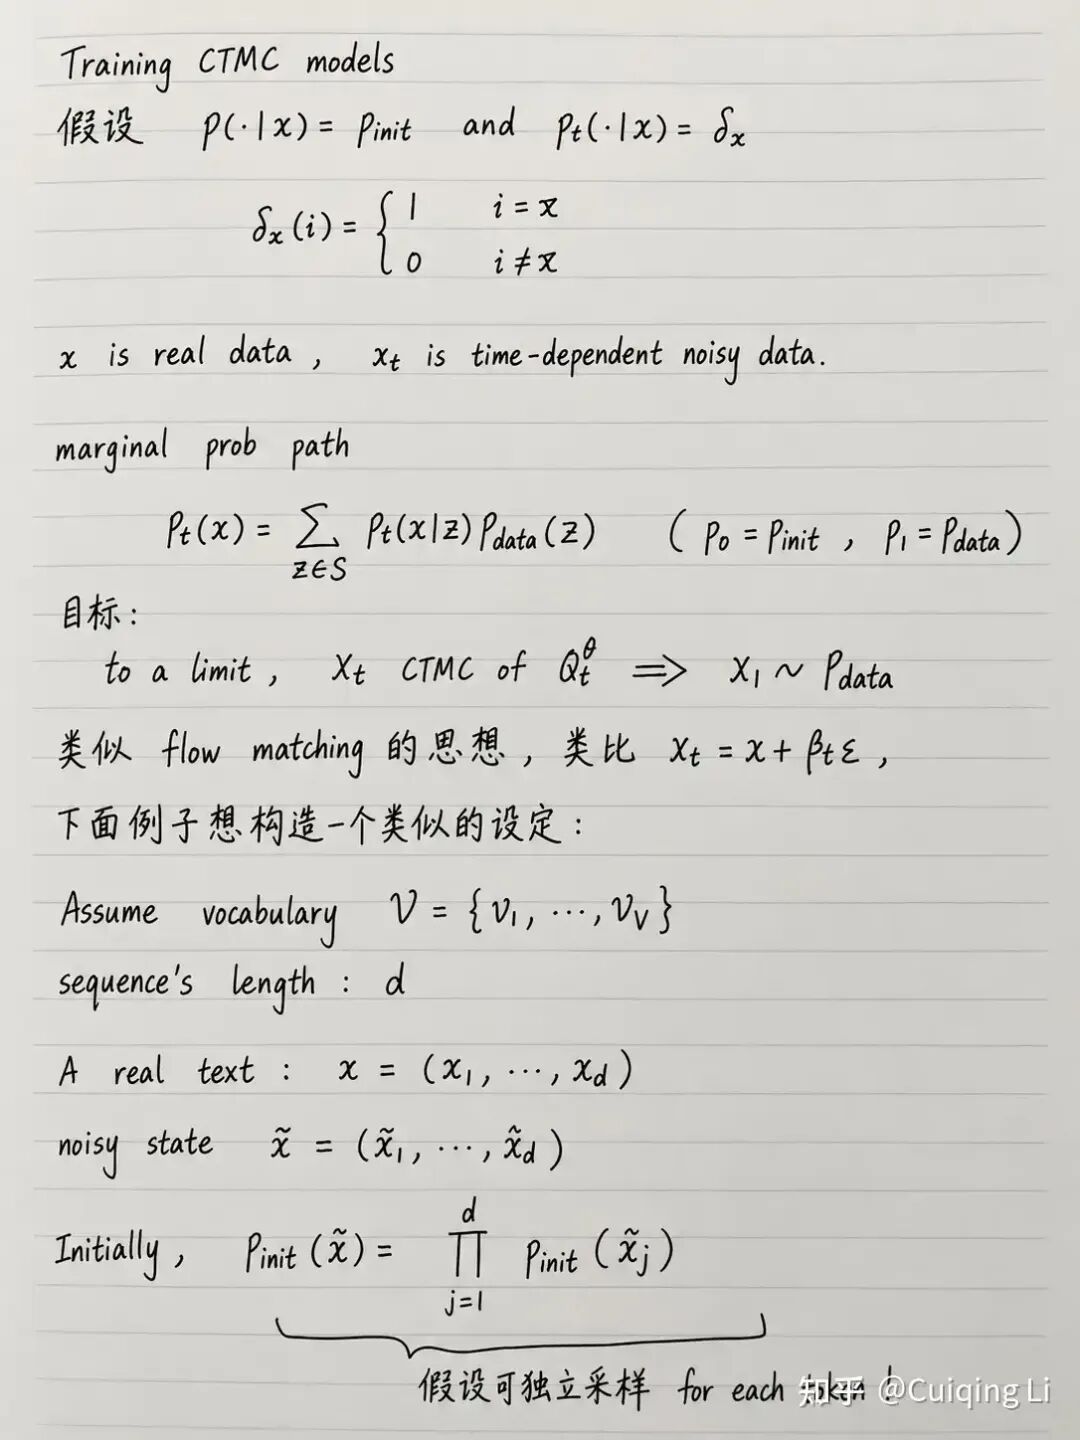
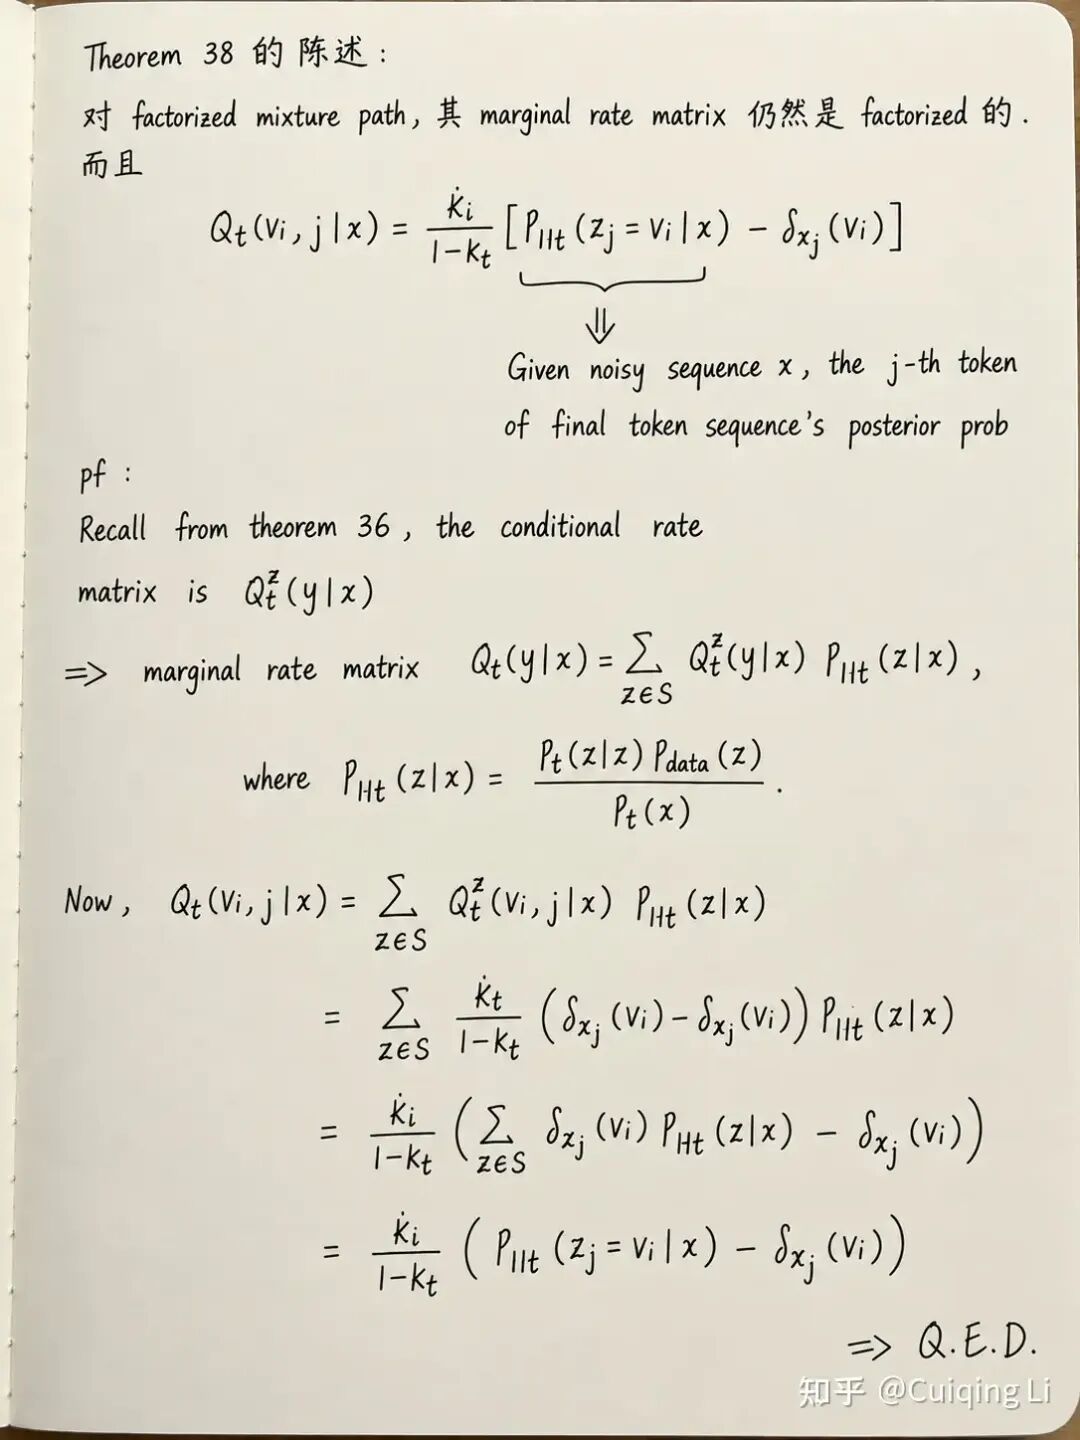
怎么训练?本质上与之前的 flow matching 思路一致:先从条件概率路径推出边际概率路径,再用神经网络去学习原本难以直接处理的 $p(y|x)$。具体推导见下面的笔记:
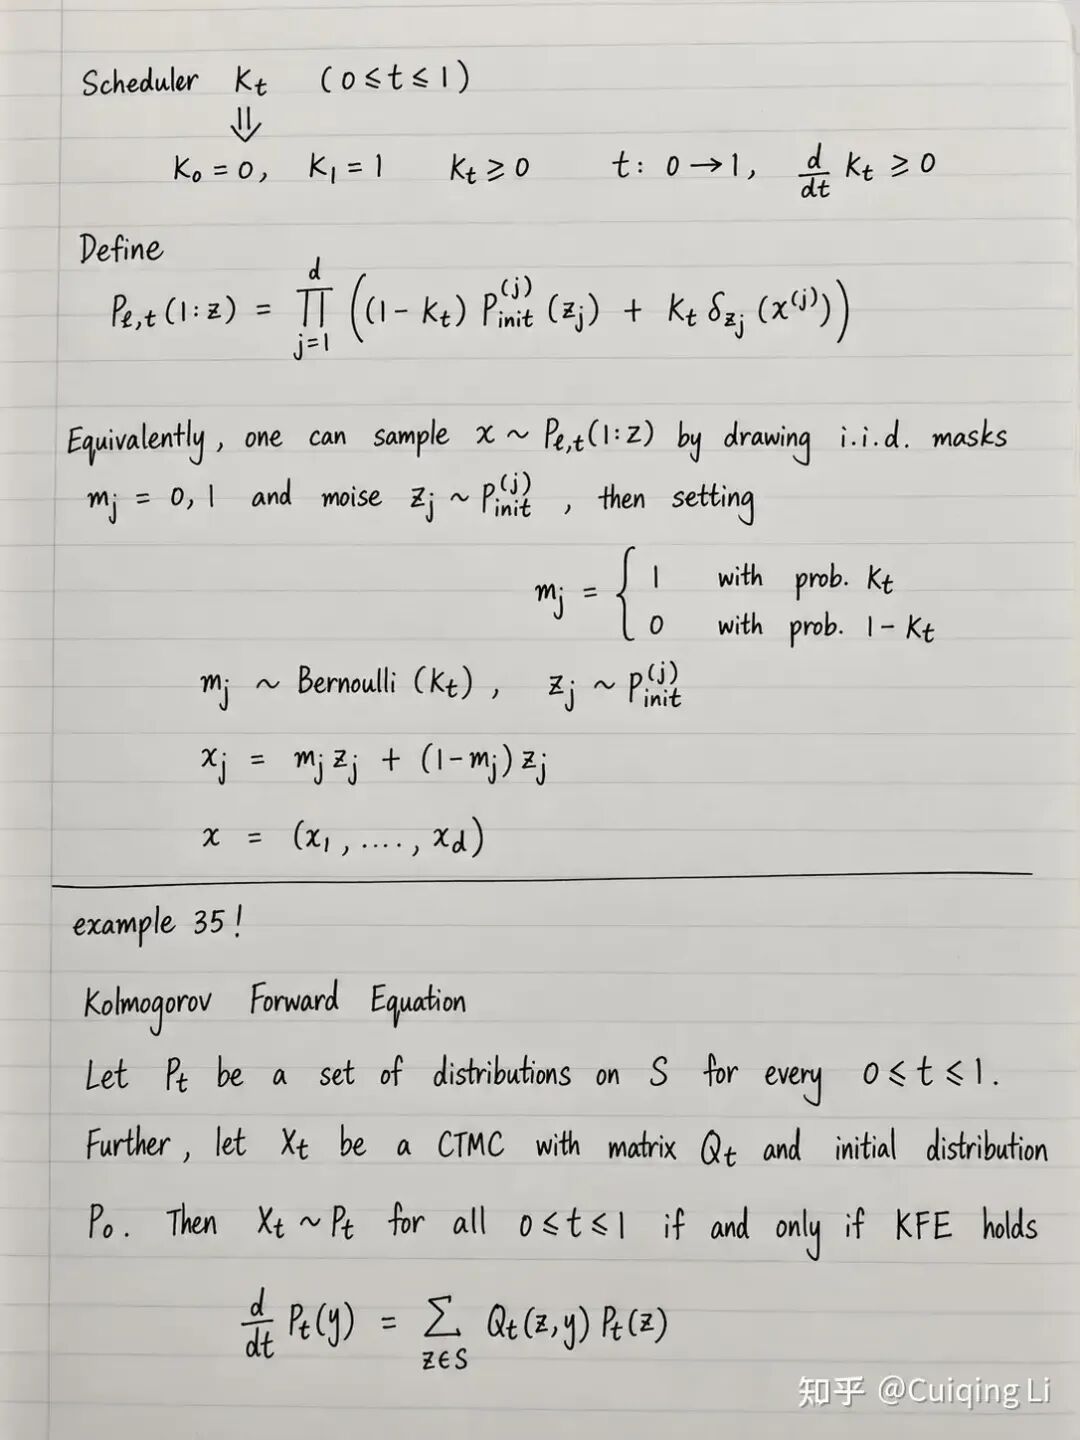
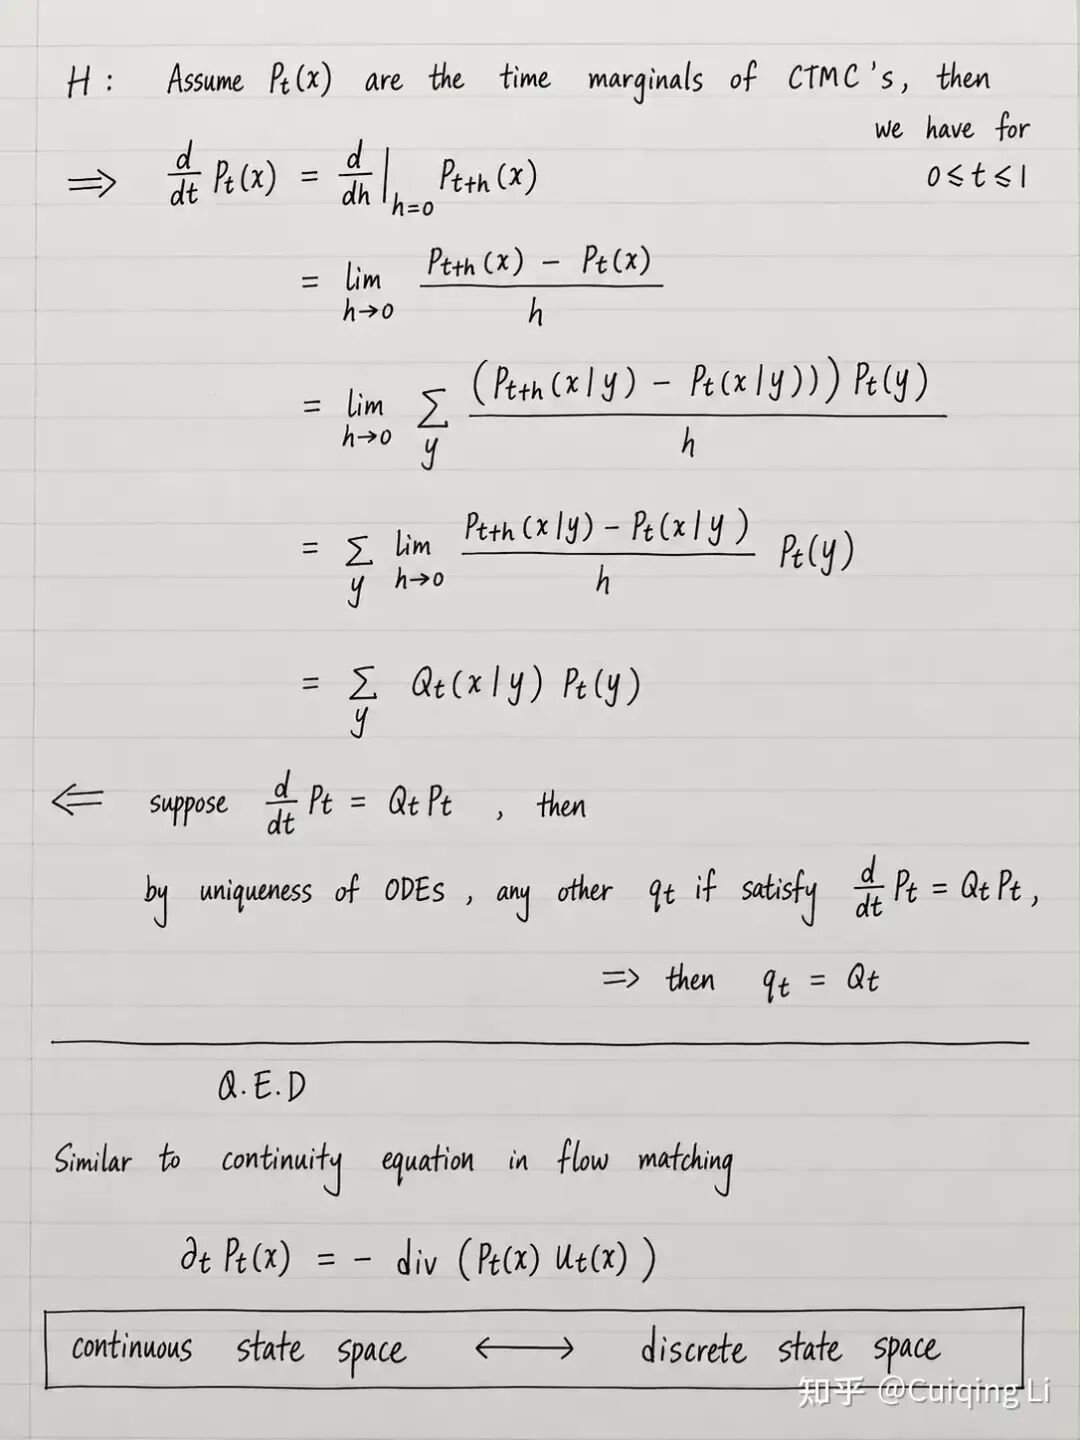
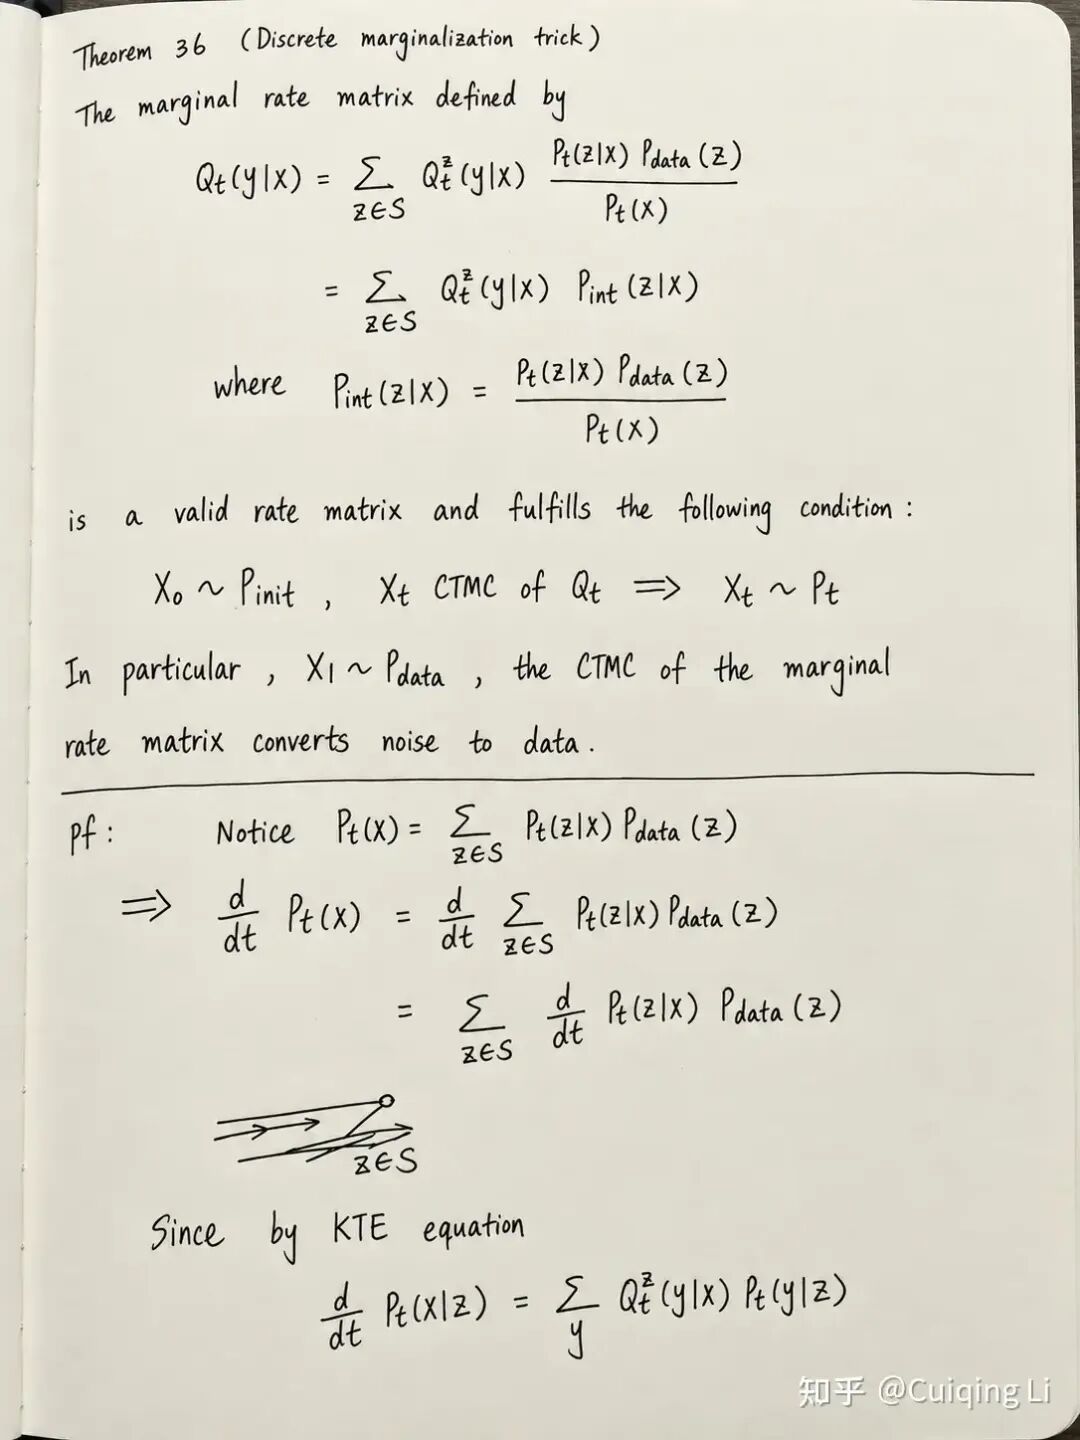
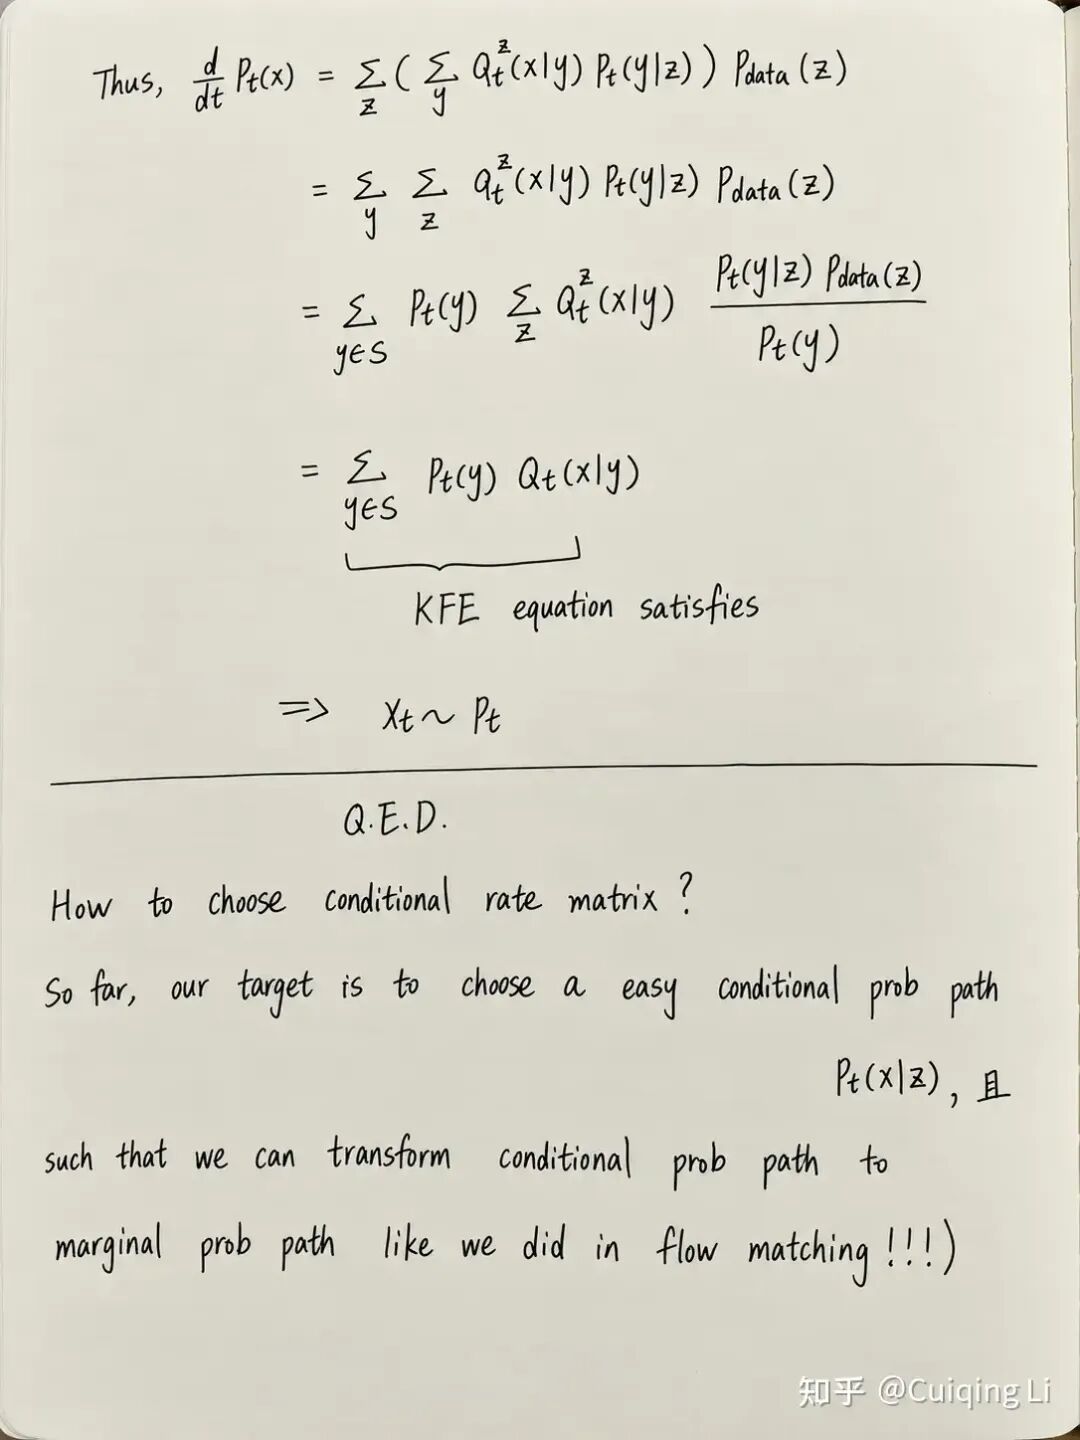
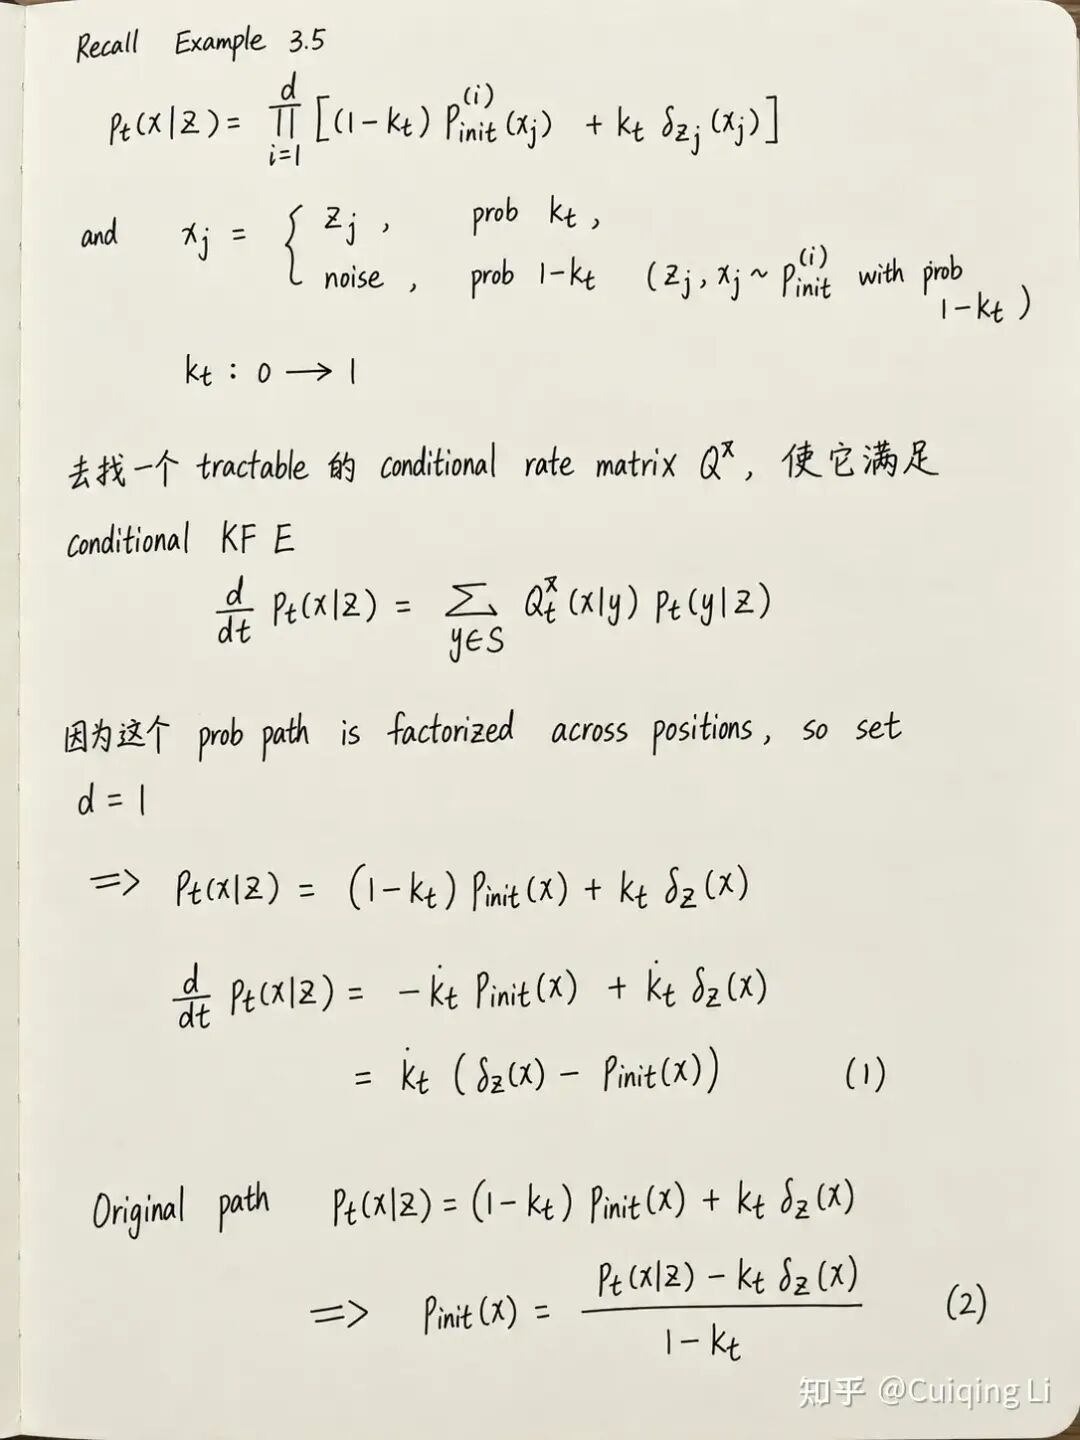
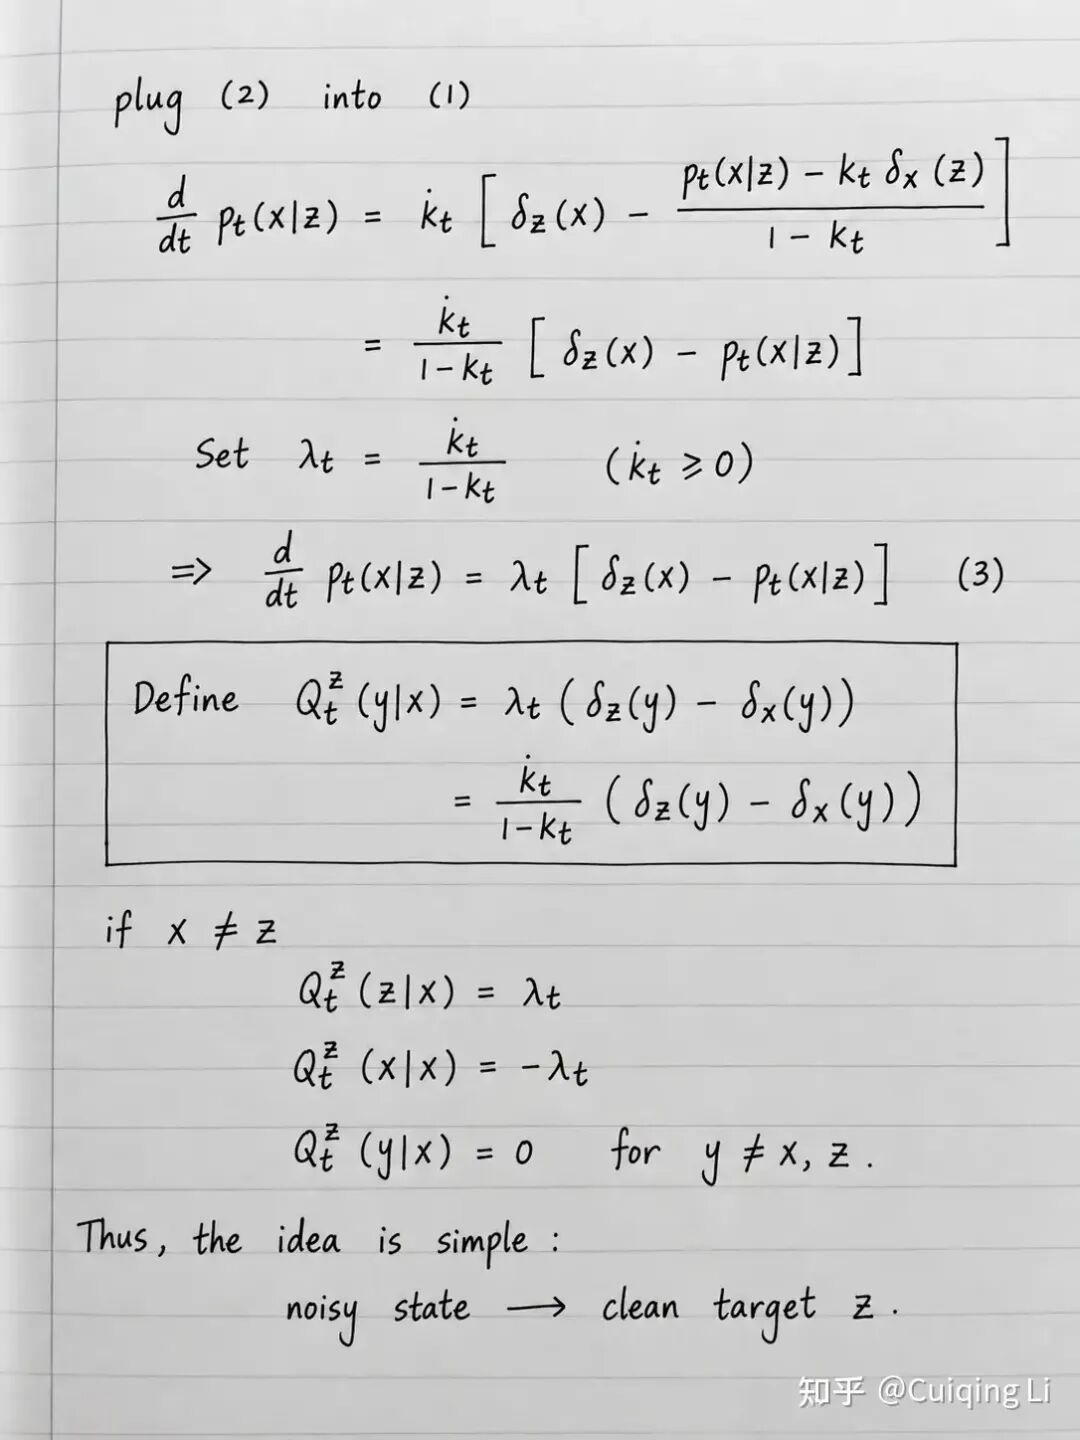
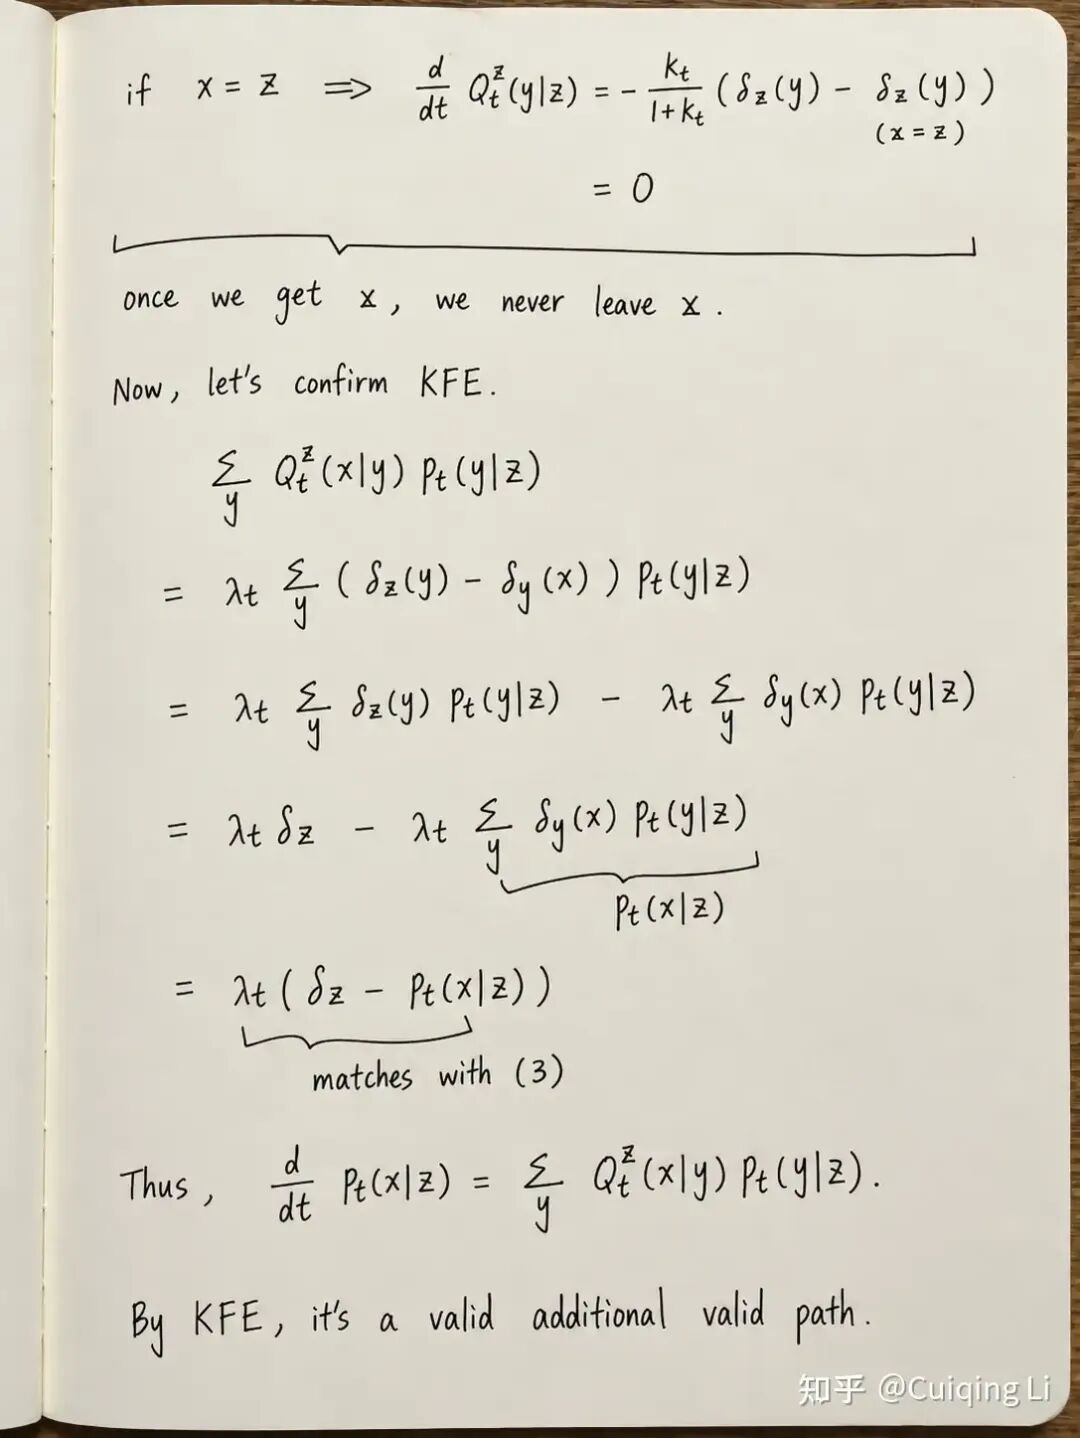
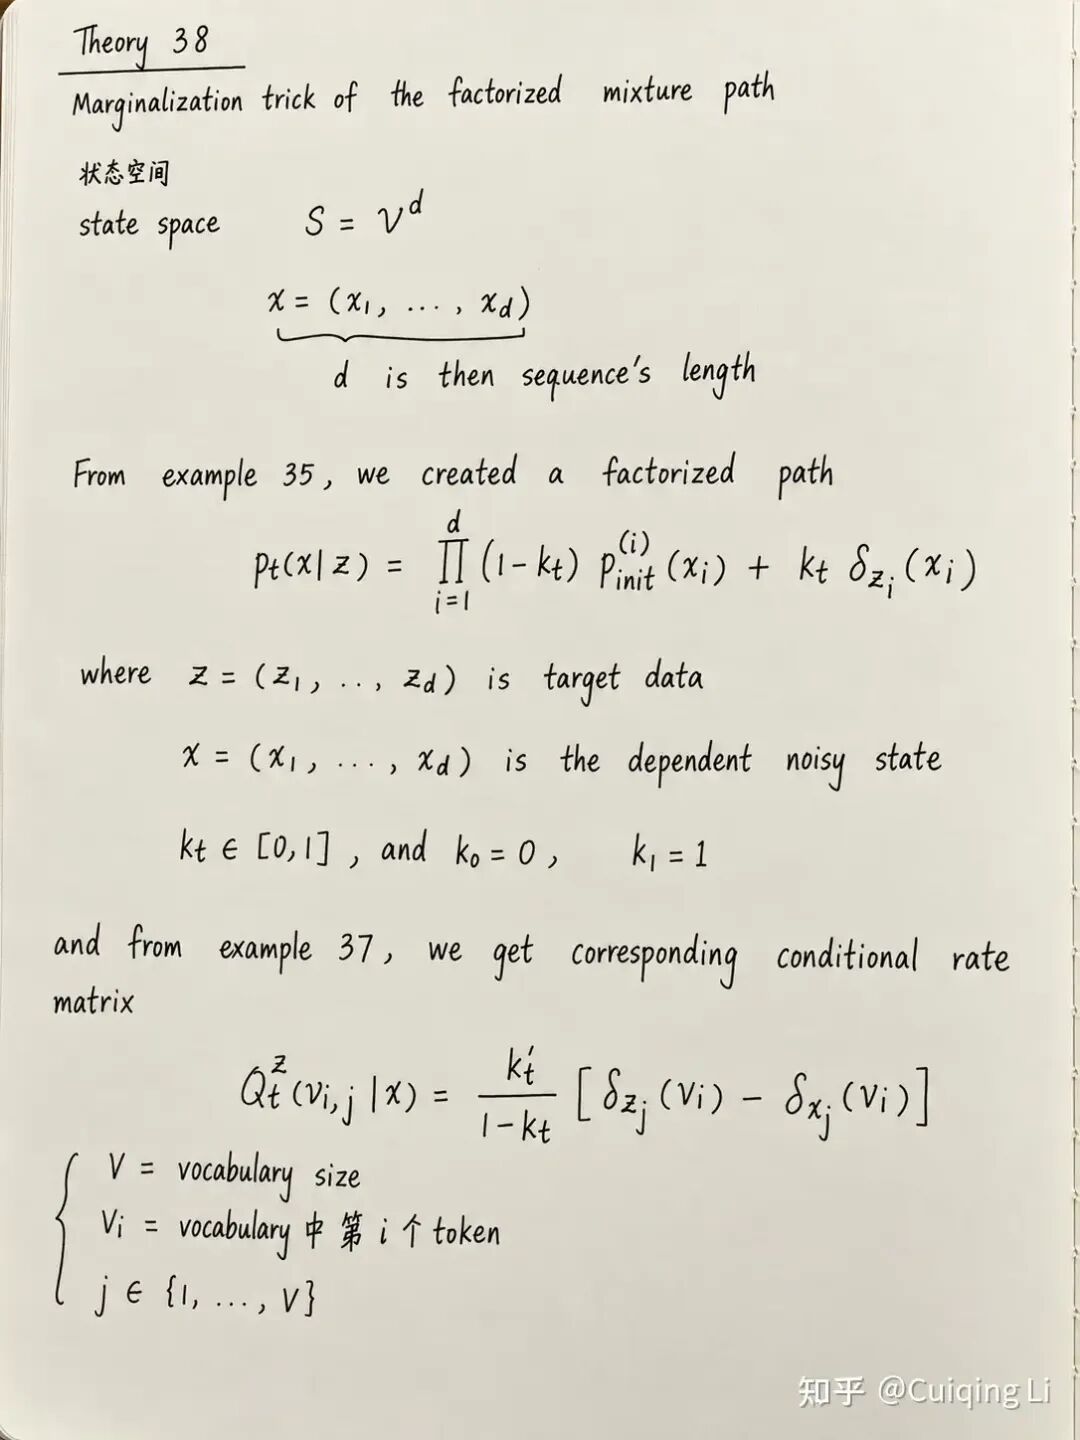
离散流匹配与文本训练
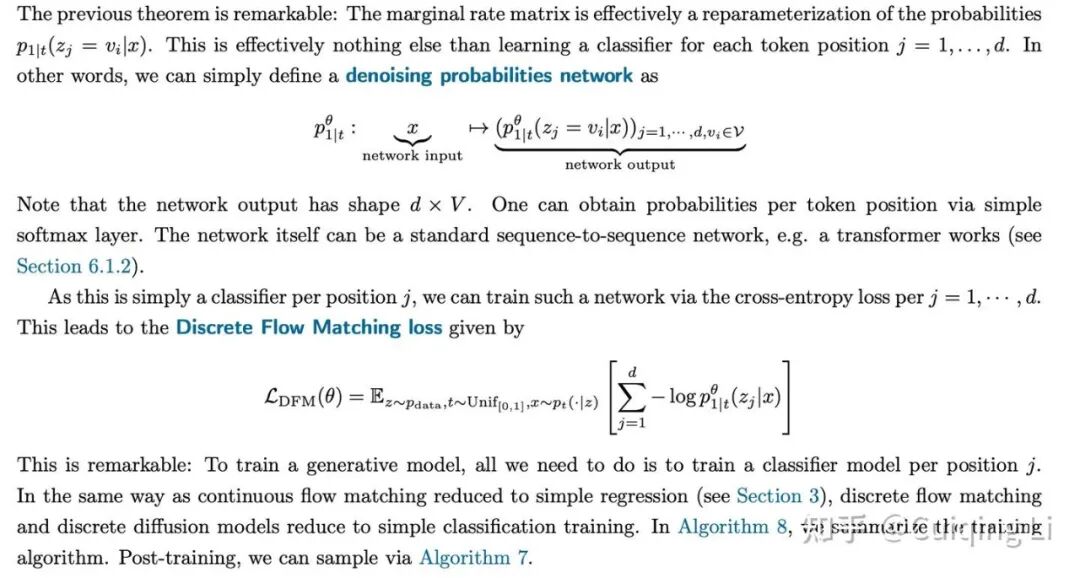
具体到文本扩散模型,神经网络要学习的是 $P_{1|t}(z_j = v_i \mid x)$,其中 $z_j$ 是第 $j$ 个目标 token,$v_i$ 表示词表中的 token。这样做的好处是:可以像 Transformer 那样 mask 掉部分 token,再预测被 mask 的 target token 来训练。相关说明如下:
整体看下来,最关键的还是背后的数学逻辑。训练算法本身并不复杂,核心在于如何引入 flow matching 思想,并把它转化成文本上的 diffusion model。训练算法如下:
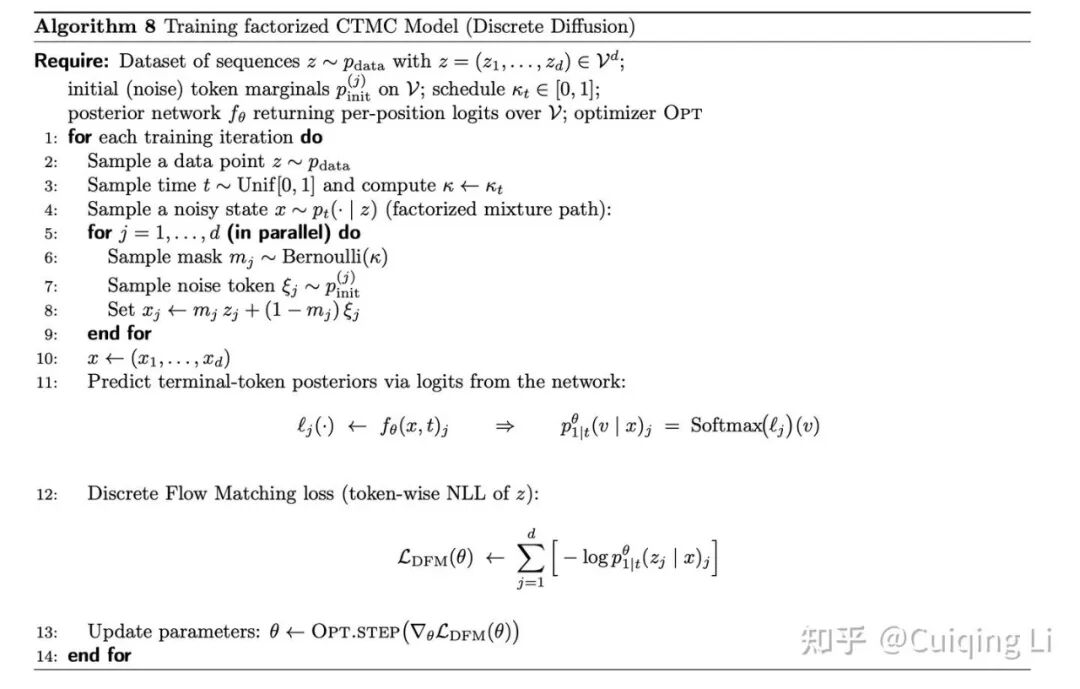
仔细看这个算法会发现它在推理上很友好:token 可以并行处理,而不是 token by token 串行生成。我们写一句话时,往往会反复推敲、逐处修改,直到句子表达准确;传统的 token by token 生成,一旦中间某个 token 出错,误差会向后续位置累积。文本扩散模型这种并行修改的方式,在一定程度上有助于缓解这类误差传播。
参考资料:
- https://diffusion.csail.mit.edu/2026/docs/lecture_notes.pdf
- https://www.youtube.com/watch?v=d0kmyEJN2hI
|  发表于 1 小时前
|
查看: 5|
回复: 0


