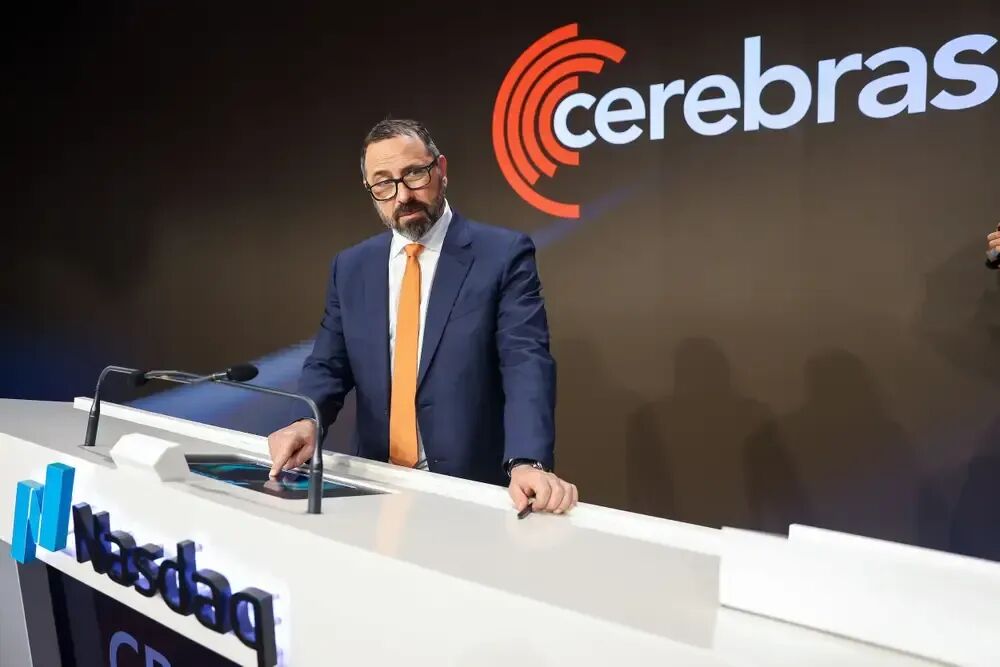
两位身处 AI 建造一线的嘉宾在 All-In 节目中,拼出了超级智能竞赛的全貌。Cerebras 创始人 Andrew Feldman 指出:
- 未来几年投用的数据中心耗电量将超过过去五十年总和,单体建筑用电超过一座中等城市,公司手握 250 亿美元订单积压,厂商追赶的不是未来需求而是昨天的需求;
- 新一代模型的核心是推理,无限 token 意味着无限推理, 而新架构正以远超摩尔定律的速度提升算力。
一、比城市更耗电的数据中心:史无前例的全球 AI 基建
人类正处在一场超级智能竞赛之中。这期节目先后请来两位身处 AI 建造一线的嘉宾:
- 一位是推理芯片公司 Cerebras 的创始人兼首席执行官 Andrew Feldman,公司刚完成上市,手中握着规模惊人的订单;
- 另一位是 Black Forest Labs 联合创始人兼首席执行官 Robin Rombach,潜式扩散算法的发明人之一、开源图像模型 Flux 背后的人。
两段对谈恰好覆盖了当下 AI 浪潮的两端:一端是支撑智能爆发的算力基础设施,另一端是把智能转化为图像、视频乃至机器人行动的生成式模型。
Feldman 首先被问起的,是这轮 AI 建设究竟到了什么量级。在他看来,过去谈软件或硬件,对象通常是芯片或机箱,并不具备真正意义上的物理庞大感;而今天人们谈论的是数据中心,是未来几年内耗电量将超过过去五十年总和的建筑群。
单体建筑有足球场大小,接入的电力超过一座中等城市,而且它们正在美国、加拿大、北欧国家、法国及欧洲各地、中东同时动工, 甚至哈萨克斯坦、塔吉克斯坦、格鲁吉亚、亚美尼亚这些此前不在任何科技版图中心的国家,也在建设成规模的数据中心。几乎每个国家、美国的每个州,都觉得自己必须参与其中。
1.1 250 亿美元积压订单:厂商追赶的是昨天的需求
买下这些算力的人——OpenAI、Anthropic、xAI、谷歌、微软、AWS——胃口远未见顶。Feldman 透露,Cerebras 目前有 250 亿美元的订单积压,而这并非孤例,所有头部玩家都想要更多数据中心。
与科技史上许多"建好自然有人来"的激动时刻不同,这一次厂商追赶的是昨天的需求,不是未来的需求:需求早已被预订,问题只是如何不让客户流失, 客户甚至会在芯片尚未完工时就提前下单。
1.2 从"token 最大化"到像经营业务一样使用 AI
围绕企业疯狂消耗算力的"token 最大化"现象,外界一直有"这究竟创造了多少价值"的争论。Feldman 的判断是,实验性投入必然存在,但净价值依然巨大。
他用两个类比解释:
- AWS 早期企业允许工程师刷信用卡开通云服务,大部分有用,也有一部分让人后悔;
- 1988 年帕洛阿尔托刚开 Costco 时,人们起初逐条货架逛、买回并不需要的东西,熟悉后才变成直奔目标的策略性采购。
企业使用 AI 同样如此,正从"所有人敞开用"转向区分真正高产的环节,以及用开源或廉价模型即可的环节。他还观察到,模型会反过来提醒目标不清的使用者:你正在盲目堆 token,需要更聚焦。
二、推理即算力:当模型开始理解人的意图
主持人回忆,二十年前一位计算机科学家说过,计算机其实很笨,你让它做什么它才做什么;早期提示词工程正是如此,提示词微调一点,答案就剧烈变化。但新一代模型越来越能理解人的真实意图。
Feldman 以 OpenAI 的新模型为例说,使用者不必再当"提示词耳语者",模型会主动补全用户没说出口但确实想要的东西,比如把图表调整成更合适的形式。 两年前人们还无法想象,模型会从优秀的摘要工具、网页检索工具,进化到理解意图、给出方案并把复杂过程全部封装起来。
2.1 无限 token 意味着无限推理
主持人分享了自己当天早上的经历:他通过一个分布式项目获得搭载新版 GLM 模型 的近乎无限算力,让模型每小时搜寻一次尚未被人识别的全球趋势,却在后台看到模型自我辩论应该去 Hacker News、Reddit 还是 Instagram 找线索。
Feldman 指出,这正是在观看一个推理模型工作。在他看来,无限 token 就意味着无限推理:这些模型连续运行 25 到 48 小时就能给出惊人结果, 若借助 Cerebras 快约 15 倍的机器跑上 24 小时,相当于得到数周乃至数月的思考量。他感慨,Ilya 与 Sam 早年预言的这一天正在兑现,他们能看到拐角之后的景象;主持人也回忆 Sam 曾把"下一步"概括为理解意图、制定策略、与其他智能体互相校验,这与"猜下一个词"已有天壤之别。
Feldman 强调,推理的本质是推理时计算,内部要消耗海量 token;正因如此,速度极快的机器才让这类工作变得可行,不至于因等待过久而失去意义。他随身带着一枚早期晶圆级芯片,那是最早生产的八到十枚之一,单枚造价约五亿美元,被他笑称像八岁男孩把越野摩托搬进卧室。
2.2 打破摩尔定律的新架构
谈到推理领域是否有自己的"摩尔定律",Feldman 表示,此前所有处理器都遵循约十八个月翻倍的摩尔定律,而 Cerebras 用新架构开辟了一条更陡的轨迹,他预计未来十八个月内性能提升将远超两倍。原因在于,GPU 这类已有二十年历史的架构,继续进步主要依赖制程节点缩小; 而年轻架构仍有大量空间,可以通过理解负载本身做出优化,获得巨大增益。
三、自研芯片、开源模型与智能主权
主持人问到,在需求如此旺盛、客户又如此强势的情况下,如何经营一家必须以极快速度招人、定路线图、交付部署,并跟上 OpenAI 这类史上最快组织之一的公司。 Feldman 承认这些客户要求极高、绝不好应付,但当前需求大到没有一块硅片会被闲置。
3.1 没有人愿意被单一供应商绑定
如何看待 OpenAI 自研芯片、亚马逊自研芯片的趋势?这究竟是向英伟达施压定价的姿态,还是未来真要亲自下场?
Feldman 认为核心在于没有人喜欢受制于人:x86 时代超大规模云厂商曾依赖英特尔,GPU 厂商也曾依赖少数几家云厂商,于是后者转而投资新型云厂商以扩大客户群。自研芯片的本质,是把命运的关键部分握在自己手里; 企业不必做出最快的芯片,但不能完全依赖他人的芯片,这是非常理性的选择。
3.2 开源补位、受监管行业与智能主权
主持人提到自己很早就开始使用开源模型,随着智能路由的普及,开源模型在推理能力上的差距今年骤然缩小。Feldman 用"不会开法拉利去买菜"作比:困难的前沿问题需要 OpenAI、Anthropic、Gemini 这类前沿模型, 但企业里大量工作是把数据从一个系统剪切粘贴到另一个格子,这类"剪切粘贴经济"并不需要金牌数学水平,需要的是稳定可靠的开源模型能力,企业一般行政费用中有相当大比例并非发明创造。
另一张被翻开的牌是数据泄露顾虑与智能主权。金融、医疗等受监管行业受 HIPAA、FINRA 等规则约束,要求模型本地部署、留在境内,并倾向于更可控的开源版本。Feldman 证实这种需求确实存在,认为 OpenAI 此前开源 OSS 120B 是一步好棋,但美国需要更多本土开源模型给世界选择,否则当下的选择基本只剩少数美国开源模型与中国模型。
英伟达同样看到机会,却因要直面与大客户竞争的尴尬而相对谨慎;而 Cerebras 处在更中立的位置,同时运行 GLM、KIMI、Qwen 等模型、OpenAI 的闭源模型、葛兰素史克的自研模型,以及阿联酋合作伙伴 G42 的模型。他判断,智能主权已是明确趋势,而美国政府围绕新模型发布的审慎动作,在欧洲尤其敲响了警钟。
四、安全与监管:一场没有剧本的首演
讨论转向围绕前沿模型分阶段发布的争议。主持人坦言美国当下党派对立严重,外界很难区分哪些是安全考量、哪些是政治博弈,并询问 Feldman:新模型是否真的对网络战、网络攻击构成重大威胁,按计划分阶段发布是否明智。
4.1 分阶段发布为何并不离谱
Feldman 没有评判具体时点是否恰当,但他认为,当一个模型的创造性思维强到足以构成实质性威胁时,政府希望企业分步发布并不离谱,正如强效药品要分阶段上市。他不赞成 FDA 式堆积七年试验与海量文书的做法,但让政府先做红队测试、检查国家基础设施能否挡住攻击、争取两三周修补明显漏洞,这样的要求完全合理。
他认为两极分化严重损害清晰思考,而行业没有现成剧本,护栏本身也需要从零设计;他还透露过去六周的一个发现:护栏会增加延迟、让产品显得更慢,高速芯片恰好能缓解这种代价。在他看来,人们需要 Dario 与 Sam 疯狂竞争,正是这种竞争逼得谷歌、亚马逊全部变得更强;不应成为一个第一反应就是监管的地区,但行业也理应更好地自我约束。
主持人补充了网络安全公司 Palo Alto Networks 负责人 Nikesh 的例子:新模型在一小时内找出了他们此前不知道的数十个关键漏洞,公司不得不停下所有工作,花六周打补丁。两人都认为,这正说明 强大工具需要先在小范围验证,正如 iPhone 存在面向安全、普通用户无从加入的内部测试版。
4.2 为必然发生的泄露提前做好准备
Feldman 引用巴菲特谈再保险业的逻辑:你知道坏事一定会发生,只是不知道何时,所以必须提前储备。大规模数据泄露必然出现,往往还是没人考虑过的黑天鹅;但知道存在"未知的未知"本身就是有用的起点。
主持人则分享了自己的提示词习惯:每次任务结尾都要求模型检查自己的工作、指出目标中尚未考虑之处并反问问题,效果截然不同。Feldman 对此深有共鸣,他回忆融资十年间听过最聪明的提问,是"在我问过的问题之外,你听到的最聪明的问题是什么"; 如今同样可以要求 AI 拓宽视野,替人提出那些自己还不知道怎么问的博士级问题。
五、递归学习与通往超级智能之路
5.1 按二十年前的任何定义,AGI 都已经到来
在 AGI 与超级智能的定义问题上,两人的判断相当一致:按照十年、二十年乃至半个世纪前提出的任何标准,图灵测试早已被击穿,AGI 实际上已经到来,只是尚未完全部署。当年科幻作家提出的问题如今全部有了答案,恐怕已经提不出新问题。Feldman 提醒,要认真倾听那些听起来像边缘人的声音:Ilya 在八九年前谈安全、马斯克谈把火箭发射成本降到近乎于零,当时都像天方夜谭,后来全部被证实。
5.2 循环最大化:以果蝇速度完成数千代进化
主持人提到,工具已经开始参与建造工具,递归循环刚刚被人们大规模使用,他甚至被自己的趋势模型"推送"了一个新词——循环最大化,随后这个词真的在人群中流行开来。Feldman 解释,Sam、Ilya 以及后来的 Dario 等人五六年前就看到,强大的递归收益是指数级的:提问、从结果中学习、再问一次,答案覆盖更多材料、质量大幅跃升,如此往复,产出的不是略好一点而是远好于从前的答案。 最迷人的未知问题是:不断投入算力,指数曲线究竟会在何处停止。
他进一步指出,当智力问题被逐步解决,剩下的难题会变成"人的问题": 如何组织人完成 AI 给出的方案、如何激励团队、减少协作摩擦。 主持人半开玩笑地设想,当智能走进物理世界,也许可以派一千台机器人去得州或内华达的一百英亩土地上再造一座凡尔赛宫;这听起来奇幻,但凡尔赛宫对亲手建造它的人同样奇幻。
Feldman 接过比喻:古代大型工程往往由同一个石匠家族的三到四代人接力完成,知识在代际间传递;而人类学习受限于十五到二十年一代的节奏,AI 却像遗传学偏爱的果蝇,一天就能迭代两代,相当于在极短时间内完成数千代学习,达尔文若看到这种进化速度也会惊叹。主持人则想起库恩的观点:范式不会自己消亡,持守范式的人会消亡,而 AI 正在把这种代际间隔压缩到极短。
5.3 富足账本:把收益与代价同时写下来
面对外界大量悲观预测,Feldman 是鲜明的技术乐观派。他承认经济中必然出现错位,正如汽车出现后,赶马车的人和造马车的人处境艰难;但必须同时算一笔账:借助这项技术,我们的孩子以及他们认识的人,有机会不再因癌症离世,无限的能源、热量、知识、教育与住房并非空话。
他以教育为例:亚里士多德曾是亚历山大大帝的老师,苏格拉底也以个别对话育人,人类一千年前就知道因材施教效果最好,却一直选择按中等水平批量教学;而 AI 让为每个孩子配备适配其学习方式的导师成为可能。只要认真、公平地把利弊同时写下,账本会明显地偏向富足一侧。
六、从潜式扩散到世界模型:生成式 AI 的另一条主线
节目的后半段,镜头转向 Black Forest Labs 的 Robin Rombach。公司名字取自他长大的黑森林山区,总部位于德国弗赖堡与旧金山,成立两年,团队刚超过一百人。Rombach 与联合创始人早年在慕尼黑读博期间发明了潜式扩散算法:其原理与 JPEG、MP3 一脉相承,即把图像、视频、音频等自然数据压缩成高效表示,再在其上训练 Stable Diffusion 以及今天几乎所有图像、视频乃至物理 AI 生成模型都建立在这套基础算法之上。
6.1 生成视频,就必须理解世界
Rombach 介绍,公司现在主攻同时以图像、视频、音频预训练的多模态视觉模型,并进入一个新范式:把生成能力与动作预测结合,让同一个模型既能生成图像、视频、音频,又能预测动作,最终部署到真实世界的机器人身上。主持人把这概括为:要生成一个关于世界的视频,前提就是理解世界及其中的物体。Rombach 认同这一直觉,并区分了两种互补的智能:直觉式智能与深度推理层,完整的智能需要二者互动;他们选择从更省算力的图像这一直觉侧切入,而视频预训练会让模型隐式学到真实世界的物理规律,动作预测与机器人能力便由此生长出来。
针对"生成式 AI 像老虎机、结果不可控"的批评,Rombach 的回答是尽可能多地向用户和开发者暴露操控层:从最初的文生图,到文加图的图生图,可基于真实或生成图片反复编辑,再到多张图片加文本的语义融合, 如今同样的路径正在视频上重演,而最有趣的阶段是所有模态在同一个模型里互为输入输出。
6.2 AI 是一种媒介:斯科塞斯看重的是什么
Black Forest Labs 正与马丁·斯科塞斯合作。Rombach 强调,AI 模型是一种媒介,他们不会去教斯科塞斯这样的导演该怎么使用它。他回忆多次与斯科塞斯同处一室的场景:导演脑中已有某个东欧村庄的画面,他口头描述,团队生成图像、再据反馈迭代,最终导演本人总结说,这种方式最大的价值,是把头脑中的画面变成可视化的东西,让沟通变得更容易。Rombach 解释, 语言本质上是一种有损的沟通媒介,同一句话会被不同人解读成不同样子,而图像与视频携带的信号极其丰富。他并不认为用视频模型一口气生成整部电影是终极目标,真正有趣的成果往往出现在"人在回路中"(Human in Loop)、把模型当作媒介反复迭代的时候。
主持人补充了电影工业的传统:雷德利·斯科特习惯亲手画分镜,斯皮尔伯格为《夺宝奇兵》画草图,乔治·卢卡斯长期雇佣专职分镜师,因此最先被 AI 改变的正是头脑风暴与前期可视化环节。创业圈的变化同样直接:过去一支产品发布视频要花 10 万到 25 万美元,如今创业者与一位导演花一两周就能完成。
6.3 从绿幕到机器人:生成式模型进入生产环节
更实质的生产应用也已出现。主持人转述演员盖尔·加朵的经历:一部预算 3000 万美元的比特币题材电影,全程在摄影棚拍摄、不搭实景、不用绿幕,所有背景由生成式 AI 完成;若按传统方式搭景,成本约为 1.5 亿美元,影片根本不会被立项。Rombach 确认这类生产级用例已经出现,高端电影是要求最苛刻的场景之一;他提醒人们注意技术轨迹,他读博时只能生成 64×64 像素的图像,如今已能生成高分辨率、时长数分钟的视频,且进步不会停止,但人在回路中的生产工具始终重要。
真正让他兴奋的是技术的通用性:同一个模型既能拍电影,也能成为机器人的大脑。他解释,这条路线由感知、预测与动作预测共同驱动,模型必须先看懂视觉输入,才能改造内容、描述场景或预测下一步动作。至于机器人如何获得训练数据,他描述的目标是像语言模型一样进行上下文提示,直接告诉机器人"去调一杯鸡尾酒";现实中不同机器人硬件的动作表示各不相同,目前仍需数小时微调数据适配具体任务,走向上下文学习仍是研究课题。
6.4 IP 方的选择题,与粉丝创作的未来
面对迪士尼这类坐拥庞大 IP 库的公司,Rombach 的思路是分层处理:面向公众的工具会禁止生成特定 IP;同时与 IP 持有者基于开源模型或更强的专有模型联合开发定制模型。他设想,随着模型更快、更具交互性,流媒体平台上会出现大量互动式创作工具。主持人则看好粉丝创作:卢卡斯当年允许非商业粉丝短片,甚至公开光剑制作教程与音效,如今人们用 AI 重现星战宇宙中未被讲述的故事,相关系列单条视频已达数百万播放;未来 IP 方可以通过授权费、软件租赁或按产出计费,让粉丝在合规框架内自由创作。Rombach 对此高度认同,每个人读书看电影时都有"这里本可以另一种走向"的念头,技术第一次让这些念头可以被看见。
访谈末尾,Rombach 介绍公司刚超过百人,正在德国与旧金山同时招人,方向包括大规模模型训练、扩散模型与流匹配研究、面向客户与 IP 方的前置工程、大规模算力集群基础设施等。在他看来,企业因可控性而需要开源,又因精细化能力而需要前沿专有模型,两条路线并行,正是公司的机会所在。
结语:一条从电力到世界模型的完整链条
把两场对谈放在一起看,这条产业链条就清晰了。Feldman 负责的是底层:足球场大的数据中心、五亿美元一枚的晶圆芯片、250 亿美元的积压订单,电力、硬件和交付节奏决定了智能的成本与上限;Rombach 负责的是上层,模型把这些算力变成图像、视频,最终变成机器人理解和改变现实的能力。底层支撑上层,上层为底层找到用途,二者缺一不可,也恰好解释了算力公司与生成式模型公司为何会在同一波浪潮里彼此成就。
这场建设的速度超出了所有人的既有经验:需求跑在供给前面,客户提前数年下单,技术每隔几个月就跨过一道旧门槛,按二十年前的标准,AGI 其实已经到来;与此同时,开源与智能主权成为结构性趋势,监管、安全和就业错位却没有现成答案,只能边跑边摸索。
两位嘉宾都不回避风险,但都认为比起恐慌,更该做的是把利弊同时算清楚:AI 有望帮助攻克疾病、让因材施教成为常态、把知识和工具送到更多人手里。 无论模型多强,人在回路中的判断仍然重要,未来不会自动变好,它取决于建造者是否审慎,也取决于每个普通人如何理解和使用它。
 发表于 1 小时前
|
查看: 3|
回复: 0


