LLM 输出是概率的,但下游要确定性。Structured Output 把概率输出约束为 JSON 接口。
为什么需要 Structured Output
lora_finetune 项目里的 eval.py 用「取第一个非空白字符」做 高/中/低 三分类,34 条测试集上准确率 29.4%([07 LoRA 微调])。模型吐出「对不起,我无法判断」,首字「对」,期望「高/中/低」全落空。三个失败混在一起:代码解析失败、模型答案错、接口格式错,分不清下一步该改 prompt、模型、还是解析函数。
一、痛点:lora_finetune eval 三种错混在一起
取第一个非空白字符,期望命中「高/中/低」。34 条测试集跑出 29.4%,三种失败合在一起:
- 模型吐「抱歉,超出能力范围」,首字「抱」:解析失败
- 模型吐「中」,首字命中但真实标签是「高」:答案错
- 模型吐「属于高严重度」,首字「属」落空但答案对了:格式错
代码表现一样(首字不匹配),但根因分两类:第 1 种(吐「抱歉」)和第 3 种(答对但首字落空)都是输出格式问题,属于接口;第 2 种(首字命中但真实标签错)是模型能力问题。
把这三种混进 29.4%,分不清下一步该改 prompt、模型、还是解析。Structured Output 解第 1 种 + 第 3 种(接口,对应 schema_validity),LoRA 微调解第 2 种(能力,对应 accuracy)。两件事正交,不能用同一组数字评。
二、3 种方法:把输出约束为 JSON
Structured Output 不是单一技术,而是三种工程方法的合集:
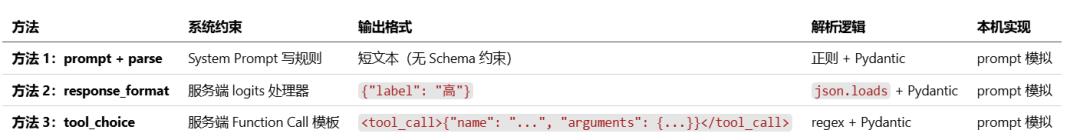
表前 3 列是 OpenAI / Anthropic 服务端的真实形态:服务端 logits 处理器在生成阶段拦截掉不符合 Schema 的 token。Anthropic 2025-11 上线原生 Structured Outputs(Claude Developer Platform),之前只能靠 tool use 模拟。
最后一列「本机实现」是本项目实情:transformers 直推 Qwen2.5-0.5B-Instruct 没有 constrained decoding 能力,方法 2/3 退化成「prompt 要求 + 解析时硬校验」(端侧 Outlines / vLLM / Guidance 是另一条路)。本机 benchmark 数字 ≠ OpenAI 上对应方法的真实数字。
方法 1(prompt + parse) 最轻,只动 prompt 和解析。System Prompt 写「只输出一个词:高、中 或 低」,生成后正则匹配:
def predict_prompt_only(text):
    raw = _generate(SYSTEM_PROMPT_M1, text, max_new_tokens=8)
    m = re.search(r'[高中低]', raw)
    return Severity(label=m.group(0)).label if m else None
任何模型都能用,但模型行为不可控,碰到「不确定」「抱歉」就落空返回 None。
方法 2(response_format 模拟) 把输出约束到 JSON。System Prompt 改成「严格按 JSON 格式输出」,下游 json.loads() + Pydantic 校验:
def predict_response_format(text):
    raw = _generate(SYSTEM_PROMPT_M2, text, max_new_tokens=32)
    try:
        return Severity(**json.loads(raw)).label
    except (json.JSONDecodeError, ValidationError):
        return None
比方法 1 多一层 try/except。OpenAI 上对应原生 response_format={type: "json_schema", schema: ...}(MCP 协议),本机没有 logits 处理器只能 prompt 要求 + 解析硬校验,但 JSON Schema 标准(多字段、嵌套、严格枚举值)由 Pydantic 校验保证。
方法 3(tool_choice 模拟) 把输出约束到 Function Call。System Prompt 改成「调用 classify_severity 函数」,下游从 <tool_call> 标签抽 arguments:
def predict_tool_choice(text):
    raw = _generate(SYSTEM_PROMPT_M3, text, max_new_tokens=64)
    m = re.search(r'<tool_call>\s*(\{.*?\})\s*</tool_call>', raw, re.DOTALL)
    if m is None:
        return None
    return Severity(**json.loads(m.group(1))["arguments"]).label
比方法 2 换的就是包装层:json.loads(raw) → json.loads(m.group(1))["arguments"]。OpenAI 上对应 tools=[...] + tool_choice="required"([06 从 Chain 到 Graph]),「必须调函数」的语义让 Agent 工具链 可追溯。代价是 prompt 模板更长,max_new_tokens 从 32 提到 64,给两段式思考留余量。
方法 1 够用就够用(短任务、单字段),方法 2 支持 JSON Schema 标准(多字段、Pydantic 校验),方法 3 是 Function Call 标准封装(工具语义、调用链可追溯)。
三、benchmark:3 方法在 34 题 test set 上的数字
3 种方法在 lora_finetune 34 题 test set 上跑一遍,结果如下:
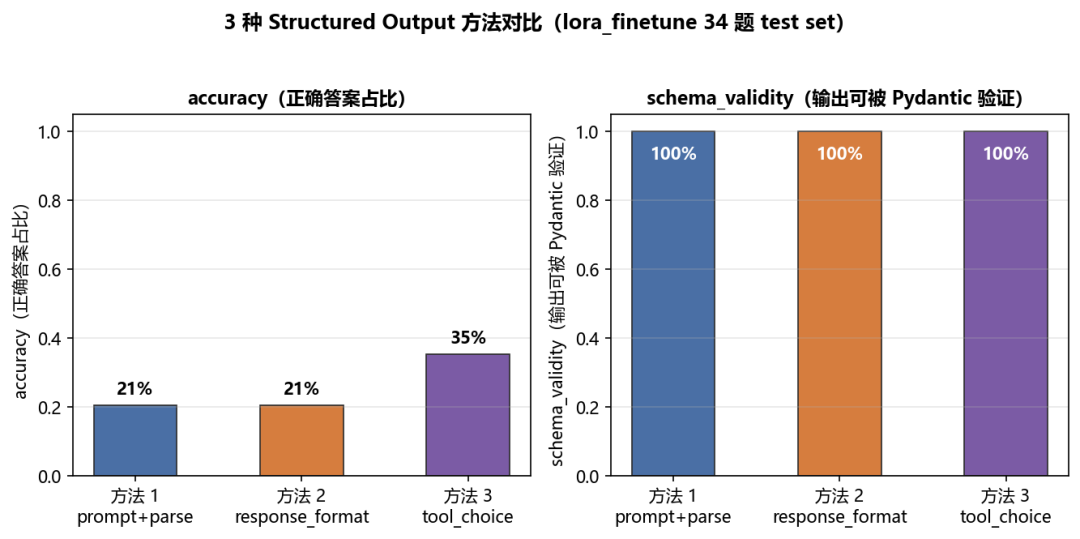
3 方法在 34 题 test set 上的 schema_validity 和 accuracy(base 模型,无 LoRA adapter):
| method |
schema_validity |
accuracy |
| prompt_only |
1.0 |
0.2059 |
| response_format |
1.0 |
0.2059 |
| tool_choice |
1.0 |
0.3529 |
第一个数字 schema_validity 是头条:3 种方法都做到 1.0,34 道题全部能解析成有效 JSON 或标签。下游代码不必再写容错分支,以前要 if pred is None: log + fallback,现在直接 Severity(**data) 用就行。
第二个数字 accuracy 是 base 模型的天花板,0.2059 / 0.2059 / 0.3529,都没过 0.4。Qwen2.5-0.5B-Instruct 没在环境违法定级数据上微调过,零样本上限就是这个区间。方法 3 的 0.35 略高,但 34 题下 0.15 的差异等于 5 题波动,未达统计显著。
四、上生产:retry 兜底 + 落地清单
schema_validity = 1.0 是单次实验的结果。生产里模型会偶发失败,retry 是把它稳住的工程动作。
retry 三件事:指数退避避雪崩(首次失败不 sleep,第二、三次等 1s / 2s);最大次数 3 次;副作用类请求(写库、发邮件、发通知)必须带幂等键去重,避免重试触发重复副作用(LLM 应用系统设计)。
import time

def predict_with_retry(fn, text, max_retries=3):
    for attempt in range(max_retries):
        try:
            result = fn(text)
            if result is not None:
                return result
        except Exception as e:
            print(f"[WARN] attempt {attempt} failed: {e}")  # 项目里换成 logging
        if attempt > 0:
            time.sleep(2 ** (attempt - 1))  # 1s, 2s(首次失败不 sleep)
    return None
落地 Structured Output 有 3 件必做:
- Pydantic Schema 定义:所有输出字段先在 BaseModel 里写一遍,再喂给 prompt / OpenAI json_schema
- 解析失败日志:每次 schema_validity 失败记原始输出 + 错误信息
- retry 上限 3 次,超过就 fallback
回到开头那句话:LLM 输出是概率的,但下游要确定性。Structured Output 把概率输出约束为 JSON 接口。
schema_validity = 1.0 是 Structured Output 的目标,accuracy = 0.21-0.35 是 base 模型的天花板。前者用 3 种方法解决了,后者由微调去解决(准确率能提到 0.91)。接口用 Structured Output 稳,能力用微调提,两条独立的工程动作。
Structured Output、LoRA 微调这些工程细节的更多讨论,可以到云栈社区继续聊。
 发表于 1 小时前
|
查看: 10|
回复: 0


