今天是2026年10月5日,星期一,北京,天气晴。假期第五天,继续看技术趋势。
RAG方向的论文现在都还有吧?把范围限定在2026年6月至今,大家都在研究啥?怎么研究的?有什么结论?先来看整体趋势。
另一个进展,继续做技术总结。在之前的文章《技术总结:Agent Memory绿皮书及Jev技术白皮书继续对内发布》(https://mp.weixin.qq.com/s/ILcTkboB5I8owEQcRg5rHg)中,已经完成了Agent Memory这本书的整理和发布。今天,云栈社区继续对内发布《Agent Harness 技术蓝皮书》,作为系列的补充,这里做个记录。
一、Agent Harness技术蓝皮书对内发布
大语言模型在形式上只是一个无状态、随机、仅输出文本的映射函数。当我们要求一个智能体跨越时间去完成真实任务——读写文件、调用接口、记忆上下文、从失败中恢复并接受权限约束——就必须在模型之外引入一层确定性的运行时。
这就是 Agent Harness(智能体外壳/确定性控制平面),定义为:围绕大语言模型或任意生成式模型构建的确定性运行时,负责把模型的文本输出转化为在真实环境中具备约束、可观测、可恢复的行动序列,并在此过程中持久化状态、管理上下文、寻址并执行工具、落实权限边界与人机协同。
其设计初衷也很清晰:在模型的随机性之上,叠加一个确定性的控制平面,让智能体的行为变得可约束、可观测、可恢复。
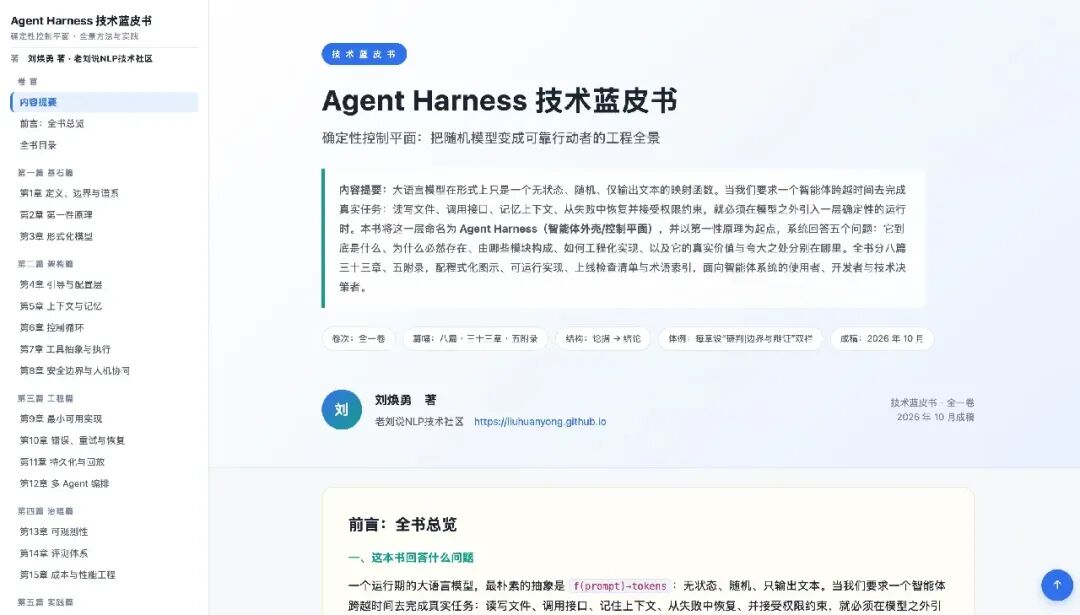
《Agent Harness技术蓝皮书》以第一性原理为起点,系统回答五个问题:它到底是什么、为什么必然存在、由哪些模块构成、如何工程化实现、以及它的真实价值与夸大之处分别在哪里。全书三十三章按"是什么→由什么构成→怎么造→怎么跑住→怎么落地→值不值→具体怎么写→用什么造"的顺序推进,共8篇,139页。
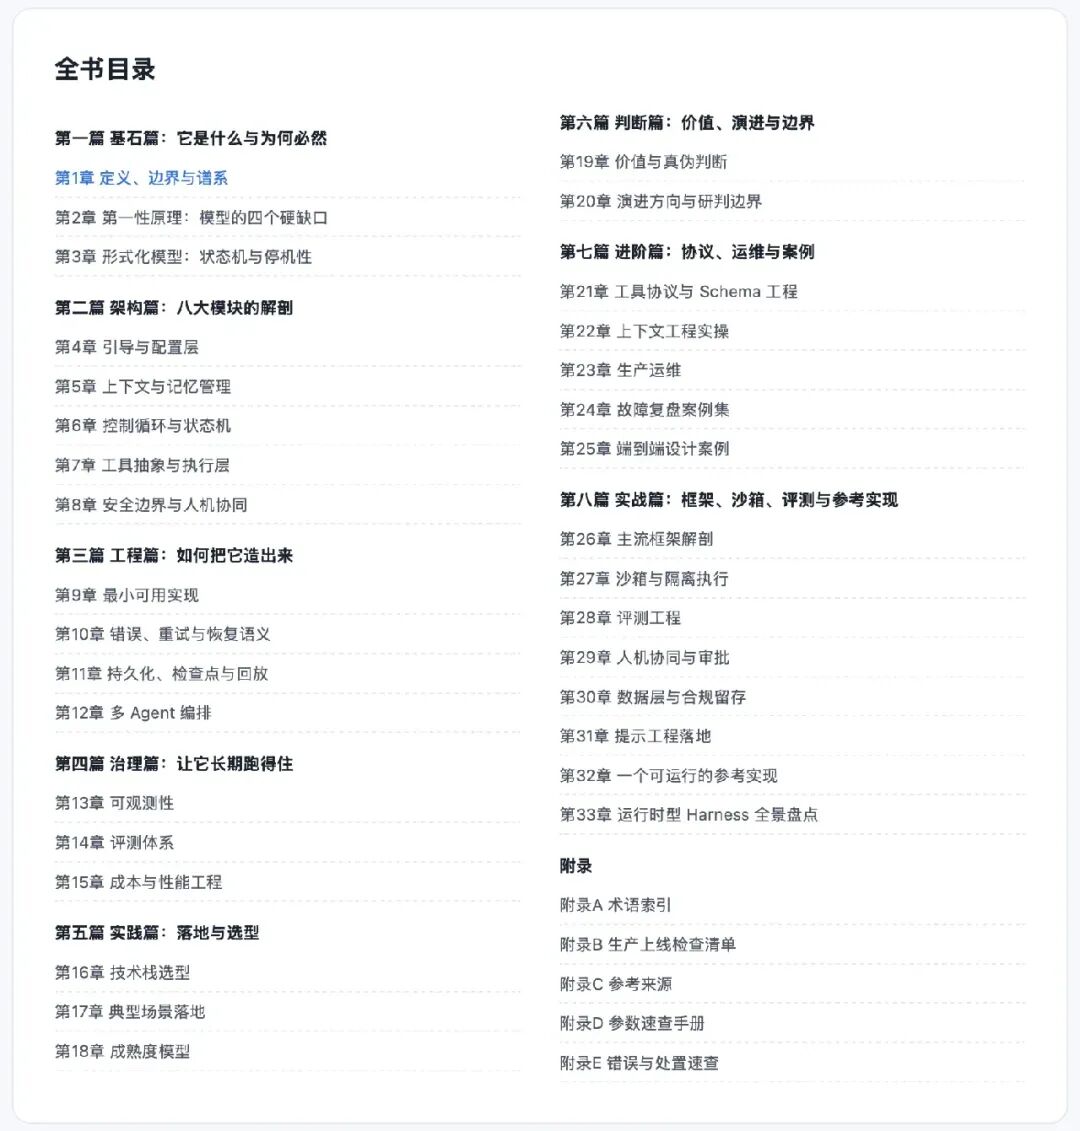
从书里能提炼出5个核心结论:
- 其一,有 Harness 是结构性必然,四个硬缺口来自"模型即采样函数"这一定义;
- 其二,两个平面正交,Harness 的价值在于用确定性平面约束、放大、兜底随机平面;
- 其三,终止与预算是停机不可判定性的强制代偿,不是保守设置;
- 其四,上下文必须账本化管理,副作用必须先于重试被确认;
- 其五,无可观测性即无定位能力,无评测集即无法演进。
二、定量和定性角度看RAG目前研究现状
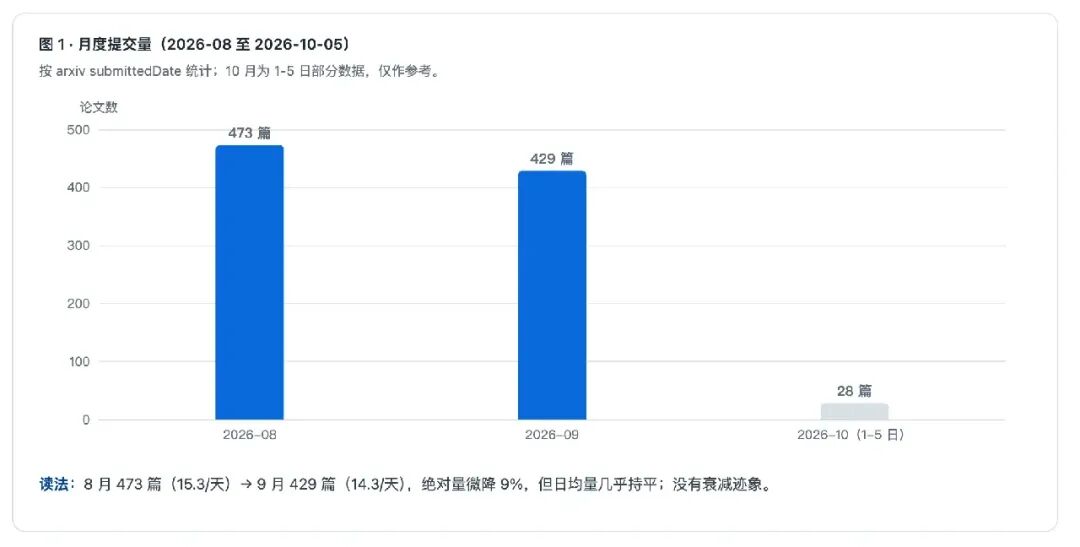
还是从定量和定性两个角度切入。通过 arxiv 官方 API(export.arxiv.org),以四组关键词变体("retrieval-augmented generation"、"RAG"、"retrieval-augmented"、ti:retrieval AND abs:generation)检索 submittedDate 落在 [2026-08-01, 2026-10-05] 区间的论文,分页抓全后按 arxiv_id 去重。2026-08-01 至 10-05 的 66 天里,arxiv 新增去重后 930 篇相关论文,约 14 篇/天。
1、先说定性结论
其一,RAG 不是"过气"话题,而是稳定高产赛道。 两个月日均量基本持平(15.3 → 14.3 篇/天),且已成为信息检索(cs.IR)内部占比最高的研究主题之一。数据层面没有看到"长上下文模型出来以后 RAG 萎缩"的证据。
其二,从"要不要检索"走向"何时检索、检索多少、由谁生成"。 自适应路由与轨迹微调控制器是典型新范式。
其三,安全从边界话题升格为系统性工程。 已出现集合级投毒、过期文档污染、向量索引删除泄露、私有信息检索等"pipeline级"威胁与防御。
其四,GraphRAG 从概念走向可工程化系统,长上下文记忆发生架构分化。 如 LiteRAG 以算法化探索替代 LLM 控制,记忆系统在"写时蒸馏 vs 读时检索 vs 非破坏性版本化"三条路线上分化。
综合来看,研究重心已从"检索pipeline怎么搭"整体转向三个层面:
系统层——自适应路由、RL 训检索器/控制器,从"是否检索"推进到"何时/检索多少/由谁生成",且用 RL 和轨迹微调把检索变成可学习动作。这是本窗口最实质的范式增量(EDAR、Fellowship、BRIDGE、MCite-RL)。
质量层——安全攻防、评测方法论(合成分布失真、多轮退化、指标污染)、效率与压缩。
形态层——GraphRAG 工程化、长上下文记忆架构、多模态与垂直领域落地。
进一步的,RAG 研究处于"工程化与再定义"阶段:核心路线问题(检索→排序→生成)已基本收敛,增量来自系统级控制、安全与评测方法论、以及 GraphRAG/记忆/多模态的新形态。最大的结构性风险不是"RAG 过气",而是评测与真实部署之间的失真正在扩大——这与领域 2019-2023 年间"基准繁荣"阶段的历史经验一致,需要警惕分数通胀,还是要评测先行。
2、再看统计数据
RAG 仍是高产赛道,论文量是"研究是否还活着"最直接的证据。窗口内月均约 450 篇、日均约 14-15 篇,8 月与 9 月几乎持平。注意,这还只是"检索增强生成"及其近义词的直接命中——如果把 Agent、记忆、检索优化等外围论文算进来,体量更大。
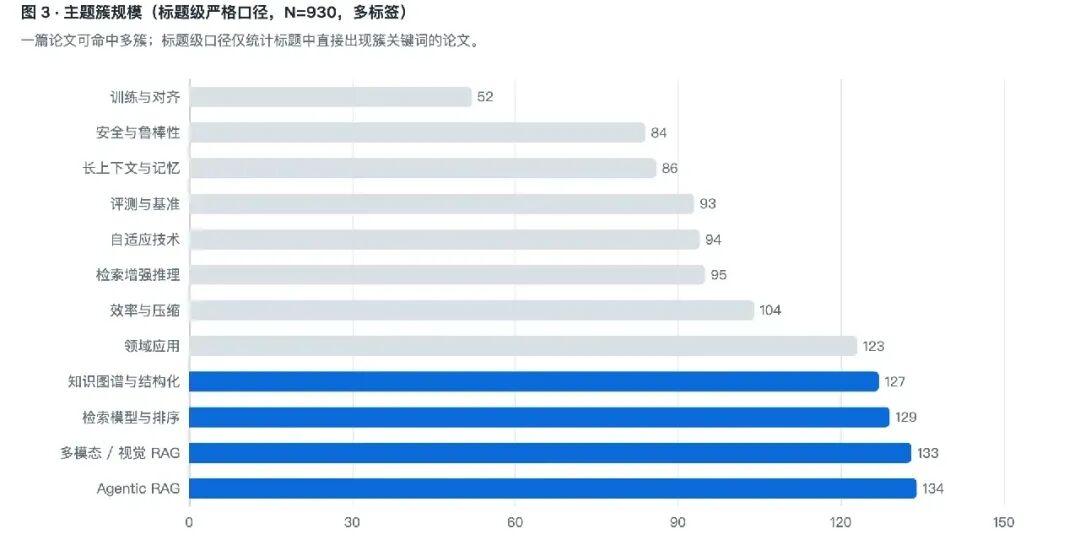
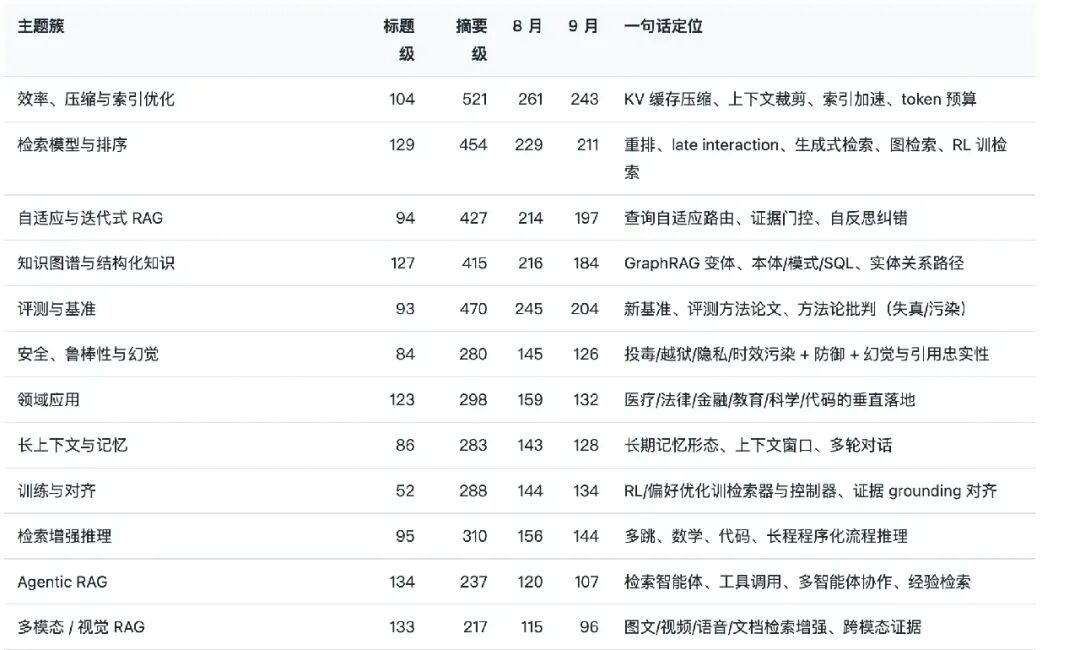
如果按照主题来分,可以看到 12 个主题簇的多标签分布如下:
具体在做的事情如下:
 发表于 半小时前
|
查看: 2|
回复: 0


