整理项目代码时,我把之前发表的《向量数据库进阶:Hybrid+Rerank 让法典问答 context_recall 从 0.35 推到 0.40》整套 RAGAS 评测重跑了一遍。同样的代码、同样的数据、同一检索指纹下重跑 hybrid_rerank,context_recall = 0.350。0.400 没复现出来。
0.05 的差距看着像效果回退,但这套数字本来就不该按 0.05 的精度来读。RAG 评测能信几分?能信,但要按 4 件事读:分母、步长、噪声、复现性。
一、分母要对得上
23 题测试集,context_recall 实际只算 20 题。
Q21、Q22、Q23 三题的 ground_truth 是空字符串(当初写测试集时留作占位,一直没补)。RAGAS 的 context_recall 在 LLM 拿到空 GT 返回 0 个分类时返回 NaN,被 np.nanmean 静默丢弃。context_precision、answer_relevancy、faithfulness 仍然按 23 题计算(那 3 题给 0 分计入),只有 recall 掉到了 20 题。
实测复核:历史值 0.300 / 0.350 / 0.400 分别落在 6/20 / 7/20 / 8/20 上。
RAGAS 日志里没有任何 warning,唯一的检测方法是在跑之前加上:
assert df['ground_truth'].notna().all()
二、步长要看清楚
20 题 × 每题 recall 二值(0 或 1),聚合步长固定 0.05。
「0.350 → 0.400」字面意思就是「满分题从 7 道变 8 道」——一道题之差。考试满分 100、一道题 5%,给分变了就动 5%。RAGAS 在小样本上的步长是采样颗粒决定的,不是模型效果决定的。
这次效果量 0.05 正好等于步长,「提升 0.05」和「换一道题判分」从数字上完全无法区分。
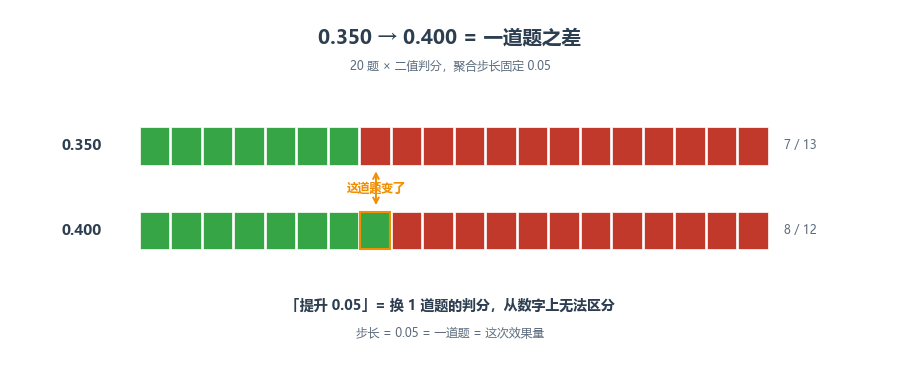
步长 = 一道题:20 题 recall 二值热图,0.350(7 满分 / 13 零分)vs 0.400(8 满分 / 12 零分),差异只有 1 道题。
三、噪声得自己测
步长只是聚合精度,单题判分本身还会随机漂。
3.1 噪声量级
先看 hybrid 这一模式(hybrid_rerank 在第四节单独讲):同一天同配置两次重跑(检索指纹都是 cc923c97313a,逐字节相同),recall 分别是 0.3833 和 0.3500,差 0.033。
0.033 是这次效果量 0.05 的 2/3。faithfulness 两次差 0.043、answer_relevancy 两次差 0.040。4 个指标全部在 0.03~0.04 之间漂。
3.2 噪声来源
知道噪声量级还不够,得追来源。看测试集的 GT 结构 + RAGAS judge 的判定逻辑,结果定位到两个机制。
复合句全有全无。测试集每条 GT 都是一整句含多个要求(「包含 X、Y、Z 三项」)。RAGAS 的 _ascore 让 LLM「逐句判断能否由上下文支撑」,分段由 LLM 决定。20 道里有 17 道 judge 只切出 1 条判定,导致每题 recall 只能取 0 或 1。
GT 含三个要求、上下文覆盖两个——整句判 0(不是 0.67)。要拿部分分,得改测试集:把 GT 拆成原子要点,每条单独判。
judge 自相矛盾。Q4 五次重跑翻 1 次(约 20%)。两次判定理由逐字相同,一次判 1、一次判 0。
复合句让单题 recall 是 0 或 1、judge 不稳让单题 20% 概率翻转、20 题聚合步长 0.05,三件事撞在一起,单题翻一次就动 0.05,正好等于 0.05 步长,也等于这次效果量。
四、复现性要追
步长 + 噪声让单个数字漂,能不能信,要靠复现性追最后一道。
复现性的检验方法:用同样的题集、同样的代码、同样的检索指纹,把要比较的几个配置同一天跑一遍,看召回判定集合是否完全相同。
三层检索落库后跑同一天 dense + hybrid×2 + hybrid_rerank,四模式召回判定完全相同:满分的是相同的 7 道、零分的是相同的 13 道,一个不差。hybrid_rerank 在指纹 48004f00e0a0 下 context_recall = 0.350,不是 0.400。
四模式 context_precision:dense 0.292,hybrid 0.39~0.41,hybrid_rerank 0.380。抬升来自 BM25 + RRF,重排没再加分。
换检索算法不改变任何一道题的召回判定。如果换算法之后判分集合完全不同,那是检索在起作用;如果完全相同,那改的就是 precision 类的指标,recall 没动。
勘误(历史口径清理)
4 件事讲完,还有一处历史口径需要勘误:
错在哪:《向量数据库进阶:Hybrid+Rerank 让法典问答 context_recall 从 0.35 推到 0.40》 对应的 0.400 数字,三层检索落库后重跑不复现:context_recall = 0.350,四模式召回判定完全相同,rerank 没改变任何一道题的判定。
现在改成什么:该篇文章仍是当时优化思路的总结(用 BM25 + RRF 抬 precision、用 Rerank 抬 faithfulness),只是 0.400 这个数字不复现。env-rag 的 RAGAS 数字能引用的口径是 30 题 baseline_v2(faithfulness 0.802 / context_recall 0.800),但这是纯 dense 检索的基线,不能挂三层检索名下,引用时要标注「30 题 dense 基线」。
Checklist(4 件事走一遍)
下次看到 RAGAS 数字时,先问这 4 件事:
- ☐ 分母对得上吗(题数?空 GT 有没有静默跳过?)
- ☐ 差值够几个步长(
k/N 是多少)
- ☐ 同配置重跑两次,噪声多大(建议 0.033 作为参考下限)
- ☐ 换算法/换代码前后,召回判定集合是否相同(集合相同 = recall 没动)
对照完这 4 件事,能不能信、信几分,就有底了。
 发表于 1 小时前
|
查看: 5|
回复: 0


