上篇聊了怎么让 AI 一次只问一个问题,这篇是系列的收尾:知识到底从哪来。
让AI在回答法规问题时“说得对”,方法就是RAG(检索增强生成):把法规原文拆成46个语义块,用BGE-small模型编码成384维向量存进ChromaDB,用户提问时命中Top-3相似条文,LLM基于搜到的原文回答。这套流程的关键不只是“用向量数据库做好检索”,而是每一步都有值得注意的细节:从HTML清洗踩过的坑,到ChromaDB 0.5.5 的bug绕过方案。
排污许可涉及一大堆法规条文,答案根本不在LLM的训练数据里,自己编一个出来后果很严重。这篇文章拆一份完整的RAG数据流,从两份HTML文件到向量库,再到运行时怎么查。
HTML 法规文件
    ↓ 提取正文
纯文本
    ↓ 按章节→条款分块(500 字一块,50 字重叠)
文本块 × 46
    ↓ BGE-small 嵌入
向量 × 46(384 维)
    ↓ 写入 ChromaDB(SQLite 存储)
本地向量库
    ↓ 运行时查询
相似条文 → LLM 基于原文回答
从 HTML 法规文件到 LLM 回答的 RAG 数据流。文本块数量、嵌入维度和重叠参数均为当前项目实际值。
总共46个文本块来自两份核心文件:
- 《排污许可管理条例》(国务院令第 736 号)— 22 个块
- 《排污许可管理办法》(生态环境部部令第 32 号)— 24 个块
两份文件合计约18,000字,46个块的平均大小约390字,刚好是一段完整法条的长度。
一、预处理:从HTML到文本块
两份法规是从生态环境部网站下载的HTML文件,里面除了正文,还混了大量导航、页脚、样式代码和脚本。
写了一个 TextExtractor 类,继承 HTMLParser,遇到 <script>、<style> 就跳过,只提取可见文本。最终提取到的正文,《管理办法》约 8,500 字,《管理条例》约 9,500 字。
逻辑很简单,但过程中踩了一个坑:<meta> 和 <link> 是 HTML 的 void 元素,没有结束标签。如果把它们放进跳过列表,skip_depth 只增不减,正文一个字都捞不到。修复方式很直接:跳过列表只放有配对标签的容器元素。
提完正文,问题变成了:怎么把这些法规切成适合检索的小块?
按段落切?太碎了,一条“无证排污处罚”可能横跨好几段。全文整块塞进去?又太长,检索精度不够。
最后选的是按层次分块:先按“章”切(正则匹配“第X章”),再按“条”切(匹配“第X条”),然后把短条合并成约 500 字一块,块之间保留 50 字重叠。每层都是一行正则的事。
500 字这个数字来自经验。太短,一条法条被切碎了,上下文不够;太长,块里混进无关内容,检索噪声增大。在中文法规场景下,500 字大概等于 2-3 条款,刚好是一段完整逻辑单元的长度。
每个块还会附带元数据:来源法规名称、原文章节和条款号。这样 LLM 引用的时候可以明确说出“根据《排污许可管理条例》第十四条规定……”,而不是模糊的“根据相关法规”。
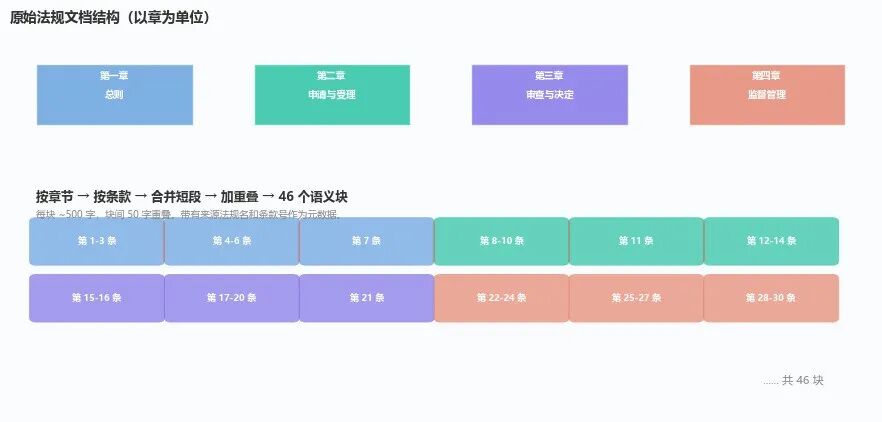
法规文档从按章拆分到按条拆分再到合并为 500 字语义块的过程,块间保留 50 字重叠。
二、向量化与检索
文本块不能直接塞进数据库做检索,需要先转成向量:一串浮点数,语义上相似的文本向量距离也近。比如“排污许可证”和“排放许可”的向量距离,比它们和“苹果”的距离近得多。
选的是 BAAI/bge-small-zh-v1.5,北京智源研究院的中文嵌入模型,6层 transformer 架构,384 维输出,模型体积 33MB。对比 bge-base (768 维) 和 bge-large (1024 维),small 版本在 MTEB Chinese 上的检索精度下降约 3-5%,但推理速度快 4 倍,而且 384 维向量在 numpy 点积计算中的内存占用和延迟都更低。46 个文档全量扫描不到 1ms。
BGE在检索任务上有一个关键规则:存库不加前缀,查询时才加前缀。 这是因为BGE的训练使用了 (query, document) 对比学习,查询侧和文档侧的表示空间有偏移:
# 存库:直接用原文编码(无前缀)
embeddings = model.encode(doc_texts)

# 查询:加检索前缀(对齐训练时的查询侧分布)
query_vec = model.encode(
    f"为这个句子生成表示以用于检索相关文章:{query}"
)
不加前缀,相当于用文档侧的分布去查询,检索召回率(Recall@3,前 3 条结果中相关文档被命中的比例)下降 5-10 个百分点,具体幅度与查询的领域相关度有关。
向量存到哪儿?选了 ChromaDB,一个开源的本地向量数据库,零配置,pip install chromadb 就能用。
但装上 0.5.5 版本之后踩了一个坑:ChromaDB 的 Python 查询 API 在某些情况下返回异常结果。查了社区 issue,是 0.5.x 重构遗留的问题。
绕开方式简单粗暴:
不调用 collection.query(),直接用 SQLite 读底层数据。
ChromaDB 的存储层就是 SQLite,文档内容和元数据都存在 embedding_metadata 表中。一条 SQL 查询读出 46 个文档块,然后用 BGE 模型 + numpy 手算余弦相似度(值越接近 1 表示语义越相似):
cos_sim = np.dot(doc_vecs, query_vec) / (
    np.linalg.norm(doc_vecs, axis=1) * np.linalg.norm(query_vec) + 1e-8
)
top_indices = np.argsort(cos_sim)[-top_k:][::-1]
这事有点反直觉:用了向量数据库,结果最后还是自己算相似度。但好处是完全可控:向量怎么存、怎么比、取几条,每一步都看得清清楚楚,不存在“某次 query 突然返回空结果”的黑盒问题。
每次查询都要对 46 个向量算一遍余弦相似度,复杂度 O(n×d) = 46 × 384 次浮点运算,numpy 不到 1ms 完成。线性扫描在 10³ 数量级内都可以接受。超过 10⁴ 条时才需要换近似最近邻(ANN)索引。
每次启动都要重新计算 46 个嵌入向量,虽然不到 1 秒,但没必要。加了一层磁盘缓存:向量矩阵存 .npz 文件,文档数不变就直接复用,变了就自动失效重算,doc_count 充当校验和。
还有一个兜底机制:FALLBACK_DOCUMENTS 内置了 10 条常见条款文本,包括 5 个行业的排放标准限值和通用环保义务条款,以 Python 列表直接写在 tools.py 中。这些数据不依赖 ChromaDB 和 HTML 文件。_load_docs_from_chromadb() 方法在检测到 SQLite 文件不存在或查询异常时,自动降级到 FALLBACK_DOCUMENTS 并打印告警,保证 Agent 在首次部署或数据文件损坏时仍能回答基础的法规问题。
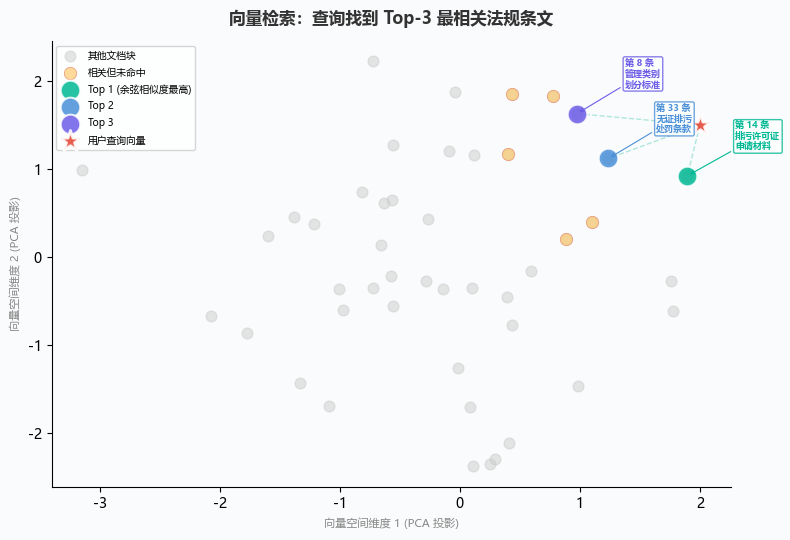
用户查询在向量空间中找到 Top-3 最相关法规条文。绿色、蓝色、紫色点分别代表余弦相似度最高的三条匹配结果。
三、设计取舍
三个关键决策:
-
分块不是越细越好,也不是越粗越好。 500 字 + 50 字重叠这个参数在不同场景可能需要调整,关键是块要跟查询的语义粒度匹配。法规查询的用户问的是“无证排污罚多少”这一整件事,不是“第 33 条第 2 款的逗号后面那句话”。
-
向量数据库不是必需品。 当你的文档量只有几十份时,用 SQLite 存文本、numpy 算相似度,比搭一个完整的向量数据库更可控。这个方案撑到数千份文档都没问题。什么时候该换?当你发现 numpy 算点积已经超过 100ms,或者你需要用元数据过滤(“只看 2024 年发布的法规”)时,再考虑 Milvus 或 Qdrant 这样的专用方案。
-
RAG 的效果不只看检索精度,还看“引用质量”。 如果检索到的片段里没有法规名称和条款号,LLM 只能复述内容,说不出出处。每个块附带 law_name 和 article 元数据,能让回答的可信度提高一个档次。
四、三篇串起来看
这个环保申报 Agent 一共写了三篇文章,每篇回答一个核心问题。
给 AI 请了个环保顾问 回答“整体怎么搭”:LangGraph 的 create_react_agent 把 LLM、五个 Tool 函数、RAG 知识库串成三层架构,走 ReAct 循环完成多轮申报引导。
让 AI 学会一次只问一个问题 回答“对话怎么设计”:多轮信息收集的关键是“每轮只问一个问题”,配合提取→更新状态→决策的三步状态机,把调查问卷变成自然对话。这套逻辑全写在 System Prompt 里,跟代码分离,改规则不用改代码。
把法规喂给 AI 回答“知识从哪来”:两份法规 HTML 文件经过清洗、分块(500 字 + 50 字重叠)、BGE-small 嵌入,存入 ChromaDB。运行时用 SQLite 直读 + numpy 余弦相似度做检索,绕过 ChromaDB 0.5.5 的查询 bug。
三篇合在一起,就是一个完整项目的三个剖面:架构设计 → 交互体验 → 工程实现。每个剖面只拆一个点,可以单独读,也可以串起来看。
如果要在实际项目里用这套方案
换行业。 这套 Agent 跟环保没有强绑定,替换知识库文档和 Prompt 里的字段顺序,就能变成消防合规、建筑规范或医保报销助手,框架层完全不用动。
换模型和数据库。 DeepSeek 可以换成 Qwen/GLM,本地部署也行。文档量超过 10⁴ 条时把 SQLite 直读换成 Milvus/Qdrant 做混合检索,BGE-small 换成 base 或 large 提升精度。
加人工审核。 AI 出的草稿先转给专员复核再提交——做 AI 辅助申报,不是 AI 代替申报。
这个项目从构思到跑通,最有价值的不是代码写得有多好,而是理清楚了一条线索:一个能用的 AI Agent,三分靠模型,七分靠怎么拆任务、怎么喂知识、怎么设边界。
三篇文章涉及的全部代码(Agent 框架、Prompt、RAG 数据流),已上传到 github.com/HuangWuwutelling/ml-learning,在 projects/env_agent/ 目录下。 相关技术讨论和更多实战案例,可以到 云栈社区 的技术论坛里翻一翻。
 发表于 1 小时前
|
查看: 6|
回复: 0


