最近几周在 GitHub 上刷到一个涨得挺猛的项目——PageIndex,近半年几乎一直在涨。做 RAG 的人多少都踩过同一个坑:向量库召回不准。把文档切块、转成向量、算语义相似度,这套流程跑下来,检索真正想要的其实是“相关”,而不是“相似”。长文档问答里尤其明显——相似的段落答不到点子上,真正相关的段落又因为不相似被漏掉。
PageIndex 的思路很直接:既然相似度靠不住,干脆把向量库扔掉,换成让 LLM 像人翻报告一样,一路推理翻到对的那一页。
项目简介
PageIndex 是一个无向量、无切块的推理式 RAG 引擎:它把向量索引换成层级树索引,让 LLM 沿树推理着检索,官方口号就是 "Vectorless, Reasoning-based RAG"——检索结果可追溯到明确引用,而不是向量 RAG 那种玄学 vibe 检索。
它和向量 RAG 的差别,一张表说清:
| 对比维度 |
向量 RAG |
PageIndex |
| 索引方式 |
向量索引 |
树索引 |
| 检索方式 |
语义相似度搜索 |
LLM 沿树推理 |
| 结果 |
不透明,玄学检索 |
可追溯到明确引用 |
| 上下文 |
只看 query 向量 |
会话历史、领域知识都能带进来 |
核心亮点拆解
亮点 1、无向量、无切块,用树索引替代向量索引
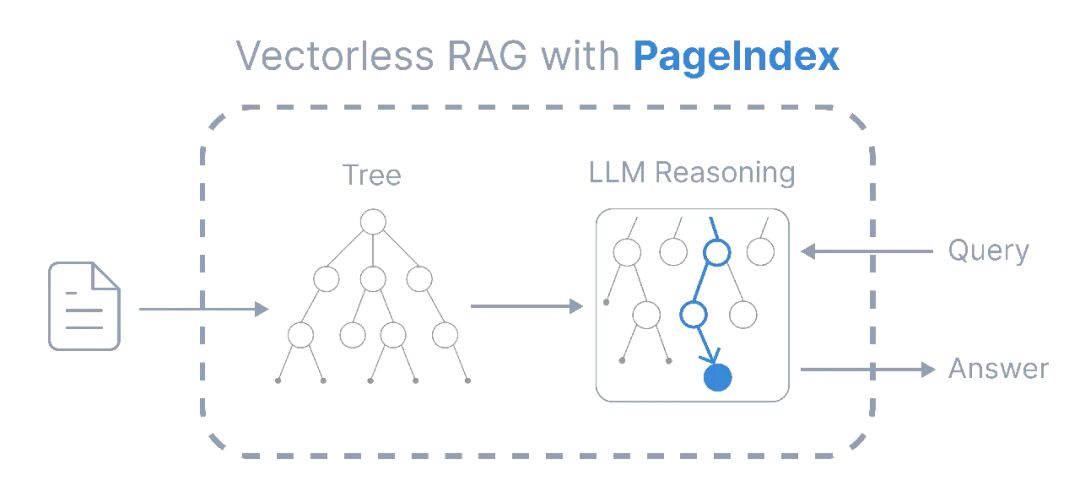
它彻底抛弃了向量数据库和切块,用层级树索引替代。检索不靠语义相似度,靠 LLM 推理——直击相似 ≠ 相关这个检索最痛的毛病。
亮点 2、两段式检索,可追溯、可解释
① Index(建索引):给每份文档生成树状结构,树结构从文档布局提取、不依赖 LLM,索引模型只用廉价基础模型。
② Retrieve(检索):让 LLM agent 沿树推理,一步步定位到正确章节。
检索结果可追溯到明确引用——本地版给到页级,云端给到块级。这可不是“我猜的”,而是实实在在翻到了哪一页。
亮点 3、成本不随文档变长
本地建索引大约 $0.001/页,一份 1000 页教材索引一次也就一美元出头、几分钟,之后每次提问都复用。
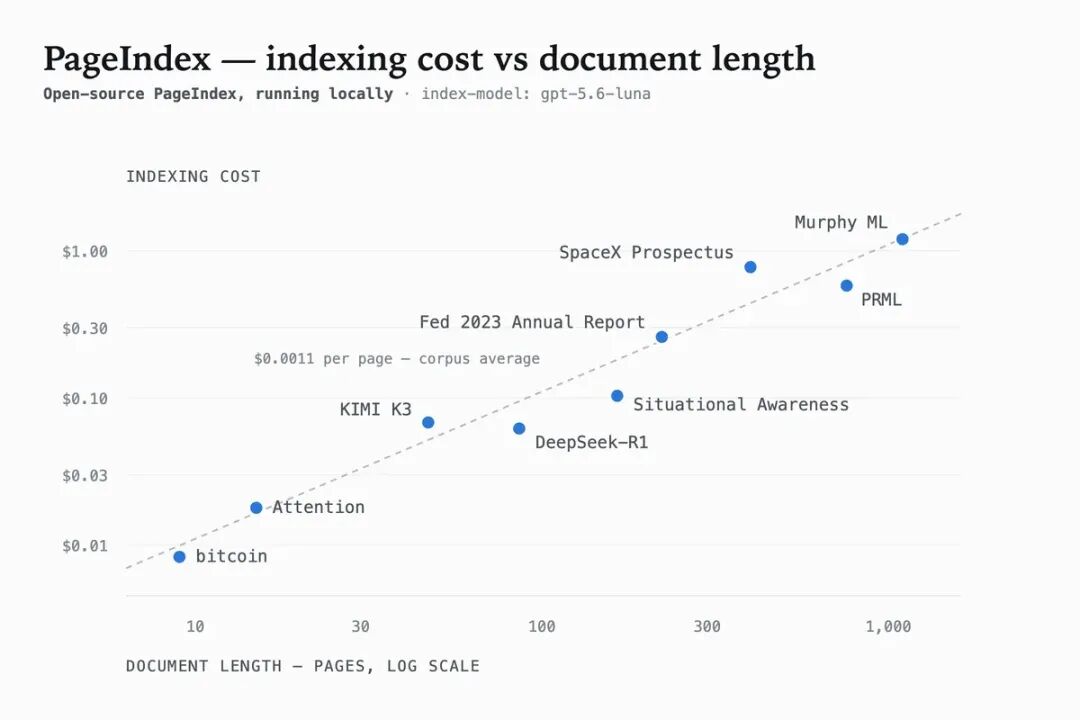
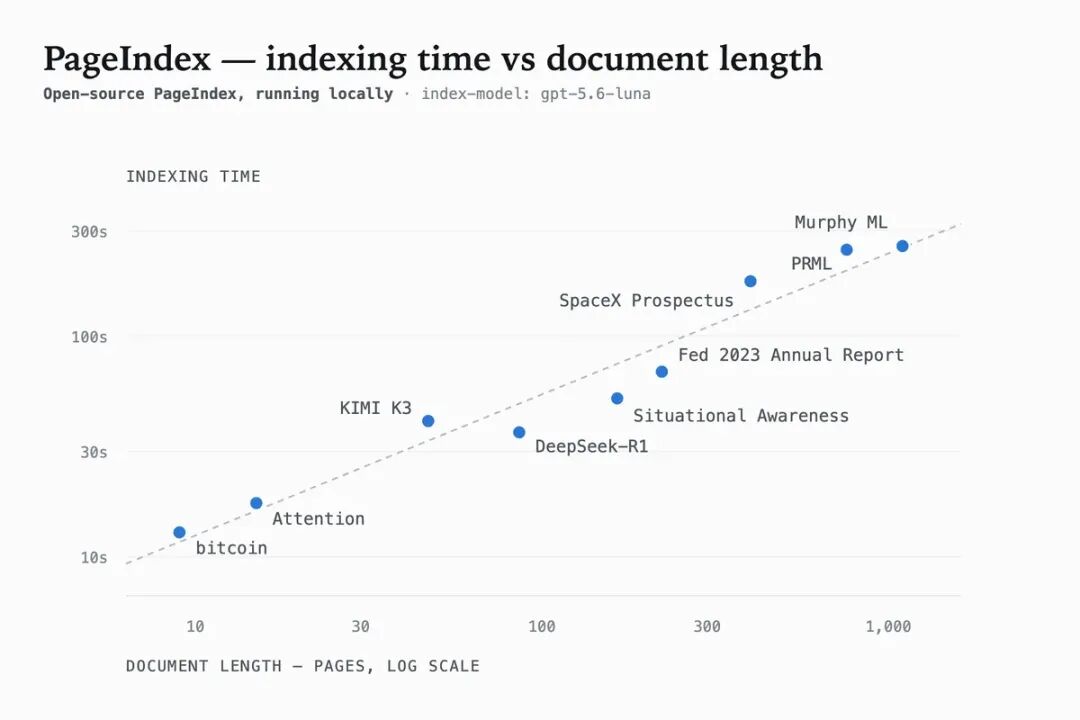
索引时间随文档长度线性增长,官方实测 9 到 1098 页的文档,13 秒到 4.5 分钟不等。
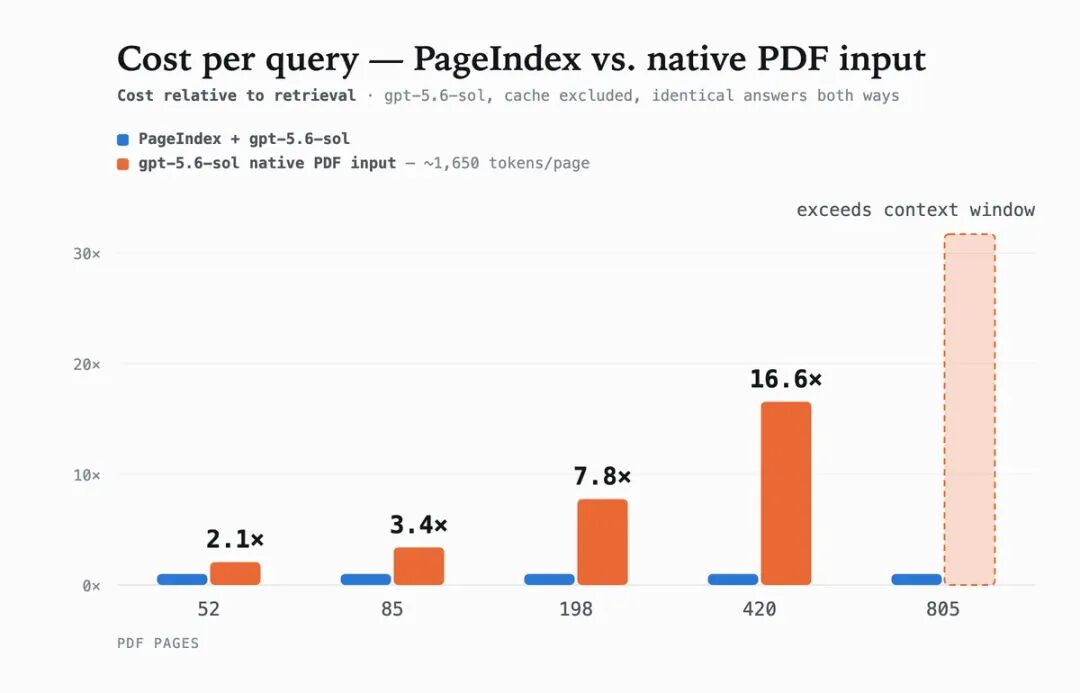
对比把整份 PDF 直接塞给模型的省事做法,差距更明显:52 页贵 2.1 倍、420 页贵 16.6 倍、805 页直接超出上下文窗口——因为 PageIndex 只读它推理命中的那些节点,而不是整个文档。
亮点 4、FinanceBench 98.7% SOTA,公开可复现
在金融文档问答基准 FinanceBench 上,PageIndex 拿到 98.7% 的 SOTA 准确率,向量 RAG 只有 50%。
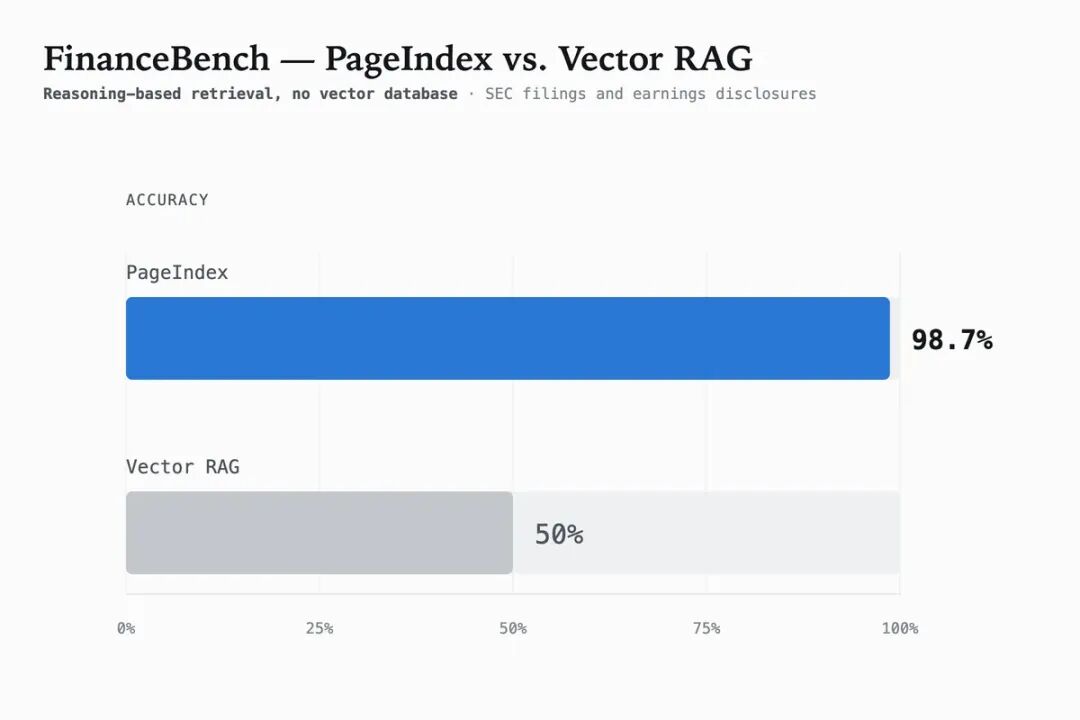
48 个百分点的差距,说明长文档检索这条路它走对了。官方另外还开了 PageIndex-OSS-Benchmark 供公开复现,题目设计成答案都是正文里明写的事实——答错就是检索或读取失败,没有“推理不行”的借口。
核心原理与架构差异
向量 RAG 的缺陷在于:把“相关”近似成了“相似”。语义相似度只在短文本、通用问答上够用,一旦遇到长而复杂的专业文档——财报、法律文书、监管备案——就会暴露相似但无关、相关却不相似的漏召误召。
PageIndex 的架构设计,受 AlphaGo 启发:
-
索引层换树,不换向量。 每份文档生成一棵树状索引,树结构从文档布局提取,索引成本极低( $0.001/页 ),且索引质量不依赖强模型。
-
检索层换推理,不换相似度。 让 LLM agent 沿树推理定位,等于把人翻报告找答案的过程程序化了——先看目录,再定位章节,最后读正文。
-
结果层换引用,不换概率。 检索结果可追溯到明确的页级/块级引用,符合合规、审计场景对可解释的要求。
这条判断很清晰:长文档检索的终局不是更准的向量,而是会推理的检索。PageIndex 把“读文档”这件事还给了会思考的 LLM。
快速上手
第一步:环境准备。 纯 Python,执行 pip install -U pageindex 即可。
第二步:配置 key。 本地模式自带 LLM key(OPENAI_API_KEY)。
第三步:拉起客户端并跑通查询。
import os
from pageindex import PageIndexClient

os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
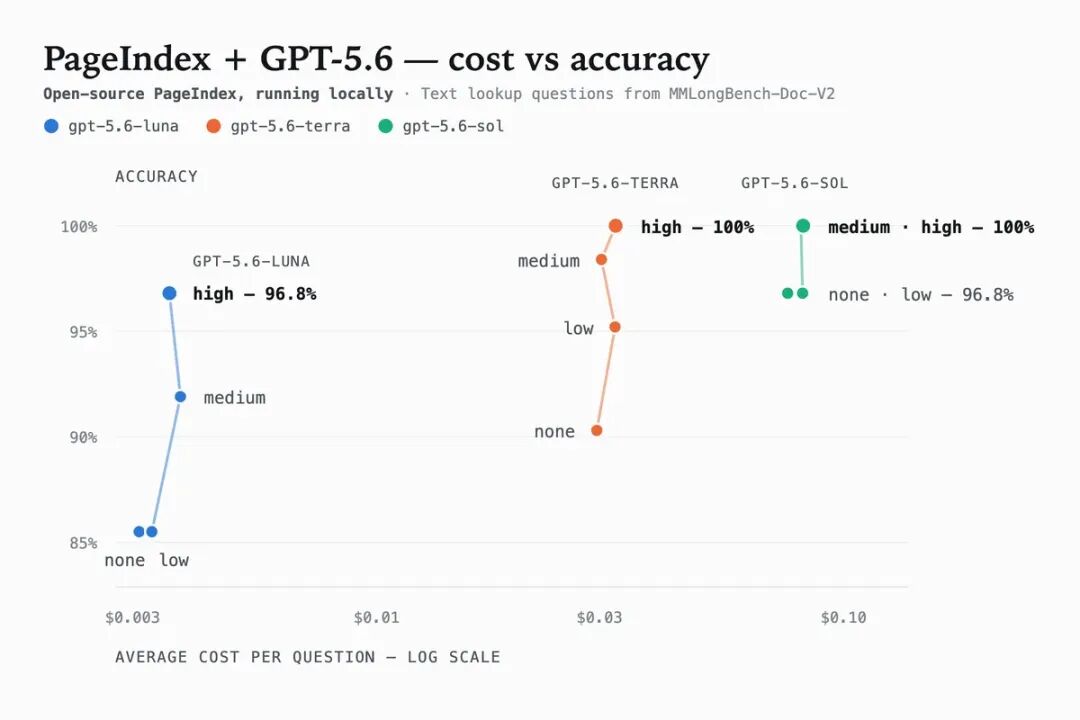
    index="gpt-5.6-luna",   # 建树索引的模型(基础模型即可)
    chat="gpt-5.6-sol",     # 沿树检索的模型(用你买得起的最强模型)
)
doc_id = client.submit_document("report.pdf")["doc_id"]
print(client.chat("What was the 2023 operating margin?", doc_id=doc_id))
第四步:双形态切换。 本地版处理文本型 PDF;扫描件、图片密集文档走 Cloud——index="cloud",OCR、图片理解、树索引、存储、块级引用、MCP 都由云端托管,chat 层仍接你自己的模型。
团队落地方案
1. 团队改造思路
适合接在长文档问答这一环:把财报、法务、监管文档的检索从向量库 + 分块迁到树索引 + 推理检索。改造边界清晰——它只接管检索层,不碰你上游的文档流和下游的业务应用。
2. 部署方案
本地 SDK 统一索引流水线:每份文档一棵树,文档变更后重跑索引( $0.001/页 ,成本可忽略)。存量语料批量建树 + 增量文档按需建树,索引资产沉淀在本地目录,团队共享。
3. 业务系统集成
把 PageIndex 当检索工具塞进现有 agent:官方支持 OpenAI Agents SDK、Claude Agent SDK、MCP server,一行接入即可让现有 agent 获得沿树检索长文档的能力。可追溯引用直接用于合规审计输出。
4. 团队规范定制
统一 index/chat 模型配置(index 用基础模型省钱、chat 按精度预算选型);引用粒度按合规要求取舍——要页级可全本地,要块级引用 + OCR 就走 Cloud。
真实适用场景
- 金融/法务/合规团队:财报、法律文书、监管备案的高精度问答,结果可追溯。
- 科研/医学:学术教材、医学文献的长文档检索,答错即检索失败的基准设计正对这类场景。
- 不想维护向量库的 RAG 团队:省掉向量库、切块、embedding 调参这一整套。
- 需要可解释检索的审计场景:引用能落到页/块,天然可解释。
不适合:做短文本、通用知识问答的人——它的长文档优势用不上;完全没有 LLM key、想白嫖的——检索质量取决于你给的模型强度。
优缺点 + 避坑
核心优势:思路新且务实(树索引 + 推理检索换掉相似度);数据硬(FinanceBench 98.7% SOTA、成本对比公开可复现);本地索引便宜( $0.001/页 );MIT 免费 + 官方多条产品线持续迭代。
局限:
- 本地版偏文本型 PDF:扫描件、图片密集文档吃不下,必须走 Cloud。
- 质量押在模型上:chat 要买得起的最强模型,检索成本与模型能力绑定,模型一弱效果就掉。
- Cloud 能力走商业服务:OCR、块级引用、MCP、File System 都在收费侧。
- 生态还新:2025-04 才建仓,受众偏长文档 RAG 这个细分,通用问答用不上。
落地常见坑:先确认你的文档是文本型还是扫描型,扫描件直接上 Cloud、别在本地硬试;chat 模型别为了省钱选弱的,检索精度会肉眼可见地掉;锁版本——生态新、迭代快,今天跑通的参数明天可能就变。
我有话说
向量 RAG 最大的毛病就是相似 ≠ 相关。PageIndex 干脆把向量库扔掉,换成树索引让 LLM 像人一样翻到对的那一页——FinanceBench 98.7% 对向量 RAG 的 50%,这个差距足以说明长文档检索这条路它走对了。
对做长文档问答的团队来说,这是一条值得认真试的新路线;但它本地版只吃文本 PDF,检索质量也取决于你给它的模型有多强。
开源地址:https://github.com/VectifyAI/PageIndex (MIT)
这种无向量 RAG 的新玩法,在云栈社区也有不少人在聊,感兴趣的可以过去看看。
 发表于 2 小时前
|
查看: 4|
回复: 0


