新入职接手遗留 Java 项目的流程,想必大家都比较熟悉:几十万行代码,文档停在三年前,Wiki 里最新一篇还是离职同事写的"环境搭建(已过时)"。平时解决问题就两招——翻代码,问老人。老人答三次就烦了,代码翻两周还没摸清调用链。
最近有个叫 graphify 的开源项目,干的就是这件事。对着项目目录敲一条 /graphify .,它能把整个代码库解析成一张能查、能点、能溯源的知识图谱。GitHub 上已经 11.8 万 Star,Apache 2.0 协议,Claude Code、Cursor、Codex、Kimi Code 等 20 多个 AI 编程助手都能装。
它是如何生成的
传统代码 RAG 的路子,是把文件切块、算 embedding、存向量库,查询时按相似度召回。这条路有三个绕不开的坑。
召回是模糊的。你问"鉴权流程连了哪些表",embedding 可能召回一个名字里带 auth 的文件,但这个文件到底 import 了谁、调用了谁,向量不知道。reindex 要花钱,代码每改一次就得重算一遍。还有向量库是黑盒,它为什么召回这个文件,你没法审计。
graphify 的思路很直接:代码本身就是结构化数据,有一棵 AST 语法树就有节点和边,没必要绕道向量。它用 tree-sitter 做确定性解析,支持约 40 种语言,.java、.kt、.scala 都在覆盖范围内。一个 import 就是一条 imports 边,一次函数调用就是一条 calls 边,class B extends A 就是一条 inherits 边。全在本地跑,不调 LLM,不花一分钱 token。
生成的图谱长什么样
每条边都带置信度标签,这是我觉得最值钱的设计。EXTRACTED 是源码里明写着的,可以直接当事实用。INFERRED 是第二轮调用图分析推出来的,比如跨文件的间接调用,用之前要自己掂量。AMBIGUOUS 是模型拿不准的,报告里标出来等人肉复核。哪些是读出来的、哪些是猜的,一目了然,向量检索给不了这种透明度。
源码里还有个细节我很喜欢。它维护了语言族的边界,会丢掉跨语言族的推断边,因为真实发生过 Python 文件的 import time 意外绑到一个叫 time.ts 的文件这种事故(issue #1749)。只有真实的跨语言互操作才保留。这种边角案例都处理了,说明项目是被真实使用锤过的。
解析完跑 Leiden 社区发现算法,把整个代码库按边密度拆成若干子系统,不需要 embedding,不需要向量库,图拓扑自己就够。输出的 graph.html 在浏览器打开,同色系节点属于同一个子系统,点任意节点能跳回源码位置。
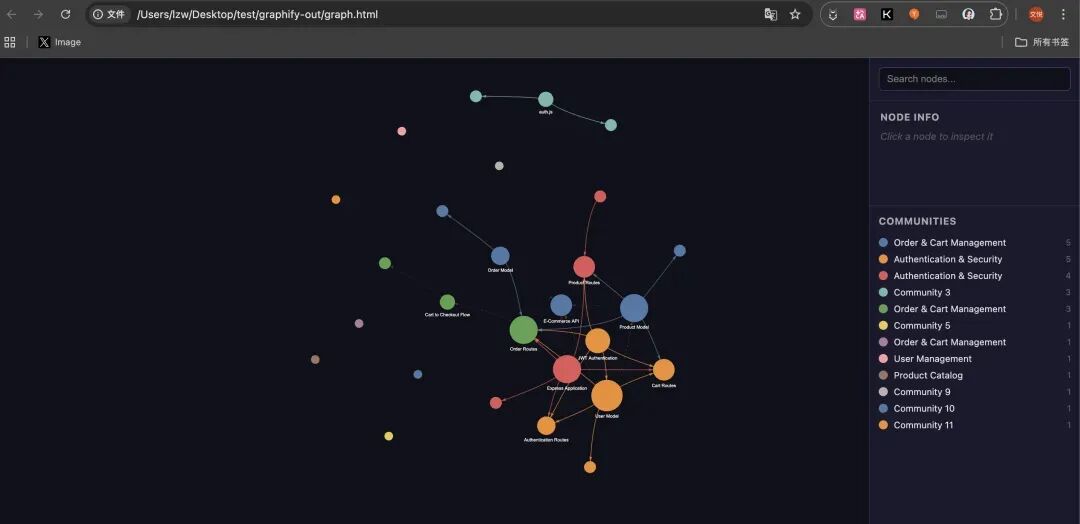
GRAPH_REPORT.md 里有个东西叫 God nodes,全项目连接度最高的节点排前面。在 Java 项目里,这个位置坐着的通常就是那个所有人都 import 的 Utils 类,或者耦合了整个系统的 BaseService。新人看一眼报告,就知道这个项目的命门在哪。
查询方式
图建好之后不用翻文件,直接查。官方在 FastAPI 代码库上的真实输出长这样:
$ graphify explain "APIRouter"

Node: APIRouter
  Source:    routing.py L2210
  Community: 2
  Degree:    47

$ graphify path "FastAPI" "ModelField"

Shortest path (3 hops):
  FastAPI --uses--> DefaultPlaceholder <--references-- get_request_handler() --references--> ModelField
query 回答自然语言问题,path 追两个类之间的调用路径,explain 讲清一个概念的来龙去脉。查的都是持久化的 graph.json,不用重读源文件。
如何安装
安装两行:
uv tool install graphifyy
graphify install
PyPI 包名暂时叫 graphifyy(graphify 这个名字在回收中),装完在 AI 助手里敲 /graphify . 就能用。
大项目第一次建图要几分钟,之后就是增量世界。SHA256 缓存记住每个文件的解析结果,--update 只处理改动的文件。想再省事,graphify hook install 装个 git post-commit 钩子,每次提交自动重建。--watch 模式下代码一保存就即时更新图谱,纯走 AST 不调 LLM,多 Agent 并行写代码的场景下图谱始终是最新的。
CI 环境可以 headless 跑:graphify extract ./src --code-only,纯代码索引完全离线,零 API key。文档、PDF、图片的语义抽取才需要模型,而且后端可以换成你自己起的 Ollama,数据不出内网。
微服务架构治理怎么玩
官方建议把 graphify-out/ 提交进 git,团队每个人 clone 下来就自带地图。这条建议本身就是治理思路:图谱和代码同版本,永远不会出现"文档停在三年前"。
落地到微服务场景,我们按仓库各建一张图。新人生成自己负责服务的 graph.html,点着节点看子系统划分,比读文档快一个量级。架构 review 的时候看 God nodes 的变化趋势,某个类的连接度持续膨胀,就是腐化信号。要汇报要存档,--neo4j 生成 Cypher 脚本导进 Neo4j,--graphml 导出给 Gephi 或 yEd 画图。数据库侧也有招,graphify extract --postgres 能直接内省线上的 PostgreSQL schema 进图。
哪些情况下适合
适合谁:背着遗留系统、团队有新人流动、想做架构治理又没钱上商业工具的 Java 团队。不适合谁:想要运行时全链路追踪的,那是 APM 的活,图谱管的是静态结构。
有哪些缺点呢
图处理用的是 NetworkX,纯 Python 实现,几十万节点的超大图性能会见顶。文档和图片的语义抽取质量跟着你配的模型走,模型差图谱就糙。还有一条对 Java 项目尤其重要:Spring 的依赖注入、反射、AOP 这类运行时才确定的关系,静态 AST 天然覆盖不全,这部分图谱只能当参考,别当真相。
我的看法
文档永远滞后,这不是态度问题,是机制问题:文档和代码是两套手工维护的东西,必然分叉。graphify 的解法是把"文档"改成代码的衍生物,每次提交自动重新生成,从机制上消灭滞后。对正在做微服务拆分或架构治理的团队来说,这种"图谱即文档"的思路,比再写十篇 Wiki 都实在。如果你也在探索更系统的微服务架构落地方法,融合 Spring Cloud Alibaba 的一站式微服务实战课程可以帮你把静态图谱里发现的腐化点,和 Nacos、Sentinel、Gateway 这些动态治理组件串起来看,形成完整的架构治理闭环。
开源地址:https://github.com/Graphify-Labs/graphify
 发表于 1 小时前
|
查看: 5|
回复: 0


