先问一个扎心的问题:有多少人为了在本地跑一个开源大模型,折腾了很久?装 Ollama,发现它什么模型都接、可哪个都没调优,DeepSeek V4 这种带 routed expert 的大型模型跑起来又慢又吃内存;换 vLLM,光配环境就要半天。最后你关掉终端,回到云端 API,一边刷 token 账单一边叹气。
说白了,现在的本地推理工具几乎都是通用 runner,什么都想支持,结果对任何一个具体模型都不够狠。
而 Redis 的作者 antirez 不这么干。他干脆反着来:只做几个最强的开源模型,把专用做到极致。
今天要聊的开源项目叫 DwarfStar ,上线不到 5 个月,Star 已经冲到 2.3w,fork 2,239,MIT 开源。
简介
DwarfStar 是一个专为 DeepSeek V4 系列、GLM 5 系列、Qwen3.8 Flash Next 这几个模型深度优化的本地推理引擎,覆盖 Metal / CUDA / ROCm 三个平台,还自带原生 coding agent 和 HTTP server。
它和 Ollama 这类通用 GGUF runner 最大的区别在于:不是都能跑,而是这几个跑得最狠。你必须用项目自己产的 GGUF 文件,换来的是极致的内存占用和吞吐。
核心亮点拆解
亮点 1:专为几个模型优化,不是万能 runner
antirez 在 README 里说得明白:这个项目刻意收窄,不是一个通用 GGUF runner。
支持的模型清单很短,但个个是当下最强的开源权重:
- DeepSeek V4 Flash(含实验性 vision 模型)
- DeepSeek V4.1 Flash
- DeepSeek V4 PRO
- GLM 5.2 / 5.3 / 5.3 Flash
- Qwen3.8 Flash Next
而且作者明说模型支持是机会主义的——项目跟着最强的开源权重走,一旦出现更好的模型,旧的会被替换掉。
这种宁可少、但精的思路,和 Redis 当年只做快、极简、正确的风格一脉相承。
亮点 2:三平台 + 多机拼内存的完整硬件谱系
一个推理引擎敢说覆盖全谱系,是因为它把小内存和多机两条路都打通了:
- Metal(主目标):Mac 96GB 以上能全量跑;小内存机器走 SSD streaming,把模型权重放 SSD 上按需读。
- CUDA:DGX Spark 是主要目标,还支持 Ada / L40S 多卡。
- ROCm:Strix Halo / Framework Desktop 这类 APU 平台。
更狠的是多机方案:两台 128GB Mac 用 RDMA 做 tensor parallelism,把 DeepSeek V4 Flash 的 4-bit 量化版拼内存跑起来;还有 pipeline parallelism,把多台机器的内存加起来跑更大的模型。
官方实测:
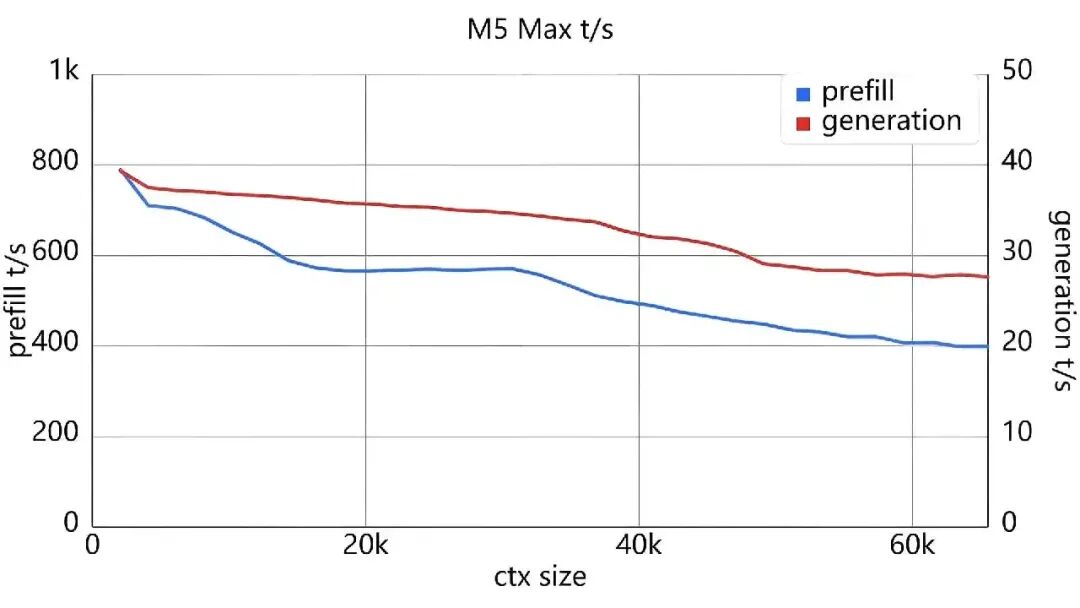
- M5 Max 128GB 跑 Flash Q2:预填充 790 t/s、生成 39 t/s(2048 上下文)
- DGX Spark 128GB:预填充 825 t/s、生成 18 t/s
- 8×L40S 跑 Flash Q4:约 126 聚合生成 t/s(16 个并发 decode 会话、100k 上下文)
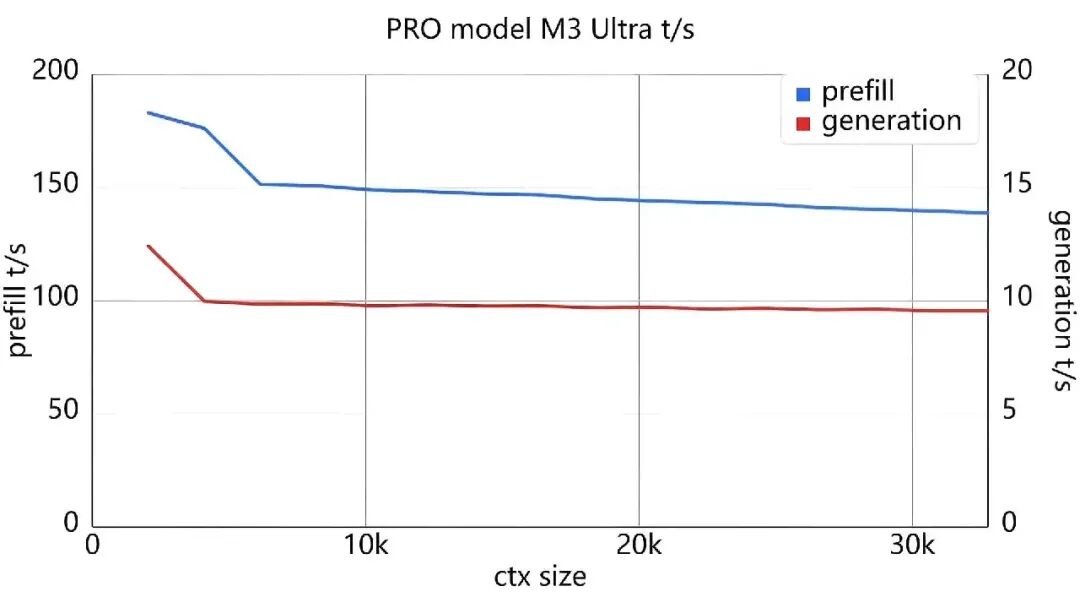
PRO 模型在 M3 Ultra 上也有官方实测曲线,prefill 峰值约 188 t/s,生成约 20 t/s——同一条专用推理路径,Flash 和 PRO 两个量级都照顾到了。
注意那个 126 t/s 的表述:这是聚合吞吐,也就是 16 个 session 加一起的总和,不是单个用户的速度——官方原文写得很克制,我们也照实说。
亮点 3:原生 coding agent + server,不是只跑个 chatbot
光跑文本不算什么,DwarfStar 把 coding agent 直接做进了推理引擎:
- ds4-agent:不带 HTTP server、直接推理的原生 coding agent,保持 token 历史 + 模型状态,用模型的原生 tool 格式。
/hints on 还能偶尔解释一下它做某个编程选择的理由。
- ds4-server:标准 HTTP server,直接接 Pi、OpenCode、Codex CLI、Claude Code。
- 推测解码(MTP):GLM 和 Qwen 走
--mtp,DSpark 有专门的支持模型,能明显提升生成速度。
- directional steering + think level:
--think-level 1 到 100 调推理强度,还有方向性引导(directional steering)这种发烧友级玩法。
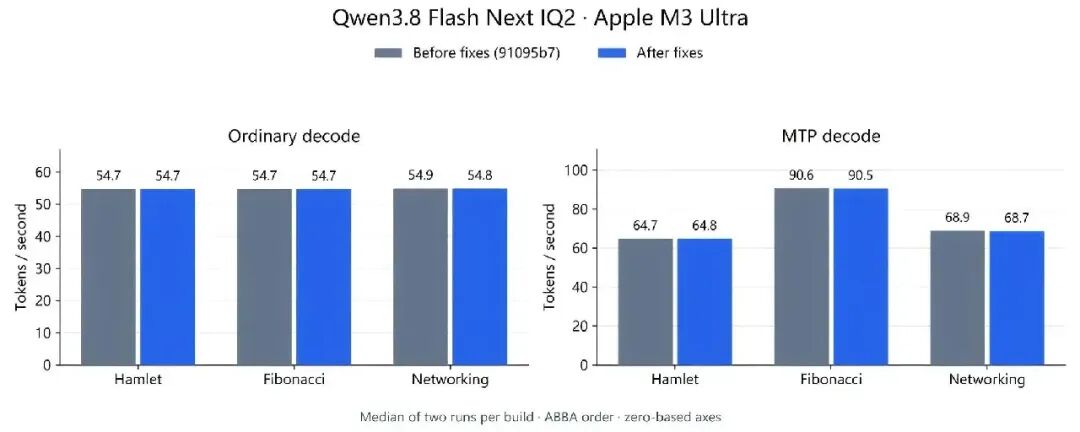
官方给出的 Qwen3.8 Flash Next 在 M3 Ultra 上的数据,MTP decode 能到 90.6 t/s,普通 decode 只有 54.7 t/s——推测解码在编码场景的收益肉眼可见。
核心原理与架构差异
为什么 DwarfStar 能比通用 runner 快?关键在三个决策。
决策一:不做通用 GGUF runner,直接针对模型写推理路径。
通用 runner 为了兼容几百种模型,代码里塞满了分支判断。DwarfStar 反着来——ds4.c 不链接 GGML,只为 DeepSeek V4 这一条推理路径深度优化。作者在致谢里说得很坦诚:它因 llama.cpp 和 GGML 开辟的道路而存在,内核、量化格式、GGUF 生态的知识都来自 Georgi Gerganov 的 llama.cpp,部分源码在 MIT 下保留或改编,所以 LICENSE 里保留了 GGML 作者的版权声明。
决策二:量化方案跟着模型走,而不是通用一刀切。
README 里点明:DeepSeek V4 Flash/PRO、GLM 5.2 能容忍激进的路由专家量化。这意味着 DwarfStar 可以针对这些模型的路由专家结构做更狠的量化,Qwen3.8 的 Q2 版本主权重只有 41.73 GiB,64GB Mac 就能起步。
决策三:把 KV cache 和 Engram 表的设计当成一等公民。
压缩的 KV cache + 快速本地 SSD,让长上下文变得实用。Engram 表始终留在磁盘上,所以作者反复强调用一块快 SSD。
安装与配置
以 96GB 或 128GB Mac 为例:
git clone https://github.com/antirez/ds4.git
cd ds4
make                                    # Metal 平台构建
./download_model.sh ds4f-q2             # 下载 DeepSeek V4 Flash Q2
./ds4 -p "Explain Redis streams in one paragraph."
./ds4-agent                             # 原生 coding agent
./ds4-server --ctx 32768                # HTTP server,默认 127.0.0.1:8000
其他平台对应不同构建目标:
| 平台 |
构建命令 |
| Metal(Apple Silicon) |
make |
| DGX Spark |
make cuda-spark |
| Strix Halo / Framework Desktop |
make strix-halo |
| 单卡/多卡 CUDA(含 Ada/L40S) |
make cuda-generic |
小内存 Mac 走 SSD streaming:./download_model.sh ds4f-q2 后加 --ctx 控制上下文,模型权重放 SSD 按需读,跑超过内存的大模型。
团队落地方案
1、团队接入思路。 如果你团队里有 DGX Spark 或 L40S 工作站,DwarfStar 可以当内网推理服务。多用户场景用 ds4-server + --batched-session,把多张卡做 tensor parallelism,一台机器服务整个团队。
2、批量部署方案。 统一用 make cuda-generic 或 make cuda-spark 构建,模型文件通过 ./download_model.sh 脚本统一拉取、放在 gguf/ 目录,断点续传。8×L40S 的部署命令官方直接给全(--gpu-devices 0,2,4,6,1,3,5,7 --ctx 100000 --batched-session 16),照着抄就行。
3、编码客户端集成。 ds4-server 的 API 兼容 OpenAI 格式,直接接到 Pi、OpenCode、Codex CLI、Claude Code(官方 docs/CLIENTS.md 有完整配置)。CI 里做推理正确性回归可以用 ds4-eval。
4、团队规范定制。 推理强度用 --think-level 统一(1-100),功耗用 --power 权衡吞吐和 GPU 负载;安全性上注意它没有内置权限系统,默认以启动用户权限运行,需要隔离的自己配 Gondolin / Docker / OpenShell 沙箱。
适用场景
- 本地跑 DeepSeek V4 / GLM 5 / Qwen3.8 的发烧友:Mac 大内存用户、DGX Spark、Strix Halo 玩家。
- 要多卡/多机拼内存跑更大模型的团队:双 Mac RDMA、8×L40S 多用户服务。
- 想要本地 coding agent 的开发者:不想把代码发给云端 API,用
ds4-agent 全程本地跑。
- 对专用 vs 通用有取舍的技术负责人:愿意为极致性能锁定几个模型。
优缺点与避坑
核心优势:antirez 的工程品味背书,专用路线带来实打实的吞吐;MIT 免费;完整硬件谱系 + 诚实的技术披露。
局限:
- beta quality,迭代极快。作者自己明说可能有 instability 和 regression,每次 release 前做一轮 QA,但不保证稳。
- 只支持自家产的几个 GGUF。换别的模型用不上,这是专用的代价。
- 硬件门槛高。主目标 96GB+ Mac / DGX Spark / Strix Halo,普通电脑只能 SSD streaming 低速跑。
避坑提示:
- 那个 126 t/s 是 16 session 的聚合吞吐,别当成单用户速度给自己画饼。
- 没权限系统,跑 coding agent 前先想好隔离,别拿生产机裸奔。
- 模型下载是 137.10 GiB 级别的大文件,SSD 容量和速度都要提前留够。
- 官方明说由 AI coding agent 强辅助开发,介意这一点的人自己权衡。
最后说几句
本地跑大模型这件事,大多数人走的是万能 runner 的宽路,antirez 偏要走专用引擎的窄路。窄路不好走,但走通了就是别人追不上的体验——M5 Max 预填充 790 t/s、8 卡 L40S 聚合 126 t/s,这些数字是死磕几个模型换来的。
如果你正好想跑 DeepSeek V4、GLM 5 这几个模型,DwarfStar 是极客味最正的选择。GitHub 开源地址:github.com/antirez/ds4
对这类专精型推理工具感兴趣的朋友,也可以在云栈社区找到更多同好一起交流。
 发表于 29 分钟前
|
查看: 3|
回复: 0


