自从用 AI Agent 协助编程以后,我干过这样一件事:让 AI 帮忙看看某段代码有没有安全问题。通常的结果是,agent 扫一圈,甩给你一份看上去貌似很全面的疑似漏洞清单——里面混着误报、重复项,还有几条言之凿凿但根本走不通的"发现"。逐条人工复核下来,花的时间比自己审一遍还长。
既然 AI 这么强,为什么连这个看上去不那么难的问题都解决不了?是大模型不够聪明吗?经过一段时间的测试和总结,我才发现真正的问题在于:没人给 agent 立规矩。它既没有"哪些地方还没查过"的记忆,也没有"自己证明自己发现"的约束,更没有"什么算确认、什么只能算线索"的分级标准。
今天就分享一个安全 skill。Cloudflare 最近把这套规矩开源了——security-audit-skill,一个把 coding agent 变成六阶段结构化安全审计员的 skill。我把仓库 README、技能文件以及官方博客《Build your own vulnerability harness》完整拆了一遍。
先说结论:这不是又一个 AI 扫描器,而是一套从 Cloudflare 真实漏洞挖掘 harness 上切下来的方法论,是目前开源世界里少有的正规军打法。
一句话定位
一个 coding agent skill,用六阶段结构化流程 + 对抗性验证 + 机器可读输出,把让 AI 扫一眼代码变成可复现、可累积、可审计的安全审计。
三个核心亮点
1. 六阶段流程,每一步都有明确产物
完整审计被拆成六个阶段:
- 侦察:摸清架构、信任边界、输入面,产出
architecture.md 和 coverage-ledger.json
- 覆盖引导狩猎:按账本的覆盖单元派发隔离的「猎人」agent,各查各的,coverage critic 专门找缺口
- 候选验证:每个候选漏洞交给一个全新的验证 agent,任务是想办法推翻它
- 结构化输出:写入
findings.json,三种判定——confirmed / needs_validation / rejected,由零依赖脚本对照 report-schema.json 校验
- 独立记录验证:新 agent 复核最终结论,重要替换还要再过一轮独立验证
- 目标中立报告:从验证过的记录派生
REPORT.md、FINDINGS-DETAIL.md、NEEDS-VALIDATION.md
每一步都有文件落地、有脚本校验(validate-findings.cjs / validate-coverage-ledger.cjs),不靠 agent 自觉。
2. 发现者永远不是验证者
这是整个设计里最狠的一条原则:检查某个漏洞的 agent,永远不是发现它的那个 agent。
道理不复杂:发现漏洞的 agent 带着"这是个漏洞"的先入之见,自证自卖是它的天性。换成全新的、任务是推翻它的 agent,误报才活不下来。再加上"只确认已证实的边界失效""严重性必须有影响支撑""纵深防御缺口不算漏洞"这几条纪律,产出质量跟一个提示词糊出来的疑似漏洞清单完全不是一个物种。
3. 审计能接着上次干
findings.json 三种判定语义严格区分:confirmed 必须有完整源码轨迹和有界观测结果;needs_validation 必须写明未解决的确切事实且不许标严重性;rejected 记录被推翻的候选。
覆盖账本支持多次运行叠加:只对没覆盖的缺口补查、对变更过的源码复验,已有证据顺延。官方博客还给了一个硬数据:单次运行大约只能发现最终总漏洞数的一半——审计 coverage 这件事,本来就应该是个长跑。
这套流程不是纸上谈兵。据官方博客,它源自 Cloudflare 真实在用的漏洞发现 harness,那套系统用六周时间从单次 slash-command 跑法进化成覆盖 128 个仓库的 fleet 级扫描器,跨仓库追踪依赖、自动在消费方仓库里补派狩猎任务。
为什么凭感觉扫一遍不行
把 AI 安全审计拆开看,旧方案的问题有三个:
- 没记忆:agent 一次只能抱一个假设,覆盖大仓库一小角就塞满上下文,压缩时信息丢失(据官方博客对通用 coding agent 缺陷的描述)
- 没分工:让 agent 自己查自己证,确认偏误拉满
- 没账本:跑完就跑完,下次从零开始,重复劳动且永远不知道自己漏了哪
新架构对症下药:
| 层 |
机制 |
解决什么 |
| 记忆层 |
coverage-ledger.json 覆盖账本 + architecture.md 架构快照 |
「查过哪、没查哪」持久化,多次运行叠加 |
| 分工层 |
侦察 / 猎人 / 验证者 / 报告者全部隔离,验证者任务定义为「证伪」 |
对抗确认偏误,误报在流程内被消化 |
| 纪律层 |
零依赖校验脚本卡住 findings 与账本的 schema |
agent 产出不合格直接被机器打回 |
| 分级层 |
confirmed / needs_validation / rejected 三态 |
确认与线索不混为一谈,人工复核有优先级 |
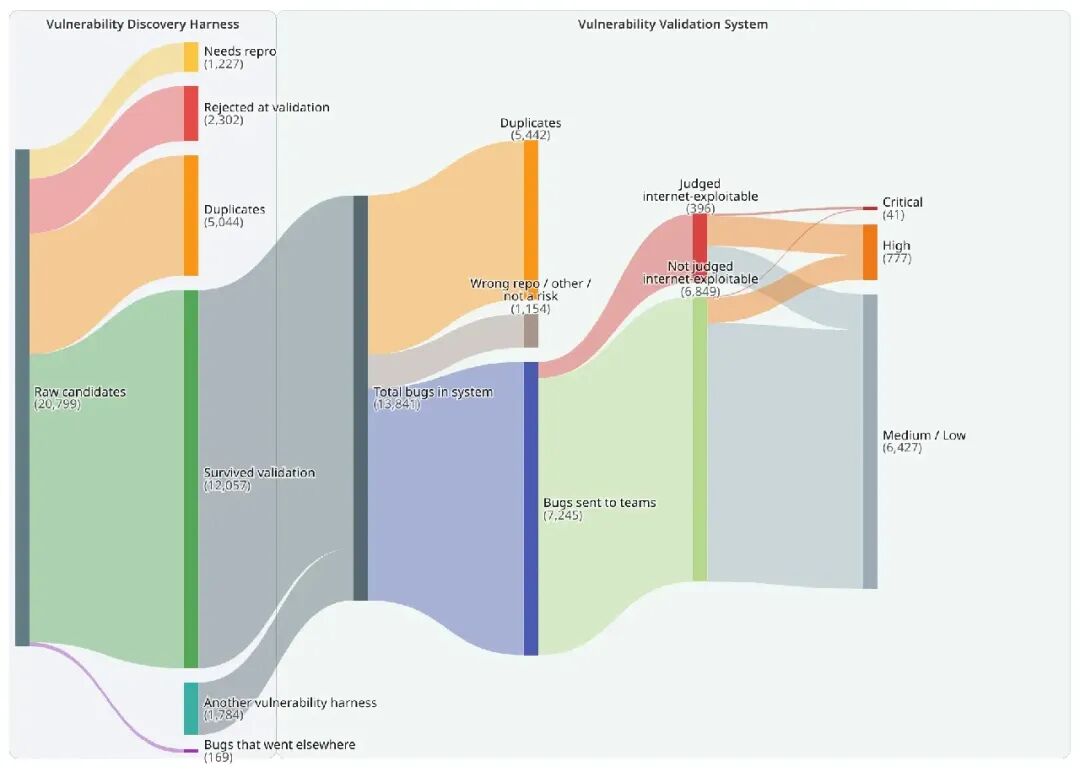
这套方法论的实战成绩单,藏在官方博客的漏斗图里:一轮 fleet 扫描产生 20,799 个原始候选,经过去重(5,044)与验证淘汰(2,302),约 13,841 个进入系统、7,245 个送达团队,最终分级为 41 个严重、777 个高危。候选很多,但每一级都有机械校验和对抗验证把关——这正是机器可读 findings + 覆盖账本跑在真实规模上的样子。
快速上手
装它只要一条命令:
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
加 --global 装到用户级。然后在目标代码库里对 coding agent 说一句:
security audit this codebase
skill 会在请求匹配时自动触发。未指定输出目录时,结果写到 ~/security-audit-skill/<repo-name>/run-<N>。
但有两个硬门槛要心里有数:
- agent 必须支持工具调用 + 并行子 agent——纯对话模型带不动这套编排。如果你的 agent 底层用的是较弱的模型,或者没有配置好工具调用链路,建议先确认清楚,必要时可以通过 RouteFast.ai 这类模型 API 中转服务接入能力更强的模型来驱动。
- 需要 OS 级沙箱:禁外网、资源限制、白名单环境、只允许写指定临时目录。没有沙箱,workflow 会把需要跑目标代码的线索降级为
needs_validation,而不是替你执行——这条默认降级的纪律本身就值得点赞。
企业团队落地:从 skill 到 harness 的路线
官方博客把这个 skill 定位成 harness 的起点:他们把每个阶段提成一个独立 agent,后面加数据库、前面加编排器,映射几乎一一对应,六周长成覆盖 128 仓库的系统。团队规模化可以抄这条路线:
先统一产物标准。 findings.json + report-schema.json 就是天然的团队接口。让所有人的审计结果走同一个 schema,CI 里直接用 validate-findings.cjs 当门禁,不合规的产出机器打回,不依赖某个人的 prompt 手艺。
再把覆盖账本当排期表用。 coverage ledger 记录的就是「区域 × 攻击类」的矩阵缺口。团队评审不用问「这次审得全不全」,直接看账本——没覆盖的格子就是下一个迭代的任务池。
按攻击域分猎人。 skill 自带十大攻击域的狩猎 prompt:内存安全、AI/LLM 注入、Web 协议与认证、客户端 DOM、供应链与发布、云与部署、RPC 与消息、资源耗尽、数据隔离、桌面/移动与本地 IPC(据仓库 skills/security-audit/ 下十个领域文件)。团队里谁懂哪块,就认领哪块的狩猎与验证。
想明白执行环境再上线。 官方博客里有个耐人寻味的细节:他们把 Semgrep 静态分析全链路接入,结果猎人 agent 一个月里调用了零次——agent 宁可自己读代码、跑代码;而愿望清单(wishlist,agent 缺工具时写下需求等人类补给)是全系统使用最多的工具,128 仓库累计写了 25,472 次。团队落地的启示是:别替 agent 预设它该用什么工具,把环境、依赖和权限备好,观察它真正伸手要什么。
适用场景
- 安全工程师 / 开发团队:需要系统化、可验证、可重复的漏洞挖掘流程
- 有合规审计要求的团队:不可篡改的分级记录 + 覆盖账本,天然适配「审过没有、漏了哪」的举证
- 想学 Cloudflare 漏洞挖掘方法论的人:skill 文件本身就是教材,README 直接链到官方博客长文
纯后端 CRUD、没有安全诉求的小团队,这个 skill 是杀鸡用牛刀,不必硬上。
优缺点与避坑
优点:
- Cloudflare 官方出品,方法论来自 128 仓库实战,不是 toy project
- 发现者≠验证者的对抗验证 + 机器可读 findings,直接治 AI 审计不可信的命门
- MIT 免费,校验脚本零依赖,schema 有测试固件兜底
避坑:
- 它不是扫描器,不产出漏洞本身:价值高度依赖背后 agent 的模型能力和工具调用能力,指望装上就自动出洞会失望
- 沙箱是硬要求不是可选项:没 OS 级沙箱,能跑代码的验证全部降级成待验证,产出密度打折扣
- 单次运行别当终态:官方数据是单轮只捞到总量约一半,覆盖靠多轮累积,一次没查出东西不等于干净
- needs_validation 不是免责背书:它有确切未解决事实的严格要求,人工复核时先看这条分级,别把待验证当已确认汇报
写在后面的话
对于架构师的价值:这个仓库值钱的不是那几百行校验脚本,而是覆盖账本 + 对抗验证 + 三态分级这套审计纪律——它回答的是「怎么让 AI 的安全结论可信」这个多数工具根本没敢碰的问题。Cloudflare 把自家漏洞挖掘纪律拆成免费 skill,方法论的含金量远大于代码量;但它是给有安全诉求的团队的基础设施,普通开发者不必凑这个热闹。
对这套审计方法论感兴趣的话,欢迎到 云栈社区 和更多开发者一起交流实践心得。
GitHub 地址:
https://github.com/cloudflare/security-audit-skill
 发表于 半小时前
|
查看: 5|
回复: 0


