省钱的关键,前缀只增不改。
每天在终端里跑上两三个小时的代码审计,token 账单会让人重新想想工具该怎么选。这篇要聊的 DeepSeek-Reasonix 是一个可以挂在终端里不用盯着的 AI coding agent,它省钱的路子跟常规做法不太一样。
本文看点
- 99.82% 是怎么算出来的
- 一条不变量,撑起四种入口
- 模型可以换,前缀不能乱
- 提示词之外的那些能力
- 两套装法,三条命令起步
- 它适合什么活,不适合什么活
一、99.82% 是怎么算出来的
先说那张账单。2026 年 5 月 1 日,一个用户的单日用量是 435,981,235 个 token,拆开是三项:命中缓存的输入 435,033,856,未命中缓存的输入 767,616,输出 179,763。
命中率用第一项除以第一项加第二项,算出来就是 99.824%。
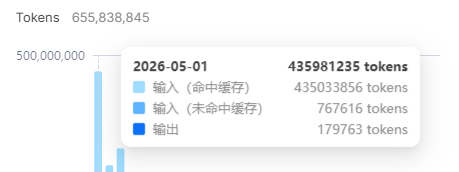
单日用量面板,命中缓存与未命中缓存的分项
未命中缓存的那部分只有七十多万 token,整个故事都藏在这个比值里。DeepSeek 的输入定价里,命中缓存和未命中缓存是两个价,前者便宜一个数量级。同一天的账,项目早期官方 README 给的对照是约 12 美元,不挂缓存要 61 美元。
要把命中率做到这个程度,靠的不是提示词技巧。大模型 API 的缓存按前缀匹配,请求开头那一段只要有一个字节变了,后面全部按未命中算。所以做法是让前缀只增不改——会话往前推进时历史部分原封不动,新内容往后追加。
这条约束听起来简单,落到一个每天都在读写文件、跑命令的 agent 上就很难。工具输出是随机的,文件内容是变化的,任何一段被插进历史中间都会让前缀作废。官方 README 里有一句原话:缓存稳定在它这里是一条不变量,整个循环都围着这条不变量设计。
这也是为什么缓存命中率值得当成一个正经指标看。它同时反映了三件事:你的会话够不够长、你的任务够不够重复、这个 agent 有没有在背后偷偷破坏前缀。前两件取决于你怎么用,第三件才是工具之间的差别。
官方的基准目录里还有另一个数字。一套四十九次运行、一千两百九十万 token 的受测任务集,缓存命中率是 71%。两个数字并不矛盾——99.82% 来自长会话里前缀高度重复的场景,71% 来自任务类型不断变化的场景。你在自己的项目里能跑到多少,取决于你的活儿有多重复。
二、一条不变量,撑起四种入口
Reasonix 把自己定位成一个可以挂着跑的 coding agent,发行形态是单一 Go 二进制,MIT 协议,四月建的库。仓库现在三万五千多 Star。
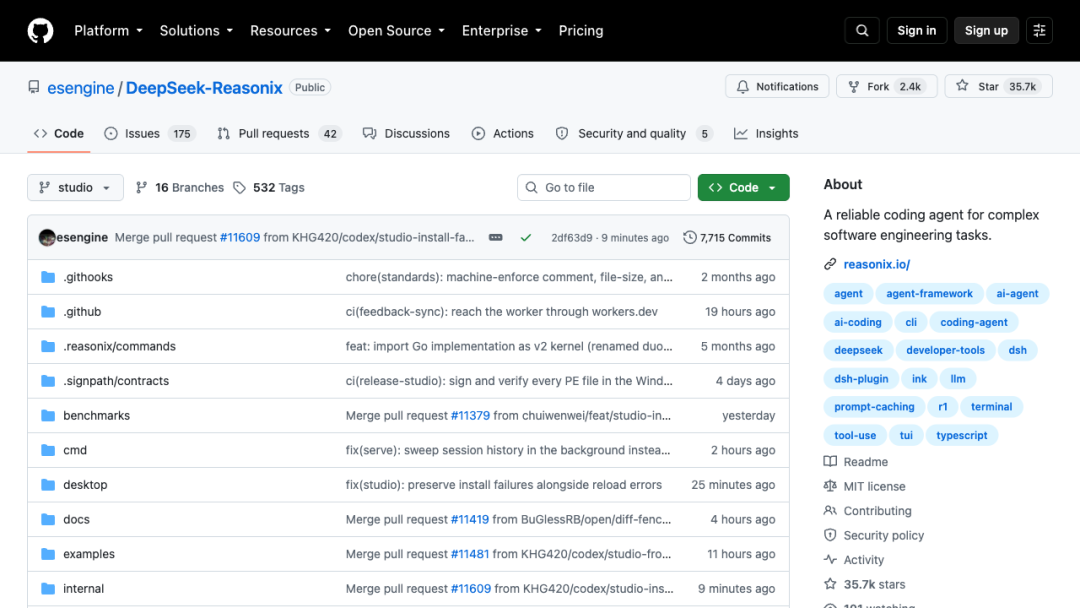
esengine/DeepSeek-Reasonix 仓库首页,Star 约 3.6 万
同一个本地引擎开了四个入口:终端界面、桌面应用、浏览器,以及通过 reasonix acp 接进编辑器的 ACP v1 通道。四者共用同一份工作区和同一份配置。
围绕缓存这条不变量,官方写了三条具体的工程做法:启动时注入一份小而不变的环境摘要,而不是每次重新描述项目;过期的工具输出先做 snip 再 prune,处理完才交给摘要压缩,避免压缩结果每次都变;内置工具的 schema 契约写成文档,改动前先做回归审查,因为工具定义本身也在前缀里。
权限是三档预设。read-only 只读工作区,写操作和外部副作用需要单独授权。workspace-write 是默认档,可以在工作区和私有的会话临时目录里写,命令跑在操作系统沙箱内。danger-full-access 以当前用户身份裸跑,没有文件系统和网络沙箱。配置里写死的拒绝规则永远优先于命令行给的允许规则。
它做修改的方式是 SEARCH/REPLACE 块,模型提出要改的内容,界面上给你看一遍,确认之前磁盘上一个字节都不动。
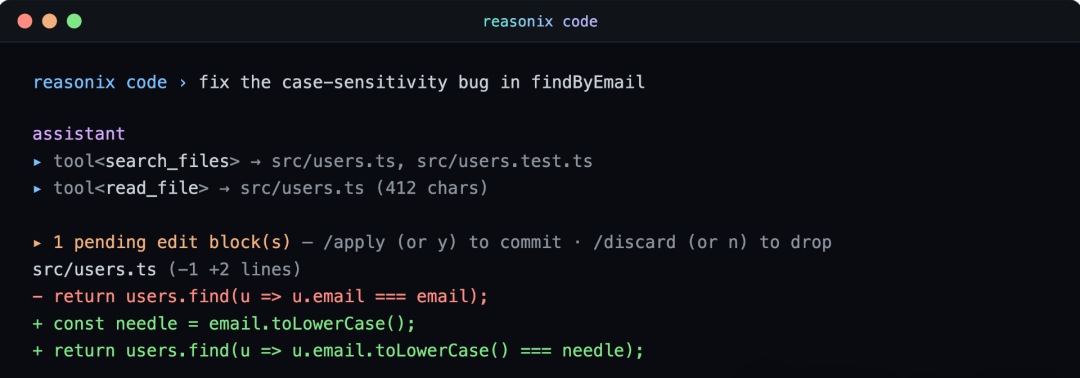
reasonix code 的终端画面,待确认的编辑块与红绿 diff
上图是这一屏的真实样子,模型先调 search_files 和 read_file 定位,再给出一个待确认的编辑块,提示行直接写着 /apply 或 y 提交,/discard 或 n 放弃。配合它还有一层逐轮的自动检查点,回滚是会话内的,不会把 git 历史搅乱。
计划模式解决的是另一类问题。打开之后模型进入只读状态,只能看文件和推理,不能动磁盘也不能跑 shell。它会先把项目结构摸清、把相关代码读完,生成一份执行方案交给你确认,确认之后才动手。遇到大量重构或者不确定性高的任务,先让它把方案写出来再看,比直接放开手要稳。
三、模型可以换,前缀不能乱
早期这个项目把自己锁死在 DeepSeek 上,理由很直接:只有绑死一个后端,才能针对它的缓存行为做深度优化。
现在的形态是配置驱动。provider、agent、启用哪些工具、装了哪些插件,全部写在 reasonix.toml 里,官方 README 的措辞是没有硬编码模型。DeepSeek 作为预设随包提供,任何 OpenAI 兼容的端点都只是一条配置项,不是新代码。用户级配置和项目级配置分开放,reasonix setup --local 管的就是项目里那一份。
它还能让两个模型一起干活,一个当执行器一个当规划器。这里有个取舍值得说清楚:两个模型各自开一个独立会话,而不是在同一段对话里轮换。原因还是前缀——同一段共享对话里换模型会把前缀打散,命中率直接掉下去。
会话是按工作区自动保存的,这也是缓存能持续生效的前提。--continue 接着最近一次,--resume 支持按标题或内容片段检索恢复,--copy 在一个可写副本里继续、原记录不动。续上之后之前那段前缀还在,只按新增的 token 计费。
日常用得多的是另外几个参数。--model 指定这次用哪个已配置的 provider 或模型,--effort 临时调整推理深度,--max-steps 限制工具调用的轮数上限,--dir 换工作区根目录。一次性任务用 reasonix run 跑完就退出,适合塞进脚本和自动化流程。
四、提示词之外的那些能力
记忆系统分全局和项目两层,条目类型有四种,分别对应个人信息、偏好反馈、项目背景和参考资料。它不只存内容,而是把记忆封进每次请求的最前端,模型每轮都看得见。这些字节同时成为前缀的一部分,多次请求只算一次钱。写入方式很直接:说一句要记住什么,模型调用工具生成条目,你确认之后生效,下次开新会话不用再说一遍。
技能就是一个 Markdown 文件。前置的 frontmatter 写它是什么、怎么跑,后面是具体指令,用 /skill new 生成模板,用 /skill 加名字调用。运行模式有两种:inline 在当前上下文里跑,subagent 派出独立子 agent 只把结果带回来,后者不污染主会话上下文,适合重复性检查和自动化工作流。已有的 Claude Code 格式 skill 文件放进 .claude/skills/ 目录就能直接用,不用改格式。
Hooks 是生命周期机制,四个时间点可以挂自定义 shell 命令。工具调用前跑 PreToolUse,退出码为 2 就拦下这次调用,可以拿它挡掉涉及敏感路径的命令。工具跑完跑 PostToolUse,适合挂自动格式化和写日志。用户输入提交后跑 UserPromptSubmit,同样能用退出码 2 拦截消息。会话退出时跑 Stop,用来清理临时资源。项目级配置优先于全局级。
MCP 这块它是客户端,支持三种传输。stdio 走本地子进程,http 走 Streamable HTTP,sse 是官方标注的遗留路径。配置写在 reasonix.toml 的 [[plugins]] 条目里,用 type 字段选传输。配好之后 GitHub、数据库、Jira 或者自建内部接口都能变成模型手上的工具。界面里用 /mcp 打开面板看已连接的服务和它们暴露的工具,/mcp reconnect 可以热重连拉新工具列表。
剩下的能力里,语义检索值得单独提一句。跑一次 reasonix index 给项目建语义向量索引,之后模型搜代码不用递归扫目录,直接语义搜索。嵌入引擎可以用本地 Ollama,也可以接任何 OpenAI 兼容接口。大代码库上这一项的差别很明显,模型能定位到具体代码位置而不是在整个项目里瞎摸。
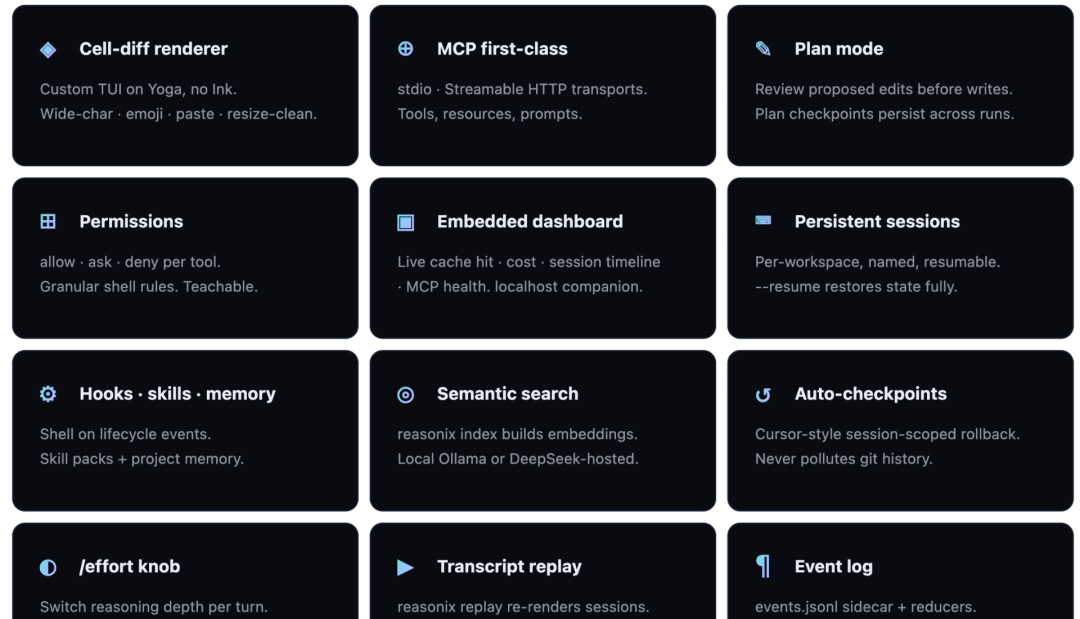
官方功能格盘,十二项能力一览
上图是官方的功能格盘,除了上面讲过的这些,还有内嵌面板里的实时缓存命中率与成本、推理深度旋钮、会话回放和事件日志。桌面客户端和 CLI 共用一个 API 凭据、共用同一个配置目录,编辑器里还能装 VS Code 扩展。还有一条不占终端的路子:开一个会话跑 /qq connect,之后在 QQ 里发的消息可以直接进这个会话,回应也会路由回去。
五、两套装法,三条命令起步
命令行版本两条路任选,npm 全局装或者 macOS 上的 Homebrew。
npm i -g reasonix
brew install esengine/reasonix/reasonix
装完先跑一次配置,它会带你把 provider 和默认模型选好,密钥存在本地,之后不用再填。
reasonix setup
之后直接敲 reasonix 进交互界面,或者用 reasonix run 丢一个任务就跑完退出。
reasonix run "implement the TODOs in main.go"
不想碰命令行的话,官方下载页有三平台的桌面安装包,Windows 安装器已经用 Certum 证书做过代码签名。编辑器里想用的话先装好 CLI,再装 VS Code 或 VSCodium 的扩展,扩展会自己去连本地的 reasonix acp 后端。版本更新用 reasonix upgrade 自更新。
六、它适合什么活,不适合什么活
适合的是重复度高的批量活。大量扫描代码、分析某一类操作模式、写 PoC 骨架、跑固定流程的检查——这些任务的前缀高度稳定,跑几轮之后每轮只需要补少量新 token,成本压得很低。语义索引加 subagent 技能这套组合,正好对上这类场景。
不适合的是需要顶级推理的活。跨系统的架构分析、复杂重构的方案设计,Claude Code 配合更强的模型确实更稳。它的模型可以换,但换了之后缓存优化就不再是针对性的,想省钱最好还是用预设的那条路。
跟 Aider 这类多模型工具比,差别也在同一个地方。多模型支持换来的是灵活性,代价是没法对某一家 API 的缓存行为做到底层适配,长会话里前缀一变就要重新计价。这不是谁好谁坏,是两种取向。
从源码构建需要 Go 版本达标,日常使用不必走这条路。另一个要提前知道的是稳定性。它还在快速迭代,版本号一天一个,用它跑关键任务之前先把检查点开着,重要改动先过一遍 diff 再确认。省钱的前提是别出事。
作者自己的结论也是这个意思:成本确实能压下去不少,但当编程主力还不行。搭配着用在合适的任务上,省下来的钱是实打实的。
仓库地址: https://github.com/esengine/DeepSeek-Reasonix
 发表于 2 小时前
|
查看: 6|
回复: 0


