用过 ChatGPT、文心、豆包的人都有同一个感受:AI 是一个字一个字蹦出来的。很多工程师把这当成 UI 层装饰,反正最后总会出完,加个 loading 动画也就能对付过去。“这不就是前端 streaming 渲染吗?”——这句话放在 Web 开发里没错,搬到 LLM 上却不成立。流式输出不是 UI 层的选项,而是 LLM 推理机制带来的硬约束。
这一篇讲 3 件事:为什么模型只能逐 token 返回;怎么用 SSE 把这条流接到浏览器;流式到底换来了什么、没换来什么。
一、为什么 LLM 只能逐 token 输出
可以把 LLM 看成一个“接下一个字”的函数:拿到前 N 个 token,吐出第 N+1 个;再把第 N+1 个拼回去,继续吐第 N+2 个。这就是自回归(autoregressive)模式。第 N+1 个 token 依赖第 N 个产生的隐藏状态,所以“并行预生成整段回答”这条路从一开始就被堵死了。GPU 并行能力再强也没用,第 N 步和第 N+1 步之间存在严格的数据依赖,先后顺序不能乱。
只锁住生成顺序还不够。每一步还要决定具体输出哪个 token,采样阶段又把路收紧了一点。top-p、temperature、top-k 这些参数每一步都会重新计算概率分布:拿到第 N 个 token 的 logits 后,先过滤、再归一化、最后采样得到第 N+1 个 token。这一步不完成,下一个 token 的概率分布根本算不出来。无论用贪心(greedy)还是随机采样(sampling),每一步都得跑一次前向传播才能拿到下一个 token,本质没有区别。
加速只是手段,预生成完全不可能。4-bit 量化、KV cache、批处理、投机解码,都是把“单步生成”压得更快一些,没有一种能跳过第 N 步、直接拿到第 N+10 步。
所以逐 token 输出是由“自回归 + 采样”共同决定的,根本不是一个 UI 选项。
这个结论对应用层有两个直接推论。第一,模型接口不能假设一次性返回完整字符串,必须按迭代器(iterator)来消费;第二,前端必须能够拿到增量 token 并实时渲染。这两个推论都不在传统前端 streaming 渲染的射程内:HTML streaming 推送的 chunk 本质是 HTTP 切块,发送之前就已经切好了;而 LLM 推送的 token 是逐个实时生成的,第 N+1 个还没出来之前,第 N+2 个根本不存在。
LLM 的输出形态很明确:服务器推、客户端收、单向、纯文本。那到底该用哪种协议来承接?
二、怎么用 SSE 把这条流接到浏览器
能选的主流机制有 3 种,差别在方向和重连成本:
| 机制 |
连接方向 |
重连成本 |
LLM 应用场景 |
| SSE(Server-Sent Events) |
单向(server → client) |
低(浏览器内置自动重连) |
LLM 输出(主流场景) |
| WebSocket |
双向 |
中(需心跳 + 重连逻辑) |
多轮对话、工具调用流 |
| 轮询 |
客户端拉 |
高(每 N 秒一次) |
不支持长连接的环境(IE、部分 CDN) |
SSE 协议很简单:HTTP 长连接 + Content-Type: text/event-stream + 每条消息以 data: ...\n\n 收尾。浏览器原生的 EventSource 会自动解析格式,并在断线后自动重连。
WebSocket 听起来更通用,但在这个场景里有点杀鸡用牛刀:LLM 输出本来就是单向文本流,双向能力用不上,反而要自己处理心跳(比如 30 秒一次 ping/pong)、断线重连和消息去重。只有多轮对话场景(用户中途打断、工具调用中间结果回传)才真正需要 WebSocket,因为客户端要反向发数据。
轮询只能当兜底方案:用 setInterval 每秒拉一次“生成到哪了”,延迟和带宽都不理想。除非环境真的不支持长连接(某些 CDN、老 IE),否则优先用 SSE。
时序图:
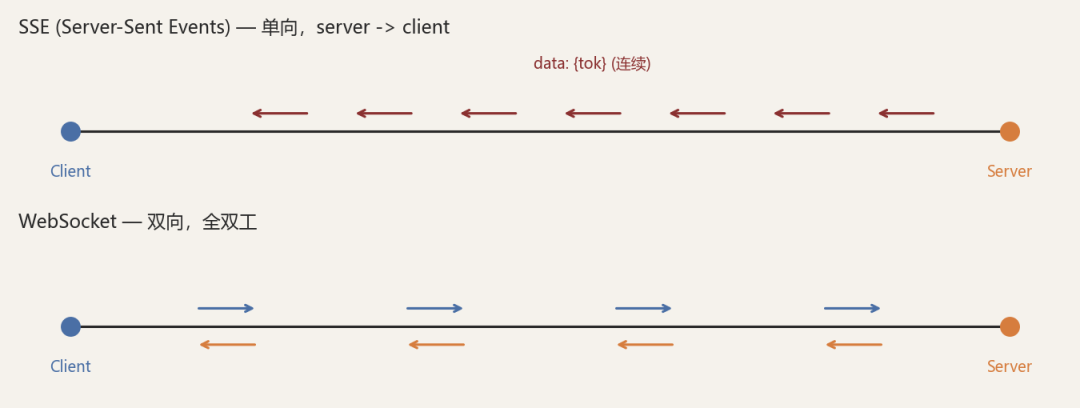
上面是 SSE 的单向通信,服务器连续推送 data: {tok};下面是 WebSocket 的全双工通信,双方各自发帧。在 LLM 单向输出这个场景里,SSE 链路更短、更直接。
链路分 3 层:浏览器 → FastAPI → 模型。
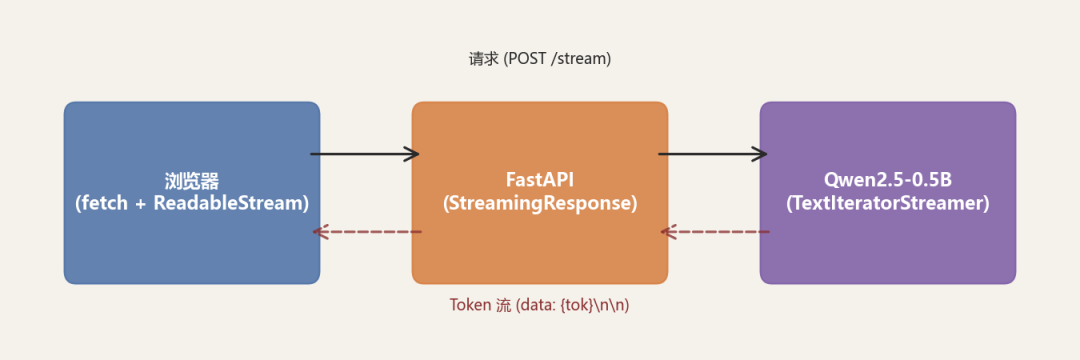
浏览器 fetch + ReadableStream → FastAPI StreamingResponse → transformers TextIteratorStreamer → 模型逐 token 生成。
每一层只做一件事:模型层把同步的 generate() 封装成 token 迭代器;FastAPI 层把这个迭代器包装成 SSE 响应;浏览器层再把 SSE 数据解析成逐字追加。
模型层(stream.py):TextIteratorStreamer 把生成过程包成迭代器,Thread 让阻塞的 model.generate() 跑在副线程,主协程只负责消费:
streamer = TextIteratorStreamer(tokenizer, skip_prompt=True)
Thread(target=model.generate, kwargs={**inputs, "streamer": streamer}).start()
for token in streamer:
    yield f"data: {token}\n\n"  # SSE 协议:每条消息以空行结尾
FastAPI 层(app.py):StreamingResponse 接住这个迭代器,指定 media_type="text/event-stream":
return StreamingResponse(generate(prompt),
    media_type="text/event-stream",
    headers={"X-Accel-Buffering": "no"})
浏览器层(index.html):用 fetch + ReadableStream(MDN Streams API)而不是原生 EventSource,因为 EventSource 只支持 GET、传不了 JSON body:
for (const line of decoder.decode(value).split('\n')) {
  if (line.startsWith('data: ')) output.textContent += line.slice(6);
}
别忘了自己起副线程:FastAPI 运行在单线程事件循环上,如果同步的 model.generate() 直接跑在端点里,整个服务会在生成期间被卡住,其他请求全部超时。另一类常见问题是缓冲:服务器推得再快,反向代理攒够一批才吐给浏览器,逐 token 又退回一次性返回,需要把 NGINX 缓冲关掉。还有消息边界的问题:SSE 是文本协议,每条以空行结尾,而 reader.read() 不会按消息边界切分,所以要按照 \n 拆行,再用 data: 前缀筛选。
三段代码接上之后,数据就能从模型一路流到浏览器:模型异步吐出 token → FastAPI 转成 SSE → 浏览器 fetch 逐字追加。如果你不想在本地托管模型,RouteFast.ai 这类大模型 API 中转服务同样提供 SSE 流式输出,链路里就能省掉模型层那一段。
三、流式换来了什么:TTFT 和 TPOT 是两个问题
链路是跑通了,但流式到底换来了什么体验?得拆成两个指标看。
TTFT(Time To First Token):从发出请求到拿到第一个 token 的耗时,反映 prompt 预处理和第一次前向传播的成本,决定“用户要等多久才能看到第一个字”。TPOT(Time Per Output Token):相邻两个 token 之间的平均间隔,反映稳态生成速度,决定“第一个字出来之后,后面打字快不快”。
流式并不会改变这两个数字中的任何一个。它改变的是第一个字出现之后的等待方式。
下面是本机实测数据(CPU + Qwen2.5-0.5B-Instruct + fp16,沿用项目里的 20 道环境违法描述作为 prompt),同一套代码跑了两遍。两次结果有差异,但这差的是机器状态,不是流式开关:
| 指标 |
第一次跑 |
第二次跑 |
差 |
| 平均 TTFT |
573.3 ms |
713.8 ms |
+24% |
| 平均 TPOT |
140.2 ms |
175.6 ms |
+25% |
| 平均生成 token 数 |
191.9 |
195.7 |
+2% |
| 平均总耗时 |
27.2 s |
34.8 s |
+28% |
两次生成的 token 数几乎一样,但时间类指标差了四分之一左右。同一个模型、同一批题、同一份代码,只是换个时间跑,快慢就能差这么多。
模型吐多少 token 是模型的性质,吐得多快是这台机器的性质。
第二次跑之前还踩了个坑:device_map="auto" 在内存不够时会悄无声息地把权重卸载到磁盘,那一次每道题慢了 8.6 倍。数字看着一切正常,不查日志根本发现不了。在本机跑分之前,得先确认权重确实待在内存里。
我原本想从这 20 道题里挖出两个指标分别由什么决定,算完发现挖不动。20 题的样本根本支撑不起相关性结论,同长度分组内也能差出 400–650 ms,比长度从 13 个汉字到 24 个汉字带来的差异还大,说明长度并不是主导因素。生产环境的绝对值本机测不出来(全程 CPU),作为参照,GPU + 4-bit 量化下 TTFT 可以压到 200 ms 以内。明细数据见 projects/llm_streaming/ 下的 bench_results.json 和 bench_results_run2.json。
实验挖不动,不如换个问法:流式到底为什么必要?拿第一次跑的数据看:27 秒的回答,TPOT 140 ms 意味着用户每 0.14 秒看到一个新字。如果改成“全生成完再一次性返回”,TTFT 就等于总耗时 27 秒。流式把等待体验从“干等 27 秒看全文”变成了“等 0.6 秒看到第一个字,然后逐字追加”。两者体感相差约 45 倍。
想进一步优化,TTFT 和 TPOT 必须分开调。TTFT 偏高,卡在 prompt 编码和第一次前向传播这两段固定开销上。要压它,就得压缩 prompt(system prompt 别写 500 字说明书)、上 KV cache 预热,或者直接上 GPU + 4-bit 量化。TPOT 偏高,更多是稳态计算密度的问题,上 GPU 加速效果最直接。CPU 跑 0.5B 模型大约是 140–176 ms/token(两次跑的区间),GPU 跑同模型可以压到 30–50 ms/token。把两个指标混在一起调,是常见误区。
小结
流式不是 UI 选项,而是 LLM 推理机制带来的硬约束。自回归决定了模型只能逐字吐出,SSE 是这条输出流的天然协议,三段代码就能把链路接通。总耗时并不会因此改变,首 token 该等多久还是等多久。真正变的,是等待的形状:同样是 27 秒,干等变成了边看边等。
配套代码在 projects/llm_streaming/ 目录下,本机 CPU 跑 Qwen2.5-0.5B-Instruct,20 道题实测得到 TTFT(首 token 延迟)和 TPOT(逐 token 间隔)数据。如果你想继续折腾这类实践,欢迎到 云栈社区 交流。
 发表于 1 小时前
|
查看: 6|
回复: 0


