最近如果你经常刷 X,大概率已经被一个叫 Jev 的东西刷屏了。至少我的时间线是这样——最近差不多 70% 的内容都在讨论 Jev。
2026 年 9 月 15 日,TypeSafe AI 正式发布了 Jev。它看起来像一个 AI 模型,但工作方式和我们熟悉的 Claude、GPT 完全不同。
因为它几乎不负责「说话」。
Jev 更像一个专门负责判断的模型,只返回三种结果:
Choice、Score,以及 Noul(Yes/No 概率)。
也就是说,你不会让它帮你写文章、总结报告或者回答问题。它真正擅长的是另一件事:
快速做判断。
Jev 不生成文本,而是返回「类型化判断 + 校准后的概率」。它的响应速度大约只有 70~500ms,成本甚至可能比传统 LLM 低几十倍乃至上百倍。更特别的是,它从设计上就放弃了文本生成,只负责以非常低的成本快速完成分类和判断。
当然,这并不意味着它比前沿大模型更聪明。从目前公开的验证结果来看,它的准确率整体仍然比顶级 LLM 低一个档次。
但问题来了:
如果我们根本不需要它生成答案呢?
例如,让 Jev 负责判断,让 Claude 负责生成。事情一下子就变得有意思了。
LLM 最头疼的问题,可能一直没解决
做过 LLM 应用的人,应该都遇到过一个很烦的问题:
幻觉。
模型可能一本正经地告诉你一个完全错误的答案。更麻烦的是,即使你不断纠正它,它有时候依旧会重复犯错。
然而,真正危险的其实还不是「答错」。而是——
它说错话时的语气,和说对话时几乎没有区别。
你很难仅凭语气判断一个答案到底靠不靠谱。以前的大模型甚至在日期这种基础信息上都会频繁出错,数学计算、精确数字之类的问题更不用说。当然,现在的模型已经进步了很多,可问题并没有彻底消失。
于是,RAG 出现了。
RAG,也就是 Retrieval-Augmented Generation,中文通常称为检索增强生成。它的思路并不复杂:当模型需要精确信息时,不要逼它从参数里「回忆」,而是让它去外部数据源里找。
以前也反复提到一个观点:知识不一定非要全部记在模型里,需要的时候把它检索出来,很多时候反而更加合理。 因为一旦存在明确的外部证据,模型就可以根据找到的资料回答,而不是凭模糊的「印象」猜答案。至少这样一来,回答有机会被验证,信息来源也可以追溯。
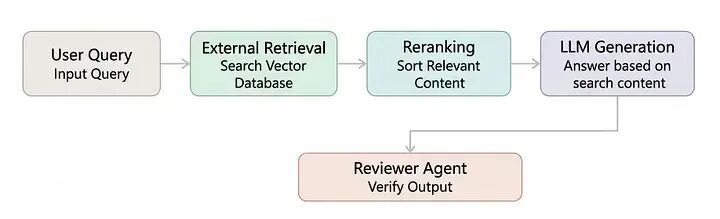
可惜,RAG 仍然解决不了全部问题。因为即便检索出来的资料本身完全正确,LLM 依然可能理解错。它可能错误使用某段资料,也可能在整合多个搜索结果时出现逻辑偏差。
因此,一个完整的 RAG Pipeline 里,Reranking(重排序)以及后面的 Reviewer Agent(审查 Agent)并不是多此一举。 它们实际上是在给最终答案增加一道保险。
先看看一个 RAG 应用到底怎么跑
为了让整个过程更直观,我们先快速看一个实际运行的聊天机器人。
打开应用以后,它第一件事不是调用大模型,而是检查 documents/ 文件夹。里面所有 PDF 和文本文件都会被扫描一遍,系统会判断这些文件和上一次运行相比有没有发生变化。
第一次启动时,程序会逐页读取文档。然后,把长文本拆成一个个比较小的 Chunk。不同 Chunk 之间会故意保留少量重叠内容,避免因为切割位置不巧,把关键上下文直接切没了。
接下来,系统调用 OpenAI 为这些 Chunk 创建 Embedding,并将向量数据保存在本地的 Chroma 向量数据库 中。与此同时,界面会通过进度条告诉你当前处理到了哪里。
第二次再打开应用,情况就不一样了。已经处理过的内容没必要全部重新计算,程序会直接读取保存在电脑上的索引,所以启动速度会快很多。
如果某个文件无法正常读取,比如扫描版 PDF 或损坏的 PDF,应用也不会直接崩溃,而是把有问题的文件显示在侧边栏中。你还可以通过侧边栏继续上传文件,新文件会自动进入索引。
同时,检索参数也可以手动调整,比如:搜索多少个 Chunk、最终保留多少个高质量 Chunk,以及相关性分数到底设置多严格。
假设我现在问:
「什么是 Reranking?」
应用会把整个检索过程一步步展示出来。
首先,它会把用户的问题重新整理成一个更清晰、更适合搜索的 Query。接着,从向量数据库中找出距离最近的 15 个 Chunk。然后,再让一个比较小的 OpenAI 模型检查这 15 段内容,并分别给出 0~4 的相关性评分。低分内容直接淘汰,真正相关的 Chunk 才会送给最后负责回答的大模型。
答案随后以流式方式逐字显示出来,而且模型被限制只能根据检索到的文档回答。回答中还会自动带上 [1]、[2] 这样的引用。
答案下方则有一个 Sources 区域。这里会展示对应的文件名、页码、相关性评分、置信度以及相似度。真正参与最终回答的来源会被高亮,而那些虽然被检索出来、最后却没有使用的资料,则会弱化显示。
这就是一个比较典型的 RAG 工作流程。
Jev 到底应该塞进 RAG 哪里?
大致有两个位置:
一个在向量搜索之后,一个在向量搜索之前。
模式 1,是先进行搜索,再让 Jev 过滤搜索结果。模式 2,则是在搜索发生之前,让 Jev 根据问题决定「这一次应该使用哪些 Tag 缩小检索范围」。
两个方案看起来只差一个前后顺序,实际解决的问题却并不完全一样。
模式 1:搜完以后,让 Jev 筛一遍
第一种方案最好理解。先通过 WHERE 条件和向量搜索拿到一批候选结果。随后,Jev 读取每个 Chunk 的具体文本,并判断它到底是不是我们真正需要的内容。
这种方法的优势在于:它可以处理那些必须真正「读内容」才能判断的问题。
比如两篇文档讨论的主题非常接近,可目标受众完全不同。仅仅依靠 Embedding,相似度可能都很高。然而,人读完之后马上就会发现:
「这根本不是写给同一类人的。」
这种时候,Jev 就可以承担第二层筛选工作。
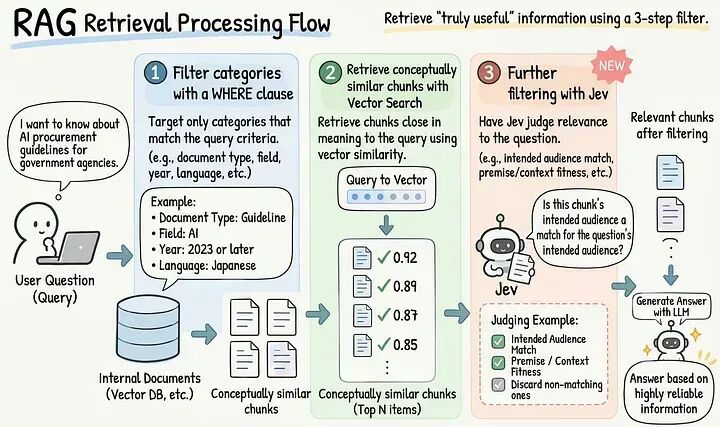
模式 2:搜索之前,先让 Jev 选 Tag
第二种玩法更有意思。
假设 Cosmos DB 中的每条记录都提前带有 Tag,例如:文档类型、所属领域、发布日期、语言等等。用户提出问题以后,不马上做向量搜索,而是先把问题交给 Jev。Jev 根据 Query 判断这次应该选择哪些 Tag,然后利用这些 Tag 构造 WHERE 条件,最后才真正执行向量搜索。
这样做的价值很明显。如果某些条件能够提前确定,我们就可以先通过 WHERE 缩小数据范围,从而节省 RU。区别只在于,以前这些过滤条件可能由用户自己填写;现在,条件可以直接由 Jev 根据问题自动判断。
那么,Tag 怎么选?主要有两种方式。
对于只由一个因素决定的属性,例如文档类型,可以直接使用 Choice。Jev 从你提供的选项中挑一个。Choice 最多支持 255 个选项,而且还能加入 other,也就是「以上都不是」。
但如果某个字段可能同时对应多个 Tag,就可以针对每个 Tag 单独发起一个 Noul 判断。这些问题可以并行评估,而且能够合并到同一个 Request 中。所以即使 Tag 数量增加,延迟也不一定会明显上涨。
目前我还没有确认一次请求最多究竟能提交多少个问题。不过,整个请求大约存在 64,000 Token 的总限制。因此,你为每个 Tag 写的描述越长,最终输入自然也会越大。
这里还有一个非常重要的坑:
Tag 一旦选错,后面的搜索可能从一开始就错了。
因为错误的 WHERE 条件可能直接把真正包含答案的 Chunk 排除在搜索范围之外。所以最好准备一个 Fallback。例如,当 Choice 的 confidence 很低,或者 Noul 的概率接近 0.5 时,不再强行缩小范围,而是退回到完整数据集进行搜索。宁可多搜一点,也不要在第一步就把正确答案过滤掉。
实测 1:Jev 能不能替代 Reranker?
接下来开始验证。第一项测试非常直接:
Reranking。
我拿了三种方案进行比较。
Cohere Rerank 3.5 / Amazon Rerank 1.0
把一个问题和 20 个 Chunk 一起传入 Bedrock 的 Reranking 功能,然后根据结果重新排序。
Claude Haiku 4.5
把 20 个 Chunk 编号后一起交给 Claude,然后要求它:
「按照与问题的相关程度,从高到低返回编号。」
Jev
针对 20 个 Chunk 分别创建一个 Score 类型的问题:
「这段内容与当前问题的相关程度是多少?」
接着,把 20 个判断一次性塞进同一个请求。例如:
{
  "model": "jev-1.13.0",
  "state": {
    "query": "What is the deadline for transportation expense reimbursement?",
    "items": [
      {
        "id": "item_0",
        "title": "Travel and Transportation Expense Regulations",
        "text": "Transportation expense reimbursement requests must be submitted by the 25th of each month."
      },
      {
        "id": "item_1",
        "title": "Travel and Transportation Expense Regulations",
        "text": "To request transportation expense reimbursement, enter the date of use, travel route, business destination, and purpose into the expense reimbursement system..."
      }
// … up to item_19
    ]
  },
  "questions": {
    "rel_0": {
      "type": "score",
      "instructions": "How relevant is the text of item_0 to the query?",
      "criteria": [
        "0 - Irrelevant. It has nothing to do with the query.",
        "1 - Loosely related because it is in the same general area.",
        "2 - It concerns the same subject, but addresses a different matter from what the query is asking.",
        "3 - It concerns the same subject and the same matter as the query. It does not matter whether the answer itself is explicitly written."
      ]
    }
// … up to rel_19, one question for each chunk
  }
}
这里的评分标准按照 0 分 → 3 分依次排列。其中,3 分标准里我特意加入了一句话:
「无论答案本身是否明确写在里面,都不影响相关性判断。」
为什么要这么写?因为我们现在判断的是「相关性」,而不是「这段文字能不能直接回答问题」。如果把两个概念混在一起,评分很容易被「有没有出现答案」干扰。拿到结果之后,再按照 Jev 返回的 Score 从高到低排序。
结果怎么样?
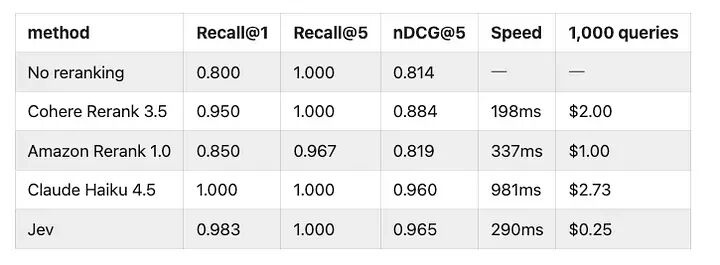
首先,Haiku 基本可以排除了。它不仅接近 1 秒,而且还是几个方案里成本最高的。为了完成一次排序专门调用 LLM,然后马上把它踢出后续流程,我个人觉得性价比不高。
真正值得比较的是:两个专业 Reranker 和 Jev。
结果有点出乎意料。在准确率和速度方面,三者并没有拉开特别明显的差距。真正拉开距离的是价格:
Jev 的成本只有大约 1/8。
看到这里,你可能已经准备下结论:
「那还比什么?直接 Jev 啊。」
先别急。因为这次准确率测试本身并没有那么有说服力。在完全不进行 Reranking 的情况下,Recall@5 已经达到 1.000。
什么意思?也就是说,仅仅通过最开始的向量搜索,正确答案本来就已经进入前 5 了。换句话说:
这个测试里可能压根不需要 Reranker。
所以,仅凭这一组结果,还不能证明 Jev 已经可以彻底取代专业 Reranker。
实测 2:它能判断「这个问题答不了」吗?
这其实是我更关心的一项能力。因为 RAG 里有一个很容易被忽略的问题:
搜到了相关资料,不代表搜到了答案。
假设用户问:
「育儿假期间申请社会保险费减免,最晚什么时候提交?」
检索系统找到了大量「育儿假」和「社会保险费」的文档。从主题上看,全都很相关。可如果这些资料里压根没写截止日期呢?
这个时候,如果还是把内容丢给 LLM,它就可能开始自己补。而如果系统能提前判断:
「现有资料不足以回答这个问题。」
那么我们甚至可以不调用最终 LLM,直接返回:
「没有找到相关信息。」
这样不仅更安全,还能省掉一次大模型调用成本。
怎么判断?
第一种方案是传统的 Rerank Score Threshold。如果 Reranker 返回的最高分低于某个阈值,就判定当前资料不足以回答。这种做法在 RAG 系统里已经使用很久了。
为了公平测试,我先用 40 个问题确定阈值,然后才开放测试集。最终:
- Cohere 阈值设置为 0.672。
- Amazon 设置为 0.0006。
因为不同方法输出的 Score 范围完全不同,所以阈值必须分别确定,不能拿一个数字通用。
第二种方案是 Claude Haiku 4.5。给它一个问题和 Top 5 Chunk,然后只问:
「仅依靠这些信息,能不能回答这个问题?」
只允许回答 Yes 或 No。
第三种,就是 Jev。同样,把问题和 Top 5 Chunk 一起交给它,让 Noul 做 Yes/No 判断。
为了保证公平,三个方案使用的五条内容完全一致:全部都是通过 Cohere Rerank 3.5 排序后的 Top 5。
Jev 的请求大概是这样:
{
  "model": "jev-1.13.0",
  "state": {
    "query": "By when do I need to apply for the social insurance premium exemption while on childcare leave?",
    "items": [
      {
        "id": "item_0",
        "title": "Childcare and Family Care Leave Regulations",
        "text": "Social insurance premiums during childcare leave are exempted upon request by the employee. The Human Resources Department handles the procedure."
      }
// … up to item_4
    ]
  },
  "questions": {
    "can_answer": {
      "type": "noul",
      "instructions": "Do the texts in the items contain evidence that can answer the query?",
      "criteria": {
        "true": "At least one of the items directly states the value, condition, method, or contact point requested by the question, so the question can be answered using only the items.",
        "false": "The items discuss the same topic as the question, but do not state the specific information being asked for. Or they only point to another source (for example, 'as separately specified' or 'check with the responsible department'). Or they concern a different subject or matter. Answering the question would require information that is not provided."
      }
    }
  }
}
注意这里对 false 的定义。「讨论了同一个主题」远远不够。真正的判断标准是:
现有文本里,到底有没有直接证据能够回答用户正在问的那个问题。
如果文档只是说「具体规定另行通知」,或者「请咨询相关负责人」,同样应该判定为无法回答。
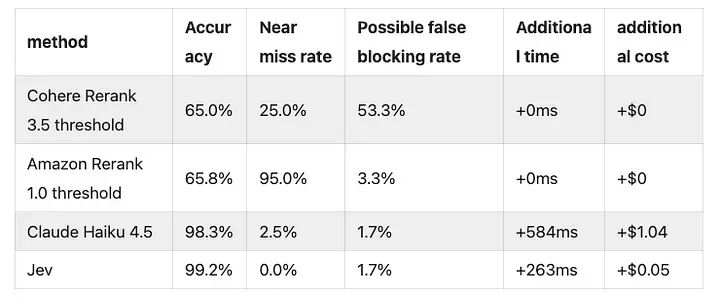
这一步看起来很小,但对于真正上线的 RAG 系统来说非常重要。因为「相关」与「能回答」,从来不是同一件事。
实测 3:一次请求全做完会怎样?
做到这里,我开始有点贪心了。既然 Jev 能够并行处理多个问题,那么为什么还要把 Reranking 和「能否回答」的判断拆成两个步骤?
能不能一个 Request 全做了?
于是,我针对每个 Chunk 同时加入两个问题。
第一个问题:这段 Chunk 和 Query 有多相关?
第二个问题:这段 Chunk 是否包含足以回答 Query 的证据?
于是,对于 20 个 Chunk,就会产生 40 个问题。但关键在于:
Request 仍然只有一次。
结构大概变成这样:
{
  "model": "jev-1.13.0",
  "state": {
    "query": "By when do I need to apply for the social insurance premium exemption while on childcare leave?",
    "items": [
      {
        "id": "item_0",
        "title": "Childcare and Family Care Leave Regulations",
        "text": "Social insurance premiums during childcare leave are exempted upon request by the employee. The Human Resources Department handles the procedure."
      }
// … up to item_19
    ]
  },
  "questions": {
    "rel_0": {
      "type": "score",
      "instructions": "How relevant is the text of item_0 to the query?",
      "criteria": [
        "0 - Irrelevant. It has nothing to do with the query.",
        "1 - Loosely related because it is in the same general area.",
        "2 - It concerns the same subject, but addresses a different matter.",
        "3 - It concerns the same subject and the same matter as the query."
      ]
    },
    "ans_0": {
      "type": "noul",
      "instructions": "Does the text of item_0 contain evidence that can answer the query?",
      "criteria": {
        "true": "The item's text directly states the rule, condition, value, procedure, or person responsible that answers the question.",
        "false": "The item's text discusses the same topic but does not state the rule, condition, value, procedure, or person responsible that the question asks for. Or it concerns a different topic."
      }
    }
// … up to item_19, with 2 questions per chunk (40 questions total)
  }
}
这样一来,我们可以利用 Score 完成相关性排序,再使用 Noul 过滤结果。如果最高相关 Chunk 的判断值仍然达不到 0.755,系统就直接认为:
当前资料不足以回答。
最有意思的是,虽然我们增加了 Yes/No 判断,但请求数量依旧没有增加。还是一次。
然后我比较了三套方案
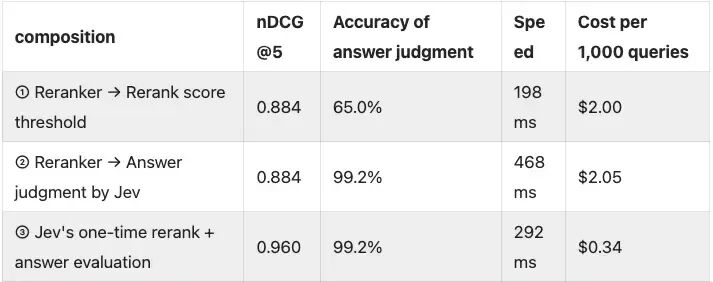
结果非常有意思。方案③的「能否回答」判断效果和方案②基本一致。但是,它的重新排序效果却比方案①和方案②都更好。
更夸张的是成本:
速度只需要方案②的约 60%。
价格则只有方案②的约 1/6。
而且还有一个很大的好处:
Reranker 调用彻底消失了。
原本 RAG Pipeline 里需要单独存在的一层服务,现在有机会直接被合并进一次 Jev 请求里。
所以,Jev 真能让 RAG 变便宜吗?
我的答案是:有可能,而且方向非常值得继续验证。
从这次实验来看,Jev 确实有机会同时改善 RAG 的速度和成本。但这里必须加一个限制条件:真正明显的速度提升,很可能主要出现在那些超出知识库范围、最终不需要调用 LLM 的问题上。
为什么?因为只要最后还是需要 Claude、GPT 这类生成模型回答,你最终依旧得等大模型生成。前面的 100ms、200ms 优化当然有价值,可真正耗时的大头可能仍然在最后。
不过,Jev 的价值并不只有「快」。还有另外一个我觉得更有想象空间的方向:
降低后续模型的规格。
例如,以前为了确保回答质量,我们可能需要:向量搜索 → Reranker → Sonnet。
但如果 Jev 能够提前把无关 Chunk 清理掉,只留下纯度非常高、真正指向答案的内容,那么最终负责生成答案的模型,未必还需要 Sonnet。也许 Haiku 就够了。这样一来,节省的就不只是一次 Reranker 调用,而是整个生成阶段的成本。
甚至还可以继续往前走一步:根据「答案判断」的 Confidence 动态选择模型。
例如:
- 高 Confidence → Haiku。
- 低 Confidence → Sonnet。
- 极低 Confidence → 直接拒绝回答或者扩大搜索范围。
这时候,Jev 就不只是一个便宜的分类器了。它更像一个站在 RAG Pipeline 中间的流量调度器:先判断问题,再筛选资料,接着决定当前任务究竟值得调用多贵的模型。
这可能才是我觉得 Jev 最有意思的地方。
过去我们构建 AI 应用时,很容易形成一种惯性:
什么事情都扔给 LLM。
分类找 LLM,排序找 LLM,判断找 LLM,生成答案还是找 LLM。大模型当然能做这些事情,但「能做」从来不等于「应该让它做」。
如果一个 70~500ms、成本低几十倍甚至上百倍的判断模型,就能把前面的工作处理掉,那么为什么一定要让一个昂贵的生成模型完成所有步骤?
所以,我现在越来越觉得:
下一阶段的 AI 应用,拼的可能不只是「谁用了最强模型」。
真正拉开成本和体验差距的,反而可能是:你有没有把最贵的模型,只留给那些真正需要它的任务。
Jev 做判断,向量数据库负责找资料,Haiku 处理简单答案,Sonnet 处理复杂问题。每一种模型只负责自己最擅长的环节。
如果这套思路最终能够跑通,那么 RAG 的下一轮优化,也许根本不是换一个更大的 LLM。而是反过来:
想办法少用 LLM。
 发表于 3 小时前
|
查看: 6|
回复: 0


