一个团队做了个智能客服 Agent。为了让它“记住”用户历史,他们把所有历史对话全部塞进每次请求的 context 里。
前 30 轮对话,效果很好。Agent 知道用户上次问过什么、买过什么、投诉过什么。
第 50 轮,开始报 context length exceeded。
他们加了上下文压缩,把旧对话做摘要。好了几天,第 80 轮又崩了——摘要也越来越长。
最后他们给 Agent 配了一台 128GB 内存的服务器,准备“把所有历史都放进去”。
结果:问题没解决,钱花了不少。因为瓶颈不是内存大小,是模型的上下文窗口——一个固定的、由模型架构决定的硬限制,不是加机器能解决的。
记忆 vs 文档:一个根本性的区别
Hacker News 上有篇高赞文章,标题就叫“Agents don't need memory, they need documentation”。作者的核心观点很朴素:
Agent 不需要“记忆”,需要的是“文档”。
这两个词看起来差不多,实际上是两种完全不同的数据结构:
| 维度 |
记忆(对话历史) |
文档(结构化知识) |
| 数据结构 |
线性日志(按时间排列) |
结构化文档(按主题/实体组织) |
| 增长方式 |
每轮对话线性增长,不可控 |
按需写入,增长可控 |
| 检索方式 |
从头读到尾 |
按关键词/语义检索 |
| 信息密度 |
低(包含“嗯”、“好的”等废话) |
高(只存关键事实) |
| 生命周期 |
会话结束即失效(除非主动保存) |
持久存在,跨会话可复用 |
一句话总结:记忆是线性增长的对话日志,会撑爆上下文窗口;文档是结构化的可检索知识库,按需查询。
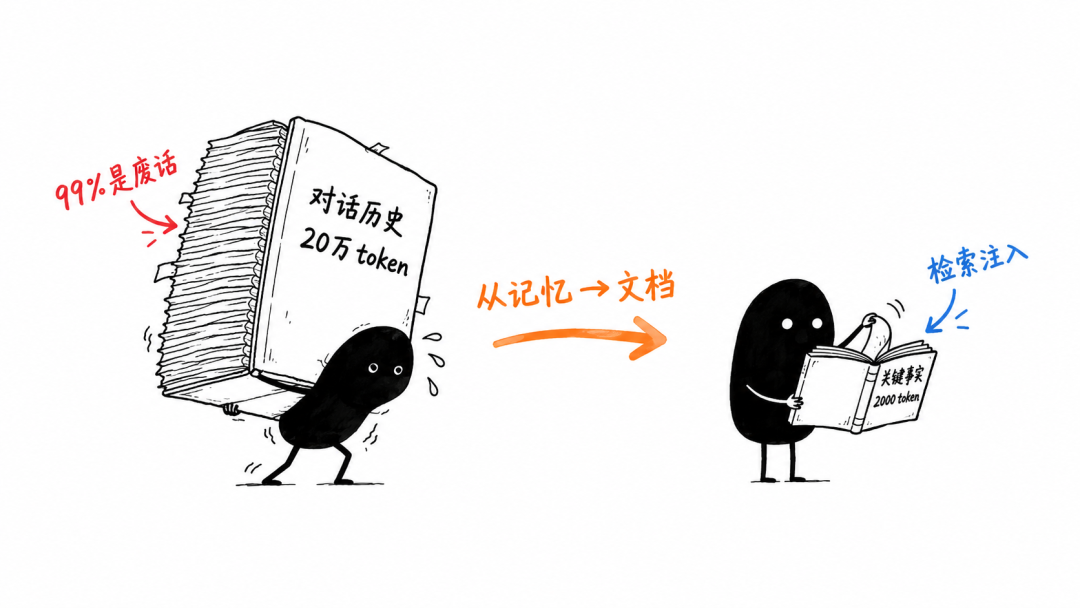
生活化比喻:日记本 vs 字典
想象你是个客服。每天处理 100 个客户电话。
用记忆的方式:你把每个客户说的每句话——包括“嗯”、“等一下”、“哦那好吧”——全都背下来。30 天后你脑子里塞了 3000 个客户的完整对话,脑子炸了,一个客户都服务不好。
用文档的方式:你准备一个笔记本,每个客户一页,上面只记关键信息:张三,VIP,上次买了 iPhone 18,投诉过屏幕问题,已解决。客户打电话进来,你翻到对应那一页,3 秒找到关键信息。
差别在哪?
- 记忆里 99% 的内容是废话(“嗯”、“好的”、“谢谢”),只有 1% 是关键事实
- 文档里 100% 都是关键事实,没有废话
- 记忆是线性排列的,找一个信息得从头读到尾
- 文档是结构化排列的,按客户名/ID 直接定位
Agent 的对话历史就是“日记本”。你把 200 轮对话塞进 context,里面 198 轮都是“好的,正在处理”、“已经完成了”这种废话,真正的关键信息——用户的偏好、历史决策、已完成任务——淹没在噪音里。
为什么“加内存”解决不了
很多人第一反应是“上下文窗口太小了,等模型窗口变大就好了”。
这是个误解。上下文窗口(context window)是模型架构决定的,从 GPT-3 的 2K token 到 GPT-4 的 128K token 再到现在的 1M token,确实在变大。但问题不在“能不能装下”,而在装下之后能不能用好。
有个很经典的实验现象叫“Lost in the Middle”:模型对放在上下文开头和结尾的信息记得最准,放在中间的信息遗忘率最高。200 轮对话塞进 context,关键信息大概率在中间——被遗忘了。
更关键的是信息密度问题。200 轮对话可能有 20 万 token,但其中真正有用的关键事实可能只有 2000 token。你用 20 万 token 的 context 去传递 2000 token 的信息,99% 的 token 都在浪费——而每多一个 token 就多一份推理延迟和成本。
所以“加内存”永远解决不了这个问题。不管你的 context window 有多大,把对话历史全塞进去都是低效的。
正确的做法:记忆 → 文档 → 检索注入
核心思路三步:
第一步:从对话中提取关键事实(写文档)
不要存原始对话,存提炼后的关键信息。每轮对话结束后,用 一个轻量模型提取“这一轮有什么值得记住的” :
# 对话结束后,提取关键事实
facts = llm_extract(
    """
    从以下对话中提取关键事实,只保留:用户偏好、已做决策、未完成任务。
    对话历史:{conversation}
    输出格式:JSON
    """,
    model="gpt-4o-mini"   # 用小模型,省钱
)

# 结果示例:
# {"preference": "用户偏好 Python", "decisions": ["选择了 PostgreSQL"], "pending": ["还没配置缓存"]}
第二步:存入向量数据库(建文档库)
# 把每条事实做 Embedding 后写入向量库
for fact in facts:
    embedding = embed_model.encode(fact)
    vector_db.upsert(
        id=fact_id,
        embedding=embedding,
        metadata={"user_id": user_id, "timestamp": now, "text": fact}
    )
第三步:下次对话时,按需检索注入(查字典)
# 新对话开始时,用当前问题检索相关历史
query_embedding = embed_model.encode(user_message)
relevant_facts = vector_db.search(query_embedding, top_k=5, filter={"user_id": user_id})

# 只把检索到的 5 条关键事实注入 context,不是全部历史
context = f"已知用户信息:{relevant_facts}"
response = llm(f"{context}\n用户问:{user_message}")
对比一下两种方案的开销:
| 方案 |
每次请求的 token 量 |
延迟 |
月成本(1000 活跃用户) |
| 全历史塞 context |
20 万 token |
高 |
$2000+ |
| 检索注入 5 条事实 |
约 500 token |
低(多一次向量检索) |
$200 |
10 倍的成本差距,效果还更好——因为模型看到的是高密度关键信息,不是淹没在废话里的低密度日志。
等等,这不就是 RAG 吗
是的。RAG(Retrieval-Augmented Generation) 本质上就是“文档系统”——从外部知识库中检索相关信息,注入到模型上下文里。
很多人把 RAG 理解成“给模型外挂一个知识库让它回答问题”,这只是 RAG 的一种用法。更本质的理解是:
RAG = 把“记忆”转化为“文档”,再用检索代替全量加载。
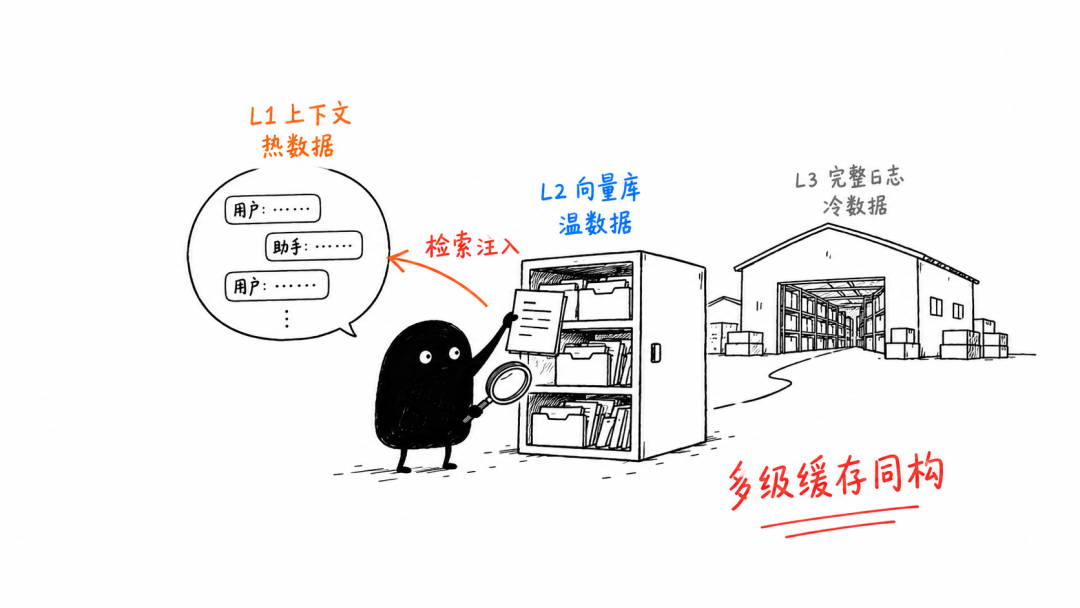
这个思路和我们讲过的多级缓存完全同构:
| 多级缓存 |
Agent 记忆系统 |
| L1 缓存(CPU 内) |
当前 context 里的对话(热数据,最近几轮) |
| L2 缓存(内存) |
向量数据库里的关键事实(温数据,结构化存储) |
| L3 缓存(磁盘) |
完整对话日志(冷数据,只在需要时回溯) |
| 缓存命中率 |
检索命中率——检不中就退化成“没记忆” |
| 缓存击穿 |
大量用户同时查同一个不存在的 key——向量检索返回空 |
缓存击穿在 Agent 场景的变体:新用户第一次对话,向量库里没有任何历史事实,检索结果为空,Agent “没记忆”。解法和缓存击穿一样——用空结果占位(返回“该用户暂无历史记录”),避免下游(LLM)被空查询穿透。
Embedding 编码延迟:一个容易被忽略的坑
51CTO 上一篇技术文章提到一个真实数据:
“单个客户打进来时,检索只在他的记忆里比——大概 50 次比较,很快,但那次把问题转成向量的调用本身就要几十到上百毫秒,在延迟预算低于 300 毫秒的语音场景里,这是一笔不小的开销。”
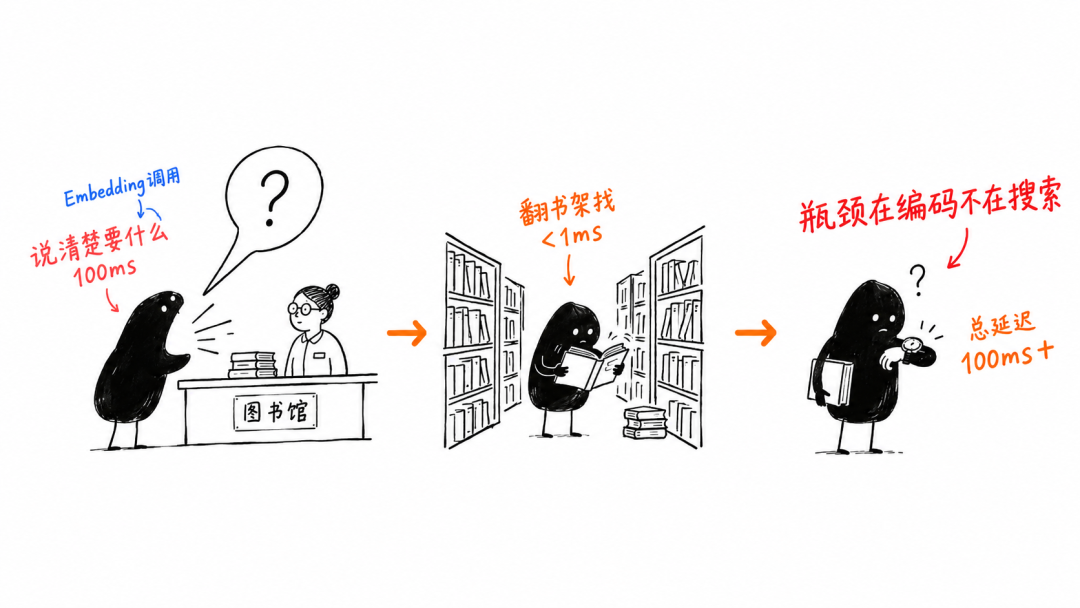
这段话揭示了一个反直觉的事实:RAG 系统的延迟瓶颈不在“搜索”而在“编码”。
向量比较(余弦相似度计算)是极快的,50 次比较 <1ms。但把用户的自然语言问题转成向量(Embedding)需要调用模型,一次调用几十到上百毫秒。
就好比你去图书馆找一本书。在书架上翻找只要 2 秒,但你得先跟图书管理员说清楚“我要什么书”——说清楚这个过程要 100 秒。你以为是“找书慢”,实际上是“说清楚要什么”慢。
解法:
- 缓存高频问题的 Embedding——常见问题(“怎么退款”、“怎么改地址”)的向量缓存起来,不用每次都编码
- 异步预编码——用户打字时就异步开始编码,不等用户点发送
- 用更快的 Embedding 模型——text-embedding-3-small 比 large 快 5 倍,质量差不了多少
面试速记卡
Q:为什么不能把所有对话历史直接塞进 context?
A:三个原因。第一,token 线性增长,成本不可控;第二,模型存在“Lost in the Middle”现象,中间信息遗忘率高;第三,信息密度低,20 万 token 里可能只有 2000 token 是关键事实,99% 在浪费。
Q:Agent 的“记忆”和“文档”有什么区别?
A:记忆是线性增长的对话日志,按时间排列,从头读到尾检索;文档是结构化的关键事实,按主题/实体组织,按语义检索。记忆的信息密度低(包含大量废话),文档的信息密度高(只存关键事实)。
Q:RAG 和多级缓存是什么关系?
A:本质同构。RAG 的 context = L1 缓存(热数据),向量数据库 = L2 缓存(温数据),完整对话日志 = L3 缓存(冷数据)。缓存击穿在 RAG 场景的变体是“新用户无历史记录,检索返回空”。
Q:RAG 系统的延迟瓶颈在哪?
A:不在向量搜索,在 Embedding 编码。向量比较 <1ms,但把自然语言转成向量的 Embedding 调用要几十到上百毫秒。解法是缓存高频问题的 Embedding + 异步预编码 + 用更快的 Embedding 模型。
Q:给 Agent 加 128GB 内存能解决记忆问题吗?
A:不能。瓶颈不是内存大小,是模型的上下文窗口——一个由模型架构决定的硬限制。而且就算窗口无限大,信息密度问题依然存在:全量加载对话历史 vs 检索注入关键事实,成本差 10 倍。
这篇在知识体系里的位置
属于「高并发」分类,是「多级缓存」和「缓存击穿」的延伸。同时也关联「架构」分类的 CQRS——把“写”(对话历史写入向量库)和“读”(检索注入 context)分离,就是 CQRS 在 Agent 场景的应用。
新增知识点:记忆 vs 文档的数据结构差异、RAG 作为 Agent 记忆系统、Embedding 编码延迟瓶颈、Lost in the Middle 现象。
数据来源
 发表于 2 小时前
|
查看: 3|
回复: 0


