上篇 RAGAS评测,context_recall 0.350 垫底,瓶颈在召回。RAG项目有 445 个 chunk,dense 检索跨章内容天然吃亏,例如问听证程序启动条件,召回来的多是按日连续处罚这类沾边但不中的条文。这次在召回层做了三处改动:扩池、加 BM25、Cross-Encoder 精排。
一、先把问题看清楚:context_recall 0.350 到底丢在哪
复盘上一篇文章的 23 题测试集,得分最低的 5 道题呈现出一个共同特征。
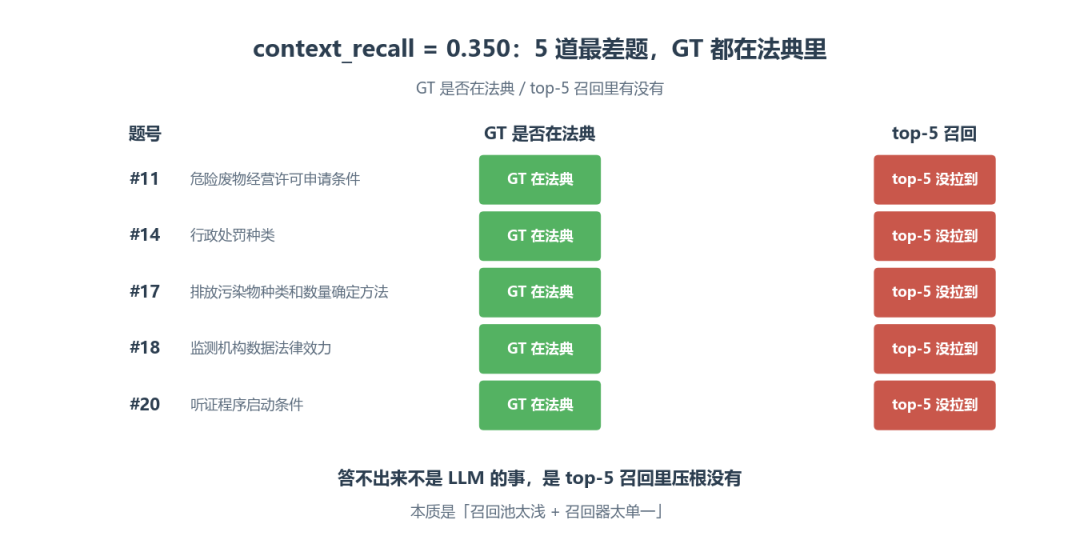
5 道最差题:初看是召回不够,发现 4 道根本不在法典里
拿 #11 危险废物经营许可申请条件来说,GT(标准答案)列出了 4 项条件,法典里没有明文规定,系统只能答"建议查阅国务院制定的管理办法",这属于典型的语料覆盖缺失。
其余四道问题的情况类似。#14 行政处罚种类和 #20 听证程序启动条件的 GT 信息都来自《行政处罚法》,法典没有单独收录。#17 排放污染物种类和数量的确定方法出自排污许可证管理办法,法典只涉及许可证制度层面。#18 监测数据法律效力依据的是监测规范,法典也没具体规定。
仔细划分 5 道题的情形,里面至少 #20 和 #14 的 GT 信息在《生态环境法典》其他章节是有相关条文的,只是跨章分布,top-5 按 dense 相似度排序时天然吃亏。问题出在两条线上:top_k=5 召回池太浅,加上全程只走 dense 单一召回路径,跨章节的相关条文自然容易被埋没。
二、思路:把检索拆成三层
上节的两条归因对应着三个独立的维度。召回池只有 top-5,那就扩到 top-50。召回来源只有 dense,那就加上 BM25 词法检索。50 条拿回来不能全喂给 LLM,那就加一个 Cross-Encoder 把最相关的几条提到最前面。
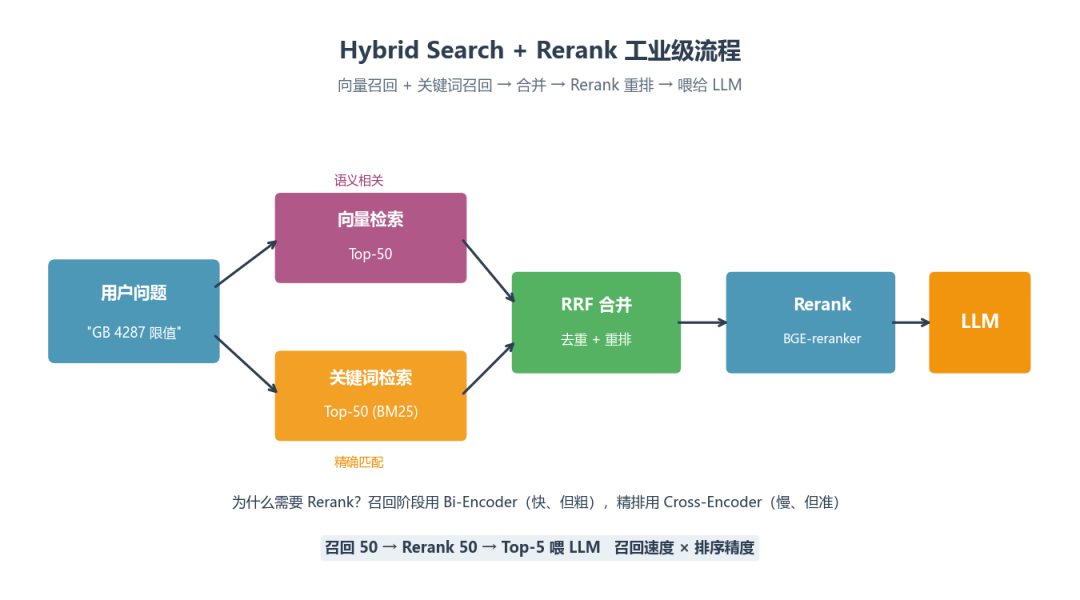
Hybrid+Rerank 工业级流程:query → dense top-50 + BM25 top-50 → RRF 合并 → Cross-Encoder 精排 → top-5 喂 LLM
这条流程里 dense 没有被替换,而是在它的基础上补了词法召回和精排两道工序。
三、Hybrid Search(dense + BM25 + RRF)
Hybrid Search(混合检索)是把向量检索和词法检索的结果合并起来,让语义匹配和精确匹配两种方式互相补位。先看召回来源这一层,把 dense 向量和 BM25 词法两条路并联,再用 RRF 把结果合并,这是改动量最小但见效最直接的一步。
3.1 为什么需要 BM25
向量检索擅长匹配语义,但法规里有很多场景需要精确的字符匹配,比如法条编号、标准号、专有术语。这些字面信号 dense 模型在通用语料上训练后召回效果并不稳定。拿 GB 4287(纺织染整工业水污染物排放标准)或听证这类词来说,BGE 官方文档也建议在精确匹配场景下配合 BM25 使用。
BM25(Okapi Best Matching 25)的公式:
score(D, Q) = Σ IDF(qi) · f(qi,D)·(k1+1) / (f(qi,D) + k1·(1-b+b·|D|/avgdl))
f(qi, D) 是 qi 在 D 里出现的频次,|D| 是文档长度,avgdl 是平均文档长度。常用起点 k1=1.5、b=0.75。IDF(逆文档频率)让罕见词权重高,常用词权重低。中文要先 jieba 分词,否则听证程序的启动条件会被切成 9 个字,BM25 词项权重就退化成字符匹配。
3.2 RRF 合并
把 dense 和 BM25 各自的 top-50 合在一起,最直接是线性加权:score = α · norm(BM25) + (1-α) · norm(dense)。但两路分数要归一化到同一量纲,而 BM25 的 IDF 项和向量余弦的 [0,1] 区间不在一个尺度上。
Reciprocal Rank Fusion(RRF)只依赖排名、不依赖分数:
RRF(d) = Σ 1 / (k + rank(d))
k=60 是常用值。每个文档在两路检索结果里按排名换算成分数再求和,同一段内容如果在两路都出现了,得分相加后前置;只在单路出现就单独算。整个过程不需要分数归一化,也不需要调 α 权重。
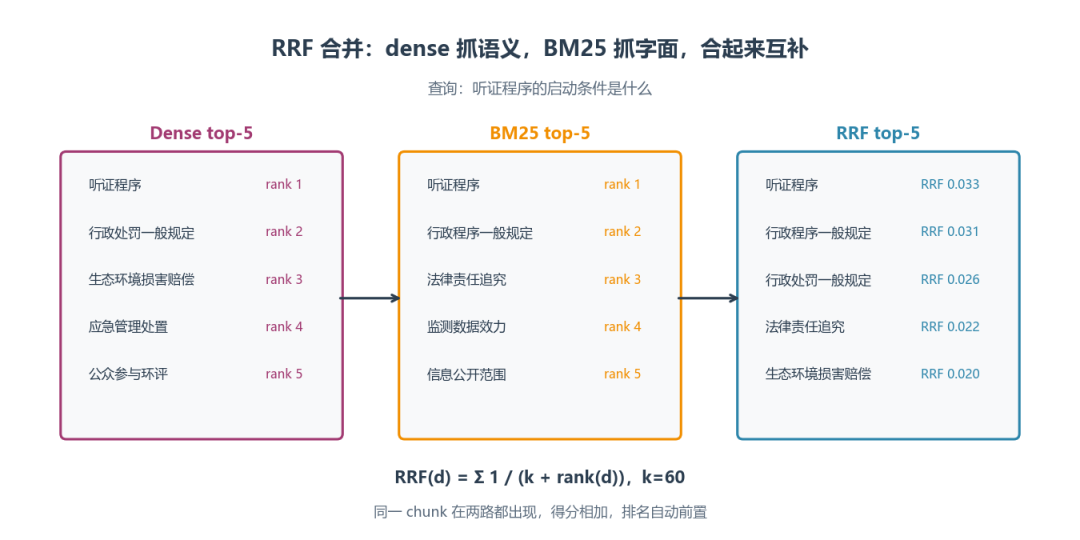
dense 抓到听证程序,BM25 也抓到听证程序,RRF 把它们合起来并前置
langchain_community.retrievers.EnsembleRetriever 已封装 RRF,但 0.4+ 的 pydantic 校验对自定义 retriever 较严,写了 30 行代码绕开:
@staticmethod
def _rrf_fuse(dense_results, bm25_results, k=60, top_n=50):
    scores, items = {}, {}
    for rank, item in enumerate(dense_results, start=1):
        key = hash(item["content"])
        scores[key] = scores.get(key, 0.0) + 1.0 / (k + rank)
        items[key] = item
    for rank, item in enumerate(bm25_results, start=1):
        key = hash(item["content"])
        scores[key] = scores.get(key, 0.0) + 1.0 / (k + rank)
        if key not in items:
            items[key] = item
    ranked = sorted(scores, key=lambda x: -scores[x])[:top_n]
    return [items[k] for k in ranked]
BM25 索引离线构建一次,存为 pickle:
import jieba, pickle
from langchain_community.retrievers import BM25Retriever
from src.data.processor import VectorStore

def chinese_preprocess(text):
    return [t for t in jieba.cut(text) if t.strip()]

vs = VectorStore()
all_docs = vs.collection.get(include=["documents"])["documents"]

bm25 = BM25Retriever.from_documents(all_docs, preprocess_func=chinese_preprocess)
bm25.k = 50
with open("data/bm25_index.pkl", "wb") as f:
    pickle.dump(bm25, f)
这段代码跑完后,BM25 索引就以 pickle 形式存在磁盘上了。445 个 chunk 的索引约 1MB,jieba 加载耗时 0.7 秒,BM25 单次查询大约 50ms。索引离线建一次后,热路径上的额外开销很小。
四、Rerank(Cross-Encoder)
Rerank(重排序)是用一个更精确的模型对召回结果重新打分排序,把最相关的文档提到最前面。双路召回解决了召回来源的问题,但 50 条候选直接喂给 LLM,效果和成本都不划算。接下来加一道精排工序,从大量候选中精确命中那几条真正相关的。
4.1 Bi-Encoder vs Cross-Encoder
Bi-Encoder(dense 用的那种)离线算 embedding、检索时只用点积,速度快但 query 和 doc 没有交互。两个向量独立编码,query 和 doc 的字面对应关系模型看不到。
Cross-Encoder 把 (query, doc) 拼在一起送进 transformer:
[CLS] q [SEP] d [SEP]
自注意力让 query 和 doc 的 token 交互,输出一个相关度分数。更准,但每次都要重算一遍,不能离线缓存。
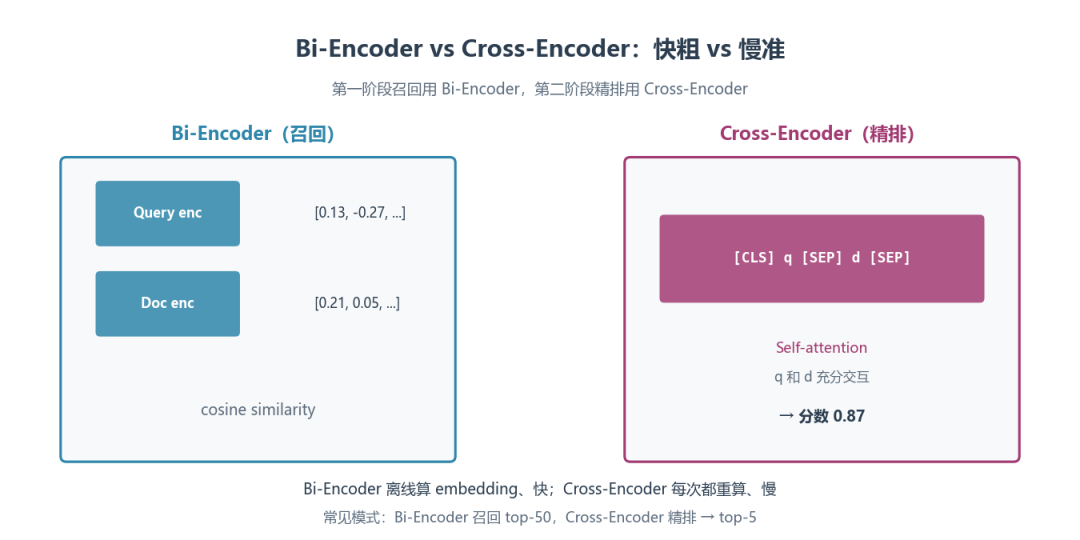
左侧 Bi-Encoder 流程:query 和 doc 独立编码;右侧 Cross-Encoder:query 和 doc 一起编码
把 Cross-Encoder 当主检索来用是反模式。5 万条规模还行,到了 50 万条就完全撑不住。正确的做法是两段式:先用 Bi-Encoder 从全库召回 top-50,再让 Cross-Encoder 在 50 条候选里精排出 top-5。取舍很清楚:追求 precision,Bi-Encoder 就够了;要 recall 拉起来,才值得上 Rerank 的代价。
4.2 Reranker 选型
BGE 系列里选了 bge-reranker-v2-m3(0.6B),它在中文场景是个不错的平衡点。准确率高于 bge-reranker-base(278M),推理速度又比 bge-reranker-large(560M)和 v2-gemma(2B)都快。CPU 上推理一对约 200ms。
rerank top-50 出 top-5 是常用配置,候选条数再多的话,TTFT(首 token 时间)会显著上升。公开 benchmark(BEIR)上 rerank 一般能提升 +5~15 个点的 nDCG@10,不过具体到这套法典语料上还得实测。
几行代码就能跑通:
from sentence_transformers import CrossEncoder

ce = CrossEncoder("BAAI/bge-reranker-v2-m3", max_length=512)

def rerank(query, candidates, top_k=5):
    pairs = [(query, c["content"]) for c in candidates]
    scores = ce.predict(pairs)
    ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
    return [c for c, _ in ranked[:top_k]]
注意:Cross-Encoder 的输入是 (query, doc) 字符串对,不要再加 BGE 的 query 前缀。前缀是给 Bi-Encoder 用的,Cross-Encoder 已看到 query 全文。
五、HNSW 调优(不到百万级不用动)
召回和排序都调完了,还有一个跟向量库底层相关的参数值得了解:HNSW(Hierarchical Navigable Small World)。
这一节面向将来数据量增长后的场景,445 个 chunk 的阶段不需要动。
HNSW 是当前最主流的 ANN 索引结构,ChromaDB 默认就在用。理解它的工作方式,方便数据大了之后做参数决策。打个比方,HNSW 像城市高架路网:顶层是稀疏的主干道,负责粗定位;底层是密集的支路,负责精找邻居。
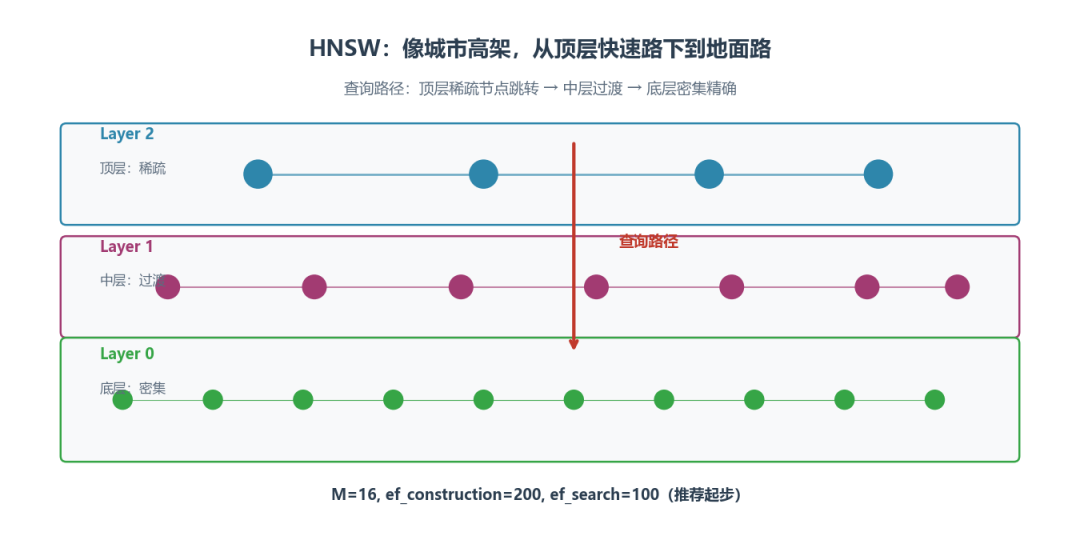
HNSW 像城市高架:顶层稀疏粗定位 → 中层过渡 → 底层密集精找
三个关键参数:
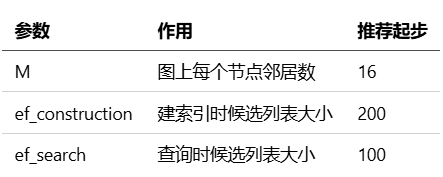
调优顺序反过来最高效:先调 ef_search,它最便宜、修改立即生效;再考虑调整 M,但这需要重建索引;最后才动 ef_construction,它最贵、重建最慢。
ChromaDB 0.5.5 通过 collection.modify(metadata={"hnsw:M": 16, "hnsw:ef_construction": 200, "hnsw:ef_search": 100}) 可改部分参数(部分可能忽略,看版本)。判断标准明确:数据量 ≥ 1M 或 P95 latency > 100ms 才动,否则属于过度优化。
六、复测:context_recall 从 0.35 提到多少?
复测沿用同一套 23 题、同一个 DeepSeek 当 judge,跑三轮对比:
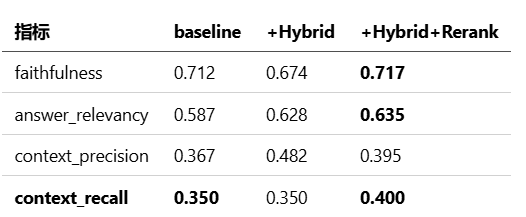
context_recall 从 0.350 提到 0.400,没达到最初预期的 0.65~0.75,5 道最差题里 4 道的 GT 根本不在法典语料里(来自《行政处罚法》等),Hybrid 和 Rerank 召不回库里没有的内容。排除这 5 道超纲题,剩下 18 道 in-scope 题的改善更明显:precision 从 0.367 涨到 0.482,faithfulness 从 0.712 提到 0.717,recall 升到 0.400。
值得注意的还有 precision 回落,Hybrid 阶段涨到 0.482,加 Rerank 后回到 0.395。BM25 命中了字面相关 chunk,Cross-Encoder 给了高分推入 top-5。不过 recall 那 +0.05 正是在 Rerank 阶段实现的,取舍很清楚:要 precision 停在 Hybrid,要 recall 得上 Rerank。
七、优化建议
回到这篇最开头的问题:context_recall 从 0.350 提到 0.400,刚才那些改动哪步值得做?
如果做一个相似的 RAG 系统,建议的顺序是这样。第一步永远是先检查语料覆盖度。这次有四道题根本不是检索算法能解决的,把 BM25、Rerank、HNSW 全部拉满,库里没有的内容就是召不回。花五分钟看最差的那几道题是不是超纲,比调任何参数都值。
确认语料没问题之后,加 BM25 是最划算的投入。 几行代码、50ms 查询、不需要下载模型,context_precision 就能从 0.367 涨到 0.482。无论数据量大小,这一步都值得先做。
要不要上 Rerank,取决于你要 precision 还是 recall。 Rerank 要 1.2GB 模型、200ms 推理,在这个测试集上把 recall 从 0.350 推到了 0.400,但 precision 反而从 0.482 回落到 0.395。如果你更在意召回率,值;如果你更在意检索精度,Hybrid 就够了。至于 HNSW 调优,数据量不到百万级不用动。
下一步最该补的还是语料,换 embedding 和调 chunk 策略性价比多少,等实测再写。
 发表于 1 小时前
|
查看: 6|
回复: 0


