过去两年,企业做大模型几乎是同一条路线:把 SharePoint、Google Drive、内部 Wiki、合同、邮件切成 Chunk,做 Embedding,塞进向量库;员工提问后先检索片段,再交给模型生成答案。这就是 RAG。
9 月 21 日,OpenAI 公布企业 AI 公司 V7 的案例。这一次,RAG 的位置变了。
主要内容包括以下几个部分:
- 从“每次搜一遍”,到“先把企业读懂一遍”
- HERB 暴露的,不是模型不够强,而是“没搜全”
- 长上下文也没真正解决这个问题
- Agent 跑到 50—100 步之后,Context 错误会被一路放大
- RAG 不会消失,但“企业知识库=向量库”可能真的要结束了
V7 没有让 Agent 每接到一个任务,就从成千上万份文档里重新搜一遍。它先把 SharePoint、Google Drive 等资料持续抽取成一张 Context Graph:公司、基金、人、文件等实体,实体之间的关系,业务事实、指标,以及这些事实对应的原始证据,都提前整理进去。Agent 工作时优先查这张 Graph;只有图里信息不足,才回到底层文档继续做 RAG。
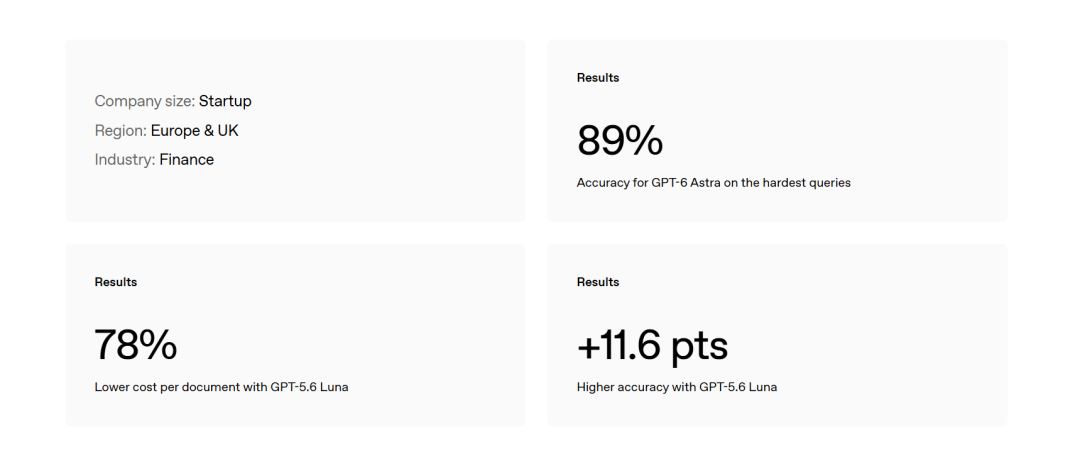
图1|V7 案例页给出的结果:GPT-6 Astra 在最难问题上的准确率 89%,GPT-5.6 Luna 让单份文档成本降低 78%、准确率再提升 11.6 个百分点(来源:OpenAI V7 客户案例)
OpenAI 对这套架构的描述很直接:以前 Agent 每次请求都要重新发现 Context,现在 Context 先被组织成一份可持续查询的企业记录。
严格说,这不是 OpenAI 宣布“RAG 已死”,也不是 OpenAI 产品架构全面转向 Context Graph。9 月 21 日发布的是一篇 V7 客户案例,而且其中大量结果来自 V7 自测。但这个案例透露出的架构变化很明确:至少在 V7 这类复杂企业 Agent 里,RAG 已经不再是第一入口,而是被放到 Context Graph 之后,负责补足图里没有的信息。
需要说明的是,文中的 HERB 提升、1000 文档测试和 99.9% 准确率均来自 V7 自测或 OpenAI 客户案例,主要用于观察架构变化,不应视作独立 Benchmark 结论。
01 从“每次搜一遍”,到“先把企业读懂一遍”
传统 RAG 最大的问题,不一定是模型不会回答,而是每次提问之前,它都要重新寻找问题需要的证据。
假设一家投资机构有十几年历史资料。某家公司在三年前的 Deal Memo 里出现过一次,在去年某份基金报告里换了简称,在 CRM 中又用了另一个名字,最近一次讨论则藏在 SharePoint 的会议纪要里。现在问 Agent:“我们以前看过这家公司吗?当时为什么放弃?最近哪些指标发生了变化?”
向量检索面对的是文本片段。它要先猜哪些 Chunk 和问题相似,再希望这些 Chunk 恰好覆盖完成答案所需的全部证据。问题一旦跨文档、跨系统、跨时间,Agent 就容易进入不断搜索、打开文档、换关键词、再次搜索的循环。
V7 真正改的,不只是检索算法,而是“什么时候构建 Context”。传统 RAG 是在问题来了以后临时找 Context,V7 则把这件事前移到数据进入系统的时候。文件进入后,GPT-5.6 Luna 被用来从大量文件中抽取实体、关系和证据,再放入 Context Graph。OpenAI 举的对象包括 company、fund、people 等,Graph 中同时保存事实、属性、指标以及回到原始文件的引用。新文件到达时,不只是“再增加几个 Chunk”,而是判断它属于哪个已有实体、更新了什么事实、和已有记录有什么关系。
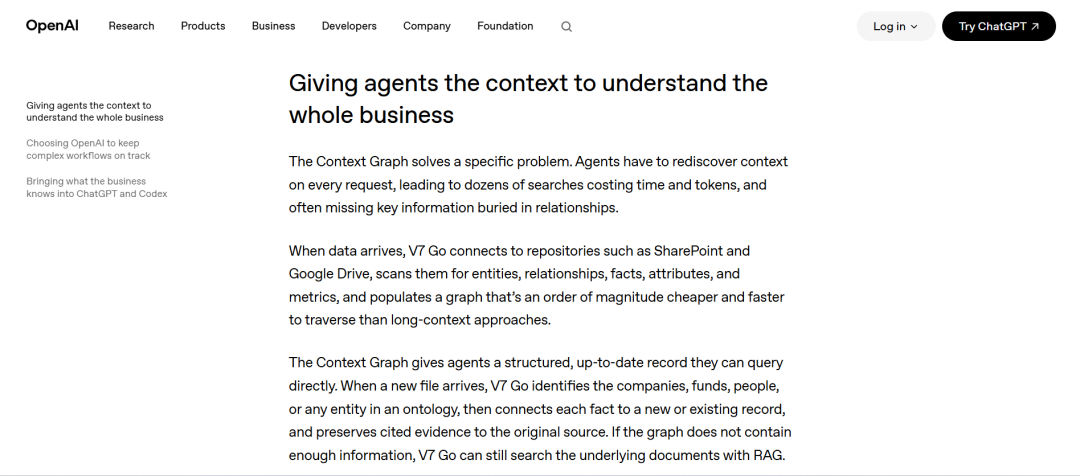
图2|OpenAI 案例页对 Context Graph 的说明:数据到达时抽取实体、关系、事实与指标,Agent 直接查询这张图,信息不足再回到文档做 RAG
V7 披露的设计更具体。Context Graph 并不是把所有识别出的名词随便连成图,而是先定义 Ontology:企业真正关心哪些对象、对象之间允许存在哪些关系、哪些 Metric 需要长期跟踪。
以私募场景为例,可以提前定义 Fund、Manager、Portfolio Company、Security、Commitment、Person 等对象,以及 Fund 持有哪些公司、由哪个 GP 管理、某 Entity 有多少 Commitment 等关系。NAV、EBITDA、Headcount 也不再只是 PDF 里的一串数字,而可以成为挂在同一个实体上的历史字段。
这里有一个关键区别:传统 RAG 把企业知识主要看成“文档”;Context Graph 开始把它看成“对象、关系、状态和证据”。
SharePoint / Google Drive / 文件 → 实体与事实抽取 → Entity Resolution → Ontology / Context Graph → Agent 查询 Graph → 信息不足时再 RAG 原始文档 → 模型推理与执行。
RAG 没有消失,只是不再承担所有 Context 构建工作。
图3|V7 联合创始人兼 CTO Simon Edwardsson 谈上下文的价值
02 HERB 暴露的,不是模型不够强,而是“没搜全”
OpenAI 在这篇案例中给了一组数据:V7 称,其 retrieval-only 系统在 HERB 上比官方 baseline 高 69%,对不可回答问题的幻觉减少 38%。
这组数字不能直接理解为“Context Graph 比所有 RAG 高 69%”。OpenAI 没有公布 V7 这次运行的完整配置、绝对分数和可复现实验记录,69% 也是 V7 自报结果。但 HERB 本身很值得深挖,因为它刚好说明企业 RAG 为什么越来越难。
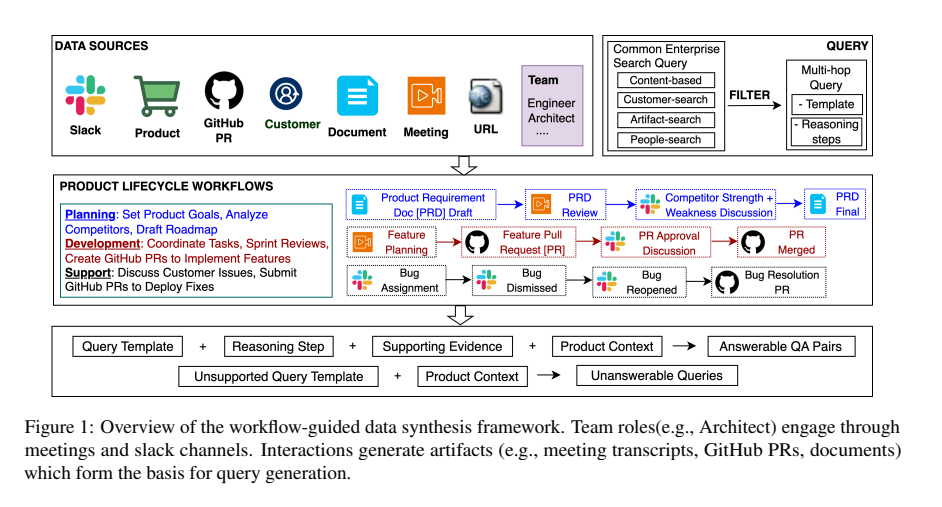
图4|HERB 论文中的工作流引导数据合成框架:由团队角色交互生成会议记录、GitHub PR、文档等 Artifact,再据此生成可回答与不可回答问题(来源:HERB 论文 Figure 1)
HERB 全称 Heterogeneous Enterprise RAG Benchmark,由 Salesforce AI Research 发布,并进入 EMNLP 2025 Industry Track。它不是简单放几十篇文章让模型找答案,而是模拟了一家 530 人、30 个产品的企业,生成 39,190 个企业 Artifact,数据横跨文档、Slack、会议记录、GitHub、URL 等结构化和非结构化来源。其中包括 815 个有答案的问题和 699 个故意缺少证据、理论上应该回答“不知道”的问题。
比如一道题可能是:找出某个产品 PRD 的作者和所有 Review 人,然后返回他们的 Employee ID。
答案不在一段文字里。系统首先要找到 PRD;再从 Slack 和会议记录中判断到底哪些人提供过 Review;最后还要到结构化员工数据里把人名映射到 Employee ID。另一些问题则要求找出没有被实现的 Feature,或者统计哪个客户还有最多未解决 Bug。
HERB 的结果也很难看。
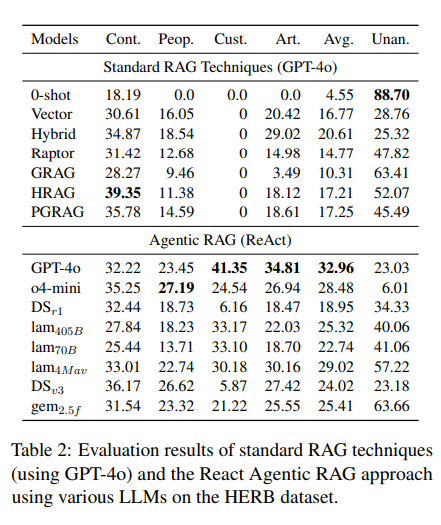
图5|HERB 论文 Table 2:标准 RAG 方法与 Agentic RAG(ReAct)在各类问题上的平均分,最佳为 32.96(来源:HERB 论文 Table 2)
标准 Hybrid Retrieval,也就是 Dense Vector 加 BM25,平均只有 20.61;加入 Planning、工具调用和多步搜索之后,GPT-4o 驱动的 ReAct Agent 提升到 32.96,已经是论文测试中的最佳结果之一,但依然很低。研究者最后给出的判断是:检索本身就是主要瓶颈。系统经常找不到完成推理需要的全部证据,于是模型只能在不完整 Context 上继续推理。
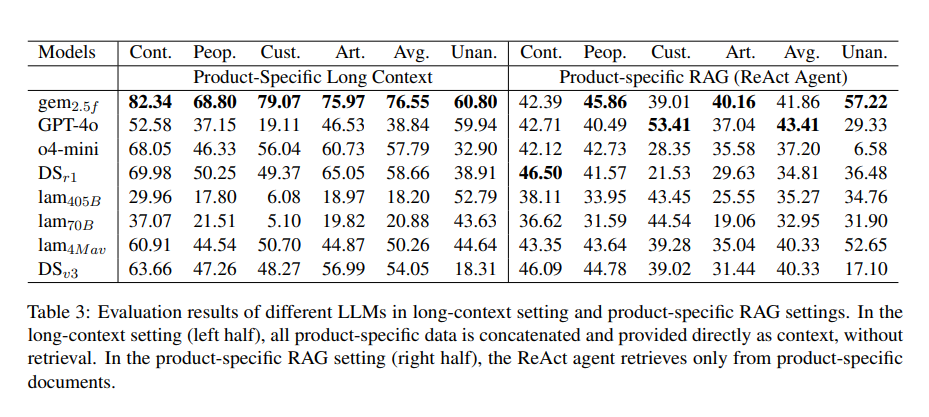
图6|HERB 论文 Table 3:长上下文设置与产品级 RAG 设置对比,长上下文下 Gemini 2.5 Flash 达到 76.55(来源:HERB 论文 Table 3)
更有意思的是,GraphRAG 也没有自动解决问题。
在 HERB 的标准测试里,Microsoft GraphRAG 对应的 GRAG 平均分只有 10.31,RAPTOR 14.77,HippoRAG 2 为 17.21;简单 Hybrid Retrieval 反而是 20.61。
所以,这不是“GraphRAG 终于打赢了 RAG”。真正的变化是,Graph 不再只是用来增强检索,而开始被放到检索之前,承担企业的 State / Memory Layer。
HERB 里的 GraphRAG,依旧主要是在解决怎样更好地检索;V7 要做的则更靠前:提前确定企业对象模型,在数据写入阶段完成 Entity Resolution,把事实、关系、Metric 和 Provenance 持久化。等 Agent 开始工作时,它查询的已经不只是“哪些文字可能相关”,而是“这个实体是谁、和谁有关、过去发生了什么、这个数字来自哪份文件”。
03 长上下文也没真正解决这个问题
另一个自然的问题是:模型 Context Window 越来越长,为什么不直接把文件全塞进去?
HERB 恰好也做了这个实验。
当研究人员不做检索,而是直接把与某个 Product 有关的完整 Artifact 放进模型 Context 时,Gemini 2.5 Flash 得分可以达到 76.55;相比之下,完整语料库上的 Agentic RAG 只有 32.96。
这里需要补一个限定:HERB 的长上下文设置并不是把全部 39,190 个 Artifact 都塞进去,而是提供某一个 Product 对应的完整 Artifact 集合,论文把它作为次要评估设置。但即便如此,这个对比仍说明问题很大程度出在检索:证据一旦完整地出现在 Context 里,模型的表现会明显提高。
但企业很难把所有信息永远塞进 Prompt。
一家公司的知识不是几十份 PDF,而可能是十几年邮件、文档、CRM、数据仓库、项目记录和会议内容。它还在每天增长,而且不同 Agent 只需要其中很小一部分。
V7 因此采取的是另一条路线:最近对话保留在模型 Active Context,较旧的信息进入 Graph,需要时再查询。OpenAI 称,V7 认为这种 Graph Traversal 相比直接依赖 Long Context 可以做到数量级上的成本和速度优势;这个“数量级”目前仍属于 V7 的产品侧说法,官方案例没有披露完整独立测试。
V7 8 月自己还做过另一组 1,000 文档测试。它报告,在固定 40 个私募领域问题上,纯向量检索在 1,000 份文档时准确率为 72.1%,Context Graph 为 93.8%,Graph 加 RAG 为 97.1%;在需要跨多个文档进行集合、过滤和比较的最难一档问题上,分别是 36.3%、91.7% 和 95.8%。
这组实验同样来自 V7 自测,而且使用了合成文档,Ontology 与测试问题也存在共同设计,因此不能当作通用 Benchmark。它更适合说明一种架构分工:Graph 负责已经结构化进企业对象模型的问题,RAG 则继续处理 Ontology 之外、无法提前枚举的开放信息。
所以最合理的形态可能不是 Graph 替代 RAG,而是:
Graph first,RAG second。
04 Agent 跑到 50—100 步之后,Context 错误会被一路放大
为什么这件事恰好在 Agent 时代开始重要,还有另一个原因:任务正在变长。
OpenAI 披露,V7 Go 的一部分 Agent 工作流已经可以连续执行 50—100 步,并称可以在数分钟内完成,准确率达到 99.9%。这依然是 V7 自报结果,OpenAI 页面没有解释 99.9% 的具体 Metric、样本数量和统计范围,因此更适合看作客户案例数据,而不是独立 Benchmark。
但长任务带来的工程问题是真实的。
两步问答里,Context 错一次可能只是一次错误回答;但进入几十步甚至上百步的 Agent 流程后,一个早期错误会变成后续步骤共同依赖的错误前提。OpenAI 在案例中也提到,长流程里一个上游错误会带来高昂后果。
一个 80 步 Agent 里,第 6 步把客户认错、第 12 步引用了过期指标,后面的判断、工具调用、报表甚至系统写入都可能建立在这个错误之上。
这也是为什么 OpenAI 案例里还有另一组值得关注的数据:V7 称,在自己的 Context Graph Benchmark 上,GPT-5.6 Sol 的 Tool Call Error Rate 从 GPT-5.5 的 2.7% 降到了 0.2%;新版 Harness 中,一些包含多次外部调用的 Workflow 最多快了 50%。
模型变强当然重要。但一个 100 步 Agent 要稳定执行,系统不能每一步都重新猜“企业里这家公司到底是谁”“哪个数字才是最新的”“上一季度的结论存在哪里”。
Context 必须从临时检索结果,升级成一种可以持续维护的基础设施。
OpenAI 自己在 9 月 10 日发布 Data Agent 时,其实已经发出了类似信号。Data Agent 虽然可以连接 Snowflake、BigQuery、Databricks、Redshift、MongoDB,以及 Google Drive、SharePoint,但 OpenAI 特别强调,它还会读取企业已有的业务术语、Metric Definition、Custom Calculation 和 Data Relationship;这些 Context 可以来自 Databricks Genie Ontology、dbt、GitHub、Snowflake Horizon 和 BI Dashboard。
9 月 10 日的 Data Agent,开始主动消费 Semantic Layer;9 月 21 日的 V7 案例,又把非结构化文件进一步组织成 Context Graph。
两件事放在一起,企业 Agent 的技术栈正在出现一条越来越清楚的线:
模型之下,不再只有数据库和向量库,而开始多出一层专门给 Agent 使用的企业 Context Layer。
05 RAG 不会消失,但“企业知识库=向量库”可能真的要结束了
RAG 当初解决的是一个非常明确的问题:模型不知道企业私有信息,那就在回答前把相关资料找出来。
这个方案对于“这份合同的付款期限是多少”“帮我总结这份报告”仍然非常有效。甚至 V7 自己现在也没有放弃它——Context Graph 查不到的信息,依旧回到原始文档执行 RAG。
变化发生在任务复杂度上。
当 Agent 要跨 SharePoint、Drive、CRM、数据库和几十份文件工作,要理解同一个 Entity 的不同名字,要比较连续几个季度的 Metric,要记得公司过去做过什么判断,还要把任务一直执行几十步,“找到几个语义最相似的 Chunk”就开始显得不够。
企业需要提前解决的开始变成:Entity Resolution、Ontology、Relationship、Metric Definition、Temporal State、Provenance,以及这些 Context 如何持续更新。
过去大家讨论 Context Engineering,更多是在研究 Prompt 里该塞什么、什么时候做检索、什么时候压缩 Context。现在 Context Engineering 又在往基础设施层下沉:企业要先把自己的组织知识变成模型可以稳定查询的结构。
这也解释了为什么现在同时出现 Semantic Layer、Ontology、Context Graph、Enterprise Memory 这些词。它们表面属于不同产品,背后解决的是同一个问题:模型已经越来越会推理,但企业内部真正可用的 Context,还没有被整理成适合 Agent 消费的形态。
V7 CEO Alberto Rizzoli 在 OpenAI 的案例里最后说了一句话:真正从 AI 获得价值的金融机构,不会是 Agent 数量最多的,而会是 Context 最好的。
这句话放在今天,可能比“再换一个更强模型”更接近企业 Agent 的下一个竞争点。
RAG 没死。它只是正在从企业 AI 的“知识层”,退回自己更擅长的位置:搜索层。
而企业 Agent 真正开始争夺的,是 RAG 上面的那一层——谁能把散落在文档、数据库和业务系统里的知识,提前整理成一份持续更新、可追溯、可以直接被 Agent 调用的企业 Context。
过去企业 AI 的核心问题是“模型去哪找资料”;接下来更可能变成“在 Agent 开始工作之前,企业有没有先把自己组织明白”。这个趋势,在云栈社区的企业 AI 讨论中也有不少回响。
参考来源
OpenAI:《How V7 gives AI agents institutional memory》,2026 年 9 月 21 日。
V7:《GraphRAG vs RAG: A 1,000-Document Benchmark on Private Markets Data》,2026 年 8 月 28 日。
Salesforce AI Research:《Benchmarking Deep Search over Heterogeneous Enterprise Data(HERB)》,EMNLP 2025 Industry Track。
OpenAI:《Now everyone can put data to work》,2026 年 9 月 10 日。
 发表于 1 小时前
|
查看: 5|
回复: 0


