体检报告、房屋租赁合同、家电保修凭证、散落各处的发票,还有随手塞进鞋盒就再也找不着的数码说明书……每当你急需其中某张纸去办事时,翻找现场往往狼狈不堪。
纸质原件沉睡在某个抽屉的深处,电子扫描件混杂在微信传输助手或网盘里,文件名清一色是 IMG_20240312.jpg。
很多人试过用网盘或云笔记来拯救生活,但很快就放弃了:网盘只是一个冷存储文件夹,不会理解发票上的税号与开票日期;而把包含全家敏感隐私的社保、纳税、病历明文托付给第三方 SaaS,又会让人心里发毛。
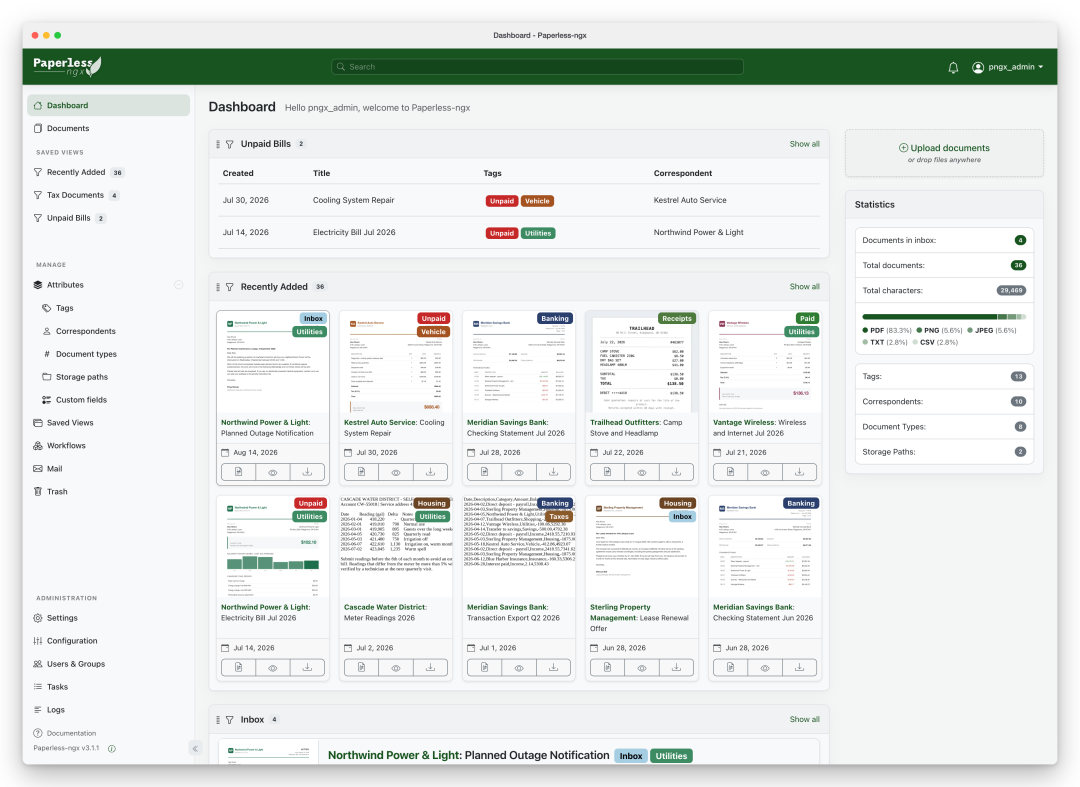
我一开始也怀疑过:真有必要为了存几张单据专门跑一套服务吗?直到深入研究了 开源 自托管领域的明星项目 Paperless-ngx(GitHub 4.6 万 Star,最新 v3.2.1)。它解决的从来不是“怎么把纸拍成照片”,而是把从单据录入到长期归档的整条阻力链彻底打通。
项目卡片
- 项目:Paperless-ngx
- 状态:v3.2.1 / GitHub 46k+ Star / 开源自托管文档管理系统(DMS)
- 一句话判断:将散落的纸质单据与杂乱电子文件,自动化转变为可全文检索、本地防锁死的私有数字档案库。
为什么多数文档整理系统最终都会荒废?
几乎所有文档归档计划的死因都一样:手动录入的阻力太大。
如果每收到一张发票,你都得打开电脑、拍照、裁剪、重命名、选三层目录、打好标签再上传,不到两周流程就会崩溃。桌上一旦堆起未整理的文件,整个系统就会迅速退化。
Paperless-ngx 的第一道解法是“零摩擦归集”:
它在后台监控一个名为 consume 的目录。如果你有网络扫描仪或支持 ADF(自动进纸)的多功能一体机,只需将扫描目标配置为该目录的 SMB 共享。按下扫描键,文件落地即自动触发流水线。
对于日常电子单据,它内置了邮件拉取规则。水电费账单、云厂商账单、火车票凭证,只需在系统里配置一条针对特定发件人的 IMAP 规则,附件里的 PDF 就会被静默抓取并自动入库。
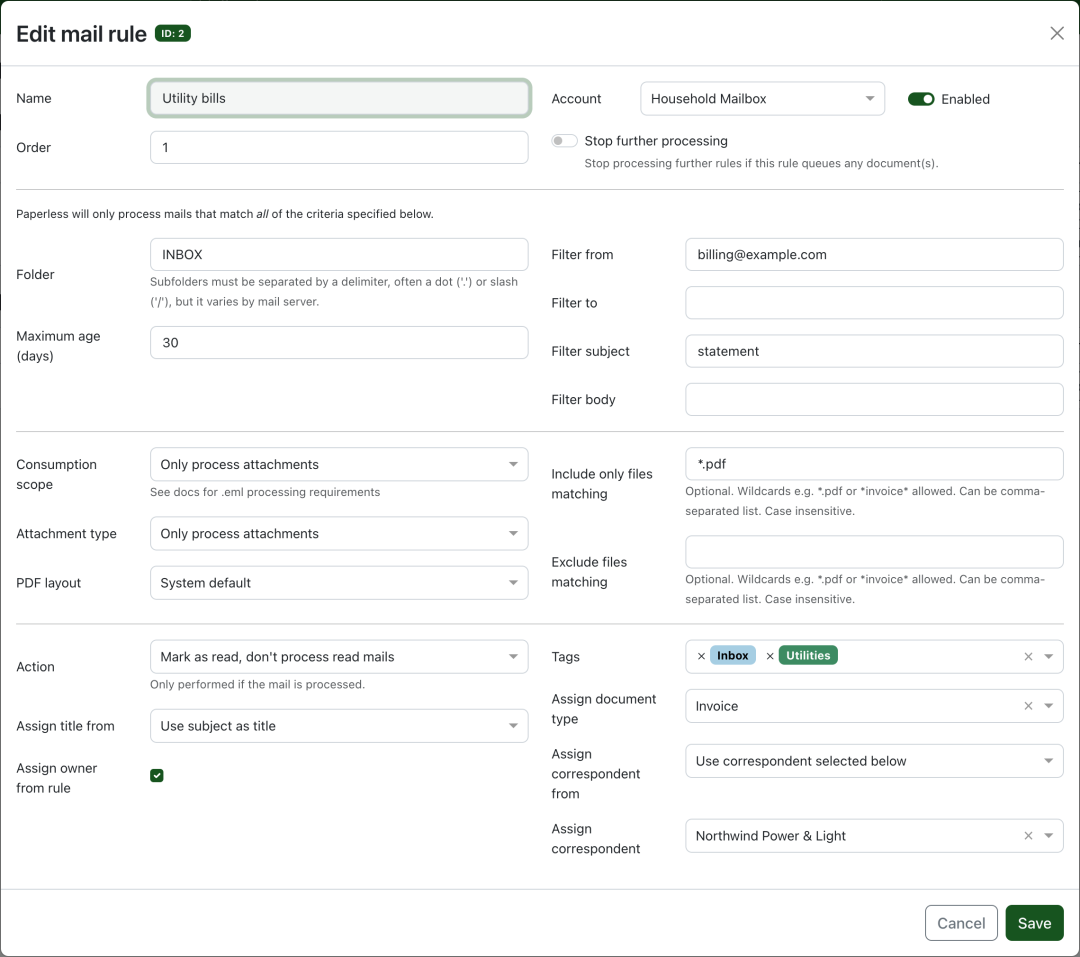
手机端配合开源 App 或 Web 端直接拖拽,几秒内即可完成投递。你不需要在录入阶段做任何分类决策,把东西“丢进去”就够了。
丢进系统之后:双轨制归档与 Rust 级检索
收纳只是第一步。如果堆积上千份文档后依然搜不到,它就只是个更大的数字垃圾桶。
很多轻量工具做 OCR 仅提取一段纯文本存进数据库。Paperless-ngx 采用的是严肃的“双轨制”存储:
- 绝对保留原始文件:无论上传的是扫描图片、原始 PDF 还是 Office 文档,未经修改的原始介质都会永久保留,绝不在处理中造成破坏。
- 生成标准 PDF/A 归档副本:内置 Tesseract OCR 引擎,支持中文(
chi_sim)在内的 100 多种语言。它会为文档附加上透明文字层,生成符合 ISO 归档标准的 PDF/A 格式,确保十年后换任何阅读器都能精准选中复制。
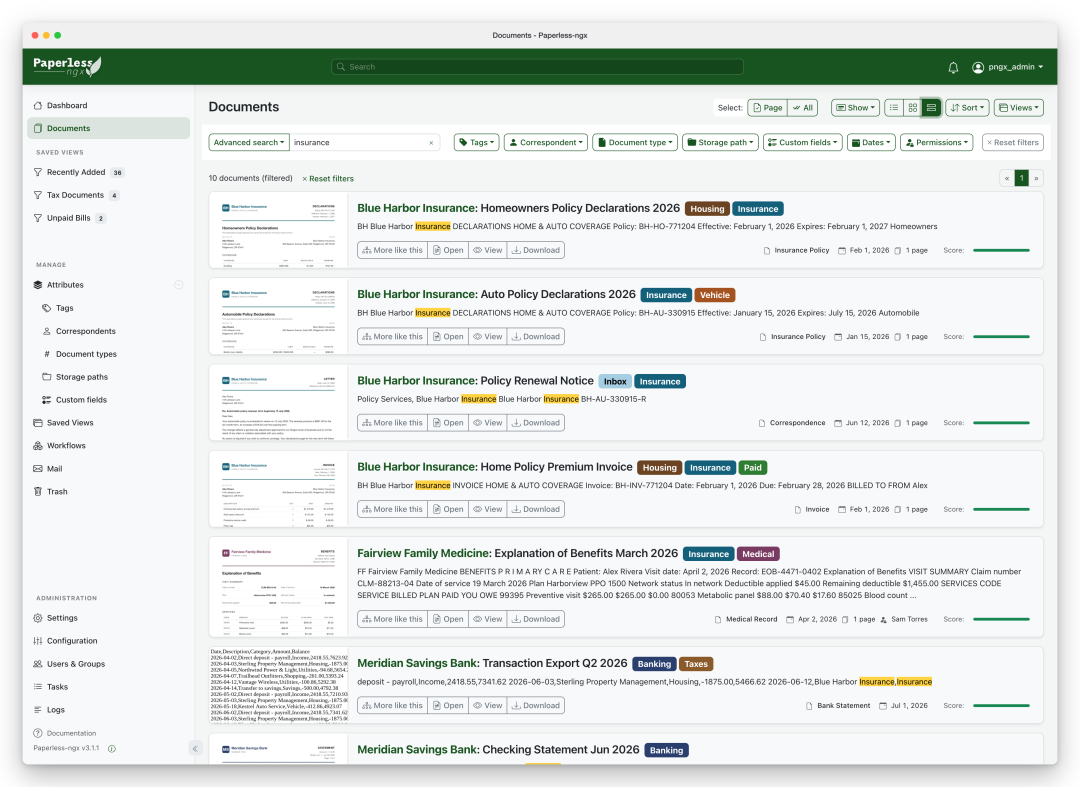
更实用的是它的自动标注。Paperless-ngx 内嵌了基于 scikit-learn 的文本分类器。最初手动纠正几次后,只要文档出现某家公司的抬头发票或医院名称,系统就会自动匹配对应的交易方(Correspondent)、文档类型与标签。
底层全文检索则接入了用 Rust 编写的高性能 Tantivy 搜索引擎。几千页的文档库里,不仅支持毫秒级关键词高亮直达,还提供了自动补全与相似文档联想。
纸质原件还要留着,物理整理怎么办?
做无纸化最常遇到的现实是:很多关键纸质文件在法律或生活场景中根本不能扔。
房产原件、红章合同、公证书、出国签证证明,即便数字化了,原件依然得妥善保管。如果找原件还要在纸质文件夹里翻找,数字化的意义就打了折扣。
Paperless-ngx 最惊艳的设计,是它对物理档案流水号(ASN,Archive Serial Number)与条码的原生支持。
你只需在网上买一卷按顺序编号的条码贴纸(0001, 0002, 0003……):
- 收到重要纸质合同或收据,在第一页右上角贴一张条码。
- 丢进扫描仪,系统识别到 ASN 条码后,自动将其绑定为系统内的唯一物理编号。
- 扫描完的纸张无需做任何物理分类,直接按数字顺序叠放在一个普通牛皮纸箱里。
当某天你需要带原件去现场核验时,在 Web 界面搜出文件,界面清晰显示 ASN: 0142。你走向储物架,翻开纸箱数到第 142 份即可抽出。这套逻辑消灭了物理分类的全部心智负担。
不当“数据囚徒”:绝不锁死的本地磁盘哲学
自建个人系统的最大顾虑,是软件停止维护或数据库损坏后资产尽失。很多系统把文件加密打碎存放在专有数据库的 BLOB 里,一旦离开系统导出的全是一堆乱码。
Paperless-ngx 在架构上做了清醒的取舍:数据必须以普通文件形式存在于物理硬盘上。
它提供了一项名为 PAPERLESS_FILENAME_FORMAT 的规则配置,允许自由定义硬盘上的真实目录结构:
PAPERLESS_FILENAME_FORMAT={{ created_year }}/{{ correspondent }}/{{ title }}
这意味着即便 Docker 容器崩溃、数据库损坏,或者你决定放弃它,宿主机 media 目录下依然整齐躺着 2024/招商银行/对账单.pdf 这样的物理文件。
配合官方提供的 document_exporter 工具,随时可以一键将全部文档与元数据 JSON 完整打包迁移,没有任何专有壁垒。
上手体验与必须警惕的边界
部署 Paperless-ngx 并不繁琐。官方推荐使用 Docker Compose,核心服务包含 Web 容器、Valkey(或 Redis)任务中继以及 PostgreSQL 数据库:
# 官方一键引导安装脚本(含目录交互与默认凭据生成)
bash -c "$(curl -L https://raw.githubusercontent.com/paperless-ngx/paperless-ngx/main/install-paperless-ngx.sh)"
如果手动编写 Compose,最关键的是把用于自动摄取的 consume 目录和持久化存储的 media 目录正确映射到大容量存储盘上。
但在准备把全部家庭或工作室文档迁入前,务必清楚它的边界:
- 明文存储的安全红线:Paperless-ngx 底层明文存放原始文件,系统内部不提供加密落盘。官方明确提醒:严禁将服务端口无防护暴露在公网。远程访问请务必配合 Tailscale 等私有组网,或在反向代理前加上严密的双重认证(2FA)。
- 批量扫描时的算力激增:Tesseract OCR 与 Apache Tika 非常消耗 CPU 和内存。如果一次性把几百页旧文档倒进
consume 目录,低功耗 NAS 上会瞬间跑满 CPU。建议合理限制工作进程数,避免挤占核心业务。
- 场景劝退:如果你一年只有三五张发票,直接用网盘文件夹足够,无需常驻一套 Docker 栈;它真正适合的,是有家庭证照沉淀、自由职业者财务票据、或小团队采购与技术合同管理需求的用户。
把精力从机械归档中解放出来,让物理纸张有去处,让数字资产无论何时都能秒级重现——这才是自托管工具应有的体面。
如果你对这类自托管工具与开发者实践感兴趣,云栈社区 还有更多深度拆解可供参考。
[1] Paperless-ngx: https://github.com/paperless-ngx/paperless-ngx
 发表于 1 小时前
|
查看: 4|
回复: 0


