不知道你有没有这种经历:PDF 下载了一堆,笔记写了几十篇,收藏夹也分好了类别。可真要找一个结论时,却怎么都想不起它在哪。
打开搜索框,换三组关键词,翻好几个文件夹,最后还是重新上网搜。至于让 AI 帮忙,还得先找出文件、上传、再交代一遍背景……收藏的时候挺勤快,用的时候挺费劲。
今天要聊的 Khoj,想把这件事理顺:把资料接进来,有问题直接问。
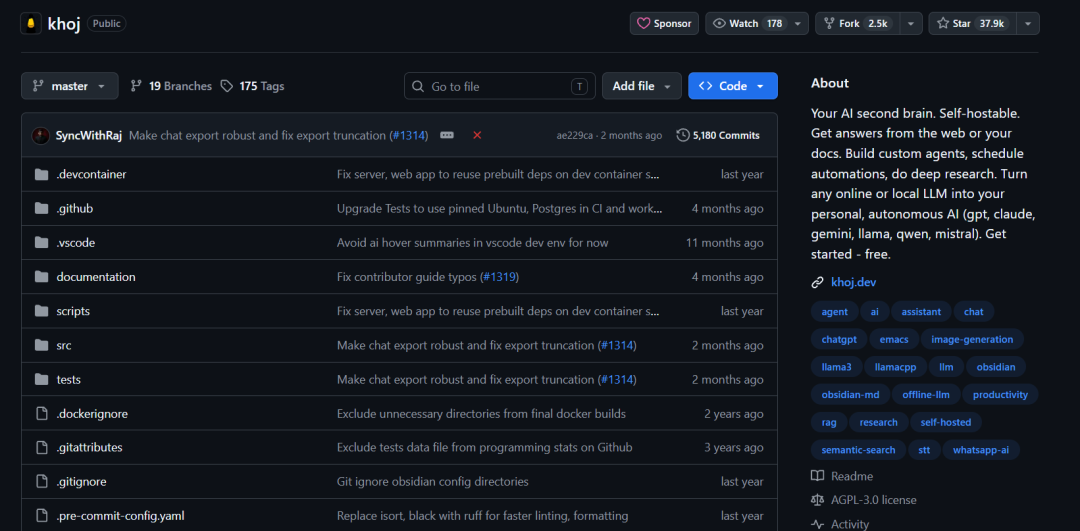
项目简介
Khoj 是一个开源、支持自行部署的 AI 助手,定位是你的“第二大脑”。它可以结合个人文档和互联网信息来回答问题,也能创建专用智能体、安排定时任务。
模型选择上也很灵活:可以接入 GPT、Claude、Gemini 等在线模型,也可以搭配本地模型使用。平时在浏览器里打开就能聊,Obsidian、Emacs 等工具也有对应的接入方式。
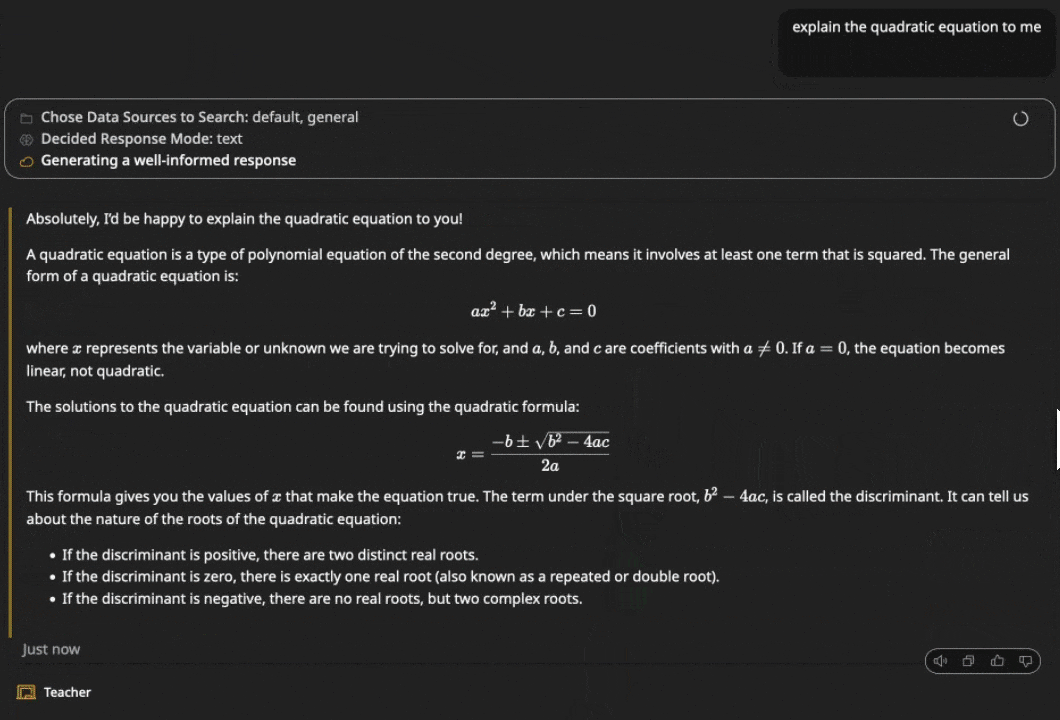
官方演示截帧:Teacher 智能体讲解数学问题
自己的资料,直接开口问
PDF、Markdown、Word、org-mode,以及 Notion 中的内容,都可以成为它检索和回答的材料。
比如把某个项目的会议记录和需求文档接进去,问一句“之前为什么放弃了这个方案?”,它就会先找相关内容,再交给模型组织回答,并展示用到的参考笔记。
这一步省心的地方在于:你不用每次都重新找文件、复制材料。 读到关键结论,还能回头核对原文,看看 AI 有没有理解偏。
如果资料混在一个大库里,也能用文件筛选限定对话范围。只讨论当前项目,就让它围绕那几份文件找答案,少受其他笔记干扰。
忘了关键词,也能找笔记
普通搜索很依赖你记不记得原来的用词。Khoj 支持语义搜索,用自然语言描述“想找什么”就行,不必死磕某一个关键词。
比如记得写过“怎么让会议少一点”,却忘了标题叫“团队沟通流程优化”,就可以直接按意思去搜。它会寻找内容相关的文档片段,而不是只做字面匹配。
碰到需要新信息的问题,还能联网检索;想深入查一个主题,也有研究模式。旧笔记和新资料,终于可以放在同一次对话里讨论了。
给不同事情,配不同助手
写作、学习、整理资料,适合的回答方式往往不一样。Khoj 可以创建自定义智能体,单独设置知识范围、角色提示、模型和工具。
你可以给写作助手规定语气,让学习助手多追问、少直接给答案。常用的要求提前设好,下次进入对应角色,就不用从头重复一遍。
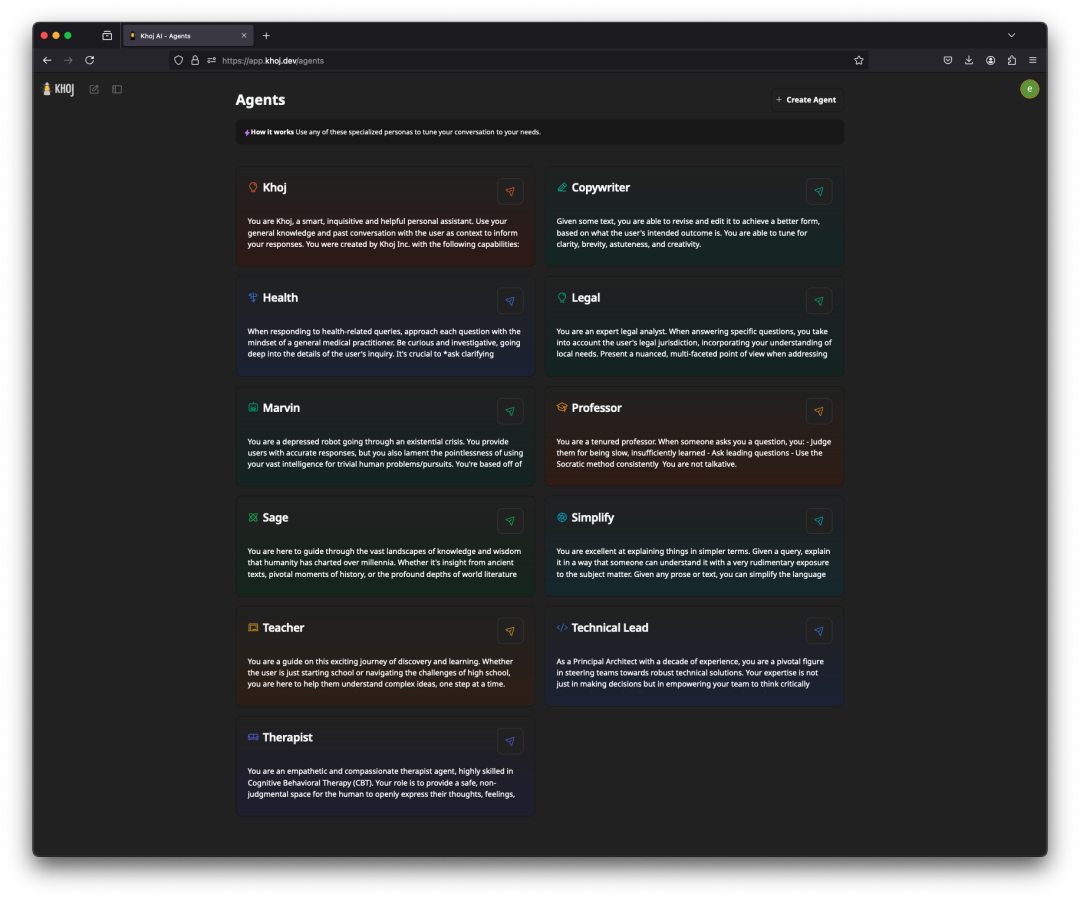
智能体列表:为不同任务配置不同角色,界面随版本变化
重复查的内容,让它定时查
如果你每周都要追踪某个技术方向的更新,就可以把查询设成自动任务,指定时间和频率,让 Khoj 定时研究,再通过邮件把结果发给你。
这比每天想起来就打开网页翻一遍省事不少。任务也能在页面里管理、修改和删除。自行部署时,邮件推送需要配置邮件服务和身份认证。
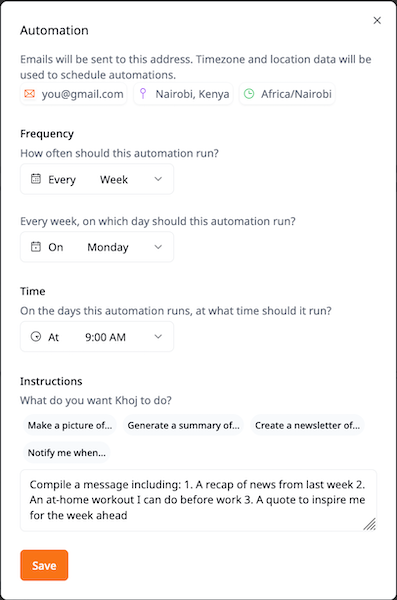
自动任务设置:选择频率、时间和查询内容
模型自己选,习惯不用重来
Khoj 把聊天界面、资料检索和模型连接放在同一套工具里。想换模型时,可以在配置中调整,不必重新搬一次资料、再学习一套全新的文件问答界面。
电脑性能够用,可以研究本地模型;更看重回答能力和省去维护,也能选在线服务。选择哪个模型,按自己的设备、预算和需求来。
快速安装、使用
想先看看是否适合自己,可以从仓库进入官方云端应用。想自己掌控服务,就选 Docker 部署,支持 Windows、macOS 和 Linux;Windows 用户需要按文档准备 WSL2 和 Docker Desktop。
装好 Docker 和 Compose 后,先下载配置文件:
mkdir -p ~/.khoj
cd ~/.khoj
curl -L https://raw.githubusercontent.com/khoj-ai/khoj/master/docker-compose.yml -o docker-compose.yml
打开 docker-compose.yml,修改 KHOJ_ADMIN_PASSWORD 和 KHOJ_DJANGO_SECRET_KEY,再填入模型 API Key,或者按配置中的说明连接本机 Ollama。然后启动:
docker compose up -d
首次启动需要下载镜像和模型。等服务就绪后,打开 http://localhost:42110。首次运行后再重启一次服务,让设置完整生效;模型可以在管理后台继续调整。
接着上传几份熟悉的文档,先问一个自己知道答案的问题,看看检索结果和回答是否对得上。
这里也得说清楚:本地部署不等于所有处理都在本地。 接入云端模型时,相关内容仍会发给模型服务商;想只在本机处理资料,需要配合本地模型,并关闭联网功能。云端 API 和自备硬件也各有成本。
写在最后
Khoj 的吸引力,在于把“存资料、找资料、问资料”接成了一条顺畅的流程。笔记不再需要等你记起文件名,才有机会被翻出来。
当然,资料写得清楚、模型选得合适,回答才更有用。个人认为,先让一小部分笔记真正用起来,比一上来导入几万个文件更容易看到价值。
如果你也有一堆攒了很久、用得很少的文档,不妨先挑一个小文件夹试试。从下一次找资料开始,看看它能不能替你少翻几个窗口。类似的部署和配置问题,也欢迎到云栈社区一起交流。
项目地址:https://github.com/khoj-ai/khoj
 发表于 昨天 23:37
|
查看: 3|
回复: 0
 /1


