企业AI最难的问题,从来不是“会不会回答”,而是“能不能进入生产”——在安全边界内完成一件真实的事。
前段时间,一家制造企业找我们聊AI。他们做的事其实不少——大模型接了,RAG建了,知识库也有了,还上线了销售AI助手。
销售人员可以直接问:“过去30天,哪些重点客户订单下降超过20%?”AI能回答。再问:“为什么下降?”AI也能结合历史数据做分析。到这里,一切看起来都挺好。
但业务人员接着说了一句:“那就把这些客户加进跟进名单,给对应销售创建任务吧。”系统突然卡住了。
不是模型不会,而是后面的流程根本没接上。AI不知道什么叫“重点客户”,不知道这个客户归哪个销售管,更不知道CRM里怎么创建跟进任务、需要什么权限。于是最后还是变成:AI给建议,人去CRM里手工操作。
这其实就是今天企业AI最典型的困境。模型越来越强,Agent越来越聪明,RAG、MCP、Workflow一个不少,但真正进入生产流程后,很多项目还是停在“AI助手”这一层。
因为企业AI最难的问题,从来不是“AI会不会回答问题”,而是 “AI能不能进入真实业务世界,在安全边界内完成一件真实的事”。
前两篇文章讨论了Ontology如何让AI理解企业,FDE如何让AI进入企业。这一篇要解决的是:没有Palantir,企业到底怎么自己把这套东西搭出来,并真正跑进生产环境?
本文看点
- 01 五道鸿沟
- 02 落地五步法
- 03 90天路线
01 AI已进入企业,但还没进入生产系统
McKinsey 2025年调研发现,88%的组织表示至少在一个业务职能中使用AI,但只有7%表示AI已经完成规模化。
这个数字说明了一件事:AI Adoption和AI Scaling完全不同。员工会用AI,不代表企业拥有AI能力。做出一个Agent,不代表AI已经进入业务流程。上线一个AI应用,也不代表企业生产方式已经改变。
真正的规模化大致要经历这样一条路:
员工使用AI → 企业建AI应用 → AI进入业务流程
→ AI调用企业系统 → AI执行业务动作
→ AI成为流程一部分 → 企业重新设计工作方式
这就是为什么很多企业会出现一种奇怪现象:AI项目越来越多,但业务并没有明显变化。销售还是原来的销售,客服还是原来的客服,只是每个人旁边多了个聊天框。这还不叫企业AI真正落地。
02 企业AI项目的五道鸿沟
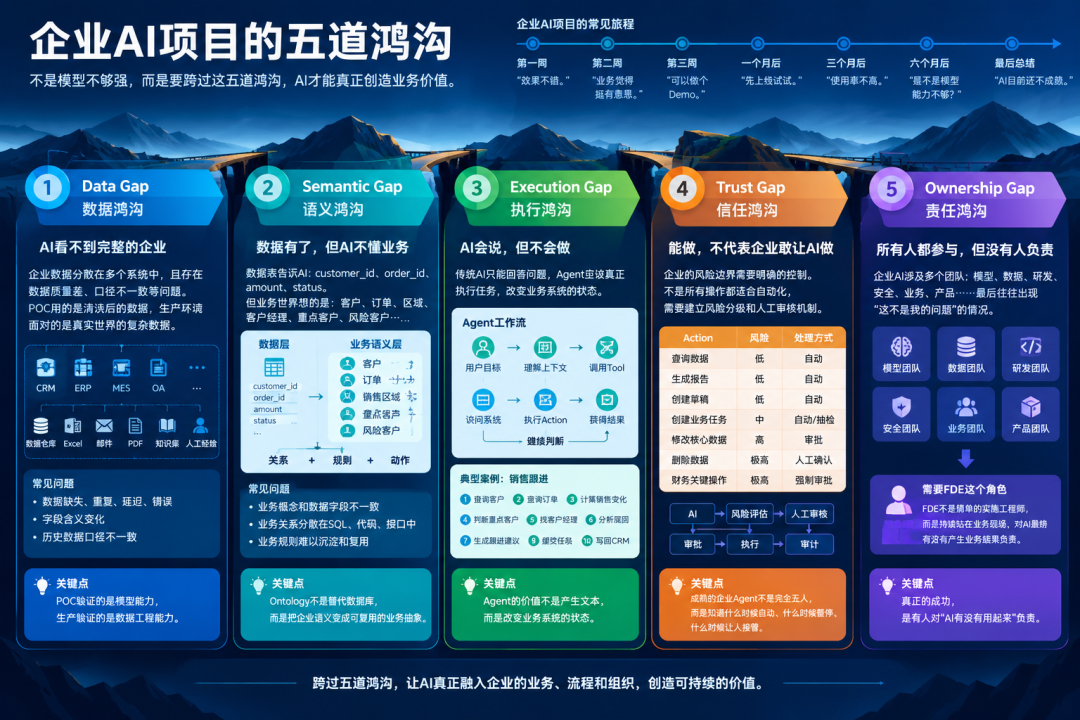
如果你参与过企业AI项目,应该对这个过程很熟悉:
第一周:“效果不错。”
第二周:“业务觉得挺有意思。”
第三周:“可以做个Demo。”
一个月后:“先上线试试。”
三个月后:“使用率不高。”
六个月后:“是不是模型能力不够?”
最后总结:“AI目前还不成熟。”
很多时候,问题根本不在模型。真正的问题是,企业AI要跨过至少五道鸿沟。
第一条鸿沟:Data Gap
AI看不到完整的企业。企业数据从来不会整齐地躺在一个库里。现实通常是:CRM、ERP、MES、OA、数据仓库、Excel、邮件、PDF、知识库、人工经验……散落各处。
而且每个系统都有自己的历史。销售系统有一套客户定义,财务系统有另一套,ERP里可能叫客户编码,CRM里可能叫Customer ID。
POC时怎么办?工程师把需要的数据抽出来,清洗一下,喂给AI。所以POC看起来很漂亮。问题是,一旦进入生产环境,真实数据开始进来:缺失、重复、延迟、错误、字段含义变化、历史数据口径不一致……
于是出现典型现象:POC准确率90%,上线后突然掉到60%。业务人员说:“AI不行。”但很多时候真正发生的是:POC验证的是模型能力,生产验证的是数据工程能力。
第二条鸿沟:Semantic Gap
这是企业AI最容易被低估的一层。数据库告诉AI:customer_id、order_id、amount、status。从数据库设计角度看,完全没问题。
但业务世界不是这样理解的。业务人员想的是:客户、订单、销售区域、客户经理、重点客户、风险客户……更重要的是,这些东西之间还有关系:
Customer
  ├── 拥有 → Order
  ├── 属于 → SalesRegion
  └── 负责 → AccountManager
再往下,还有业务规则:
重点客户 = 过去一年销售额超过X + 战略客户标签 + 当前合同状态有效
再往下,还有动作:创建跟进任务、升级客户等级、触发销售提醒、提交审批。
这时候会发现:企业真正缺的不是更多数据,而是业务语义。数据告诉AI:“这里有一条记录。”语义告诉AI:“这条记录在企业里到底代表什么。”
Ontology为什么会成为企业AI的关键基础设施?
必须把一个误区讲清楚:Ontology不是“比SQL更高级的数据库”。设计良好的数据库Schema、View、存储过程、业务规则层,同样可以表达很多业务语义。
Ontology真正有意思的地方,在于它把Object、Relationship、State、Action、Permission提升成整个应用和AI共同使用的业务抽象。
还是拿制造业举例。传统数据库里可能有:material_batch、production_order、supplier、quality_event。然后工程师通过JOIN把它们关联起来。当然可以,大型企业几十年来一直这么做。
问题不是SQL做不到,问题在于:这些业务关系往往分散在SQL、代码、接口、存储过程和工程师脑子里。Ontology的思路,是把它显式建出来:
MaterialBatch
  ├── 来自 → Supplier
  ├── 用于 → ProductionOrder
  └── 触发 → QualityEvent
然后再进一步定义Action:
批次异常 → 查找相关工单 → 定位产线 → 找到负责人 → 触发质量通知
「Ontology不是为了替代数据库,而是为了把散落在数据库、代码、接口和业务规则中的企业语义,提升成所有AI应用都可以复用的业务抽象。」
第三条鸿沟:Execution Gap
企业AI还有一个特别明显的问题:AI会说,但不会做。
传统Chatbot是:用户→AI→答案。Copilot进一步变成:用户→AI→建议。Agent则应该继续往下走:
用户目标 → Agent → 理解业务上下文 → 调用Tool
→ 访问企业系统 → 执行Action → 获得结果 → 继续判断
还是刚才那个销售案例。用户说:“找出最近30天销售额下降超过20%的重点客户,并安排销售跟进。”真正的Agent应该可以这样工作:
查询Customer → 查询Order → 计算销售变化
→ 判断重点客户 → 找AccountManager
→ 分析下降原因 → 生成跟进建议
→ 创建Follow-up Task → 提交审批 → 写回CRM
这里最大的变化是:AI不再只是产生文本,而是在改变业务系统的状态。这就是Agent和传统RAG应用之间非常重要的分界线。
从Ontology到Agent,中间真正发生了什么?
没有业务语义的时候:Agent → SQL → 数据 → 自己猜业务含义。有了业务语义之后:Agent → Business Object → Relationship → Business Rule → Action。
Agent不再面对一堆孤立的数据表,而是面对:客户、订单、合同、销售、设备、工单、供应商……这些企业真正使用的业务对象。
2026年6月,Palantir宣布Ontology MCP正式GA。它可以把Ontology中的对象类型、Action类型和查询函数作为MCP工具暴露给外部Agent,同时工具调用继续受Foundry既有权限体系约束。
换句话说:MCP解决的是“Agent怎么接进来”,Ontology解决的是“Agent接进来以后到底在操作什么”。两者不是一回事。
第四条鸿沟:Trust Gap
AI能做,不代表企业敢让AI做。这是企业AI和个人AI最大的区别之一。
个人用ChatGPT:“帮我写封邮件。”错了,大不了改一下。企业系统:“把这500个客户的信用等级全部改掉。”如果AI错了呢?
所以成熟的企业Agent,不应该追求“什么都自动化”,而应该建立明确的风险边界:
| Action |
风险 |
处理方式 |
| 查询数据 |
低 |
自动 |
| 生成报告 |
低 |
自动 |
| 创建草稿 |
低 |
自动 |
| 创建业务任务 |
中 |
自动/抽检 |
| 修改核心数据 |
高 |
审批 |
| 删除数据 |
极高 |
人工确认 |
| 财务关键操作 |
极高 |
强制审批 |
最终形成:
AI → Risk Assessment → Human Review → Approval → Action → Audit
这就是Human-in-the-loop真正的价值。不是因为“AI太笨,所以还得人工帮忙”,而是因为:企业的风险边界本来就不应该全部交给AI。成熟系统不是完全无人,成熟系统是知道:什么时候自动,什么时候暂停,什么时候让人接管。
第五条鸿沟:Ownership Gap
企业里通常有:模型团队、数据团队、研发团队、安全团队、业务团队、产品团队。最后项目出了问题,大家都可以说:“这不是我的问题。”
于是出现非常尴尬的情况:所有人都参与了AI项目,但没有一个人真正对“AI有没有用起来”负责。
这正是FDE这个角色有价值的地方。FDE不是简单的实施工程师,真正重要的是:有人持续站在业务现场,对AI最终有没有产生业务结果负责。
03 Palantir拆解与企业AI公式
如果把Palantir的企业AI路线拆开,会发现它并不是简单的“数据+大模型”,更接近:
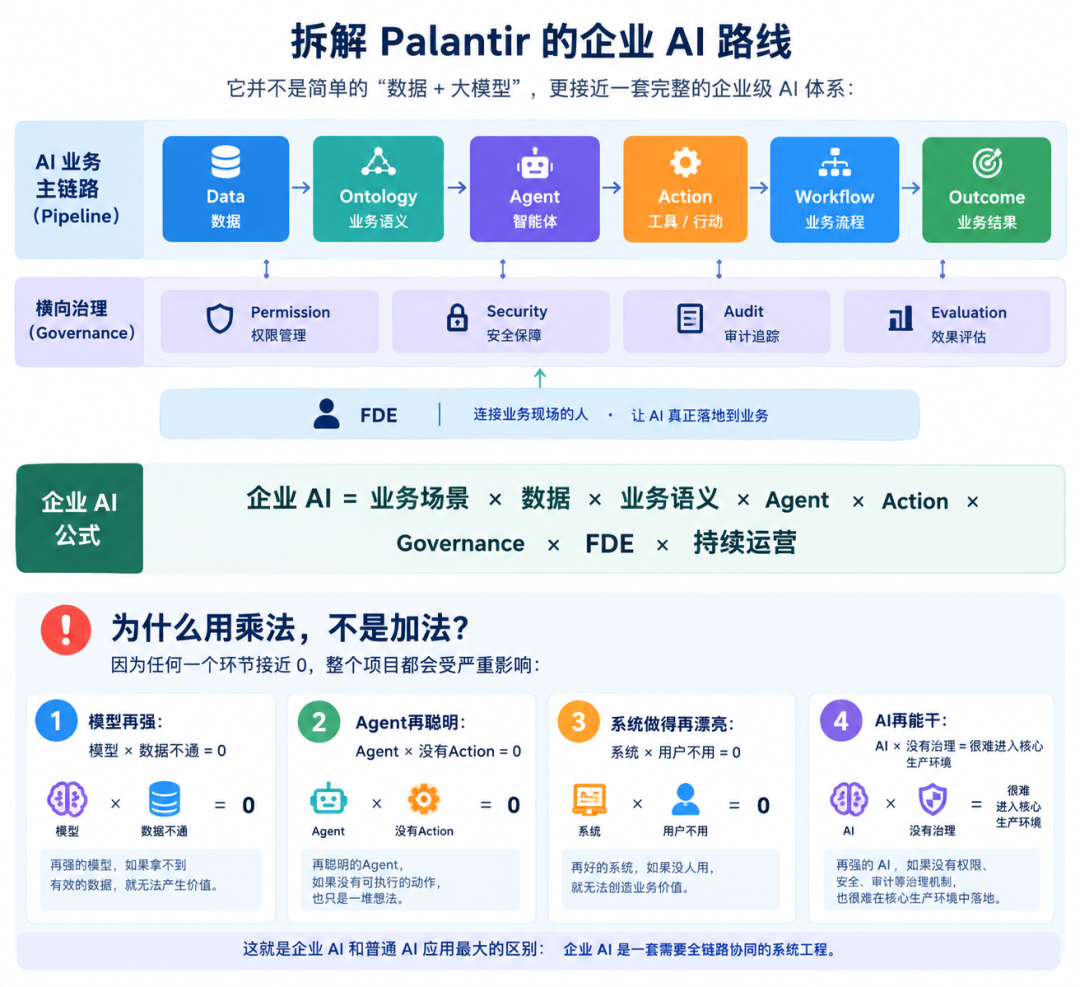
Data → Ontology → Agent → Action → Workflow → Outcome
再加上一层横向治理:Permission、Security、Audit、Evaluation。再加一个连接业务现场的人:FDE。
于是可以得到一套清晰的企业AI公式:
「企业AI = 业务场景 × 数据 × 业务语义 × Agent × Action × Governance × FDE × 持续运营」
为什么用乘法,不是加法?因为任何一个环节接近0,整个项目都会受严重影响:
- 模型再强:模型 × 数据不通 = 0
- Agent再聪明:Agent × 没有Action = 0
- 系统做得再漂亮:系统 × 用户不用 = 0
- AI再能干:AI × 没有治理 = 很难进入核心生产环境
这就是企业AI和普通AI应用最大的区别。
04 企业AI落地五步法
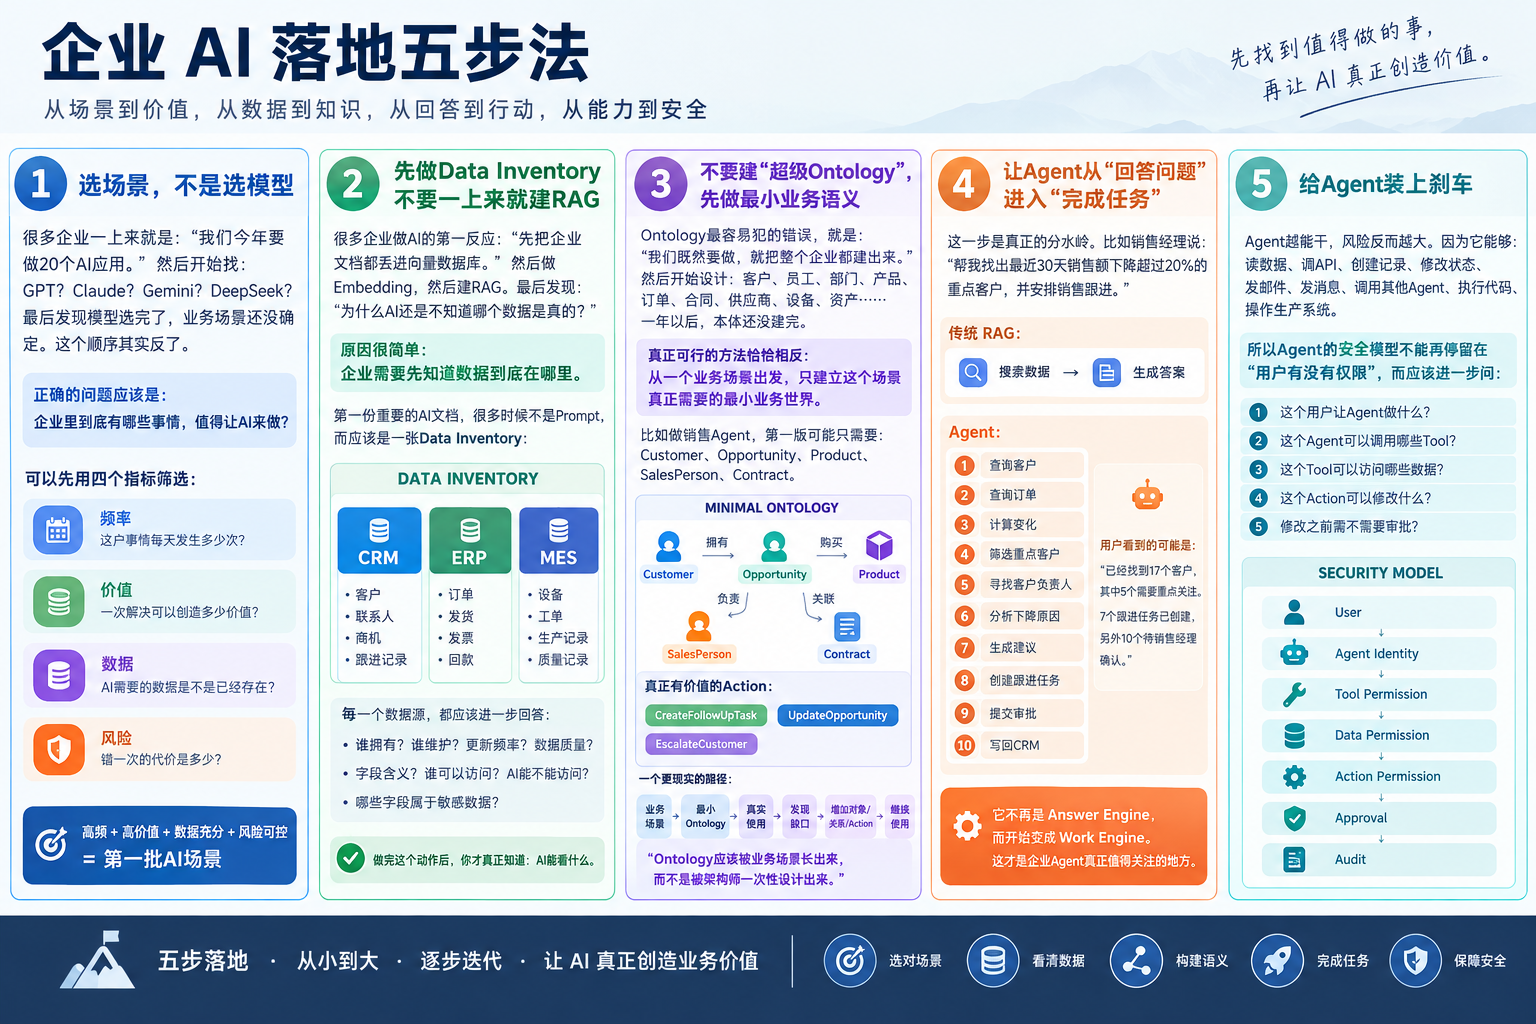
第一步:选场景,不是选模型
很多企业一上来就是:“我们今年要做20个AI应用。”然后开始找:GPT?Claude?Gemini?DeepSeek?最后发现模型选完了,业务场景还没确定。这个顺序其实反了。
正确的问题应该是:企业里到底有哪些事情,值得让AI来做?可以先用四个指标筛选:
- 频率:这个事情每天发生多少次?
- 价值:一次解决可以创造多少价值?
- 数据:AI需要的数据是不是已经存在?
- 风险:错一次的代价是多少?
高频 + 高价值 + 数据充分 + 风险可控 = 第一批AI场景
第二步:先做Data Inventory,不要一上来就建RAG
很多企业做AI的第一反应:“先把企业文档都丢进向量数据库。”然后做Embedding,然后建RAG。最后发现:“为什么AI还是不知道哪个数据是真的?”
原因很简单:企业需要先知道数据到底在哪里。第一份重要的AI文档,很多时候不是Prompt,而应该是一张Data Inventory:
CRM
├── 客户
├── 联系人
├── 商机
└── 跟进记录

ERP
├── 订单
├── 发货
├── 发票
└── 回款

MES
├── 设备
├── 工单
├── 生产记录
└── 质量记录
每一个数据源,都应该进一步回答:谁拥有?谁维护?更新频率?数据质量?字段含义?谁可以访问?AI能不能访问?哪些字段属于敏感数据?做完这个动作后,你才真正知道:AI能看什么。
第三步:不要建“超级Ontology”,先做最小业务语义
Ontology最容易犯的错误,就是:“我们既然要做,就把整个企业都建出来。”然后开始设计:客户、员工、部门、产品、订单、合同、供应商、设备、资产……一年以后,本体还没建完。
真正可行的方法恰恰相反:从一个业务场景出发,只建立这个场景真正需要的最小业务世界。比如做销售Agent,第一版可能只需要:Customer、Opportunity、Product、SalesPerson、Contract。
关系也不要贪多:
Customer
├── 拥有 → Opportunity
├── 购买 → Product
└── 负责 → SalesPerson

Opportunity
└── 关联 → Contract
再加几个真正有价值的Action:CreateFollowUpTask、UpdateOpportunity、EscalateCustomer。
跑起来,让真实用户使用,然后你会发现缺东西。这就是一个更现实的路径:
业务场景 → 最小Ontology → 真实使用 → 发现缺口 → 增加对象/关系/Action → 继续使用
「Ontology应该被业务场景长出来,而不是被架构师一次性设计出来。」
第四步:让Agent从“回答问题”进入“完成任务”
这一步是真正的分水岭。比如销售经理说:“帮我找出最近30天销售额下降超过20%的重点客户,并安排销售跟进。”
传统RAG:搜索数据→生成答案。Agent则是:
查询客户 → 查询订单 → 计算变化 → 筛选重点客户
→ 寻找客户负责人 → 分析下降原因 → 生成建议
→ 创建跟进任务 → 提交审批 → 写回CRM
最后用户看到的可能只是:“已经找到17个客户,其中5个需要重点关注。7个跟进任务已创建,另外10个待销售经理确认。”
这时候,AI的角色已经变了。它不再是Answer Engine,而开始变成Work Engine。这是企业Agent真正值得关注的地方。
第五步:给Agent装上刹车
Agent越能干,风险反而越大。因为它能够:读数据、调API、创建记录、修改状态、发邮件、发消息、调用其他Agent、执行代码、操作生产系统。
所以Agent的安全模型不能再停留在“用户有没有权限”,而应该进一步问:“这个用户让Agent做什么?”“这个Agent可以调用哪些Tool?”“这个Tool可以访问哪些数据?”“这个Action可以修改什么?”“修改之前需不需要审批?”
User → Agent Identity → Tool Permission → Data Permission
→ Action Permission → Approval → Audit
OWASP在2025年底发布的Agentic Applications Top 10,已经把Agent Goal Hijack、Tool Misuse、Identity & Privilege Abuse等作为独立风险类别。这意味着:AI安全已经从“模型输出安不安全”,逐渐进入“Agent行为安不安全”。
05 上线后的持续运营与自建路线
很多项目验收标准是:“功能已经上线。”但AI项目真正上线后,才会暴露大量问题:这个用户为什么总是不用?为什么同一个问题有时候答案很好有时候很差?为什么业务人员开始绕过AI?
所以企业AI必须建立Production Loop:
上线 → 运行 → 监控 → 用户反馈 → Evaluation
→ 发现问题 → 更新Context/Knowledge/Workflow → 重新上线
至少要看四类指标:
AI指标:Accuracy、Groundedness、Hallucination、Tool Success Rate、Task Completion Rate
业务指标:人工工时减少、流程耗时减少、错误率变化、转化率变化、客户满意度变化
系统指标:Latency、Token Cost、API Cost、Failure Rate、Tool Error
治理指标:权限违规、敏感数据访问、人工接管率、审批率、Audit Coverage
💡 不要只问“AI回答得对不对”,更应该问“AI有没有把事情做完”。Task Completion Rate 才是最重要的指标。
没有Foundry,企业自己能不能搭?
答案很简单:可以。但这里有个特别容易产生的误解:“既然开源组件都有,那我们自己拼一个不就行了?”技术上当然可以。真正的问题是:你是在替代Palantir的产品,还是只是在替代它的许可证?
如果自己搭,企业AI Stack可以拆成三层:
Semantic Layer:负责企业业务对象与关系。可考虑:dbt Semantic Layer、OpenMetadata、Apache Atlas、Graph Database、Knowledge Graph。
Agent/Action Layer:负责AI如何理解任务并调用企业系统。组合:Agent Framework + MCP + REST API + Function Calling + Workflow。
Governance Layer:最容易被低估。至少需要:IAM、RBAC/ABAC、Policy Engine、API Gateway、Audit、Observability、Evaluation。
很多企业开源方案最后真正花时间最多的地方,不是Agent,而是:权限。
真正难复制的不是组件,而是三层之间的一致性
假设你有:Graph DB + RAG + Agent + Workflow + API Gateway + IAM + OPA + Audit。每个组件都很好。问题来了:
Ontology里的Customer A,对应CRM里的customer_id=18392,谁保证两边一直一致?Agent能看到Customer A,那Agent是否应该拥有同样的权限?Agent创建了一个Action,CRM状态变了,Graph DB有没有同步?Audit有没有记录?
「企业AI最大的隐藏成本,是Integration Tax。」
也就是:组件开发+系统集成+权限同步+数据同步+治理+运维+升级+故障排查。你可以不用买Palantir,但这些工作不会凭空消失。
企业什么时候应该自己建?
其实没有必要所有企业都去建设企业级Ontology。如果只有一个简单场景:员工问知识→RAG,就够了。但如果企业开始出现:多个AI应用 + 多个业务系统 + 大量共享业务对象 + 跨部门流程 + Agent需要修改业务状态 + 严格权限要求——这时候,语义层的价值开始显著增加。
简单问答 → RAG
业务查询 → Semantic Layer
跨系统Agent → Ontology + Tools
业务执行 → Ontology + Action + Governance
企业规模化 → Enterprise AI Platform
不要为了“先进”而跳级。
06 POC到生产的陷阱与治理
企业AI有个特别奇怪的现象:第一个项目成功了,反而可能是第二个项目失败的开始。因为第一个项目往往拥有很多隐性条件:有个特别支持AI的业务负责人,有个特别懂业务的数据工程师,数据刚好比较干净……这些条件并不会自动复制。
从POC到生产,至少要注意六个坑:
- POC数据太干净。工程师拿最好的数据做Demo,生产环境却是真实数据+历史数据+脏数据。最后模型背锅。
- 权限最后补。POC阶段“先跑起来”,生产后被安全部门叫停。
- 第一个成功场景被误认为方法论已经成功。真正应该复盘的是:这个项目到底为什么成功?
- 只看回答准确率。企业最终需要的是Task Completion,而不是Answer Quality。
- AI不知道什么时候应该停止。成熟的Agent应该允许:AI不确定→停止→请求人工。
- FDE离开后项目没人管。没人维护、没人评估、没人看日志、没人更新知识。
所以真正的交付,不应该只是“系统上线”,而应该包含:Business Owner + AI Owner + Technical Owner + Evaluation Set + Monitoring + Knowledge + Runbook + Incident Process。
Agent时代,权限体系也要重新设计
传统企业软件的权限模型通常是:User→Role→Permission→Data。Agent进入后,会变成:User→Agent→Tool→Data→Action→External System。
问题从“谁能看这个数据”升级成:“谁可以让哪个Agent,通过哪个Tool,以什么权限,对哪个业务对象执行什么Action?”
未来企业AI平台里的安全模块,很可能不再只是传统IAM,而是:Agent Identity + Tool Permission + Action Policy。
国内企业的AI落地,也不能简单理解成“换国产模型”
很多企业谈国产化,第一反应是:GPT→国产大模型。这只是第一层。真正的企业AI国产化,需要考虑:模型+算力+数据+数据库+身份+权限+审计+业务系统+部署边界。
企业真正应该问的不是:“我们是不是用了国产模型?”而是:“整个AI Stack是否在企业自己的安全边界和治理体系里可控?”
07 行业差异与组织演进
企业AI方法论可以统一,但业务对象不一样,落地路径完全不同。
制造业:围绕“设备、工单、物料”展开
制造业天然有一套非常适合语义建模的业务对象:设备、工单、物料、供应商、产线、质量事件。看起来非常适合Agent。但真正的难点往往不是AI,而是:OT和IT的连接。PLC、SCADA、MES、ERP,各自有自己的协议、数据结构和实时性要求。
制造业AI落地第一件事不是“上一个大模型”,而是:先把设备、工单、物料和质量事件真正连起来。
金融业:最适合Action,但治理墙也最高
金融业务天然存在:客户、账户、交易、产品、风险事件。关系非常清晰,Action也非常清晰。因此金融是非常典型的Agent场景。
但重点不是“AI能不能判断风险”,而是“AI的判断如何进入一个可解释、可审计、可追责的业务流程”。金融AI最终一定会走向:AI判断+规则+人工+审批+Audit。
政务:最大的难题经常不是技术,而是数据协同
政务领域也非常适合业务对象建模:个人、企业、事项、证照、部门、政策。但真正难的是:数据权属、部门边界、数据共享、权限、流程、责任。
政务AI很容易出现一个现象:大屏很漂亮,Dashboard很漂亮,但是业务流程没有变化。这时候AI项目依然没有真正进入生产。
从FDE到AI Engineering Team
如果一个企业只做一个AI项目,可能一个FDE就够了。但当企业有:10个场景、20个Agent、50个业务系统,这时候不能继续靠几个FDE顶着。组织会逐渐演化:
FDE → AI Delivery Team → AI Platform Team → Enterprise AI Operating Model
FDE不是企业AI的终点。FDE更像是把AI带进业务现场的人。当方法跑通后,企业真正要沉淀的是:一套不依赖某一个人的AI落地能力。
企业AI的成熟度,到底怎么判断?
可以把企业AI粗略分成六个阶段:
L0:个人AI — 员工自己使用ChatGPT、Claude等
L1:AI Application — 企业建设AI客服、AI知识库、AI Copilot
L2:AI Workflow — AI开始参与企业流程
L3:AI Agent — AI开始自主调用Tool
L4:Semantic Layer — 企业建设统一业务语义
L5:Agentic Enterprise — AI真正进入核心业务流程
这才是真正意义上的企业AI。
企业不要一上来就造“AI操作系统”
很多企业一看到Agent、Ontology、MCP,就开始想:“我们是不是应该建一个企业AI平台?”我反而建议先停一下,问三个问题:
- 我们现在到底有多少AI场景?如果只有一个,先做场景。
- 这些场景是否共享大量业务对象?如果每个场景都是独立的,没必要一开始就做庞大的Ontology。
- Agent是否真的需要修改业务状态?如果只是问问题→生成答案,RAG可能已经足够。
所以企业AI平台建设应该是被业务场景推出来的,而不是因为“现在Agent很火,所以我们也要做Agent平台”。
08 90天路线与上线清单
如果让我把前面所有内容压缩成一条企业真正能执行的路线,我会这么做:
第1~30天:找问题
不是找模型,而是:业务访谈→找到高价值场景→明确业务Owner→计算价值→盘点数据→明确权限。最终必须回答:为什么做这个项目?
第31~60天:做最小闭环
开始建设:核心业务对象→最小Semantic Layer→Agent→Tool→Action→Human-in-the-loop。目标不是“做出一个很漂亮的Demo”,而是:让3~5个真实业务人员,用它完成真实任务。
第61~90天:进入生产验证
建立:Evaluation + Monitoring + Audit + Feedback + Iteration。然后看最重要的三个数字:使用率、任务完成率、业务价值。如果用户根本不用,那么模型准确率再高也没有意义。
企业AI上线前Checklist
项目上线之前,可以拿这张表逐项问:
| 维度 |
核心问题 |
| 业务 |
为什么做?谁使用?解决什么问题?成功指标是什么? |
| 数据 |
数据在哪里?可靠吗?谁负责?更新频率?谁可以访问? |
| 语义 |
核心业务对象是什么?对象之间是什么关系?哪些规则重要? |
| Agent |
Agent可以看什么?调用什么?修改什么?什么情况必须停止? |
| Governance |
谁授权?谁审批?谁审计?谁负责异常? |
| Operations |
谁维护?如何评估?如何监控?如何回滚? |
如果这些问题回答不清楚,不要急着上线。因为真正的问题不是“模型能不能跑”,而是“这套系统能不能在真实企业里长期运行”。
企业AI真正要建设的,不是一个更聪明的Chatbot
回过头来看,前面三篇文章其实可以串成一条非常清楚的路线:第一篇讲Ontology,解决的是“AI怎么理解企业”;第二篇讲FDE,解决的是“AI怎么进入企业”;这一篇讲企业AI落地,解决的是“AI怎么真正进入生产,并且持续运行”。
最后会形成这样一条链路:
Enterprise AI → Business Context → Ontology → Agent → Tools
→ Actions → Workflow → Business Outcome → Evaluation
→ Context/Knowledge → Agent
普通AI:问题→答案。企业AI:业务问题→业务上下文→业务对象→Agent→企业系统→Action→Workflow→业务结果→反馈→持续迭代。
所以,企业真正需要建设的,从来不是一个更聪明的Chatbot,而是一套能够:理解业务、访问企业数据、调用业务系统、执行受控动作、接受人工监督,并且持续从业务结果中迭代的生产系统。
没有Foundry,企业当然可以自己搭。开源组件足够多,Agent Framework、MCP、Graph、RAG、Workflow、API Gateway、IAM、Policy Engine,一个都不缺。但真正应该问的,从来不是:“这些组件我们能不能拼起来?”
「我们有没有能力长期维护这条从业务语义到业务动作的完整链路?」
因为企业AI最终拼的不是Demo,拼的是:
- 谁能把AI真正接进业务
- 谁能让AI安全地做事
- 谁能让业务人员真的改变工作方式
- 谁又能把一次项目,变成企业可以持续复用的能力
这才是企业AI从“看起来很智能”,走向“真正产生业务价值”的那一步。
 发表于 2 小时前
|
查看: 5|
回复: 0
 /1


