PDF 里的文字都识别出来了,表格却错行、公式变乱码,阅读顺序也乱了。
OmniDocBench 不是新的 OCR 模型,而是一套用来评估文档解析结果的数据与方法。 如果你正在选文档解析方案、搭建知识库或评测模型,这张“考卷”值得收藏。
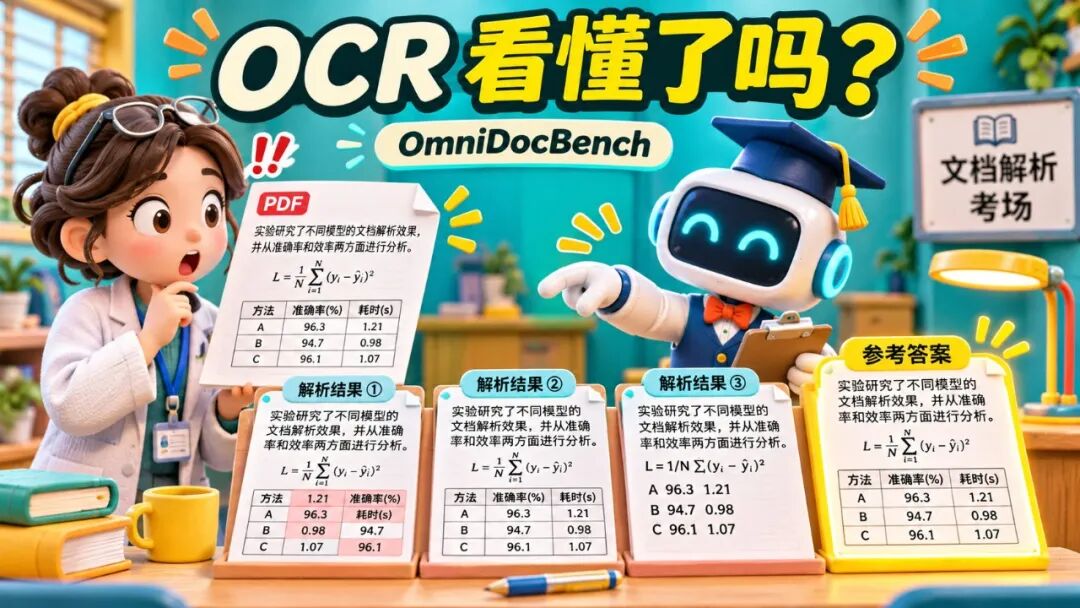
一份财报里,数字都认出来了,却把“收入”和“成本”对错了行;论文中的公式少了一个上下标,整句话的意思就变了。
更隐蔽的是阅读顺序:双栏文章的文字一个字都没错,但左右两栏被交替拼接,送进知识库之后,回答自然也容易跑偏。
所以评估文档解析,不能只问“识别了多少字”。还要看结构有没有保住、顺序有没有读对、公式和表格能不能继续使用。
OmniDocBench 是什么?
OmniDocBench 是 OpenDataLab 提出的文档解析评测基准,相关论文发表于 CVPR 2025。它包含标注数据、评测代码和公开的模型结果。
用考试来类比:文档页面是试卷,标注是参考答案;你选择的解析工具负责答题,评测代码负责比较结果。
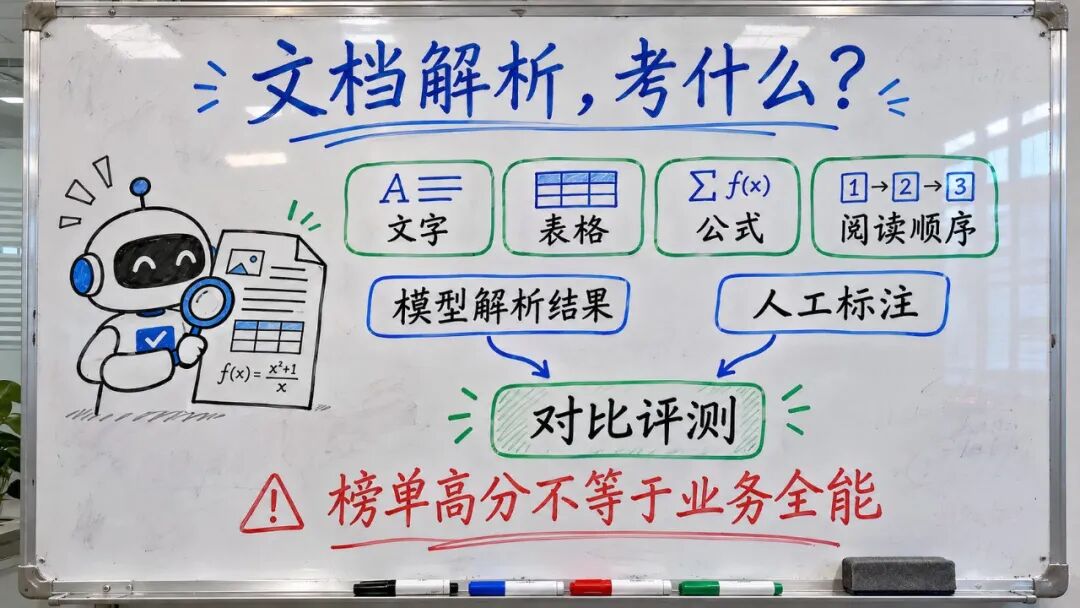
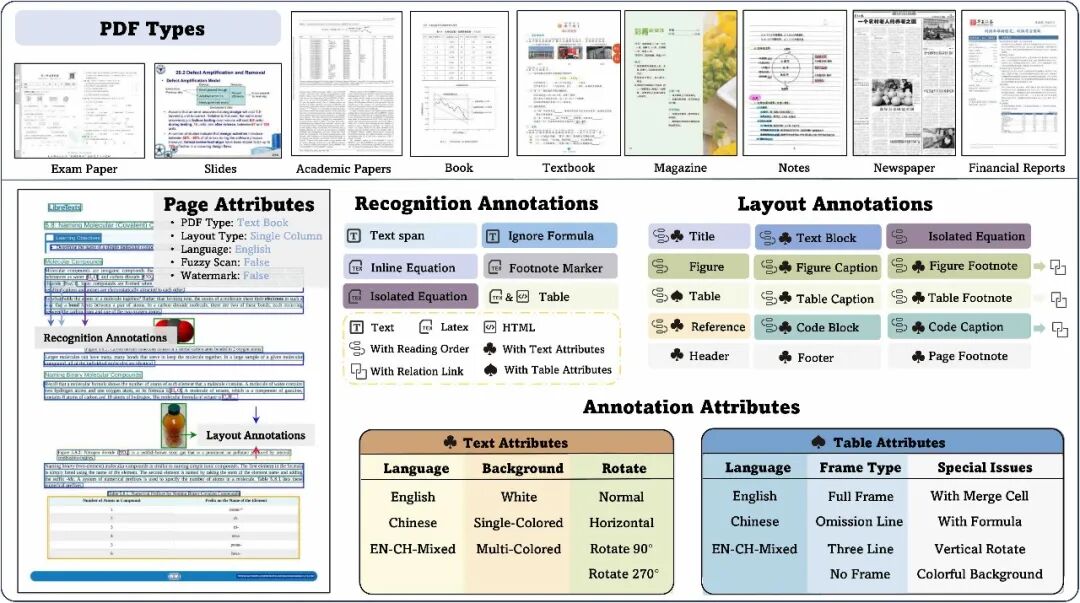
仓库当前介绍的基准包含 1651 个 PDF 页面,覆盖多种文档、版式和语言类型,并提供文字、表格、公式、阅读顺序等标注。不同版本的数据规模和评测方法会变化,比较结果时必须先对齐版本。
下面是项目提供的数据与标注介绍原图:
一张考卷,分四个重点看
| 评测维度 |
通俗理解 |
为什么重要 |
| 文字 |
内容识别得是否接近参考答案 |
错字漏字影响检索与引用 |
| 表格 |
内容和结构是否还原 |
单元格错位可能改变数据含义 |
| 公式 |
数学表达式是否正确 |
符号或上下标错误可能改变结论 |
| 阅读顺序 |
页面内容是否按合理顺序排列 |
多栏和复杂版面容易被拼乱 |
项目使用不同指标衡量这些维度。例如文字常看编辑距离,表格涉及 TEDS,公式涉及 CDM。理解趋势即可:不同指标的分数方向和计算方式不同,不能直接拿数字互相比较。
榜单怎么看,才不会掉坑里?
项目 README 给出了不同模型的评测结果,但榜单不是一句“第一名就是最适合我”的答案。
以仓库展示的端到端 Overall 为例,它由文字、表格和公式指标组合计算;阅读顺序是单独展示的指标,不包含在该总体公式里。如果你的应用特别依赖阅读顺序,只盯总体分数就可能错过问题。
同时要核对数据集版本、模型版本、输入方式和评测配置。不同版本的样本、匹配规则和评分方式会变化,跨版本数字不能简单当作同一场考试。
一款模型在公开基准表现好,也不保证它一定适合你的扫描合同、历史票据或内部报表。延迟、资源、隐私、语言以及后续人工校对成本,也要纳入选择。
怎么把它用到自己的项目里?
如果你在做 PDF 转 Markdown、企业知识库或 OCR 产品,可以先用它建立对文档解析能力的基本认识,再准备一批经过授权、符合实际业务的样本。
一个实用的比较思路:
- 选择相同输入与评测版本,记录模型和配置。
- 分别检查文字、表格、公式和阅读顺序,不只看总体分。
- 挑出高风险页面,回看解析结果和参考标注。
- 在自己的文档上测试耗时、成本和隐私要求。
这套基准能帮助组织评测,但它不负责替你自动完成全部文档解析。实际跑分仍需要准备模型预测结果、评测环境和配置;公式相关指标也有额外依赖。
使用边界
仓库代码标注 Apache-2.0,数据集和原始文档的使用许可需要单独核对,不能直接推断与代码完全相同。
公开基准还可能与真实业务的数据分布不同,标注和评分方法也有自身边界。高分可以作为筛选线索,但不等于生产系统的准确率保证。
本文依据项目仓库和论文整理,未运行评测,也未复现任何榜单分数。后续可以用一份含表格、公式和双栏的授权 PDF,比较不同解析工具的输出,再看看哪些错误最影响后续知识库问答。
项目地址
https://github.com/opendatalab/OmniDocBench
 发表于 2 小时前
|
查看: 4|
回复: 0
 /1


