用 Rust 写 PDF 引擎,有意思的点其实不在 PDF 本身——lopdf、pdf_oxide、qpdf 这条线早被人趟过很多轮。真正值得玩味的是它的架构:同一个 Rust 核心,同时开 CLI、MCP server、REST、WASM 四个口子。其中 WASM 那条路意味着浏览器里就能跑本地推理(OCR 都打包装进去),文件一个字节都不进服务器。PaperPilot 就是干这件事的:Apache 2.0 协议,2026-10-26 上了 Show HN(226 分,81 条评论),仓库当天还有新提交。
我没有照搬官方说法。在 2 核 EPYC 上冷编译 62 分钟,把 CLI、MCP、WASM 各跑了一遍,样例 PDF 是自己生成的。结论先摆在前面:merge/compress 这类操作确实在毫秒级,数据可信;但 CLI 的 ocr 命令跑完输出是空的,仓库自带的扫描页 fixture 也跑不出文字——根因是检测模型的输入形状和推理管线对不上。WASM 侧换了个 OCR 引擎反而能识别出字,只是 2 核机器上单页耗时 15.6 秒。所有数据均标来源:「本机 2 核 EPYC 实测」是我自己跑出来的,「官方自报」来自仓库 SYSTEM_BENCHMARK_REPORT.md,我没有独立复现。
实验设置
- 机器:AMD EPYC 9354P,2 核,7.8GB 内存,Linux 6.8,无 GPU,
torch/rten 全走 CPU
- 工具链:
rustc/cargo 1.99.0,Node v24.21.0(跑 WASM 包),pypdf 生成样例
- 仓库:
git clone --depth 1,2026-10-26 的 HEAD;release profile 是 opt-level=3 / lto=thin / codegen-units=16 / panic=abort / strip
- 样例:
a.pdf(3 页,1,763B)、b.pdf(2 页,1,087B)都是 pypdf 生成的纯文本 PDF;scan.pdf(1 页,94,271B)是 1240×1650 灰度 JPEG 嵌进 PDF 的「扫描件」,没有文字层
- 计时:每个命令先跑 3 遍热身,再正式计时,机器空闲
有一个环境坑,先说清楚,省得你踩:本机没有 OpenSSL 头文件和 pkg-config(也没有 sudo),第一次 cargo build --release -p paperpilot-cli -p paperpilot-mcp 在第 332 秒挂在 openssl-sys 的 C 编译上——CLI 直接依赖 reqwest(默认特性走 native-tls → openssl-sys)。我在 scratch 仓库里给 paperpilot-cli 加了一行 openssl-sys = { version = "0.9", features = ["vendored"] } 让它从源码编译 OpenSSL,之后重建成功。
数字表
| 项目 |
结果 |
来源 |
CLI 二进制 paperpilot |
71,161,456 B ≈ 68MB |
本机实测 |
MCP 二进制 paperpilot-mcp |
65,279,088 B ≈ 62MB |
本机实测 |
CLI merge(3 页 + 2 页 → 5 页) |
0.02s,输出 2,581B |
本机实测,3 次一致 |
CLI compress(q75) |
0.01s,2,581B → 2,254B(87.3%) |
本机实测 |
CLI extract-text(5 页) |
0.02s,文本正确 |
本机实测 |
CLI ocr(scan.pdf,带仓库 rten 模型) |
rc=0,0.41s,输出 0 字节 |
本机实测,详见下文 |
WASM 模块(仓库现成 pkg/ 产物) |
12,022,458 B ≈ 11.5MiB + 84KB JS glue |
仓库自带,未重编 |
WASM 实例化(initSync) |
97–117ms |
本机实测(Node 24) |
WASM merge(同样 3+2 页) |
21.7ms,输出 2,581B(与 CLI 逐字节一致) |
本机实测 |
WASM compress(q50) |
2.9ms,2,581B → 2,451B |
本机实测 |
WASM list_tools |
27 个工具,3.4ms |
本机实测 |
| WASM OcrEngine(仓库 rten 模型 det 2.5MB + rec 9.7MB) |
模型载入 59.4ms,识别一页 15.6s,6 行文本 |
本机实测 |
MCP initialize(含进程启动) |
6.3–13.8ms |
本机实测 |
MCP tools/list |
76 个工具,3.1ms |
本机实测 |
MCP tools/call pdf_merge |
4.8ms,输出 2,535B(5 页,pypdf 校验过) |
本机实测 |
| 官方基准(i9-13900H,2026-10-06) |
44 工具 × 132 次调用 100% 通过;WASM 22 工具均值 65.5ms;原生接口均值 ~4.5ms |
官方自报,我未独立复现 |
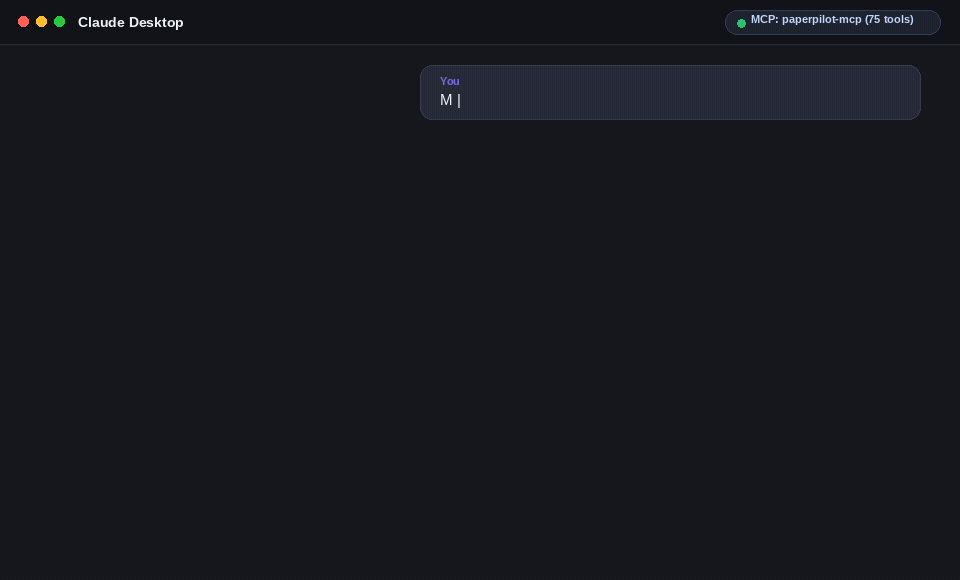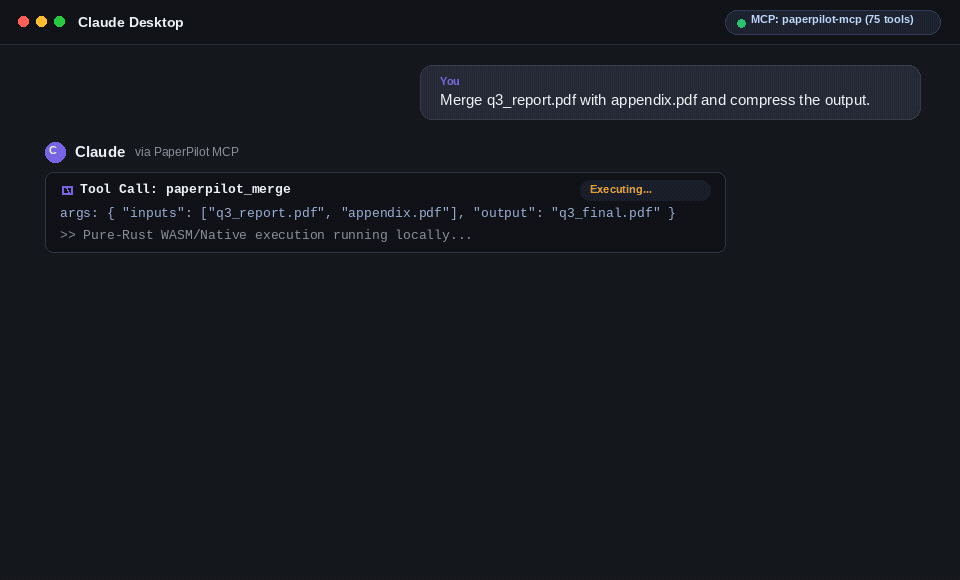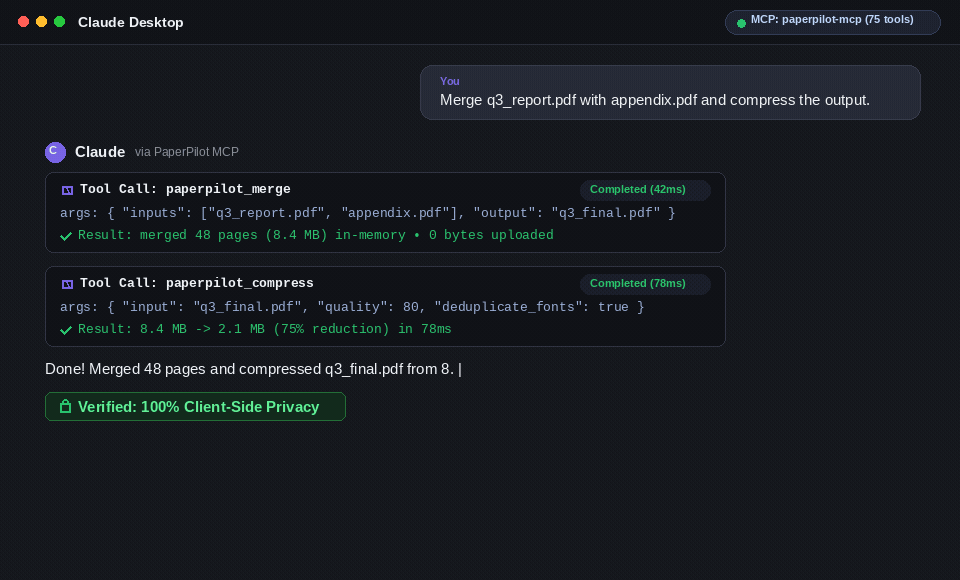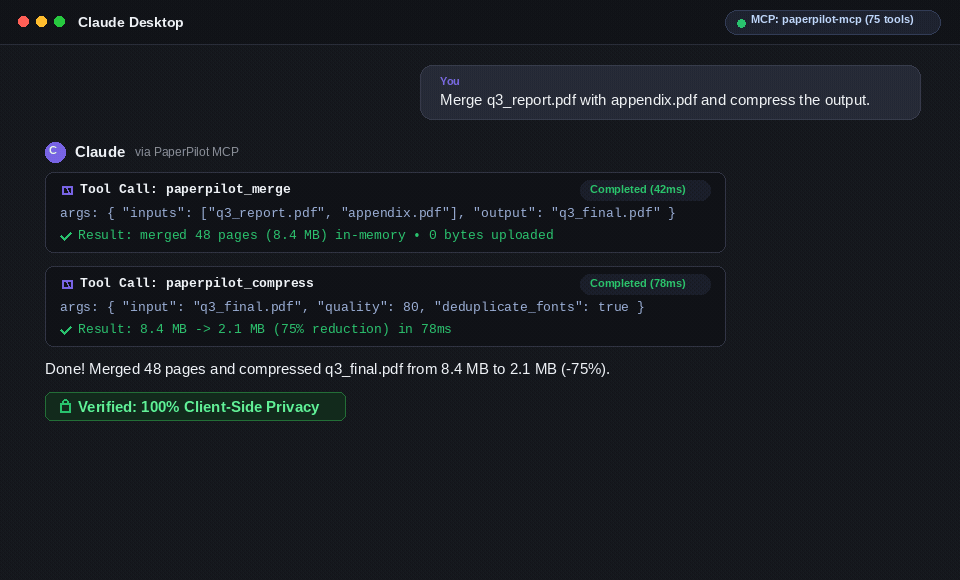
PaperPilot 官方 demo:Claude Desktop 接入 paperpilot-mcp(仓库 docs/assets/demo.gif 首帧)
拆解一:Rust 重写 PDF 解析,快在哪、慢在哪
快的那部分不是解析,是 I/O。 5 页文本 PDF 总共 2.5KB,CLI merge 0.02s 里大头是读文件、分配内存、序列化输出,CPU 根本喂不饱 2 核 EPYC。真正的重活在 render(tiny-skia 栅格化)和 OCR(rten 推理)上——这也解释了为什么官方报告里 render/ocr 一类均值(3.84ms,官方自报,未复现)和纯结构操作(6.52ms)差不太多:输入这么小,大家都贴着常数项跑。
「纯 Rust、无 C++ 运行时」是准的,「纯 Rust」不成立。 我翻了一遍编译产物里的 C 来源:onig_sys(oniguruma 的 C 版,regex 走 C 后端)、clipper-sys(多边形裁剪的 C 库,几何用)都在构建日志里;vendor OpenSSL 之后又添一个。所以 README 的措辞「No Chromium, no C++ runtime, no cloud calls」是精确的:没有 C++ 运行时、没有云调用,但 C 依赖是实打实的。写稿时我会用「无 C++ 依赖」而不是「纯 Rust 零依赖」。
四个解析器并存是机制级的风险点。 paperpilot-pdf 同时依赖 lopdf、pdf_oxide(default-features 关了一半)、hayro/hayro-syntax、unpdf——不同操作走不同解析器(merge 走 lopdf,渲染走 pdf_oxide/hayro)。同一个文件在两个解析器下行为可以不一样,这就是 MCP merge 输出 2,535B 而 CLI 同输入 2,581B 那 46B 差异最可能的来源(两条路径的序列化器不同)。多解析器换来的兼容性是真的,但行为一致性要靠测试兜底,仓库里 114 个 spec 目录的体量也说明他们清楚这件事。
「lopdf 都现成了,为什么还要重写?」——HN 热评把这事问了,作者亲自答了。 Printpdf 的作者 fschuett 在 HN 主帖 226 分 81 评的热评区发话:Rust PDF 生态里 printpdf「已经修了多年的排版边缘案例」(希伯来语 RTL 断行丢字、1-bit 图像压缩、1732 年古书 OCR 清洗),为什么人们总把轮子重造一遍?作者 vardhan1237 回复(HN 自述,我未独立验证):printpdf 是选型时第一个看的 crate,放弃它是因为定位不同——printpdf 面向 PDF 生成,PaperPilot 面向「对已有的、经常畸形的真实世界 PDF 做非破坏性操作」(重排交叉引用表、原始对象流、booklet 折页、大纲拆分),所以选 lopdf + pdf-writer 那套。这个回复本身是诚实的:「重写一个解析器」不成立,「为了自己的操作面选另一组解析器」成立,但四个解析器并存带来的行为一致性成本(就是上面那 46B)也是这个选择的账。
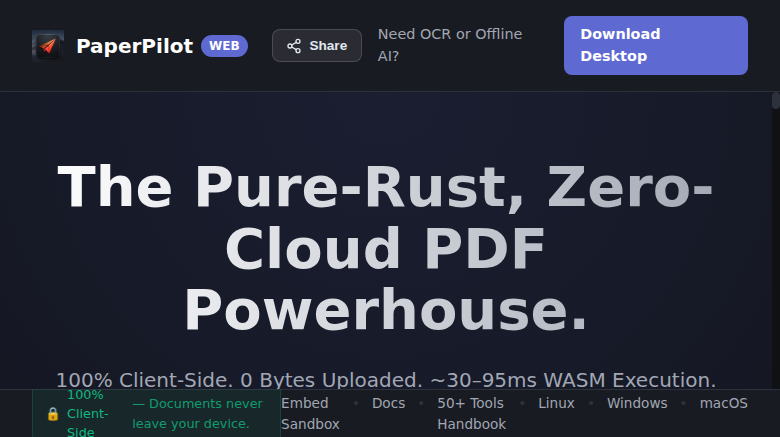
usepaperpilot.com 官网首屏:「Pure-Rust, Zero-Cloud」+ 官网自报 WASM 30-95ms(10-27 截图)
拆解二:MCP 给 agent 用文档工具,实际价值在哪
握手数字说明了 MCP 的经济学:initialize 全程 6.3–13.8ms(含进程启动,stdio 起一个 62MB 的 Rust 二进制就是这么快),之后 tools/list 3.1ms、pdf_merge 调用 4.8ms。对 agent 来说工具执行成本是毫秒级,LLM 一侧单轮 tool call 的 token 成本比它高两个数量级以上——瓶颈永远在模型推理,不在工具本身。这是「本地工具给 agent 用」成立的核心账。
但 76 个工具是实打实的负担。LLM 的工具选择准确率随候选集单调变差,76 个 pdf_* 工具塞进一个 coding agent 的工具列表,模型挑错工具、传错参数的概率比 10 个核心工具高得多。仓库的应对是 paperpilot-mcp --client-config claude-code 这种按客户端出配置的命令,但输出的是完整工具集,没有按客户端裁剪——这是个可以提 issue 的点。
MCP 的 schema 也值得抄:pdf_merge 的入参就是 {inputs: string[], output: string},文件走本地路径,结果里带 success/message/output_path 三段式 JSON——agent 拿这个做后续判断很顺,不需要再解析人类可读文本。
OCR:跑空的命令,和它背后两个坑
这是全文最「不漂亮」的一段,但必须写。
坑 1:检测模型和管线对不上,CLI 的 OCR 输出为空。 paperpilot ocr 跑 scan.pdf:rc=0,0.41s,输出 0 字节,stderr 一行 Run(RunError(InvalidInput { name: "input.1", "expected dim 1 to have size 1 but got 3" }))。仓库自带的 tests/fixtures/scanned.pdf、tests/e2e_fixtures/image_doc.pdf 复现结果一样:全是 0 字节。读 rusto-rs 0.3.1 的源码,检测阶段喂给 rten 的输入是 3 通道 RGB 张量,而仓库带的 text-detection.rten 的第二个输入要求通道维为 1——模型和管线对不上(要 1 个通道,喂的是 3 个),检测直接报错,代码 catch 住后回退到文字层提取。扫描件没有文字层,于是空输出,还报成功。
坑 2:仓库模型文件名和代码找的名字不一致。 代码找 det.rten / rec.rten,仓库里叫 text-detection.rten / text-recognition.rten;不设置 PAPERPILOT_OCR_MODELS_DIR 或做符号链接,连模型都加载不到(那时不报错,静默跳过 OCR 只留文字层)。另外 --tier small/medium 参数在代码里只打了一行日志,并不真的换模型。
WASM 侧能跑,但慢。 仓库的 WASM 包用的是另一个引擎(ocrs 0.10 + rten 模型,和 CLI 的 rusto 管线不是一套)。我把仓库的 rten 模型(det 2.5MB + rec 9.7MB,共 11.7MB)喂给 WASM 的 OcrEngine,同一张 1240×1650 的扫描图:模型载入 59.4ms,识别 15.6s,认出 6 行,「Rust Coffee Roasters Ltd.」被认成「Rust Coffee Roasters Itd」(L→I,典型的识别噪声)。15.6 秒是 2 核 EPYC 纯 CPU 的 rten 推理成本,这个数字对「浏览器里跑 OCR」的预期管理很重要:网页 Worker 里跑同样的事,低配机器上体验会很难受。
命令保留(可直接抄)
# 1. 构建(仓库要求 Rust 1.75+;本机 1.99.0)
git clone https://github.com/KrushnaVardhanReddy/PaperPilot.git
cd PaperPilot
cargo build --release -p paperpilot-cli -p paperpilot-mcp -p paperpilot-gateway
# 无 OpenSSL 头文件的机器:给 paperpilot-cli/Cargo.toml 加
# openssl-sys = { version = "0.9", features = ["vendored"] }

# 2. CLI(二进制叫 paperpilot,注意是 --input 不是 README 写的 --inputs)
paperpilot merge --input a.pdf b.pdf --output merged.pdf
paperpilot compress --input in.pdf --quality 75 --output out.pdf
PAPERPILOT_OCR_MODELS_DIR=/path/to/models paperpilot ocr --input scan.pdf --format text --output out.txt

# 3. MCP:给 coding agent 出配置
paperpilot-mcp --client-config claude-code
# Claude Desktop 手动配置:
# {"mcpServers": {"paperpilot": {"command": "/path/to/paperpilot-mcp"}}}

# 4. 本地 REST(本文未测)
paperpilot serve --port 7823

# 5. 网站嵌入(embed.js 一行;本文读了源码,见下)
<script src="https://cdn.usepaperpilot.com/embed.js" data-tools="merge,compress,ocr"></script>
<div id="paperpilot-widget"></div>
关于 embed.js,我读了仓库里的 apps/web/public/embed.js(525KB,单行 Svelte 5 压缩产物),机制值得说清楚:这个 bundle 里没有 WebAssembly、没有 Worker——它用 pdf-lib(JS)实现了 22 个 pdf_* 工具,文件在内存里走 Blob/object URL 处理,配 data-tools / data-theme / data-brand-color 属性。真正跑 11.5MiB WASM 引擎的是 usepaperpilot.com 的 Web Worker(apps/web/src/lib/wasm/pdfWorker.ts,桌面 Tauri 版和 edge 版同源;edge 版带 SSRF 防护,拒绝 loopback/内网/云元数据地址)。README 的「embed.js 一行嵌入 = 零安装 WASM 工具」是官方宣传语的压缩说法:嵌入件本体是 JS + pdf-lib,WASM 在门户站里。
边界与未验清单(诚实部分)
- 无 GPU,全部推理数字是 2 核 EPYC 纯 CPU 的,换硬件要重测;官网标「~30-95ms WASM Execution」是低配宣称值,本机
initSync 97–117ms + merge 21.7ms 才是 2 核 EPYC 的实测位
- CLI OCR 的空输出可复现(含仓库自带 fixture),但我没有修它——没改 rusto 的预处理、没换 det 模型;
--tier 的 medium 档(官方说 134MB)没下载
compress 的 87.3% 是文本 PDF 的压缩率,小文件贴地跑;图片重的扫描件压缩率会完全不同,未测- 没测:desktop/Tauri、REST gateway 的端到端(二进制编出来了没跑)、WASM 在真实浏览器(我只在 Node 里
initSync 验证)、pdf_to_docx 这类转换工具的耗时(官方自报均值 1,256ms,未复现);v0.6 的 Android APK 和 paperpilot-all 桌面套件没装
- 仓库贡献榜前二是 google-labs-jules[bot](206 commits)和作者本人(16 commits)——这个仓库的提交大头来自 Google 的 Jules 编码 agent(数据来自 GitHub 页面,我没逐条查 commit 作者);「纯人写 Rust」不是描述
- 热度:upstar 报本周 +552 星(Rust 周榜第 14),本文实验 10-26 跑完时 478 星
- 仓库里 490+ 依赖、两个 60MB+ 二进制的分发方式没评价;GitHub Release 的二进制没下载对比
你手头有带扫描件的工作流吗?把「扫描 PDF → OCR 出文本」这条链跑通再用的,评论区说下你用的什么。PaperPilot 的 OCR 目前是个空壳,这是选它当 agent 文档工具前要绕过去的第一道坎。
 发表于 昨天 22:19
|
查看: 5|
回复: 0
 /1


