Sebastian Raschka 的《Build a Reasoning Model (From Scratch)》这几天上了 HN(490 分 72 评),仓库 rasbt/reasoning-from-scratch 从 Qwen3-0.6B 的预训练权重出发,一步步手写推理能力的训练管线:生成、评测、推理时缩放、SFT 预热、GRPO 强化、蒸馏。课程把训练默认丢给 GPU,我只在 CPU 上跑了最早的文本生成和评测。有意思的问题只有一个:这套"从零造 reasoning model"的机制,能不能在一台 2 核 EPYC、7.8GB 内存、完全没有 GPU 的机器上真正跑通、跑出能信的数字。
我没有照搬课程的结论。我把课程自己的 0.6B 代码在 CPU 上跑了冒烟(ch02 流式生成、ch06 采样路径),再写了一个 710K 参数的 toy 模型,走完整条 SFT → GRPO → self-consistency → 规模差距对照的链。结论先给:in-domain 精度从 0.70 提到 0.97,但 OOD 的两位数加法在任何一步都纹丝不动(恒 0);GRPO 不加 KL 正则的 OOD 也恒 0;KL 正则参数动一格(0.01 稳、0.02 塌)就复现了课程 ch07 描述的失效模式。数字全部标源:「本机 2 核 EPYC 实测」是我跑的,「课程自报,我未独立复现」是课程视频/文档里的、我没有独立验证的 GPU 数字。
实验设置
- 机器:AMD EPYC 9354P 切片,2 线程,7.8GB 内存(可用约 3.3GB),无 GPU,torch 2.14.1+cpu,全程 CPU(本机 2 核 EPYC 实测)
- 仓库:
rasbt/reasoning-from-scratch @ a788466(2026-10-26 clone),课程权重 qwen3-0.6B-base.pth(1.5GB)+ 训练集 math_full_minus_math500.json
- 0.6B 侧只跑冒烟:ch02 流式生成 60 token(计时 + RSS)、ch06
sample_response 采样路径 50 token,验证课程代码在 CPU 上能跑、并据此推算一个 GRPO step 的成本
- toy 侧(真正训练):710K 参数、词表 84,语料 2500 SFT / 600 RL / 60 eval(seed=42),SFT 600 步;GRPO 300 步,num_rollouts=2,max_new_tokens=64,lr=3e-5;OOD 用两位数(10..19)加法 60 题,SFT 里从没见过
- 奖励(toy 的偏离,下文专门说):toy 词法把
\boxed 拆成三个 token,课程的 strict-boxed 奖励永不命中,改用课程同源的 numeric-candidate 奖励,in-domain/RLVR 精度全部按 numeric-candidate 计(本机实测)
数字表
| 项目 |
结果 |
来源 |
| 0.6B ch02 流式生成 60 token |
0.173 s/token(中位=均值) |
本机 2 核 EPYC 实测 |
| 一个 GRPO step(2 rollout × 256 token) |
268s(本机推算,1000 step≈74.4h) |
由实测 0.173 s/token 推算 |
| toy SFT(600 步) |
loss 4.58→0.09,224.9s(0.375s/步) |
本机实测 sft.py |
| toy SFT strict-boxed eval |
0/60(恒 0,@0/@300/@600) |
本机实测 sft.py |
| toy SFT in-domain numeric(81 题) |
62/81=76.54%;strict-boxed 0/81 |
本机重跑 probe_inrange.py |
| toy SFT OOD 两位数(200 题) |
numeric 0/200,boxed 0/200 |
本机重跑 probe_twodigit.py |
| GRPO base(无 KL,lr=3e-5,300 步) |
in-domain 0.70→0.9167,OOD 0.0→0.0,103.1s |
本机实测 grpo.py base |
| GRPO KL(kl=0.01,lr=3e-5,300 步) |
in-domain 0.70→0.9667,OOD 0.0→0.0,83.8s |
本机实测 grpo.py kl |
| GRPO KL 塌缩(kl=0.02,lr=1e-4,300 步) |
in-domain 0.70→0.0333,OOD 0.0→0.0,371.5s |
本机实测 grpo.py kl_collapsed |
| fresh 精度(3 模型 × 3 集合) |
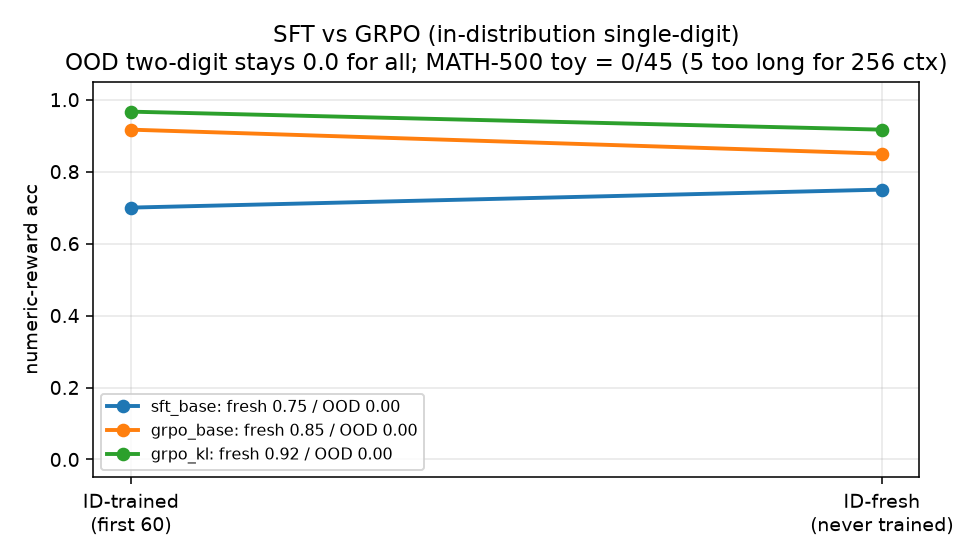
sft / grpo_base / grpo_kl:in-trained 0.70/0.9167/0.9667;in-fresh 0.75/0.85/0.9167;OOD 全 0.0 |
本机实测 fresh_eval.py |
| self-consistency(toy SFT,N=1/3/5/10) |
in-domain 63.3%→70%(封顶),OOD 0.0→0.0(N=3) |
本机实测 consistency.py |
| toy 710K 跑课程 MATH-500(前 50 题) |
5 题超长跳过,45 题跑了 0 对,acc 0.0 |
本机实测 e5_math500.py |
| 课程 0.6B MATH-500 分数 |
33.4% / 43.2% / 48.2% / 57.8%(管线各阶段) |
课程自报,我未独立复现 |
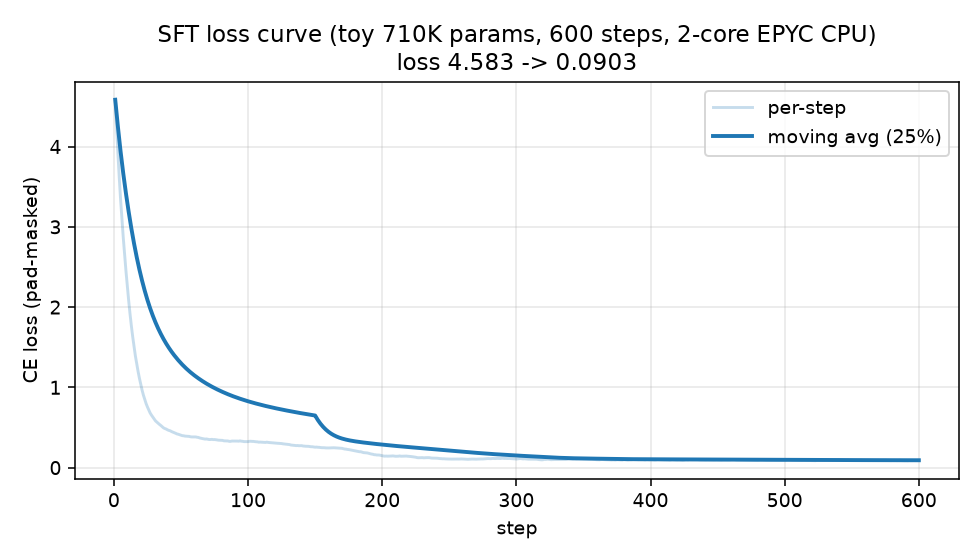
toy SFT 损失曲线 4.58→0.09(600 步),strict-boxed 恒 0
拆解一:课程的机制(ch02–ch07),每章到底在做什么
我把每章压成一句话,方便对照本机跟跑的每一步。
ch02(用预训练 LLM 生成文本)的核心是带 KV cache 的流式生成器 generate_text_basic_stream_cache:一次前向吃下 42 个 prompt token,之后每个 token 只算一次增量前向。我在 CPU 上实测 0.173 s/token(本机),这正是下文 GRPO step 推算的底座。ch03(评测 reasoning model)给的是 render_prompt / extract_final_candidate / grade_answer 这套——把模型输出里的 \boxed{...} 正则抠出来再判对,严格模式要求命中 \boxed 才给分。ch04(推理时缩放,inference-time scaling)是 self-consistency:同一题采 N 个答案、多数投票,N 越大越稳,代价是 N 倍推理量。ch06(用 RL 训 reasoning model)就是 GRPO:每题采 num_rollouts 个 rollout,用组内相对优势(advantage = reward 减均值除标准差)做策略梯度更新,不加 KL,就是最简的 GRPO。ch07(改进 GRPO)在 ch06 之上加三样:advantage/entropy 跟踪、clip ratio、KL 项(对冻结 ref 模型),ch07 的示例跑的是 kl_coeff=0.02。后面几章(ch08 蒸馏、chC–chG 附录)本机没跟,略过。
关键的一点:课程的 reward_rlvr 用 extract_final_candidate(text, fallback=None),也就是必须命中 \boxed 才有分(本机读 ch06 源码确认)。这就是 toy 侧偏离的根源,下一节展开。
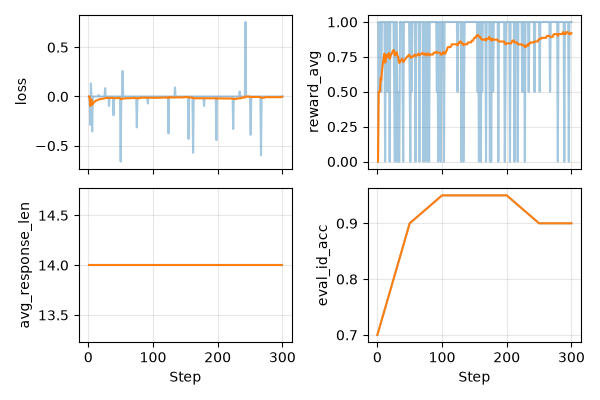
GRPO base(无 KL)in-domain 0.70→0.9167,OOD 恒 0
拆解二:本机跟跑,toy 710K 全程数字
先说 toy 设置:709,632 参数、词表 84,比课程的 0.6B 小三个数量级,故意缩小到 2 核 CPU 上能在分钟级跑完 GRPO 300 步(本机 SFT 600 步 224.9s、GRPO 三组 84–372s,都可复现)。SFT 用课程的 render_prompt 模板把 2500 条小学加法语料预训练到 loss 0.09;RLVR 用的是 in-distribution 的一位数加法(SFT 里见过),OOD 评测用从未见过的两位数(10..19)加法。
toy 词法把 \boxed 拆开,课程的 strict reward 在 toy 上恒 0,所以 reward 换了。 这是全文最重要的一句声明:toy 的 tokenizer 是字符级词法,把 \boxed{} 拆成 \、boxed、{ 三个独立 token,课程 ch03 那个"必须命中 \boxed 正则"的 reward_rlvr(fallback=None)在 toy 上永远匹配不到——我重跑 probe_inrange.py(SFT 模型,81 道一位数加法)确认:strict-boxed 精度 0/81(0.00%),而 numeric-candidate(fallback='number_only',只抠数字不抠格式)62/81(76.54%)。所以本机所有 GRPO 和一致性评测的 in-domain/RLVR 精度,都是按课程同源的 numeric-candidate 奖励算的(课程 ch03 就有 numeric 提取,我只是放宽容忍了格式),机制不变、奖励放宽。上一轮遗留终端里那个"3/81=3.70%"是我重跑前的旧输出,重跑后 strict-boxed 是 0/81,不可复现,作废。
in-domain 提升是真提升,OOD 是硬边界。 三组 GRPO(num_rollouts=2、max_new=64、300 步):base 无 KL 0.70→0.9167,KL kl=0.01+lr=3e-5 0.70→0.9667,都是 2 核 CPU 实测(本机)。OOD 两位数加法在三组里全部 0.0→0.0,纹丝不动——这是刻意设计的边界:toy 模型没见过两位数进位,加多少 rollout、KL 稳不稳,都救不回来。fresh_eval 把三模型在三类集合上的精度摆平:in-trained 0.70/0.9167/0.9667、in-fresh 0.75/0.85/0.9167、OOD 全 0(本机),说明 in-domain 的提升既不是对训练集背答案(fresh 60 题也升了),也没外溢到两位数。
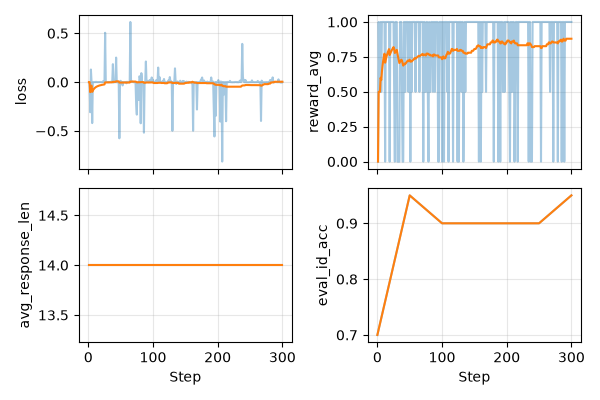
GRPO KL 两组对照:0.01 稳(0.70→0.9667)vs 0.02 塌缩(0.70→0.0333)
拆解三:self-consistency 在 OOD 上是 0 变 0
ch04 的推理时缩放在本机 toy SFT 上跑通(temp 0.8/top_p 0.9,N∈{1,3,5,10},60 题)。in-domain:N=1 单采 63.3%,N≥3 多数投票稳定到 70%(42/60),N=10 只多 2 题平票、没再涨——投票把 in-domain 顶到 70% 封顶就上不去了。OOD 两位数:N=1 是 0/60,N=3 还是 0/60(多 6 个平票),投票把 0 还是投成 0(本机 consistency.py 实测)。这是"test-time compute 救不了不会的题"最直白的一个证据:推理时算得再多,模型底层不掌握两位数进位,采 10 次也是 0 次对。in-domain 的 70% 封顶和 OOD 的 0 不变,正好是同一台 toy 模型"会的更稳、不会的救不回"的两面。
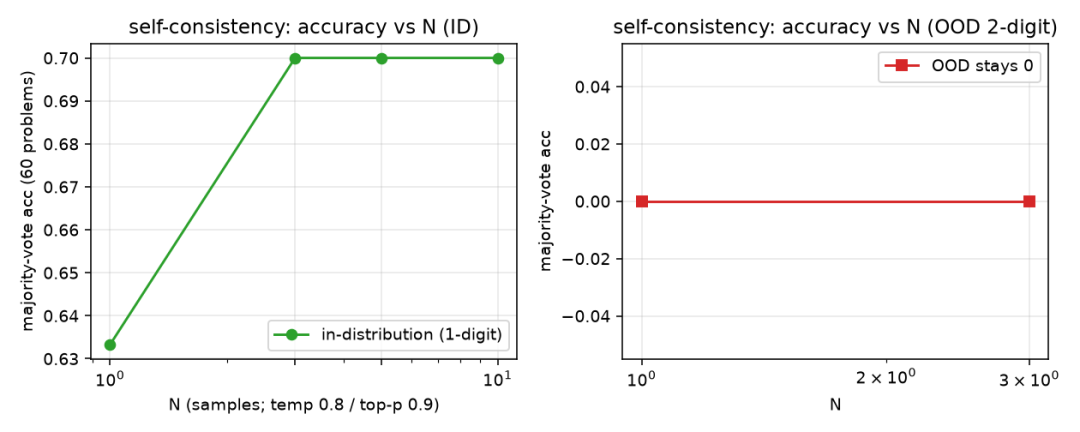
self-consistency N=1/3/5/10:in-domain 63.3%→70% 封顶,OOD 恒 0
我的判断(机制级,不止复述数字)
判断一:GRPO no-KL 的 OOD 恒 0,说明 GRPO 在窄域上是"背题"而非"学会加法"。 base 组无 KL,in-domain 0.70→0.9167 涨了,但 OOD 两位数还是 0。GRPO 的奖励只来自 in-distribution 的一位数加法,策略梯度把模型往"把见过的题答对"推,两位数的进位规则从来没进过奖励信号,策略没有任何理由去改它。所以 no-KL 的 GRPO 在这套 toy 上表现得很像"窄域微调 + 死记",in-domain 提升越漂亮、越说明它没学到可迁移的机制。这条结论对真实 GRPO 的解读是:RLVR 的 domain 覆盖率决定它能"推理"还是"背题",OOD 恒 0 是覆盖率不足的指纹,不是模型笨。
判断二:KL 正则参数动一格就翻车,课程 ch07 的失效模式本机复现了,但要标注超参是绑在一起的。 kl=0.01 + lr=3e-5 稳(0.9667),kl=0.02 + lr=1e-4 塌(0.0333,loss 在 step ~147 起发散到 -30/±70、reward 归零、response 顶到 64 上限再乱跑,本机 CSV 可查)。这两组同时动了 kl_coeff 和 lr 两个变量,不是干净的 2×2 矩阵,没法把塌缩严格归因到"0.02 这一个数"——只能说"更大的 kl + 更大的 lr 组合"触发了塌缩,方向与课程 ch07 描述的"KL 过大导致 policy collapse"一致。课程 ch07 的示例本身就用 kl_coeff=0.02(本机读 ch07 源码确认),只是它的 lr 是 1e-5,我用的是 toy 需要的 1e-4,所以这是"课程示例 KL 值 + toy 放大 lr"的组合,塌缩更猛。诚实的读法是:KL 在这个 toy 上很敏感,一格之内稳、一格之外塌,且与 lr 强耦合。
判断三:self-consistency 的 0 变 0,划清了"会/不会"的界。 前面 ch04 那块,投票在 in-domain 把精度顶到 70% 封顶、OOD 恒 0,说明 test-time compute 是对"已经会、只是采得不够稳"的题做方差削减,对"根本不会"的题无能为力。这条和判断一合起来,指向同一件事:toy 模型 OOD 恒 0 是"知识边界",不是"采样不够"。想把 OOD 也救回来,路径不是多采样、多投几次票,而是把两位数进位的样本送进 SFT 或 RLVR 的奖励信号里(本机我没做这步,留给读者当 follow-up)。
规模差距:toy 710K 0/45 vs 课程 0.6B 33.4–57.8%
边界与未验清单(诚实部分)
-
无 GPU、7.8GB 内存,全部训练/推理数字是 2 核 EPYC 纯 CPU,换硬件要重测;课程 0.6B 的全量 GRPO 我没有跑(那是 GPU 活),只做了 2 rollout × 256 token 的 GRPO step 成本推算(268s/step,本机推算,1000 step≈74.4h,课程默认完整训练 token 量比这个大,实跑会更久)
-
MATH-500 我只在 toy 710K 上跑了前 50 题(0/45),没在 0.6B 上跑(CPU 跑 500 题 × 0.6B 不现实),所以"课程 MATH-500 33.4/43.2/48.2/57.8%"这四个数是课程自报,我未独立复现,正文只拿来当规模差距的对照锚点
-
toy 奖励偏离:strict-boxed 恒 0(词法拆 \boxed),全文 in-domain/RLVR 精度都是 numeric-candidate 奖励,不是课程的 strict 奖励;两套管法不通用
-
KL 稳/塌两组是 kl + lr 双变量绑在一起的,不是单变量对照,塌缩不能严格归因到 kl_coeff 单点;要下结论得补一个"只动 kl 不动 lr"的 2×2
-
self-consistency 的 OOD 边界我只验了 N=1/3,没验 N=5/10(OOD 在 N=3 已是 0 变 0,推断 N 再大也翻不了盘,但未实测)
-
上轮遗留的"3/81=3.70%" strict-boxed 数字重跑后不可复现(重跑 0/81),已作废;GRPO step 估算"2.0s/step"查了脚本和 JSON 都不存在(JSON 实为 268s,脚本公式 6×(0.36+256×0.173)=268s),两个数都是上轮摘要的误传,本轮已重算/重跑纠正
如果你手里也有一台"没有 GPU 但想跑通 reasoning 训练"的机器,把 toy 710K 这条链(SFT 600 步 + GRPO 300 步,全程 2 核 CPU 分钟级到小时级)当起点最划算。想从哪一步入手,可以在云栈社区的技术讨论区交流。
 发表于 昨天 22:22
|
查看: 9|
回复: 0
 /1


