目录 📚
- 后端流程总览
- 各阶段展开与例子
- 后端优化什么
- 形式化:约束多目标优化
- 公式展开解读
- 目标之间如何互相制约
- 签核硬约束
- 形式化后能自动求解吗
- 为什么不能完全自动化
- 自动化能覆盖的范围
- AI在后端设计中的应用
- 成熟方案列举
- 当前较优的自动化方案
- 总结
1. 后端流程总览 🚀
后端设计通常从 RTL 代码 开始,到 GDSII 版图 结束。它把行为级描述转成可制造、可签核的物理版图。
值得注意的是,这个流程并不是单向的。后端一旦发现问题,经常要回退到布局、CTS,甚至回到前端修改 RTL。
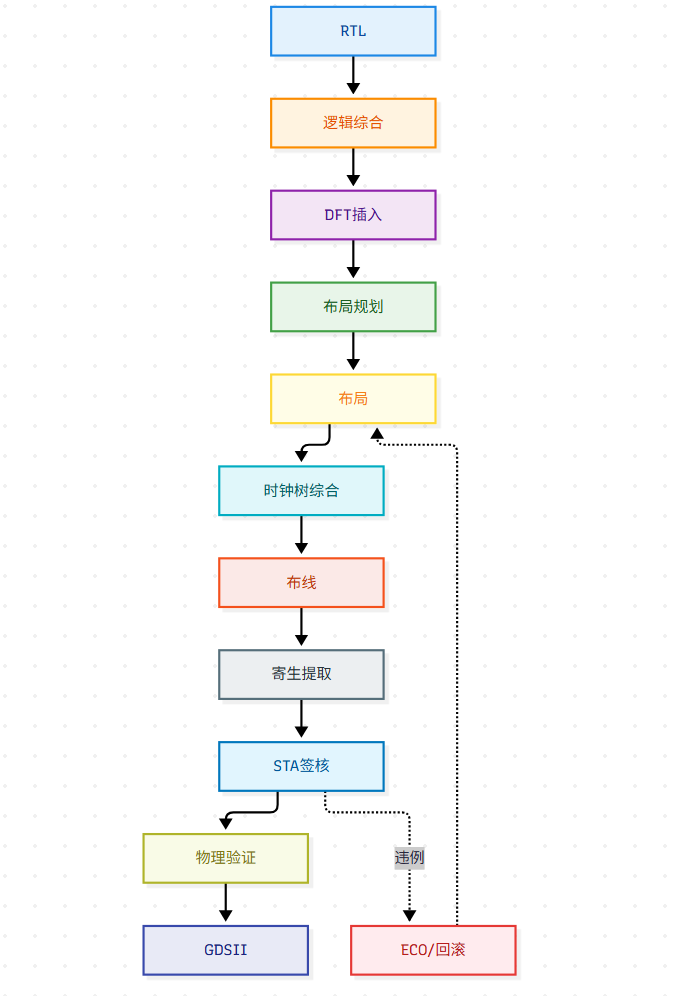
流程解读:
- 从 RTL 出发,依次经过逻辑综合、DFT 插入、布局规划、布局、时钟树综合、布线、寄生提取、STA 签核、物理验证,最终输出 GDSII。
- 如果 STA 发现违例,会走 ECO 或回滚路径,可能回到布局阶段重新迭代。
- 各阶段用不同颜色区分,便于识别流程节点类型。
下面再从数据流的角度看一遍。
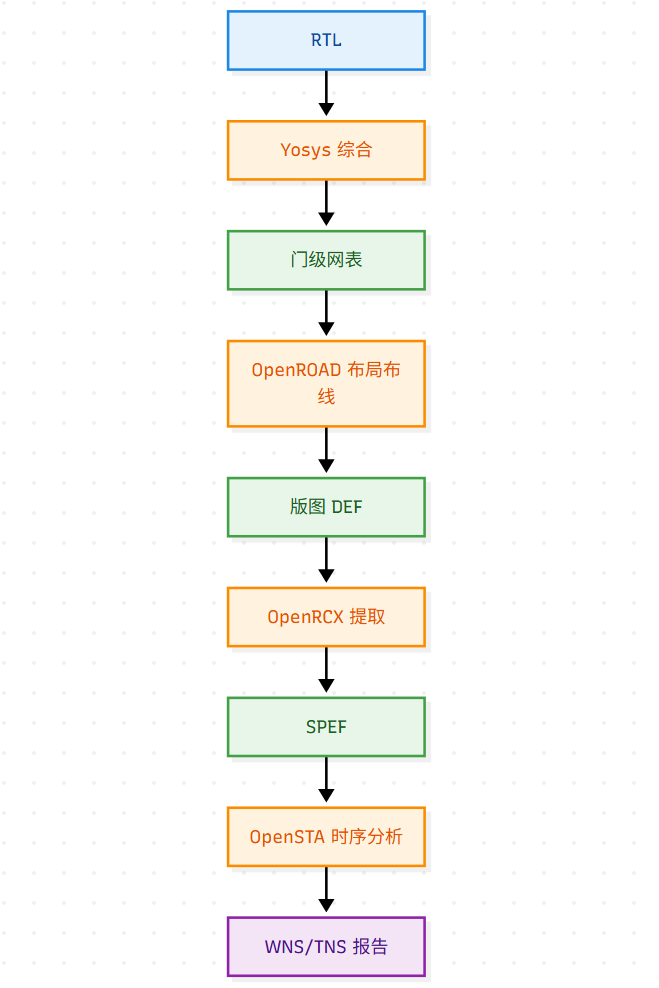
数据流解读:
- 输入是 RTL 代码,经 Yosys 综合后得到门级网表。
- 门级网表送入 OpenROAD 做布局布线,产出 DEF 版图。
- 版图经 OpenRCX 提取寄生参数,得到 SPEF 文件。
- SPEF 交给 OpenSTA 做时序分析,最终输出 WNS/TNS 报告。
2. 各阶段展开与例子 🔍
2.1 逻辑综合
输入:RTL、Liberty 库、SDC 约束。
输出:门级网表。
综合会把 always、assign 这类行为级代码映射成标准单元。比如一个 8 位加法器:
assign sum = a + b + c;
综合后可能变成全加器链、进位链和缓冲器。如果时钟周期很紧,综合会优先选低 Vt、大驱动单元。
2.2 DFT 插入
输入:门级网表。
输出:带扫描链的网表。
DFT 负责插入扫描链、测试压缩逻辑,保证芯片可测试。例如把普通触发器替换成扫描触发器,串成移位链。
DFT 会影响时序和面积。扫描使能、扫描时钟需要单独约束。
2.3 布局规划
输入:网表、LEF、面积目标。
输出:floorplan、电源规划。
布局规划决定宏单元、IO 位置和电源网格。比如 SRAM、PLL、模拟 IP 先摆好,标准单元区留出。宏单元如果摆得太远,关键路径的线延迟会明显变大。
2.4 布局
输入:floorplan、网表。
输出:标准单元坐标。
布局给每个标准单元分配合法位置。现代布局器常用解析布局,把单元当作电荷,通过力平衡完成分布。例如让关键路径上的触发器、加法器相互靠近,减少线长。
2.5 时钟树综合
输入:布局后设计。
输出:时钟树、缓冲器。
CTS 插入时钟缓冲器,平衡时钟偏斜。比如一个时钟要驱动一万个触发器,直接相连会导致延迟大、偏斜大。CTS 会建立 H 树或平衡树,让时钟到达时间尽量接近。
2.6 布线
输入:CTS 后设计。
输出:金属线、过孔。
布线分为全局布线和详细布线:全局布线规划大致路径,详细布线确定每层几何形状。关键路径通常尽量走高层金属,因为电阻小,但过孔数量也会增加。
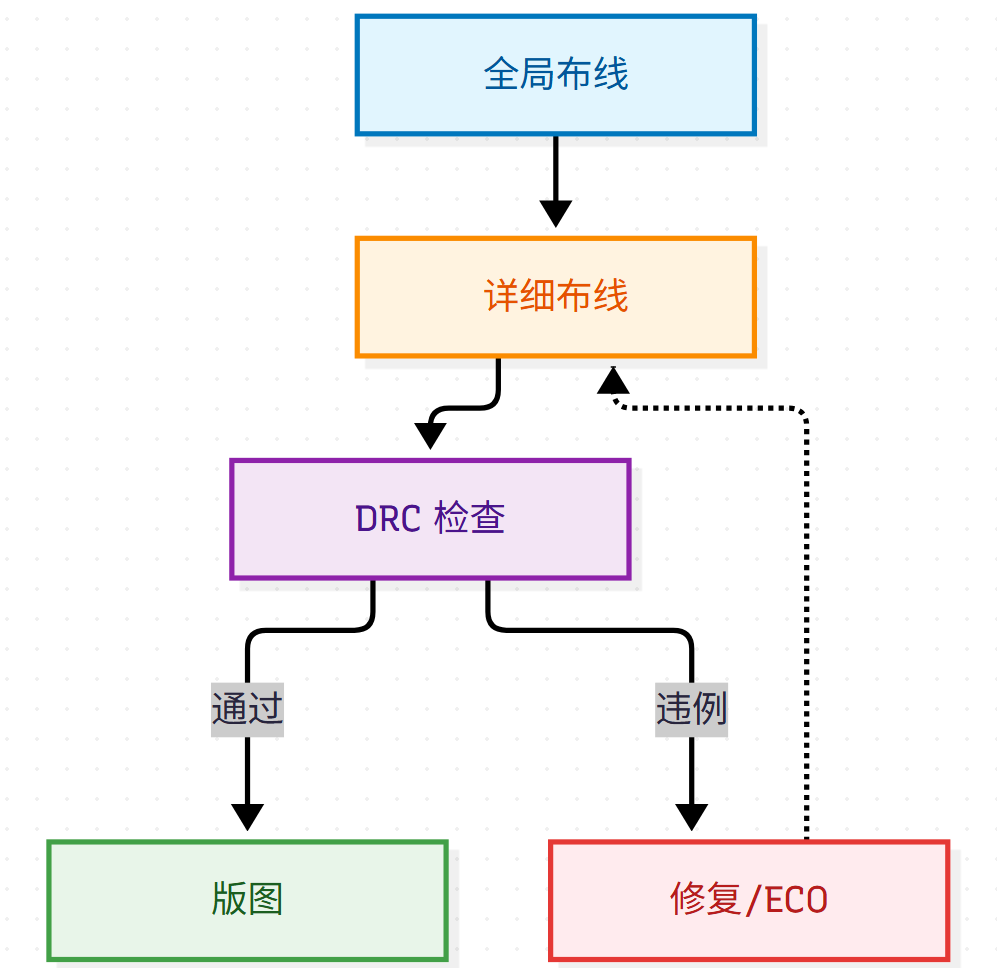
布线解读:
- 先做全局布线,再做详细布线。
- 详细布线后执行 DRC 检查。
- DRC 通过则输出最终版图。
- DRC 违例则进入修复或 ECO,再回到详细布线继续迭代。
2.7 寄生提取
输入:布线后版图。
输出:SPEF。
提取工具计算每根线的电阻、电容以及耦合电容。比如两条长线并行,耦合电容会让延迟变差。
没有 SPEF,STA 只能使用估算线延迟;有了 SPEF,STA 才具备签核级精度。
2.8 STA 签核
输入:网表、SPEF、Liberty、SDC。
输出:WNS、TNS、slack 报告。
STA 检查建立时间与保持时间。比如 WNS = −50 ps,说明最差路径还差 50 ps。
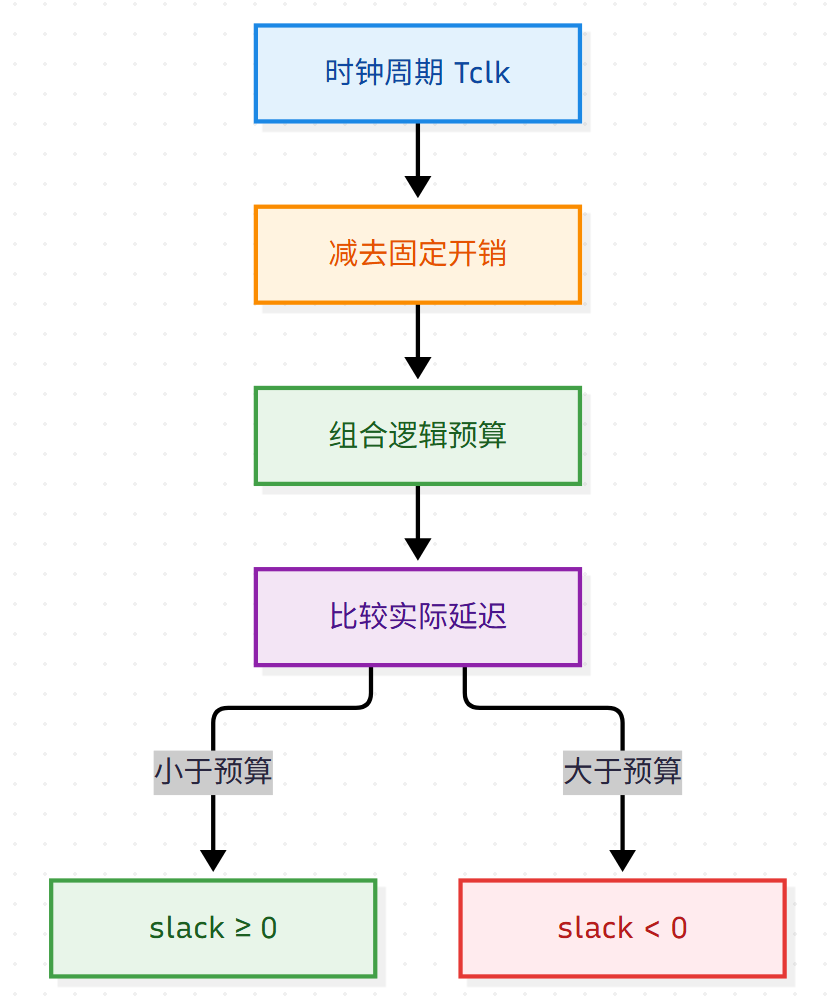
STA 解读:
- 从时钟周期出发,减去触发器、建立时间、偏斜、抖动等固定开销,得到组合逻辑预算。
- 将实际组合逻辑延迟与预算比较。
- 小于预算则 slack ≥ 0,时序满足。
- 大于预算则 slack < 0,出现时序违例。
2.9 物理验证
输入:GDS、网表。
输出:DRC、LVS、ERC、ANT 结果。
DRC 检查设计规则,LVS 检查版图与原理图是否一致。比如金属间距太小,DRC 会直接报错。
2.10 签核与 ECO
输入:所有验证结果。
输出:可流片 GDSII。
少量违例走 ECO,大量违例则回退布局甚至回前端。举个例子:STA 报 setup 违例,布线后线延迟增加,后端先尝试插 buffer、换低 Vt 单元;如果仍修不动,就需要反馈前端增加流水线级。
3. 后端优化什么 ⚖️
后端通常要在功能正确、时序、功耗、可靠性、可制造性等约束下,优化 PPA。
PPA = Performance、Power、Area。
三者经常相互冲突:
- 为了时序,可能要加大驱动、插 buffer,面积和功耗随之上升。
- 为了功耗,可能用高 Vt、降频,速度会变慢。
- 为了面积,可能减少 buffer,线延迟变长,时序变差。
- 为了修 Hold,又要插延迟单元,面积反而增大。
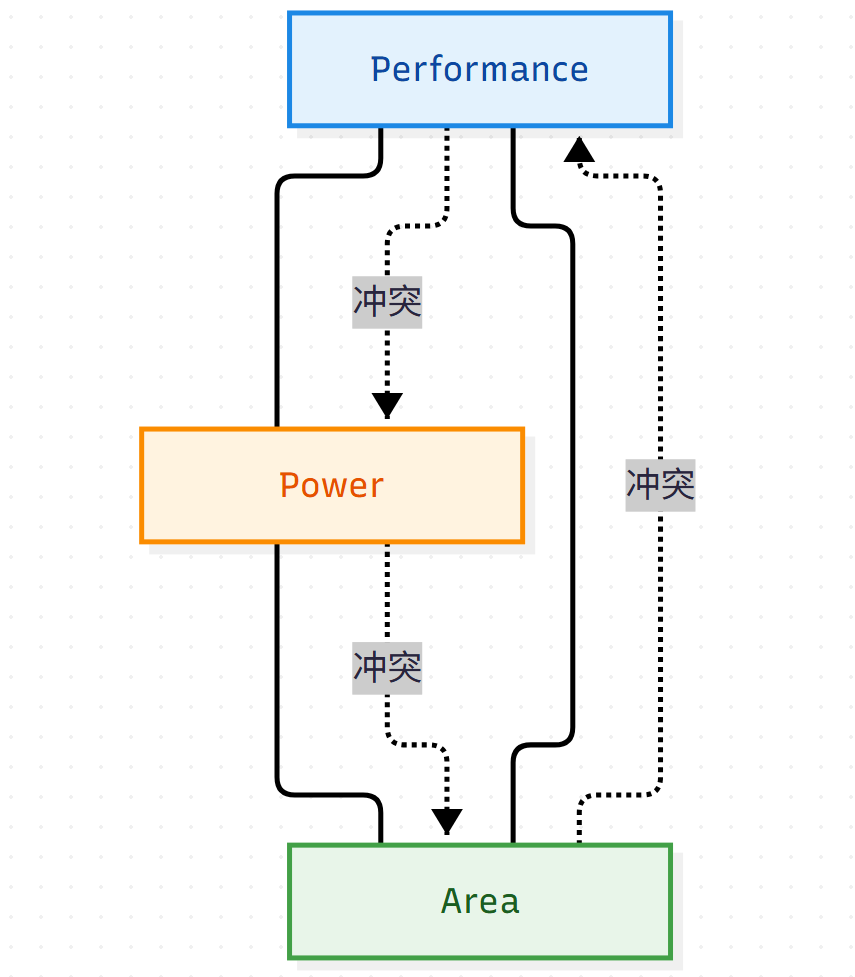
PPA 解读:
- Performance、Power、Area 三者两两之间存在冲突。
- 虚线表示冲突关系,实线表示三者被同时纳入考量。
- 优化其中一个目标,通常需要牺牲另外两个中的一个或两个。
| 目标 |
常见冲突 |
典型手段 |
| Performance |
功耗、面积 |
低 Vt、大驱动 |
| Power |
性能 |
高 Vt、降频 |
| Area |
性能、功耗 |
最小尺寸、少 buffer |
4. 形式化:约束多目标优化 📐
设设计变量为 (x),包括布局、单元尺寸、Vt、缓冲器、时钟树、布线层等。
目标可以写成:
[
\minx \; F(x) = \begin{pmatrix} P(x) \ A(x) \ -F{\max}(x) \end{pmatrix}
]
其中:
- (P(x)):功耗
- (A(x)):面积
- (F_{\max}(x)):最高频率
- 负号表示希望频率越大越好
约束通常包括:
[
si(x) \ge 0,\quad DRC(x)=0,\quad LVS(x)=0,\quad IR(x) \le IR{\max},\quad EM(x) \le EM{\max},\quad P(x) \le P{\text{budget}},\quad A(x) \le A_{\text{budget}},\quad x \in \Omega
]
时序裕量可以写成:
[
si = T{clk} - T{cq} - T{comb,i} - T{setup} - T{skew} - T_{jitter}
]
这就是后端设计的形式化框架:带约束的多目标优化问题。
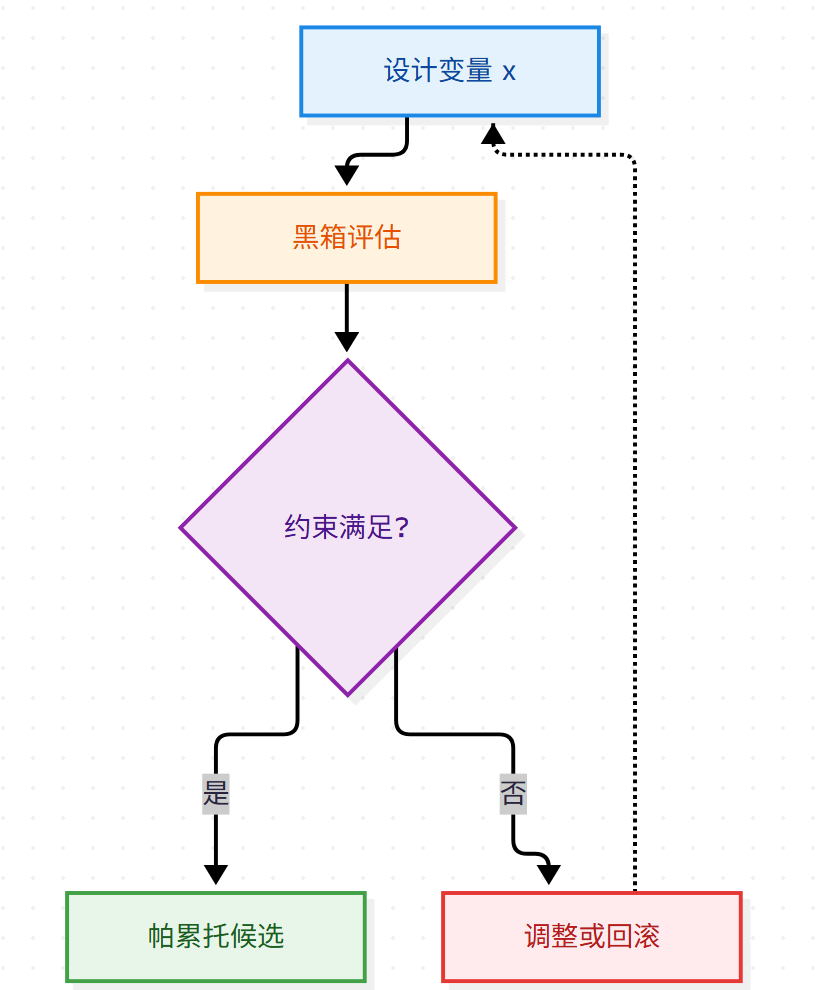
形式化决策流程解读:
- 从设计变量 (x) 出发,进入黑箱评估。
- 判断约束是否满足。
- 满足则成为帕累托候选。
- 不满足则调整或回滚,再回到设计变量重新迭代。
5. 公式展开解读 🔬
5.1 总目标函数
[
F(x) = \begin{pmatrix} P(x) \ A(x) \ -F_{\max}(x) \end{pmatrix}
]
这是一个多目标最小化问题。
- (x):设计变量。
- (P(x)):功耗。
- (A(x)):面积。
- (F_{\max}(x)):最高频率。
- (-F_{\max}(x)):把“最大化频率”转成“最小化负频率”。
(F(x)) 不是标量,而是一个列向量。因此它通常没有唯一最优解,而是得到一组帕累托解。
5.2 设计变量 (x)
(x) 不是一个数,而是一个超高维向量。它包含:
- 每个标准单元的位置
- 每个单元的尺寸
- 每个单元的阈值电压 (V_t)
- 缓冲器数量与位置
- 时钟树结构
- 每条线的布线层
- 宏单元位置
- 电源网格参数
可以写成:
[
x = (x_1, x_2, \ldots, x_n)^T
]
其中 (n) 可达数百万到数十亿。
这个搜索空间通常是离散的、非凸的,存在大量局部最优,而且没有梯度,所以不能直接用梯度下降求解。
5.3 三个目标
功耗:
动态功耗:
[
P_{\text{dyn}} = \alpha CL V{dd}^2 f
]
- (\alpha):翻转活动因子
- (C_L):负载电容
- (V_{dd}):供电电压
- (f):时钟频率
漏电功耗与阈值电压 (V_t) 强相关,通常随 (V_t) 降低呈指数上升。
面积:(A(x))
最高频率:(F_{\max}(x))
目标里写 (-F_{\max}(x)),是为了统一成最小化问题。
5.4 约束公式
逐条解释:
- (s_i(x) \ge 0):第 (i) 条时序路径裕量非负。
- (DRC(x) = 0):设计规则检查无违例。
- (LVS(x) = 0):版图与原理图一致。
- (IR(x) \le IR_{\max}):电压降不超过限值。
- (EM(x) \le EM_{\max}):电迁移不超过限值。
- (P(x) \le P_{\text{budget}}):功耗不超过预算。
- (A(x) \le A_{\text{budget}}):面积不超过预算。
- (x \in \Omega):满足物理和工艺限制。
DRC、LVS 通常不是连续函数,不能直接求导,只能作为过滤器或惩罚项处理。
5.5 时序裕量公式
[
si = T{clk} - T{cq} - T{comb,i} - T{setup} - T{skew} - T_{jitter}
]
逐项解释:
| 符号 |
含义 |
| (T_{clk}) |
时钟周期 |
| (T_{cq}) |
触发器 clock-to-Q 延迟 |
| (T_{comb,i}) |
第 (i) 条路径组合逻辑延迟 |
| (T_{setup}) |
捕获触发器建立时间 |
| (T_{skew}) |
时钟偏斜 |
| (T_{jitter}) |
时钟抖动 |
要求:
[
s_i \ge 0
]
等价于:
[
T{comb,i} \le T{clk} - T{cq} - T{setup} - T{skew} - T{jitter}
]
所以组合逻辑预算为:
[
T{\text{budget}} = T{clk} - T{cq} - T{setup} - T{skew} - T{jitter}
]
Hold 裕量通常写成:
[
Hi = T{cq} + T{comb,i} - T{hold} - T_{skew}
]
要求:
[
H_i \ge 0
]
6. 目标之间如何互相制约 ⚔️
6.1 设计变量 (x) 的两面性
(x) 包含很多参数,每个参数对不同目标的影响方向可能完全相反。
| 参数 |
对频率 |
对功耗 |
对面积 |
| 低 Vt |
变快 |
漏电增大 |
略增 |
| 高 Vt |
变慢 |
漏电减小 |
略减 |
| 大驱动单元 |
变快 |
动态功耗增大 |
面积增大 |
| 小驱动单元 |
变慢 |
动态功耗减小 |
面积减小 |
| 多 buffer |
线延迟改善 |
功耗增大 |
面积增大 |
| 少 buffer |
线延迟变差 |
功耗减小 |
面积减小 |
| 高层金属布线 |
电阻小,变快 |
差不多 |
资源占用 |
| 低层金属布线 |
电阻大,变慢 |
差不多 |
资源占用 |
| 宏单元放近 |
线延迟小 |
差不多 |
拥塞风险 |
| 宏单元放远 |
线延迟大 |
差不多 |
面积可能小 |
同一个参数,对三个目标的影响方向不同。这就是目标之间相互制约的根源。
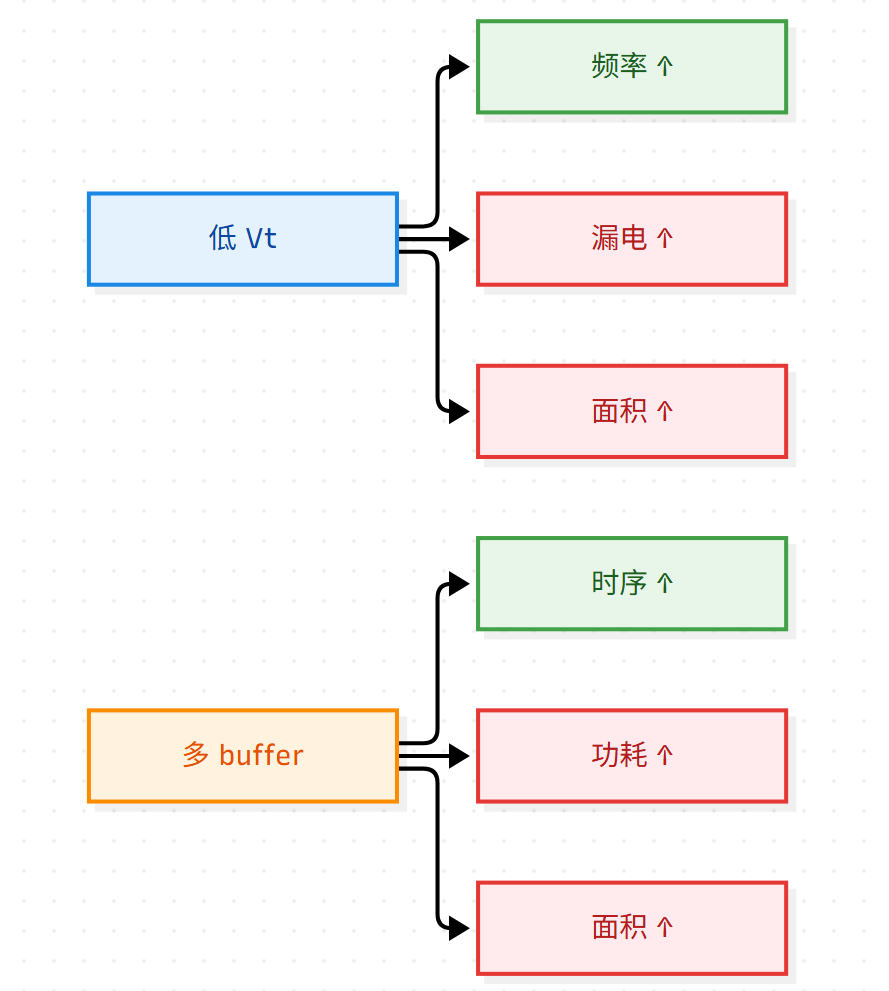
该图解读:
- 低 Vt 可以提升频率,但漏电和面积会增加。
- 多 buffer 可以改善时序,但功耗和面积会增加。
- 同一个参数往往同时带来正面和负面效果。
6.2 功耗与频率的制约
动态功耗:
[
P_{\text{dyn}} = \alpha CL V{dd}^2 f
]
频率越高,(P_{\text{dyn}}) 越大。漏电功耗方面,低 (Vt) 会让 (I{\text{leak}}) 指数上升。
想提高 (F_{\max}),常见做法包括降低 (V_t)、加大驱动、加 buffer、提高电压,而这些都会让功耗上升。
频率和功耗是直接对立的。
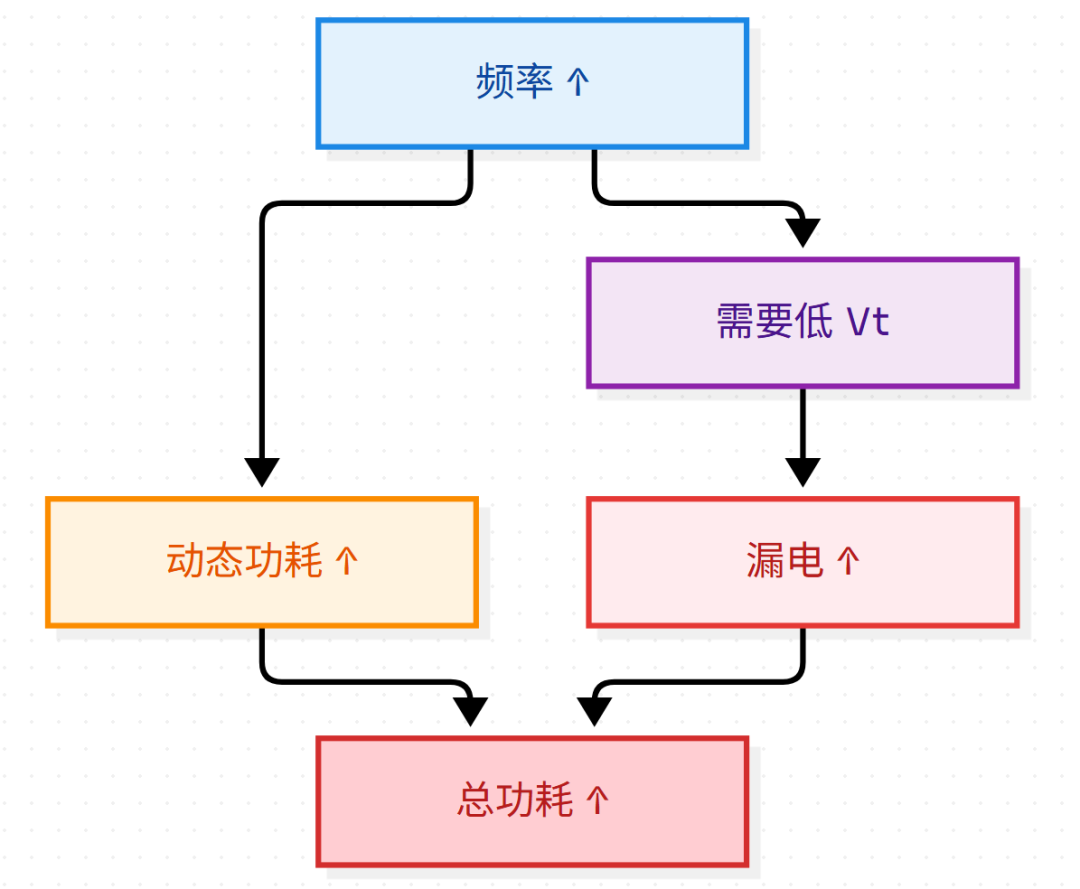
功耗传导解读:
- 频率提升会直接增加动态功耗。
- 为了提升频率可能需要低 Vt,这又会增加漏电。
- 动态功耗和漏电功耗一起推高总功耗。
6.3 面积与频率的制约
提高频率常用手段包括加大驱动单元、增加 buffer、使用低 Vt、复制寄存器降低扇出。这些都会增加面积。
- 大驱动单元:面积增大
- 多 buffer:面积增大
- 多电源网格:面积增大
想快,就要多花面积;想省面积,频率就会下降。
6.4 功耗与面积的制约
功耗优化常用手段:
- 高 Vt:漏电小,但速度慢
- 小驱动:动态功耗小,但慢
- 少 buffer:功耗小,但线延迟差
- 降频:功耗小,但性能差
面积优化常用手段:
省面积和降功耗方向经常一致,但有时也会冲突:面积压缩可能导致拥塞,绕线变长,动态功耗反而上升;修时序要插 buffer,功耗和面积同时上升;修 hold 要插延迟单元,面积和功耗也会上升。
功耗和面积有时同向,有时冲突。
6.5 Setup 与 Hold 的制约
Setup 裕量:
[
Si = T{clk} - T{cq} - T{comb,i} - T{setup} - T{skew} - T_{jitter}
]
Hold 裕量:
[
Hi = T{cq} + T{comb,i} - T{hold} - T_{skew}
]
两者方向正好相反:
- 修 setup 要让数据早点到,减少 (T_{comb,i})。
- 修 hold 要让数据晚点到,增加 (T_{comb,i})。
因此,插 buffer 修 setup 时,可能让 hold 变差;插延迟单元修 hold 时,又可能让 setup 变差。
Setup 和 Hold 是一对天然对立的约束。
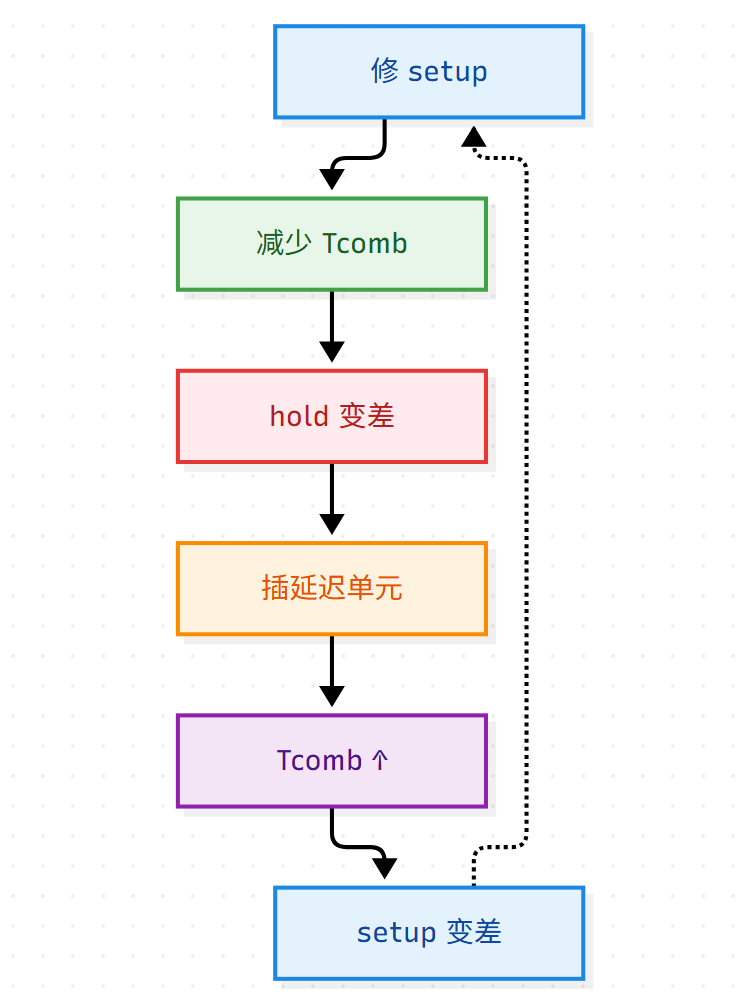
Setup/Hold 循环解读:
- 修 setup 通常要减少组合逻辑延迟。
- 减少组合逻辑延迟可能让 hold 变差。
- 修 hold 又要插入延迟单元,增加组合逻辑延迟。
- 这样 setup 可能再次变差,形成循环。
6.6 约束之间的连锁反应
改一个参数,会连锁影响多个约束。
例子:换低 Vt 修 setup
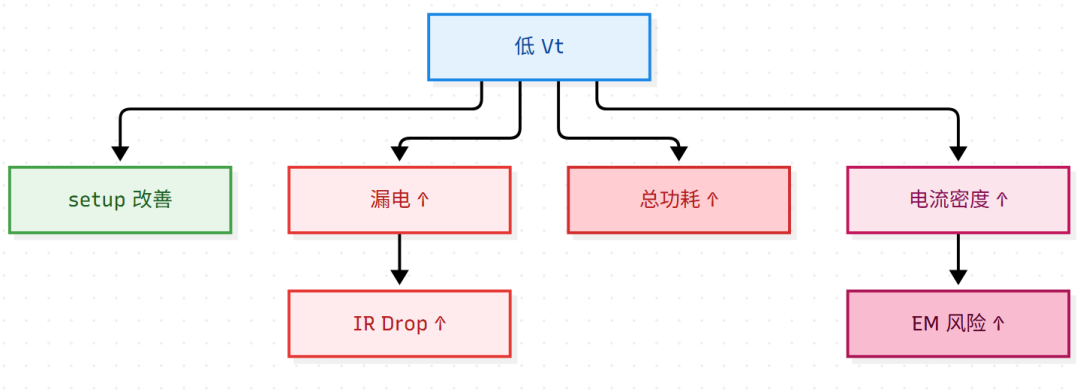
低 Vt 连锁解读:
- 低 Vt 可以改善 setup。
- 但会带来漏电、总功耗、电流密度上升。
- 电流密度上升会增加 EM 风险。
- 漏电上升也会加剧 IR Drop。
例子:加 buffer 修线延迟
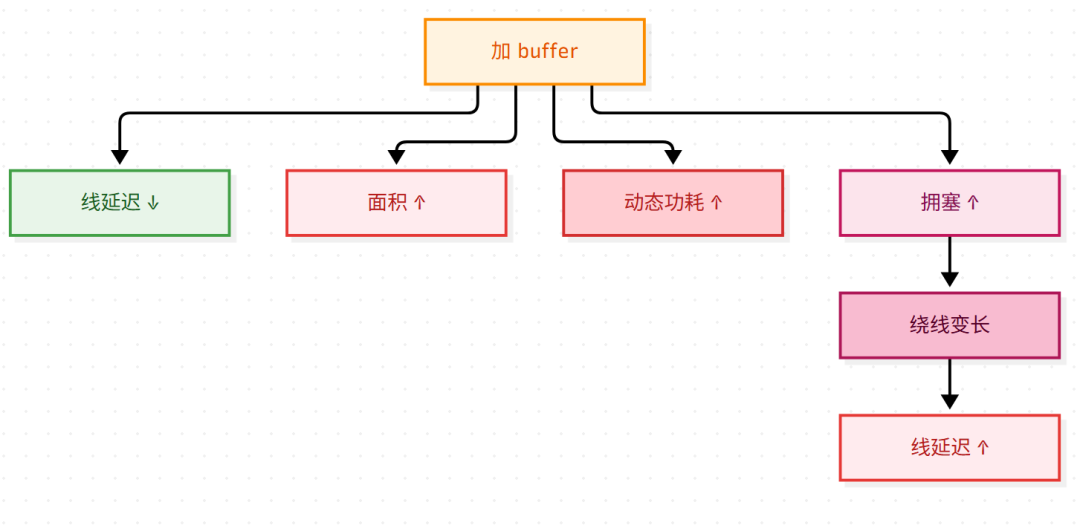
加 buffer 连锁解读:
- 加 buffer 可以降低线延迟。
- 但会增加面积、动态功耗和拥塞。
- 拥塞上升可能导致绕线变长,反过来又增加线延迟。
一个动作,多个后果。
6.7 参数方向冲突表
| 参数调整 |
频率 |
功耗 |
面积 |
时序 |
可靠性 |
| 低 Vt |
↑ |
↑ |
↑ |
↑ |
↓ |
| 高 Vt |
↓ |
↓ |
↓ |
↓ |
↑ |
| 大驱动 |
↑ |
↑ |
↑ |
↑ |
↓ |
| 小驱动 |
↓ |
↓ |
↓ |
↓ |
↑ |
| 多 buffer |
↑ |
↑ |
↑ |
↑ |
↓ |
| 少 buffer |
↓ |
↓ |
↓ |
↓ |
↑ |
| 降频 |
↓ |
↓ |
— |
↑ |
↑ |
| 升压 |
↑ |
↑ |
— |
↑ |
↓ |
| 紧凑布局 |
— |
— |
↓ |
↓ |
↓ |
| 宽松布局 |
— |
— |
↑ |
↑ |
↑ |
“↑”表示增大,“↓”表示减小,“—”表示影响不大。
几乎没有只改善一个目标而不影响其他目标的参数。
6.8 帕累托前沿的由来
正因为目标相互制约,所以不存在“全能最优解”,只能得到一组帕累托最优解:
- 想让频率更高,就必须牺牲功耗或面积。
- 想让功耗更低,就必须牺牲频率或面积。
- 想让面积更小,就必须牺牲频率或功耗。
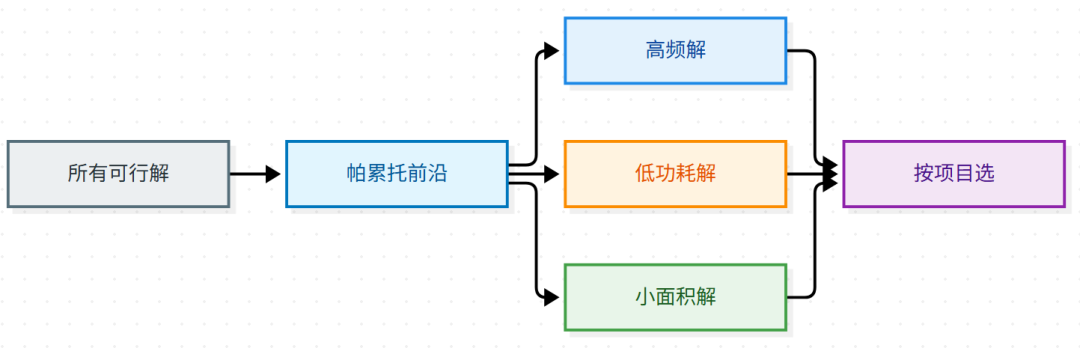
帕累托前沿解读:
- 所有可行解中,有一部分位于帕累托前沿。
- 前沿上有高频解、低功耗解、小面积解等。
- 最终按项目需求从这些解中选择一个折中。
7. 签核硬约束 ✅
无论目标怎么选,下面这些通常是硬约束:
- 时序:Setup/Hold slack ≥ 0,WNS/TNS 达标
- 物理验证:DRC = 0,LVS = 0,ERC = 0,ANT 通过
- 可靠性:IR Drop、EM 在限值内
- 功耗:不超过预算
- 面积:不超过 die 面积或成本限制
- 可测试性:DFT、扫描链正常
这些是“可流片”的底线。
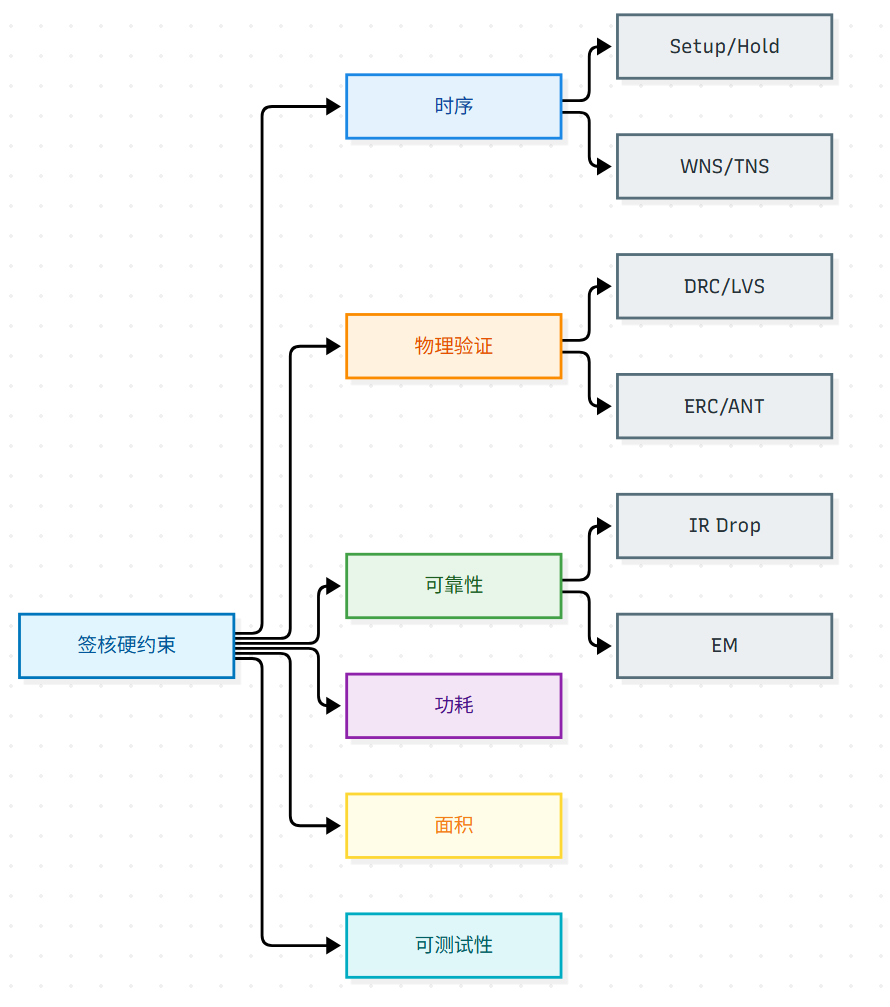
签核硬约束解读:
- 签核硬约束包括时序、物理验证、可靠性、功耗、面积、可测试性。
- 时序下分 Setup/Hold 和 WNS/TNS。
- 物理验证下分 DRC/LVS 和 ERC/ANT。
- 可靠性下分 IR Drop 和 EM。
- 这些约束必须全部满足才能签核。
8. 形式化后能自动求解吗 ❓
理论上,形式化之后确实是一个数学问题。但实际上,只能部分自动化,不能完全自动化。即便给定工艺参数,我们也只能得到一个范围,而不是确定值。原因在于这个数学问题非常难。
9. 为什么不能完全自动化 🧱
主要困难如下:
- 目标函数是黑箱:写不出 (P(x))、(A(x))、(F_{\max}(x)) 的闭式公式。每次评估都要跑 P&R + STA,耗时几十分钟到几小时。
- 空间离散、非凸、超高维:变量可达数百万到数十亿。没有梯度,不能用梯度下降。
- 约束是隐式的:slack、DRC、LVS、IR 都要跑工具才知道。很多约束不可导、不连续,甚至带随机性。
- 工艺本身有不确定性:PVT、OCV、MC 仿真都会影响结果。
- 目标不固定:不同项目、不同阶段,目标函数会变。
- 架构与约束无法完全形式化:流水线级数、时钟域、多周期路径、false path,仍需要人判断。
这属于昂贵的黑箱多目标约束优化问题。
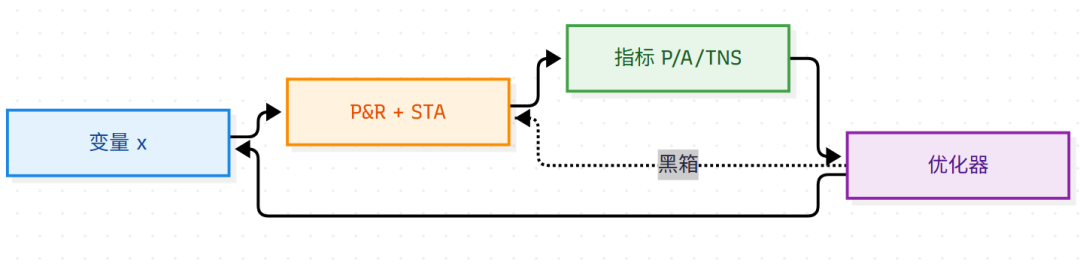
优化器交互解读:
- 优化器给出变量 (x),送入 P&R 和 STA 流程。
- 流程产出功耗、面积、TNS 等指标。
- 指标返回优化器,优化器再调整 (x)。
- 优化器与流程之间是黑箱关系。
10. 自动化能覆盖的范围 🤖
| 环节 |
自动化程度 |
| 综合 |
高 |
| 布局 |
高 |
| CTS |
高 |
| 布线 |
高 |
| 时序优化 |
中高 |
| 参数寻优 |
中 |
| DRC/LVS |
高 |
| ECO |
中 |
不能自动化的部分:
- 约束定义
- 架构决策
- 目标权重
- 签核判断
- 异常处理
- 低功耗策略
- 模拟/IP 集成
自动化负责重复劳动,人负责判断和决策。
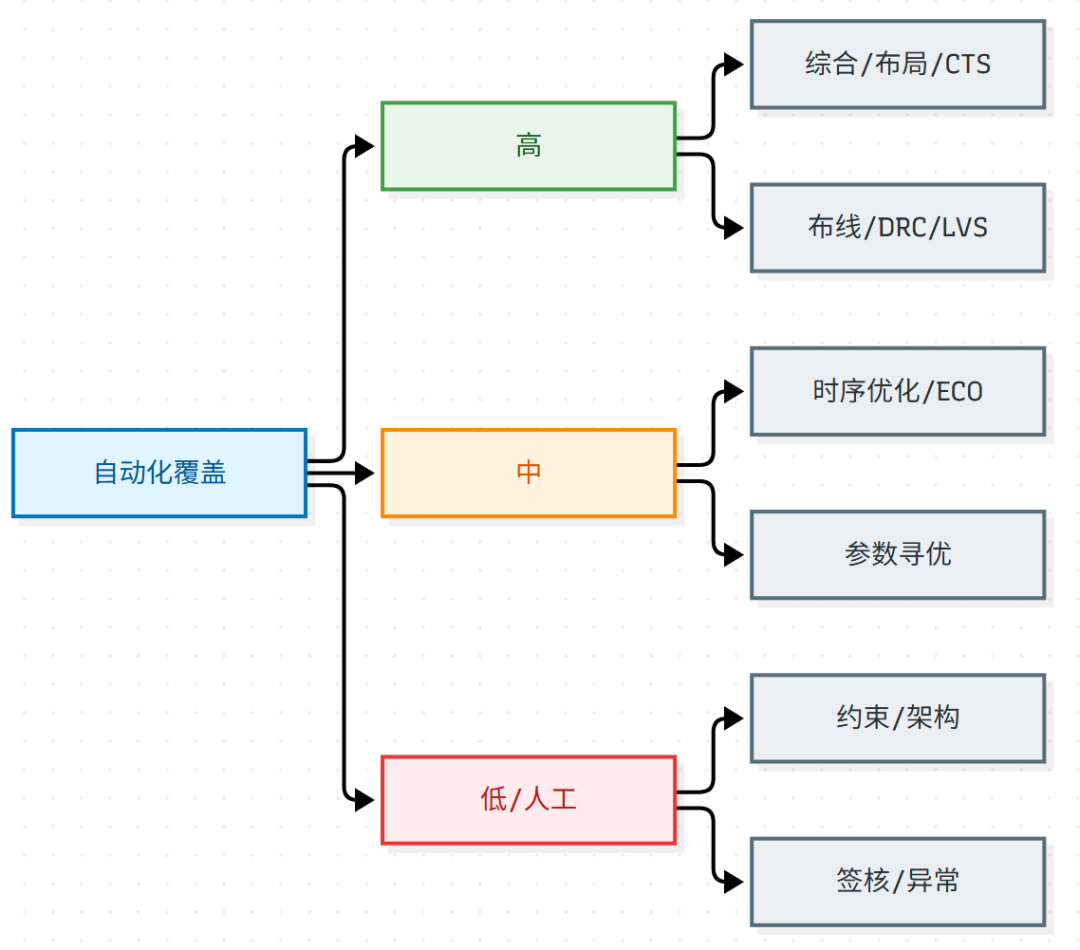
自动化覆盖解读:
- 自动化程度高的环节包括综合、布局、CTS、布线、DRC/LVS。
- 自动化程度中等的包括时序优化、ECO、参数寻优。
- 自动化程度低或仍需人工的包括约束、架构、签核、异常处理。
11. AI在后端设计中的应用 🧠
AI 在后端设计里主要有三类应用。
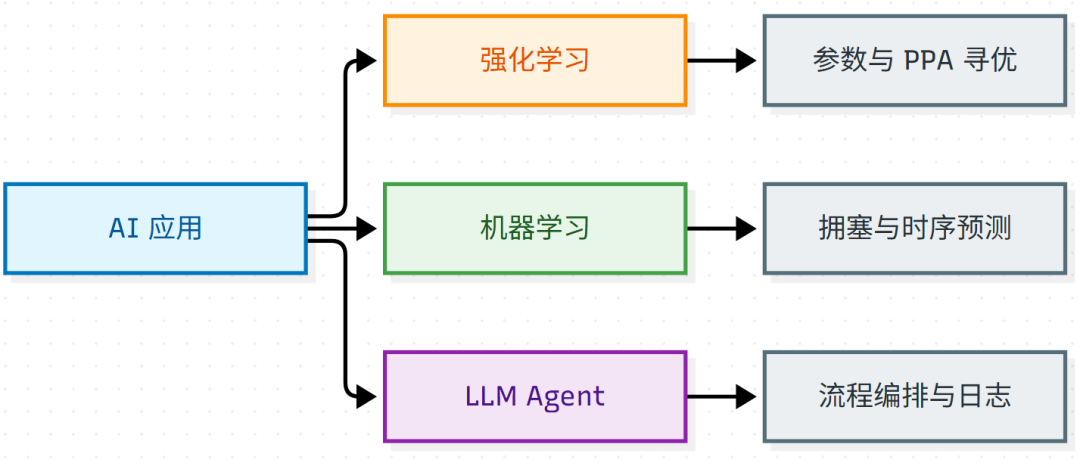
AI 应用分类解读:
- AI 应用分为强化学习、机器学习、LLM Agent。
- 强化学习用于参数与 PPA 寻优。
- 机器学习用于拥塞与时序预测。
- LLM Agent 用于流程编排与日志分析。
强化学习
用于参数寻优、宏放置、布线顺序、PPA 搜索。商业工具如 DSO.ai、Cerebrus,开源工具如 OpenROAD AutoTuner。
机器学习
用于拥塞预测、时序预测、DRC 热点预测、布局指导。它可以在设计早期预判问题,减少迭代。
LLM Agent
LLM Agent 用于流程编排、脚本生成、日志分析、修复建议、跨阶段回滚。典型例子包括 MARGO、ORFS-agent。
这些方法能做到:自动搜索参数、自动修局部时序、自动迭代到收敛。
但做不到:自动改架构、自动定义约束、自动判断可流片性。
12. 成熟方案列举 📋
商业工具
| 方案 |
类型 |
关键能力 |
| Synopsys DSO.ai |
RL |
PPA 寻优,700+ 流片 |
| Cadence Cerebrus |
RL |
参数优化,1000+ 流片 |
| PrimeClosure |
Signoff ECO |
ECO 迭代减少 50% |
Synopsys DSO.ai 利用强化学习自动探索设计空间,优化 PPA。累计支持 700+ 次商业流片,部分芯片 90% 的 SoC 模块由其优化。在一项研究中,DSO.ai 增强流程实现拥塞减少 19.42%、标准单元面积减少 5.27%、频率提升 16.44%、总功耗降低约 10.22%。
Cadence Cerebrus 同样基于强化学习,可自动优化 floorplan、单元尺寸和时钟树。累计支撑 1000+ 次流片。Himax 使用 Cerebrus 实现 5.6 倍生产力提升、50% DRC 减少;联发科在先进节点上实现 die area −5%、功耗 −6% 以上;Renesas 在 CPU 设计中实现 TNS 75% 改善。
Synopsys PrimeClosure 在 Signoff ECO 方向,宣称 ECO 迭代减少 50%、时序改善最高 45%。与 RedHawk-SC 联合的时序+IR 联合 ECO 方案,实测 IR 违例减少最高 85%。
开源工具
| 方案 |
类型 |
关键能力 |
| OpenROAD-flow-scripts |
全流程 |
24 小时 RTL-GDS |
| OpenROAD AutoTuner |
参数寻优 |
TNS +29%,时间 −36% |
| ORFS-agent |
LLM 编排 |
迭代减少 40% |
| MARGO |
多 Agent |
DRC/LVS 干净 GDS |
OpenROAD-flow-scripts (ORFS) 是一个全自动、无需人工干预的 RTL-GDSII 流程,目标是在 24 小时内完成设计,适合快速设计空间探索。OpenROAD 流程已成功用于 600+ 次硅就绪的流片,覆盖至 12nm 工艺。
OpenROAD AutoTuner 内置多种无导数优化算法,包括随机搜索、网格搜索、群体训练、贝叶斯优化和进化策略。通过 Ray 框架进行调度。在集成到 OpenROAD 工具链的实验中,平均 TNS 改善了 29%,运行时间加速了 36%。在 RISC-V 设计 ibex_core 的测试中,Optuna 算法在时序和面积上取得最佳结果,而 PBT 算法实现最低功耗。
Antmicro 进一步改进 AutoTuner,引入基于 Google Vizier 框架的多目标优化。它能独立考虑每个指标,提供一组多样化的帕累托最优解。
ORFS-agent(UCSD,MLCAD 2025 最佳论文)让 LLM 直接读取 ORFS 的 config.mk 和 SDC,迭代修改后跑流程、读日志、再优化。在六组设计上,比贝叶斯优化基线 AutoTuner 少用 40% 的迭代次数即达到可比或更优的 QoR。
MARGO(IEEE,2026)是一个基于 LibreLane 的开源多智能体编排系统。它采用三平面架构分离 LLM 认知、确定性指标提取和沙盒化 EDA 执行,并集成了 ConstraintGuard 模块进行约束检查、多智能体多数投票机制,以及跨阶段回滚机制。在三个 SkyWater 130nm 设计上,所有模型均成功生成了 DRC 干净且 LVS 通过的 GDSII 输出,无需人工干预。
13. 当前较优的自动化方案 🏆
商业方案的共同趋势是跨阶段反馈、自动回滚、约束守卫和 AI 辅助收敛。它们用强化学习自动探索设计空间,部分模块可无人值守。
开源方案形成了从 ORFS(全自动流程)到 AutoTuner(参数寻优)再到 ORFS-agent / MARGO(LLM 流程编排)的完整生态。
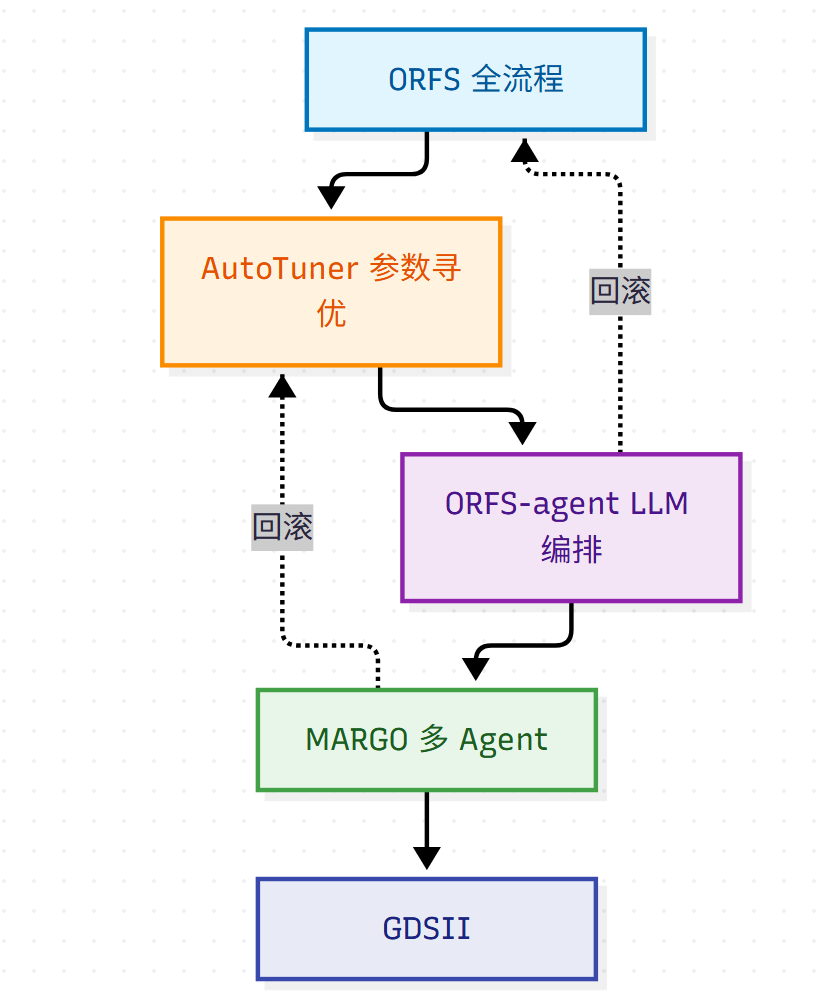
开源方案链路解读:
- ORFS 提供全流程自动化。
- AutoTuner 在 ORFS 基础上做参数寻优。
- ORFS-agent 用 LLM 做流程编排。
- MARGO 用多 Agent 做更高级的编排。
- 最终输出 GDSII。
- Agent 和 MARGO 都支持回滚到前序阶段。
但人仍负责:约束定义、架构决策、目标权重、签核判断和异常处理。
14. 总结 🎯
后端设计可以形式化为:
[
\minx \; F(x) = \begin{pmatrix} P(x) \ A(x) \ -F{\max}(x) \end{pmatrix}
]
约束为:
[
si(x) \ge 0,\quad DRC(x)=0,\quad LVS(x)=0,\quad IR(x) \le IR{\max},\quad EM(x) \le EM{\max},\quad P(x) \le P{\text{budget}},\quad A(x) \le A_{\text{budget}},\quad x \in \Omega
]
时序核心是:
[
Si = T{clk} - T{cq} - T{comb,i} - T{setup} - T{skew} - T_{jitter}
]
互相制约关系:
- 频率与功耗对立
- 频率与面积对立
- Setup 与 Hold 对立
- 修时序常常牺牲功耗和面积
- 省面积常常牺牲时序和可靠性
- 降功耗常常牺牲频率
因为目标互相制约,后端设计没有唯一最优解,只能在帕累托前沿上选一个折中。
当前较优实践是 AI 辅助的自动化收敛:流程能跑通、参数能寻优、局部能修,但架构、约束、签核仍需人。
一句话:自动化负责重复劳动和参数搜索,工程师负责约束、架构和最终判断。 💡
如果你也在做 AI 辅助 EDA 或芯片后端自动化的实践,欢迎到 云栈社区 和同行继续交流。
 发表于 1 小时前
|
查看: 3|
回复: 0


