随着 DeepSeek-R1 的出圈,强化学习,尤其是 GRPO,已成为大模型后训练中的常用方法。不过,研究指出,GRPO 仍面临两个明显缺陷:
- 探索不足,能力边界难以拓宽:GRPO 更多是在模型现有能力范围内进行探索与利用的权衡。在部分实验的大采样预算下,例如 Pass@256,其表现甚至低于基础模型。
- 难度不敏感,难以因材施教:GRPO 的奖励机制忽略了题目难度与模型当前掌握程度的变化,可能导致训练效率下降。
针对这两个问题,香港大学屈靓琼教授团队提出了“隐式优势对称性”(Implicit Advantage Symmetry)视角,并在此基础上提出非对称组相对优势估计方法 A-GRAE。研究团队报告,该方法无需额外计算成本,就能同时提升模型的准确率和探索能力。论文获 NeurIPS 2026 录用,代码已开源。
一、研究动机:GRPO 为何陷入双重瓶颈?
在可验证奖励强化学习中,GRPO 让模型针对同一道题生成多条回答,再由验证器打分。以二值奖励为例,答对得 1 分,答错得 0 分。
组相对优势估计将每条回答的奖励减去组内均值,再除以标准差。这一步标准化既决定了组内如何奖惩回答,也影响不同题目之间如何分配学习信号。
研究团队指出,组相对优势中隐藏着两种对称性,分别影响模型的探索能力和难度适应能力。
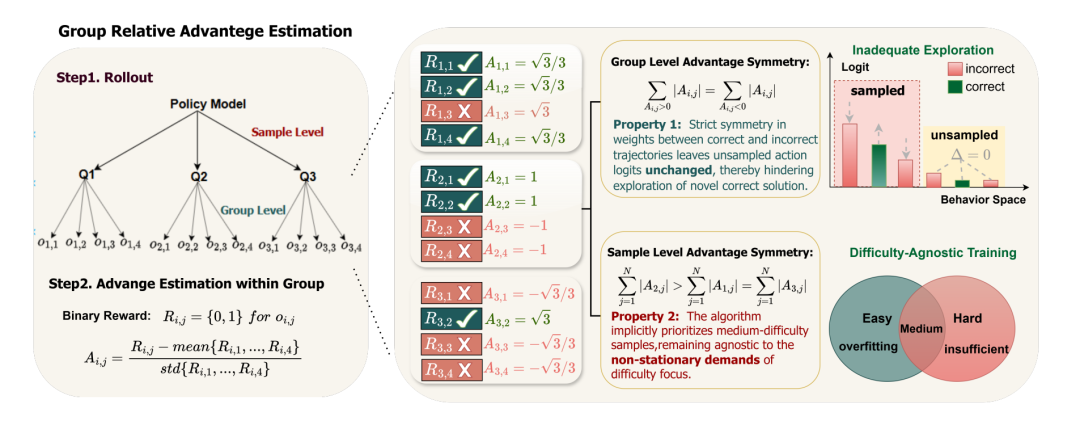
图 1:GRPO 中的双重隐式优势对称性。在组级别,正确与错误轨迹的绝对优势权重之和相等;在样本级别,中等难度样本的绝对优势值之和最大。
组级别对称:未采样路径缺少更新信号
在组内相对优势计算中,正确轨迹和错误轨迹的绝对优势值之和严格相等,具有零和性质。对于概率很低、因而未被采样到的正确轨迹,这种对称性使其无法获得直接奖励信号,限制了模型探索新解法。
定理 1:行为空间的 Logit 更新。 假定 $B$ 为模型所有可能生成的轨迹集合,其中包括已采样集合 $G$ 和未采样集合 $U$;令 $C$ 为组内优势之和。在标准 GRAE 中,归一化使 $C=0$。
学习率记为 $\eta$,指示函数 $I$ 表示轨迹是否属于采样集合 $G$,$\pi_{b_i}$ 表示模型生成该轨迹的当前概率。标准 GRAE 的零和对称性使采样到的正确与错误轨迹受到直接奖惩,而未采样轨迹在行为空间中得不到直接更新,因此可能抑制对潜在正确路径的探索。
原文中的 Logit 更新公式图片无法辨识,具体公式和推导可参阅论文。
样本级别对称:中等难度样本占据较大权重
团队推导出,GRPO 分配给单条提示词样本的更新幅度正比于 $\sqrt{p(1-p)}$,其中 $p$ 为采样成功率。
这意味着,中等难度样本在 $p=0.5$ 时获得最大权重;简单题与困难题在成功率分别为 $p=0.75$ 和 $p=0.25$ 时,权重完全相同。这种静态对称无法反映模型能力随训练发生的变化。
定理 2:更新幅度与样本难度的关系。 考虑一个查询对应的轨迹组 $G$,其二元奖励为 $\{r_i\}_{i=1}^{G}$。在组相对优势估计下,组内绝对优势值之和为:
$$
\sum_{i=1}^{G}|A_i|=2|G|\sqrt{p(1-p)}
$$
其中,$p$ 表示该样本在组 $G$ 内的经验成功率。这个关系揭示了 GRAE 中的难度偏差:中等难度样本对策略更新的影响更大,而成功率相对于 $0.5$ 对称的简单、困难样本获得相同权重。
随着模型能力增强,样本池中的简单样本可能逐渐增多。研究团队认为,静态对称可能使模型过度学习简单数据,而对高难度场景学习不足,难以适应训练过程中不断变化的能力需求。
二、控制变量实验:打破对称性会发生什么?
团队分别在组级别和样本级别打破对称性,通过受控实验观察其影响。
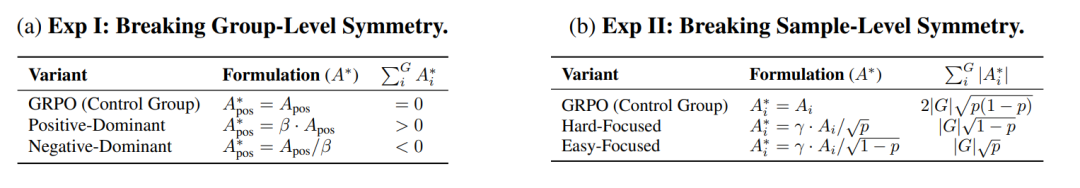
表 1:控制变量实验设计。$A_i$ 表示对应回答的优势值,$p$ 表示采样成功率,$\beta=10$、$\gamma=0.5$ 为常数。
实验 I:打破组级别对称
当研究人员刻意放大正确轨迹的权重时,模型出现严重的熵坍缩,在大采样预算下表现较差。反过来,压低正确轨迹的权重有助于增强探索,但训练后期容易出现不稳定甚至崩溃。
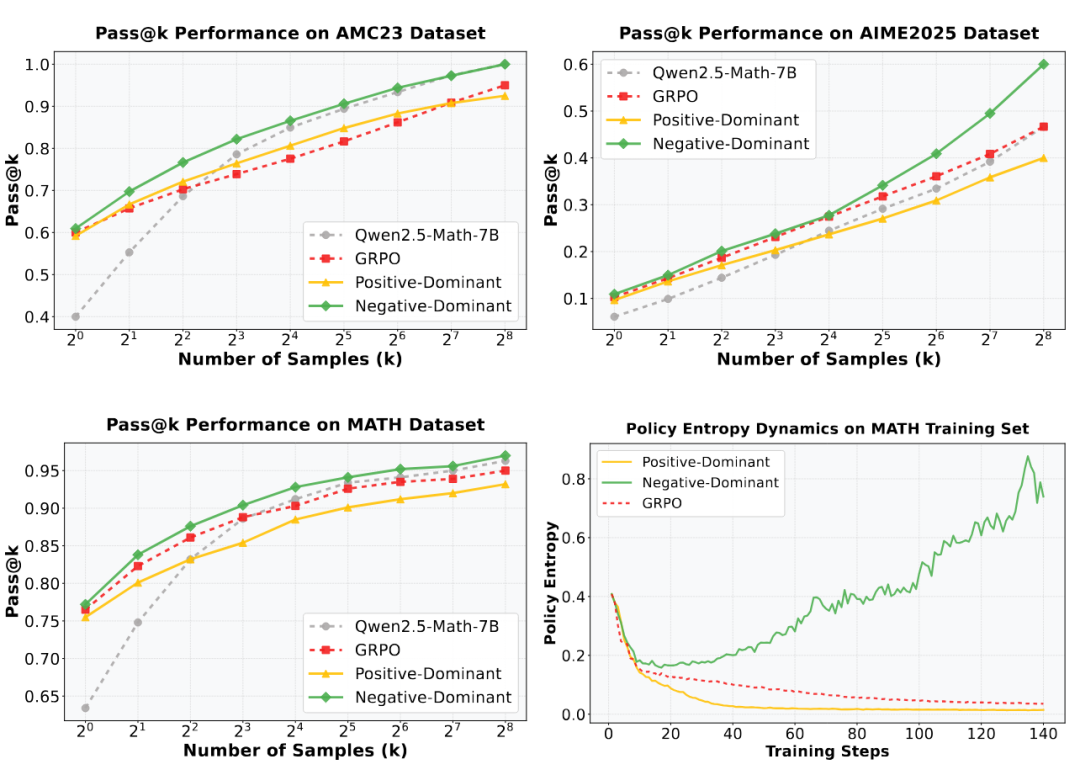
图 2:使用 Qwen2.5-Math-7B 打破组级别对称性的实验结果。研究人员分别放大正确轨迹的优势值(Positive-Dominant)和抑制其优势值(Negative-Dominant),并与 GRPO 及基模型比较。前三张图使用 Pass@k 评估性能,最后一张图展示训练集上的策略熵变化。
实验 II:打破样本级别对称
实验表明,不存在普遍最优的静态难度加权策略:合适的策略取决于具体基准和训练阶段。
研究团队进一步提出,训练早期优先学习简单样本,有助于掌握基础模式;后期转向困难样本,则有助于突破能力上限。与静态固定策略或仅关注难题的方法相比,这种由易到难的动态课程模式可以带来更高的学习效率。
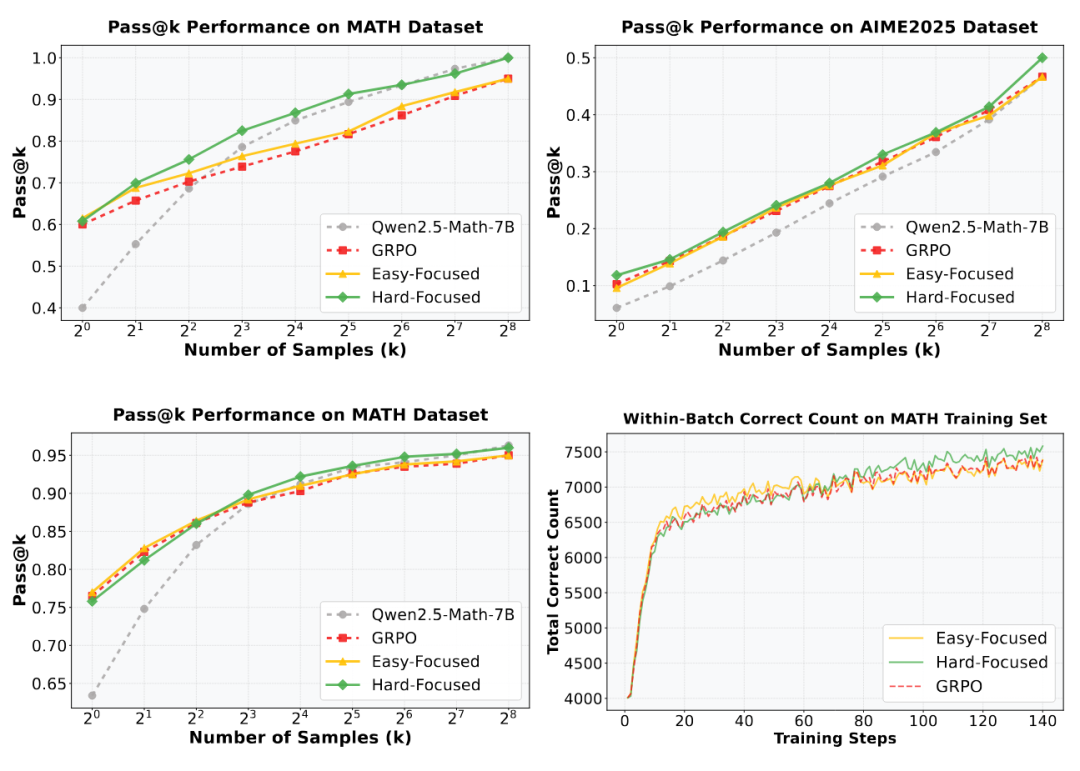
图 3:使用 Qwen2.5-Math-7B 打破样本级别对称性的实验结果。研究人员重新缩放优势值,将学习焦点转向困难样本(Hard-Focused)或简单样本(Easy-Focused),并与 GRPO 及基模型比较。前三张图使用 Pass@k 评估性能,最后一张图展示训练批次内正确采样响应的数量。
实验得到两点启示:
- 压低正确路径的权重有助于探索,但过度压低会导致训练不稳定,因此需要动态衰减机制。
- 简单样本有助于模型在早期掌握推理格式,困难样本则有助于后期突破性能上限,因此需要从易到难的动态课程机制。
三、统一视角:重新审视现有强化学习方法
优势对称性为理解现有 GRPO 改进方法提供了一个统一视角。此前看似各自独立的方法,可以从两个层面加以分析:
- 打破组级别对称性:负强化和 Pass@k 导向的方法,通过抑制对正确路径的过度学习,隐式打破组级别对称性,从而促进探索。
- 打破样本级别对称性:强调高熵 Token 或困难样本的方法,根据数据分布重新分配学习信号,将关注点转向不确定或困难区域。
这一统计视角也可用于审视强化学习中的奖励设置与优势构造,帮助研究者考虑能力边界收缩和样本利用效率不足等问题。
四、A-GRAE:非对称优势重塑
针对探索能力和难度适应能力的局限,研究团队提出了非对称组相对优势估计(A-GRAE),动态调整探索激励以及对不同难度样本的关注。
A-GRAE 首先使用批次平均奖励作为训练状态的代理指标。其中,$B$ 表示批次中的轨迹总数,$\omega_s$ 表示当前步的平均奖励;该值越高,意味着模型在当前批次上的表现越好。
在样本级别,方法引入动态注意力偏移机制。随着训练推进和模型能力发展,困难样本聚焦项的权重逐渐增加,简单样本聚焦项的权重逐渐减小,使学习重心从简单样本转向困难样本。其中,$p$ 表示给定问题的采样成功率。
在组级别,方法对正确响应的优势值采用衰减抑制策略:训练早期鼓励探索,后期则注重保持稳定性。$\alpha>0$ 是该策略中的缩放参数。
原文中批次平均奖励和两项动态调整的公式图片无法辨识,具体公式可参阅论文。计算出初始优势值后,A-GRAE 可整合到 GRPO 或其他 GRPO 变体中。
五、实验验证:准确率与探索能力
研究团队在文本数学推理和多模态推理的多个基准上进行了验证,涉及 AIME 2025、AMC23、MATH、Geo3K、MathVision 等数据集,并使用 Qwen2.5-Math-7B、DeepSeek-R1-7B 和 Qwen2.5-VL-3B 等基座模型。
实验结果主要体现为:
- 基线方法得到提升:在报告的文本和多模态任务中,A-GRAE 改善了 GRPO 及其变体的表现。表 2 显示,在 AIME 2025 上,DAPO + A-GRAE 的 Pass@k 平均值为 32.9%,高于 DAPO 的 30.5%;当 $k=256$ 时,两者分别为 60.0% 和 53.3%。
- 准确率与探索能力同时改善:实验中,A-GRAE 不仅提升了 Pass@1,也改善了大采样预算下的 Pass@k 表现。
- 跨任务表现:在多模态医疗推理和分布外(OOD)任务中,加入 A-GRAE 的方法同样取得提升。
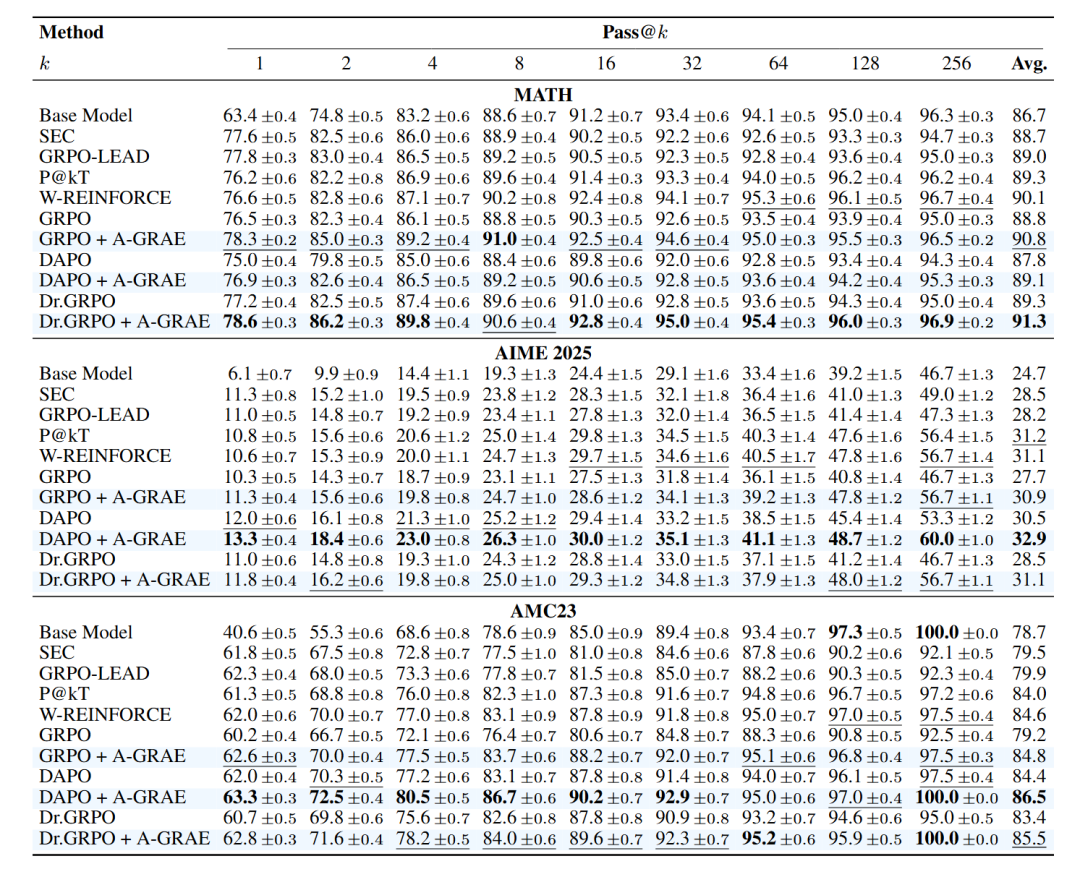
表 2:使用 Qwen2.5-Math-7B 在 MATH、AIME 2025 和 AMC23 上的 Pass@k 结果。加粗和下划线分别表示每个 $k$ 值下的最佳和次佳结果。AIME 2025 和 AMC23 进行了 16 次运行,其余基准进行了 4 次运行。
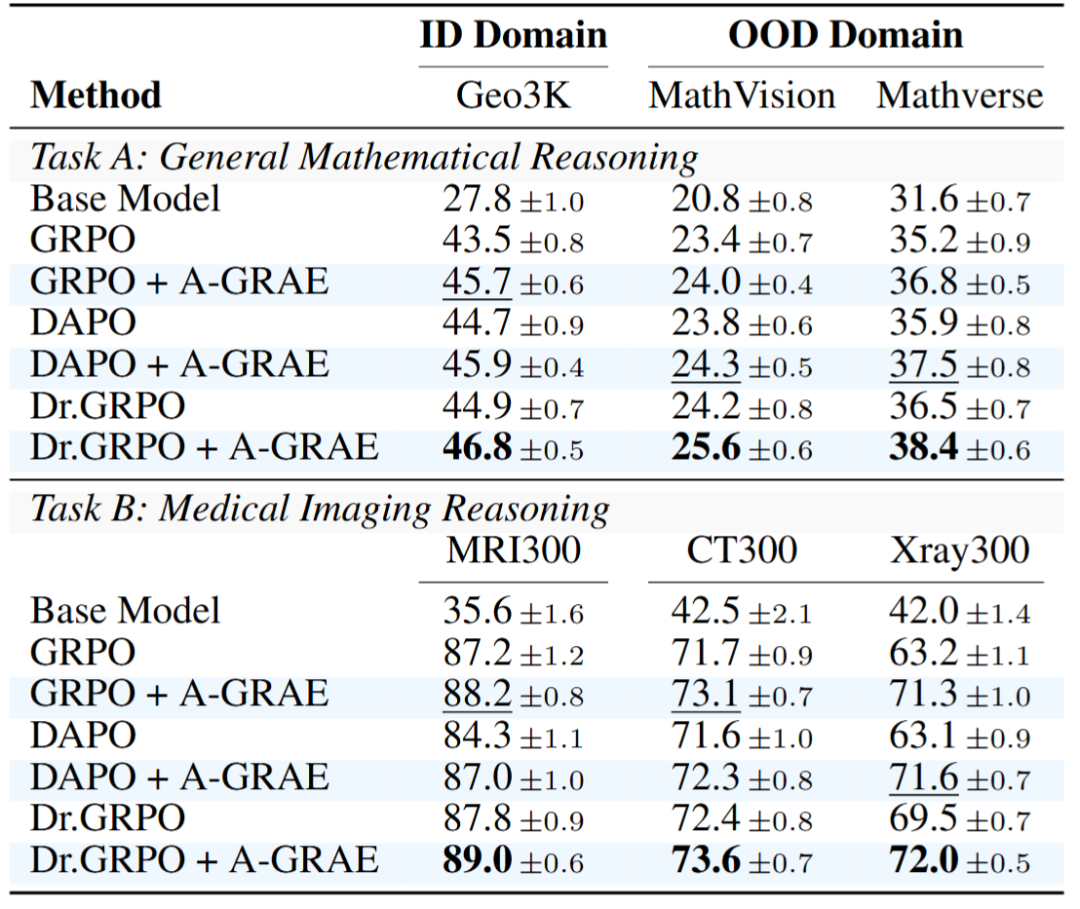
表 3:使用 Qwen2.5-VL-3B 在多模态数据集上的准确率。
六、结语
这项研究从“打破优势对称性”的角度,统一分析了 GRPO 的探索不足与难度适应问题,也为理解强调多样性和提升准确率的不同方法提供了共同框架。
基于这一视角提出的 A-GRAE,通过动态调整组级别和样本级别的优势权重,在报告的实验中同时改善了准确率与探索能力。其理论推导、证明和完整实验数据可参阅论文。
来源
第一作者:香港大学博士生余志齐。
来源:机器之心 AIxiv。
转载请联系原公众号获得授权。
 发表于 半小时前
|
查看: 5|
回复: 0
 /1


