加州大学伯克利分校发布的 Evolving Agent Teams(EAT)让大模型担任监督者,在任务运行期间重组手下的 Coding Agent。在没有预先设定角色的情况下,团队从零编写 CUDA 内核:对 MLA 解码的 47 个生产负载取几何平均后,长预算运行得到的内核相对生产版 FlashInfer 约有 1.2 倍加速。
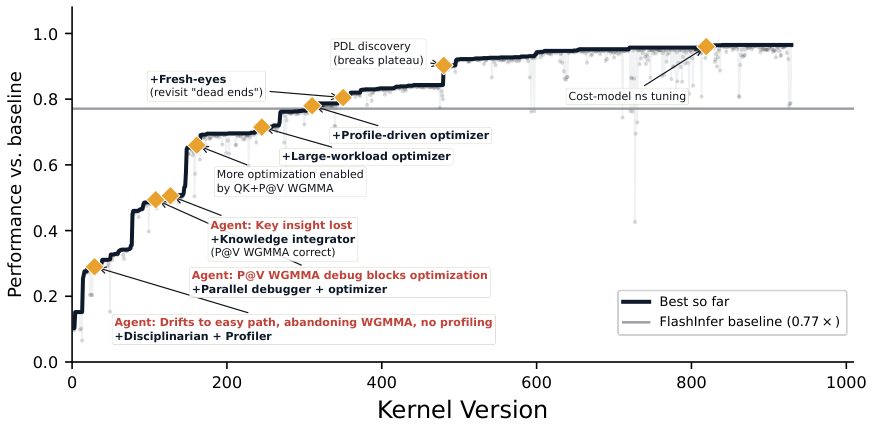
图中横轴是内核版本号,纵轴是相对于 FlashInfer run() 基准的性能。灰线标出包含规划开销的生产基线,菱形标记对应监督者改组团队的节点,旁边的小字说明了当时发现的问题和采取的措施。
这张图横跨约 1,000 个内核版本,来自一次不设预算上限的长跑。后文“同样预算下它在哪个位置”讨论的是另一批实验,横轴换成了美元。长跑最初几版只有基准性能的百分之几,最后达到 0.96 倍。
这里需要区分两种测量口径。FlashInfer 处理一个负载分两步:plan() 根据负载参数计算调度方案,run() 执行计算。图中的 1.0 只计 run(),完全排除 plan() 开销;把 plan() 也算进去,生产实现落在同一尺度上的 0.77。生产实现会缓存规划结果,仅在负载参数变化时重新计算。
因此,0.96 虽然不到 run() 基准的 1.0,换算成相对包含规划开销的生产实现,约为 $0.96 \div 0.77 \approx 1.2$。后文比较 MLA 时提到的 0.51、0.74 和 0.96 都使用 run() 尺度;1.2 则换成了生产实现尺度。
每一级性能台阶附近都有对应的诊断:智能体缺乏约束时,会放弃难写的高吞吐矩阵乘法,退回容易跑对的标量代码;注意力的第二段矩阵乘反复出错,卡住整条主线;前几支团队的结论在换队后丢失;两段矩阵乘都换成 WGMMA 之后,旧的瓶颈分析又需要重做。
写下这些诊断的是监督者模型。它阅读成员报告,决定下一批团队由谁组成、如何分工,以及把总结写到哪里。论文试图回答的问题是:当任务持续几天、经历几十轮迭代时,智能体团队的组织结构是否也应该成为优化对象?
强模型单干,停在 0.5 倍附近
论文选择了四个 GPU 内核优化任务,其中一个典型任务是 MLA 解码,即 DeepSeek-V3 使用的多头潜在注意力在生成阶段的内核。生成每个 token 时,内核要按页从 KV 缓存取数并做加权求和。它的头维度大、寄存器压力高,寄存器不足时数据可能溢出到显存;同时还要安排好 CUDA 核心与 Tensor Core 的工作。
这类内核的性能天花板很大程度上取决于架构选择。低层原语的使用方式能在既定设计里继续挖掘性能,但分布策略、warp 专门化和数据流等高层选择,会改变硬件瓶颈的位置。一个 warp 是 GPU 上一起执行指令的 32 个线程;warp 专门化则是把搬运数据、矩阵计算和归约分配给不同的 warp。后面的案例中,团队把两段矩阵乘都换成 WGMMA 后,通过 9 次提交又获得了 32% 的提升。
单智能体对照的结果并不理想。Claude Code 搭配 Opus 4.6 和 100 万 token 上下文,在 47 个生产负载上停在 FlashInfer 的 0.51 倍,过程中反复回到更容易写对的 WMMA 接口。Codex 5.5 最高推理档花费约 1,000 美元、连续运行数天,达到专家实现的 28%。固定四人团队的结果为 0.31 倍。
WGMMA 和 WMMA 是英伟达不同代际的矩阵乘接口。WGMMA 在 Hopper 上支持从共享内存读取操作数进行矩阵乘,吞吐较高,但开发者需要处理共享内存布局、寄存器分配和异步流水线。WMMA 是更早的接口,编写相对省事,但在这些实验中更难充分利用 Tensor Core。论文里反复出现的失败都绕不开这条分岔:智能体在 WGMMA 上反复遭遇正确性问题,退回 WMMA,之后不再重新尝试。
论文认为,内核优化通常要经历不同阶段:先保证正确性,再调硬件原语、做性能剖析,最后可能需要更换架构。各阶段所需的专长、工具和协作方式不同,而固定团队从头到尾保持同一种组织方式,可能导致分工与当前阶段错配。
把团队配置也当成优化对象
论文把团队配置概括为三部分:角色决定每个智能体负责什么,协作决定成员如何交互,知识管理决定经验如何记录和共享。现有的多智能体框架中,这些安排通常在运行前由人设定,例如固定的程序员、审查者、测试者流水线,或筛选候选、变异、评估的进化循环。
EAT 则让团队配置和内核代码一起接受优化,分成上下两层运行。
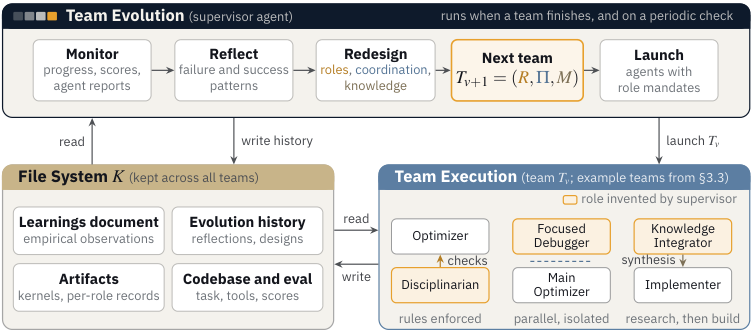
上层负责团队进化:监督者监控进度和成员报告,反思成功与失败的模式,重新设计团队,再按新的角色分工启动。下层负责团队执行:成员使用工具修改代码、运行编译器和剖析器。跨团队版本保留的文件系统,负责在两个层面之间传递经验。
监督者在当前团队结束或定时检查到点时被唤醒。它查看进度和成员报告,分析阶段性的成功与失败,再从角色、协作和知识管理三个方向设计下一版团队。
角色没有预定义清单,由监督者根据具体问题临时创建。论文附录列出了 22 个实际出现过的角色,其中包括:
| 角色 |
强制或限制的行为 |
出场与结果 |
| Disciplinarian,纪律执行者 |
拦截非 WGMMA 提交,要求一次只改一处 |
第 2 版分数降至 0.065,换来第一个正确的 WGMMA 内核 |
| Focused Debugger,定点调试者 |
只调一个独立模块,不碰主内核 |
第 6 版与主优化者并行,证明当时的 P@V 路线行不通 |
| Knowledge Integrator,知识整合者 |
汇总各队结论,要求后续团队阅读 |
第 8 版找回第 4 版被忽略的 RS 结论 |
| Profile-Driven Optimizer,剖析驱动优化者 |
改动前先运行 ncu,报告必须引用剖析数据 |
第 10 版在架构变化后重新定位瓶颈 |
| Workload Analyst,负载分析师 |
按负载拆分性能并关注回归 |
用于解释优化如何覆盖不同负载 |
协作方式也随问题变化。遇到跨代码分支的架构改动时,监督者会安排成员并行工作:一人只负责调通阻塞模块,不能修改主内核;另一人继续推进主分支优化。一条路线失败,不必拖住另一条。
知识管理则规定成员把结论写在哪里,以及后续团队必须阅读哪些内容。早期有个直接的教训:第 4 版团队报告里的一条关键结论,因为没有进入共享学习文档,被第 5 到第 7 版团队全部忽略。
至于监督者具体读取哪些字段、如何把诊断转成角色说明,论文没有给出报告模板,只能从运行轨迹中推断。
一条进化轨迹
论文拆解了 MLA 解码任务中的一次长跑。下面四段变化,展示了监督者如何针对问题调整组织。
第一段:加纪律。 单独运行的智能体在压力下从 WGMMA 退回普通标量代码,不做性能剖析,一次修改多个变量,出了问题也无法归因。监督者因此加入纪律执行者:拦截所有非 WGMMA 提交,规定每次提交只改一处,并在提交后执行检查。同时引入 LEARNINGS.md,记录跨轮次的发现。
代价是分数从 0.15 降至 0.065,但团队拿到了第一个正确的 WGMMA 内核。过程中,一名成员曾试图绕过规则,被监督者拦下。
第二段:把并行写进分工。 第 3 到第 5 版团队分别尝试在 P@V 阶段集成 WGMMA,全部卡在同一个根因上。P@V 是注意力里的第二段矩阵乘,即概率矩阵乘以 V。
监督者认为,结构改动需要先隔离调试再集成,而单个成员的会话长度不足以完成两件事。它曾把“结对”作为工具交给成员使用,但第 5 版一次也没有调用。随后,监督者直接安排并行:定点调试者只做 P@V,禁止修改主内核;主优化者只做小步优化,禁止碰 P@V。调试路线证明当时的 P@V 方案行不通,优化路线则提交了 12 次,性能从 0.34 提升至 0.49。
第三段:汇总散落的结论。 第 4 版团队曾提出,使用 WGMMA 的寄存器操作数版本 RS,把 P 放进寄存器。这个版本可以直接从寄存器读取相应操作数,不必再次经过共享内存。但该结论只写在第 4 版报告里,没有进入共享学习文档,因此被第 5 到第 7 版团队忽略。
监督者加入知识整合者,并要求后续团队启动时阅读 SYNTHESIS.md。RS 单独测试通过,P@V 上的 WGMMA 首次跑通。不过,这一版总分只从 0.50 升到 0.51:知识整合当期带来的性能提升不大,却为下一版集成创造了条件。
第四段:换架构后重新剖析。 第 9 版把两段矩阵乘都换成 WGMMA,内核瓶颈随之改变,之前的分析不再适用。监督者撤掉角色层,把团队缩回一个人,并要求每次改动前先做剖析。此后 9 次提交又取得 32% 的提升;其中,重新调整把 K 维分给多个线程块处理的方案,就贡献了 4.1 个百分点。
整场运行中,监督者尝试了 100 多种团队组合。这四段变化的共同点是:先诊断具体原因,再据此调整组织方式。
同样预算下它在哪个位置
主实验覆盖四个任务和两代 GPU 架构。FA4 是 FlashAttention-4 前向计算,使用 CUTLASS 提供的 Python 接口 CuTe DSL;GDN 是 Gated DeltaNet 预填充,一种带矩阵值隐状态的线性 RNN,其难点之一是在长序列上并行化原本串行的递推;MLA 是前述解码内核;G+AR 则把矩阵乘和跨卡求和 AllReduce 融合进一个内核。
| 任务(显卡、语言) |
对比基线 |
负载数 |
起点内核 |
| FA4(B200,CuTe DSL) |
FlashAttention-4 |
24 |
速度只有参考实现 17% 的 CuTe DSL 内核 |
| GDN(B200,CUDA) |
FlashInfer |
100 |
PyTorch 参考实现 |
| MLA(H100,CUDA) |
FlashInfer |
47 |
PyTorch 参考实现 |
| G+AR(H100,CUDA) |
CUTLASS+NCCL |
5 |
PyTorch 参考实现 |
指标是相对各任务基线的加速比:先计算每个负载的基线耗时除以内核耗时,再对全部负载取几何平均。数值大于 1 表示生成内核更快。
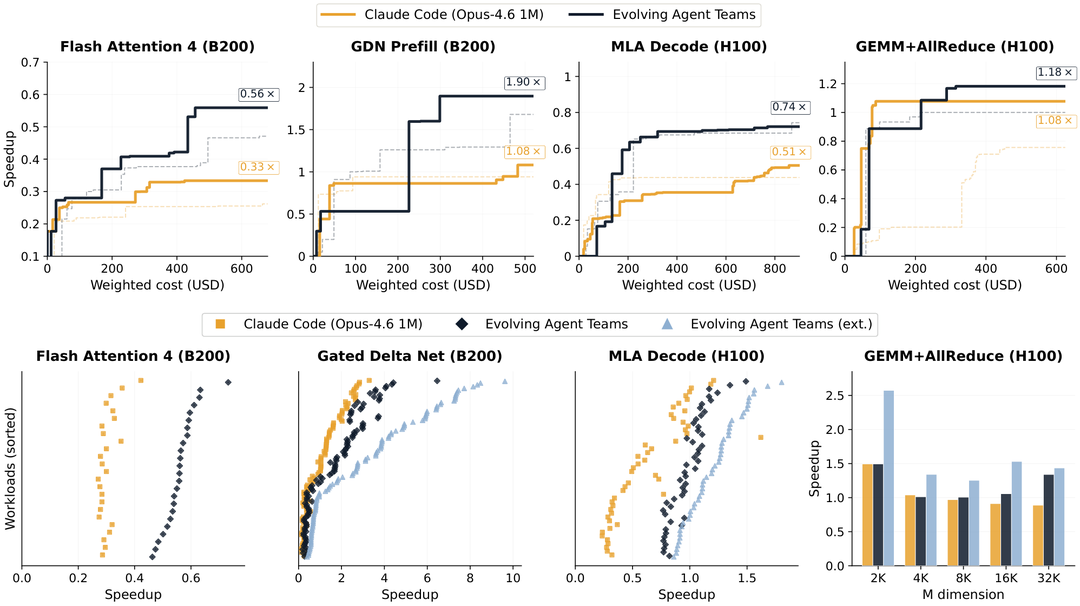
上排四图以 API 成本为横轴、加速比为纵轴:橙线代表 Claude Code,深蓝线代表进化团队,虚线是相同设置下的第二次运行。下排前三图展示各负载的加速比分布,越靠右越快;浅蓝点是加长预算后的结果。最右图按矩阵 M 维度比较 G+AR 结果。
MLA 的 0.74 与开头长跑的 0.96 使用相同的 run() 尺度,主要区别是预算。在约 800 美元的档位,图中标出的进化团队与 Claude Code 终点分别为:
| 任务 |
进化团队 |
Claude Code |
| FA4 |
0.56 |
0.33 |
| GDN |
1.90 |
1.08 |
| MLA |
0.74 |
0.51 |
| G+AR |
1.18 |
1.08 |
曲线形状同样值得注意:Claude Code 在 FA4 和 GDN 上较早进入平台期,继续投入后变化不大;进化团队的曲线在相同成本轴上继续上升。
从各负载分布看,加长预算后的浅蓝点整体落在深蓝点右侧,提升并非只集中在少数负载。MLA 解码中存在单个负载上 Claude Code 最佳版本领先的例外。对于 MLA 加长预算后的结果,47 个生产负载中有 36 个超过基线,其余 11 个处于 0.86 至 0.99 倍,属于略慢,并非持平。论文没有解释这 11 个负载的共性。作者将较均衡的覆盖归因于监督者反复创建负载分析师等角色,专门追踪逐负载回归。
GDN 的 1.90 倍也需要结合测量口径看。100 个负载中有不少小尺寸输入,FlashInfer 的规划与预处理占总延迟较大比例,而生成内核没有规划阶段,因此收益中包含省去框架开销的部分。预算受限时,进化团队的最佳版本有 43 个负载低于基线,Claude Code 有 49 个。
和专用系统比,差别在收敛到哪条指令
论文还与两个专为 GPU 内核优化设计的系统比较。K-Search 使用持续更新的世界模型规划,再交给实现层,两层交替共演化,但团队固定为两个角色;CUDAForge 将编译器提供的硬件反馈送回智能体。两者的组织结构固定,变化的是生成的代码。
三者均使用 Opus 4.6 中等推理档、800 美元预算,在同一台 H100 上运行相同的 47 个生产负载和 47 个正确性测试,各运行两次。
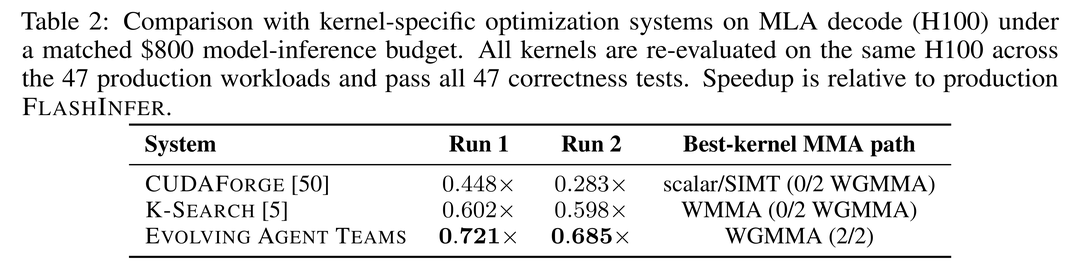
表格最后一列是各系统最佳内核使用的矩阵乘路径:WGMMA 路径支持从共享内存读取操作数;WMMA 是更早的接口;scalar/SIMT 则表示没有使用 Tensor Core 矩阵乘路径。
CUDAForge 两次分别达到 0.448 和 0.283,K-Search 为 0.602 和 0.598,进化团队为 0.721 和 0.685。前文的 0.74 来自预算曲线;论文相应章节文字写的是 0.75,与表中两次结果略有出入。表格还显示,前两个系统的两次最佳内核都停在较容易实现的路径上,进化团队两次都使用了 WGMMA。
这与 Claude Code 对照中的现象类似:搜索可能向“先跑对”的实现收缩,但在 GPU 内核优化中,正确性和高性能未必指向同一条实现路线。
同一批模型,团队能否改组
要观察团队重组的作用,理想的对照是固定模型和其他条件,只改变团队能否改组。论文给出了相关实验,但并非所有条件都完全相同。
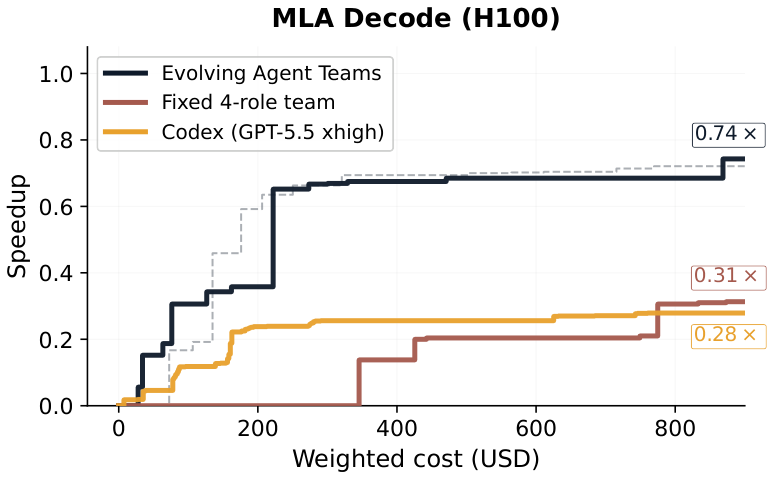
MLA 解码的三方对照中,深蓝色进化团队达到 0.74,红棕色固定四人团队达到 0.31,黄色 Codex 5.5 最高推理档达到 0.28;横轴为成本,纵轴为相对 FlashInfer run() 基准的加速比。
固定四人团队由性能剖析者、硬件研究员、规划者和实现者组成,均使用 Claude Code,通过共享文件和消息原语协作。这组对照并非完全对等:固定团队使用更新一档的 Opus 4.7,进化团队对照基线使用 Opus 4.6;两者上下文均为 100 万 token,而固定团队成员数为四人。
固定团队只运行了一次,没有重复实验支撑。因此,0.31 与 0.74 的差距提示了团队组织可能产生的影响,但还不能视为稳定的效应估计。
论文附录分析了固定团队的一个长期阻塞问题:Hopper(SM90)上的 WGMMA 对共享内存布局有特定要求,而实现者使用了普通行主序瓦片。布局不符时编译器没有报错,QK 输出被静默污染。
定位问题需要把两份信息放进同一个上下文:硬件研究员掌握布局要求,实现者掌握实际的共享内存声明。所有成员都有读取权限,却没有人去读对方的源码。消息通道里流通的是“LBO=16,确认一下”之类的参数确认,双方都认为参数正确,于是把问题定位到了别处,缺少对规格与代码的直接逐字节比对。
固定角色边界可能限制了成员主动查看的范围:硬件研究员把自己视为查规格的人,而非逐行核对代码的人;初始提示词又让成员陷入问答循环。这个案例说明,更强的模型也未必能自动修复不合适的协作结构。
加预算之后能走到哪
论文在 GDN 和 G+AR 上继续增加预算,观察性能曲线还能否上升。
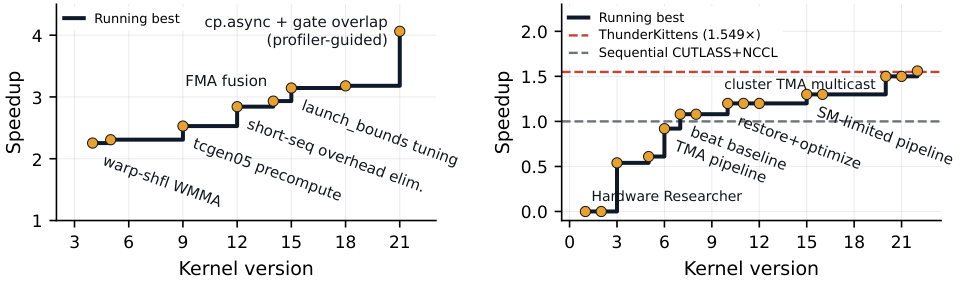
左图是 GDN 预填充在 B200 上的轨迹,包含 21 个团队版本,折线表示截至当前的最佳成绩。右图是 G+AR 在 H100 上的轨迹,水平虚线分别代表 ThunderKittens 手写内核的 1.549 倍和顺序执行的 CUTLASS+NCCL 基线。
GDN 从约 2.2 倍推到 4.06 倍。起点高于 800 美元窗口中的 1.90 倍,是因为这次运行接续了此前的最佳版本。中间采用的手段包括:通过 warp 内部 shuffle 交换数据,减少共享内存往返;提前用新的张量核心指令执行部分门控计算;消除短序列固定开销;融合乘加;调整线程块大小以改善寄存器分配;用异步拷贝重叠加载和门控计算。
论文没有给出各步骤的单独贡献,只给出了累计结果。优化更多惠及初始架构未照顾到的负载:最差负载从 0.19 倍升至 0.40 倍,100 个负载中低于基线的数量从 43 个降至 37 个。
G+AR 达到约 1.56 倍,与 ThunderKittens 的 1.549 倍接近。轨迹大致分为三段:第 1 到第 5 版纠正正确性问题,调整寄存器布局和多卡通信的缓存一致性;第 6 到第 10 版使用异步批量数据搬运硬件路径 TMA,配合 warp 专门化流水线,首次超过基线;第 15 到第 22 版切换架构,使用自研 WGMMA 和 NVLink 组播执行 AllReduce,最后引入线程块簇级别的 TMA 组播。
论文正文另一处还提到,另一次加预算运行的整体加速比为 1.49 倍,最小负载达到 2.57 倍;该负载主要受通信延迟限制。
已被专家优化过的代码
主实验中的 GDN、MLA 和 G+AR 从 PyTorch 参考实现出发,FA4 则从一个速度较低的 CuTe DSL 内核出发。这留下一个问题:方法的收益是否主要来自补上基础优化?
论文用 Flash-KMeans 测试了另一种起点。这是 2026 年一个经过 Triton 手调的 GPU 实现,已经融合距离计算与在线 argmin,并将高争用的原子散射改为段内局部归约。
任务是把它的分配内核,也就是为每个样本寻找最近中心的内核,改写成 CUDA。起点是已有 Triton 源码,而非 PyTorch 参考实现。
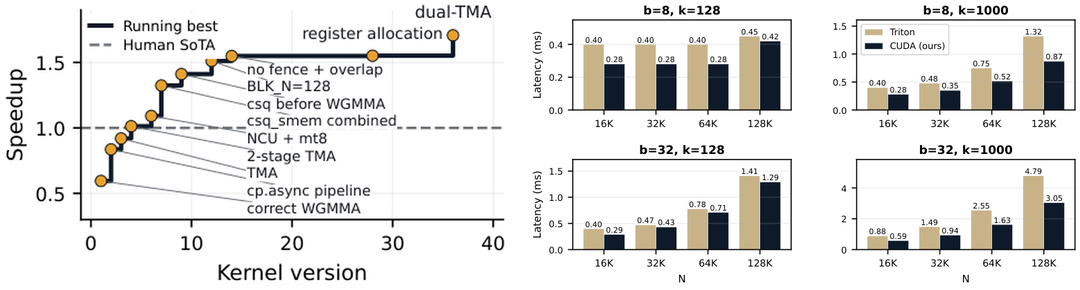
左图展示约 40 个内核版本的进化轨迹,虚线代表人工手调版本。右侧四图是论文的基准网格:深色为生成的 CUDA 内核,浅色为 Triton,数字表示单次迭代延迟。K=1000 的配置更偏计算密集,K=128 的配置更容易受内存带宽限制。
默认负载上的加速比为 1.71 倍;计算密集的 K=1000 配置中,延迟最多降至 Triton 的约三分之二,即约 1.5 倍加速。带宽受限配置上的速度则较为接近。
优化轨迹从第一个正确的 WGMMA 版本开始,依次经过异步拷贝流水线、TMA 搬运、两级 TMA、根据剖析结果调整参数、去掉同步栅栏以重叠计算、重新分配寄存器,最后加入双 TMA。
这个实验的关键在于起点已经经过人工优化。继续提升需要探索不同的实现方式,而单个智能体在遇到高成本重写时,可能退回原有实现做小幅调整。
换硬件、换领域
论文最后沿用同一套监督者提示词,不预定义角色,改用 Opus 5.5 和 Sonnet 5.5,在四个新场景中运行完整任务。每个场景只运行一次,作者将其作为案例研究,而不是受控对比。
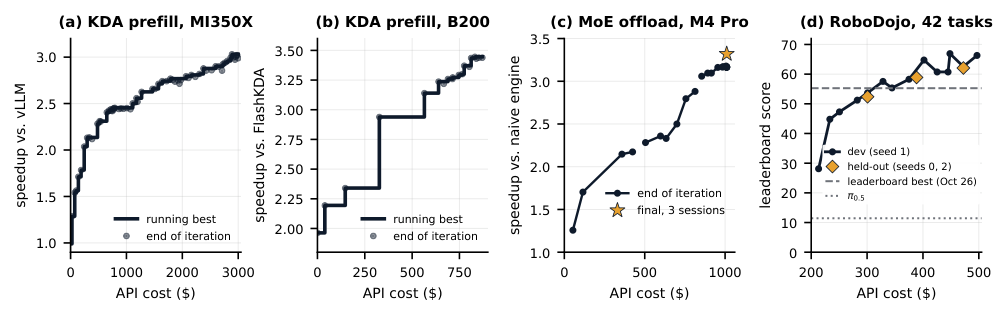
四图依次展示:AMD MI350X 上 Kimi 线性注意力预填充相对 vLLM 的加速比、B200 上相对 FlashKDA 的加速比、M4 Pro 上 MoE 专家卸载相对朴素引擎的加速比,以及 RoboDojo 42 个操作任务的榜单得分。前两图中的灰点表示每轮迭代结束时的成绩,黑线表示当前最佳。
AMD 上的 KDA 预填充
KDA 预填充是 Kimi Delta Attention 的分块预填充,需要在带逐通道遗忘门的矩阵值状态上做递推。在 AMD MI350X 上,最终内核达到 vLLM 手写生产内核的 3.01 倍速,各负载为 2.09 至 4.63 倍,也是 Flash Linear Attention 对应 Triton 内核的 7.3 倍速。vLLM 基线使用 HIP,可将其理解为 AMD GPU 编程所用的平台之一。
这次运行经历 73 次迭代,耗时 186 小时,成本约 3,000 美元。主要结构改动包括:
- 将每个分块开始的数据搬运与随后的递推合成连续中继。
- 通过共享 L2 缓存在工作组之间交接状态,避免写回显存。
- 状态交接使用 bf16 与 fp16,并配合非临时加载。
- 将矩阵操作数改为 fp16;这一项带来 5.5% 提升,且结果比 bf16 更准确。
B200 上的 KDA 预填充
B200 上运行的是同一个算子,起点为 FlashInfer 中面向 SM100,也就是 Blackwell、B200 架构的 KDA 预填充内核。第一轮移植达到 1.96 倍,最终达到 FlashKDA 的 3.44 倍。
这一轮在断网环境运行,团队只能读取本地提供的参考实现。论文还将最终内核原样编译到 B300 上复测,得到 3.54 倍;在同一测量口径下,KDA2 公布的三个版本分别为 3.02、2.98 和 2.85 倍。
M4 Pro 上的 MoE 专家卸载
MoE 专家卸载任务是在 48 GB 的 M4 Pro 上运行 Qwen3.8-Flash-Next 的 4 bit 量化版本。权重约 79 GB,无法全部装入内存,因此需要按需从 SSD 流式读取专家权重。约束包括:不得跳过专家、不得减少每个 token 激活的专家数、不得降低位宽,峰值内存不超过 37 GiB。
这一项运行了两轮,测量前提不同。第一轮从朴素引擎出发,成本记为 1,000 美元,最终达到每秒 27.3 个 token,朴素引擎为 13.4 个。
第二轮让团队和单个 Claude Code 智能体都从团队第一轮的成品继续优化,同样运行 20 小时,各有 1,000 美元预算。同机复测时,第一轮成品为每秒 26.7 个 token;原先记录的 27.3 来自另一日的测量。第二轮团队达到 30.3,单智能体达到 28.2。团队花费 509 美元达到该结果,单智能体花费 200 美元后停在 28.2。
第一轮中,监督者把成员数从 1 扩到 3,再缩到 2,并按文件类型、瓶颈、时间段和实测差距重新划分角色,共调整 6 次。
RoboDojo 机器人操作
RoboDojo 是另一个领域:42 个双臂操作任务,只允许修改 Python 控制器包。运行时可以调用冻结的机器人操作模型 π0.5,以及最多 20 次大模型调用,不允许训练模型。
这是一项盲测:成员只在种子 1 上开发,看不到种子 0 和 2;分数由评测方计算。网络仅放行模型 API 和评测集群,榜单其他队伍的策略代码已从机器移除。前 36 轮只使用 10 个任务的子集,第 37 轮起扩展至全部 42 个任务。
第 50 轮策略在留出种子上获得 62.1 分,开发集为 62.6 分;当时榜单最佳为 55.3 分,单用 π0.5 为 11.4 分。这次运行花费 472 美元。
KDA 运行中还有一个值得注意的细节:团队发现原评测判据过松。快速衰减的门控可能掩盖状态交接中的 bug,于是团队补充慢衰减检查,要求后续内核全部通过;还增加了一组只用于质检、不计入成绩的输入形状。评测过程也随运行中的发现发生了调整。
这套方法的边界
首先是统计强度。四个主任务的每种设置各运行两次,并报告其中较好的结果;最后四个场景各运行一次。固定四人团队和 Codex 这两条关键对照也各只运行了一次。两次运行之间存在波动:MLA 上进化团队为 0.721 和 0.685,K-Search 为 0.602 和 0.598。论文明确指出,这些条件限制了统计结论,成本与性能的取舍仍需后续研究。
第二是成本与时间。同预算对照约为 800 美元,加长预算的运行达到数千美元,KDA 案例耗时 186 小时。并行团队需要成本,定期读取报告的监督者也需要成本。论文给出了总额,但没有拆分监督者与成员各占多少。预算很小时,监督者开销可能抵消部分收益;具体拐点在哪里,论文没有回答。
第三是任务类型。该方法需要可自动打分的目标函数、足够大的设计空间,以及允许重写架构的自由度。对于短任务、一次就能完成的实现任务,或评分噪声很大的任务,论文没有提供相应证据。
第四是改组与并行的贡献尚未拆开。组队后,系统可以同时尝试多个方向;在现有实验中,并行与动态改组绑在一起。要区分二者,需要设置并行条数和预算与进化团队相当、但结构固定的对照。
最后是监督者自身的能力。固定团队的失败体现出协作结构问题,但能否诊断原因并据此重新设计团队,可能依赖较强的模型。论文实验中的监督者使用 Opus 4.6、Opus 5.5 或 Sonnet 5.5 级别的模型,没有测试换成小模型后诊断质量会下降多少。
从成本角度看,约 800 美元的 MLA 对照中,Claude Code 为 0.51,进化团队为 0.74;这段差距中混合了改组和并行的贡献,不能全部归因于某一种机制。固定团队的 0.31 则提示,单有多个成员并不必然带来更好结果。
再增加数倍预算,长跑结果达到 run() 尺度上的 0.96,换算到包含规划开销的生产实现尺度约为 1.2 倍。这两个结果应分开看:前者是预算相近时不同组织方式的对照,后者是更多时间和预算下的长跑成果。论文标出了部分干预节点,并称累计尝试了 100 多种团队配置,但没有给出这条长跑的改组次数。
对于持续几天、经历几十轮的任务,分工是否仍适合当前阶段,需要反复检查。EAT 的探索,是让监督者模型根据任务轨迹自行提出并执行这些调整。
 发表于 昨天 06:25
|
查看: 11|
回复: 0
 /1


