过去,大模型领域常有一种倾向:让模型输出更长的思考过程,以期得到更好的答案。但在在线推荐场景中,推理过程本身也有成本。
腾讯团队在一篇论文中提出了一个问题:在采用 CoT 的生成式推荐方案里,每次推荐都让模型先生成几十甚至上百个 token 的推理文本,这笔开销能省吗?
论文提出的 LatentRec 尝试将多步潜在计算的收益转移到训练阶段,使模型在推理时可以跳过额外的潜在步骤,直接生成推荐结果。
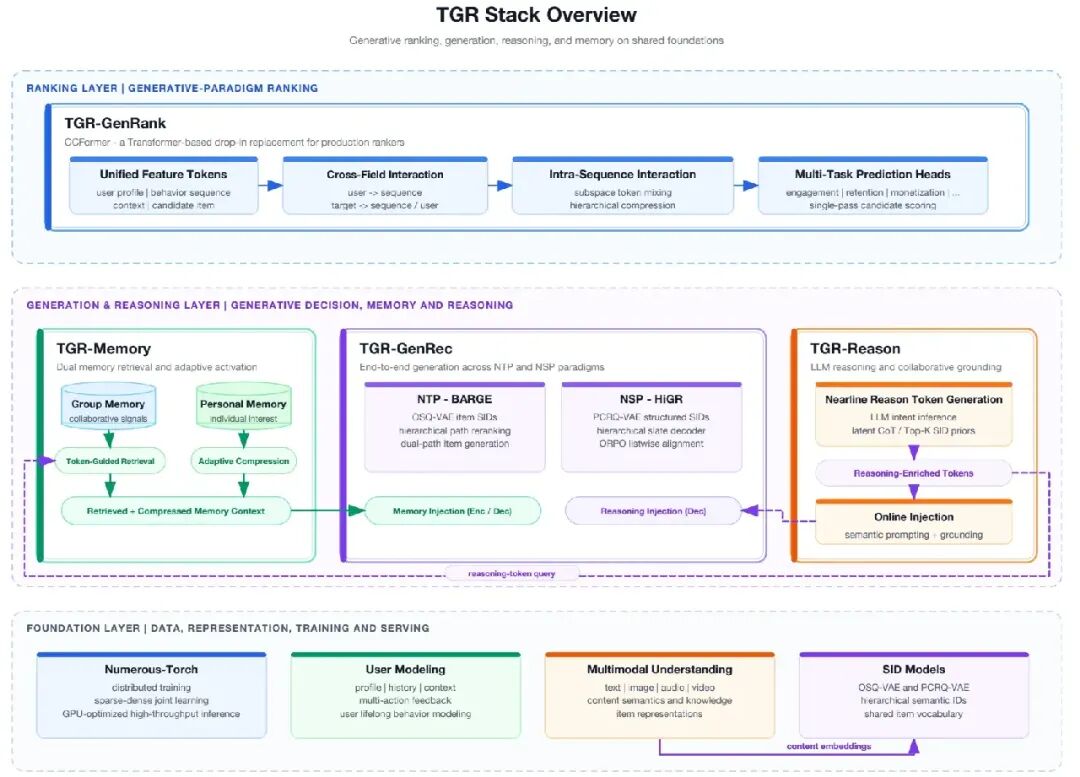
相关思路也被用于腾讯工业推荐系统 TGR-Reason。据 TGR 技术报告,在对比现有生产基线 TGR-GenRec 时,冷启动用户的离线 Hit@1 相对提升 477.8%,线上新用户曝光转化率相对提升 13.09%。这些是 TGR-Reason 整体配置的收益,不能直接归因于 LatentRec 单一模块。
TGR 技术栈覆盖排序、生成、推理和记忆等环节,相关研究成果发表于 AAAI、ACL、CIKM、NeurIPS 等会议。
01 大模型推荐的“思考税”
用 LLM 做推荐的一种方法是 SID 生成式推荐。简单说,就是通过 RQ-VAE 等方法,将每个商品编码成一串层级化的 Semantic ID。例如,一个杯子可能对应“12-45-7-233”这样的四层编码,再让 LLM 像生成文字一样生成这串 ID。
在此基础上,一些研究引入了 CoT 蒸馏:先用 GPT-4 根据用户历史生成一段推理轨迹,再用这段轨迹对小模型进行训练。
例如,用户买过露营帐篷和睡袋,推理轨迹可能是:“这个用户喜欢户外,可能还需要一个便携炉具。”推理时,模型先输出思考文本,再输出 SID。
这种方式可以改善推荐效果,但也带来了开销:每次推荐都要先生成几十到几百个 token。在线推荐对响应速度要求高,额外生成文本会增加延迟和计算成本。
02 LatentRec 的三个组件
LatentRec 关注的问题是:能否利用训练时的监督,让模型在推理时少做甚至不做额外的潜在计算?
它由连续思考模块、软 token 选择和逐步推理损失三个组件构成。
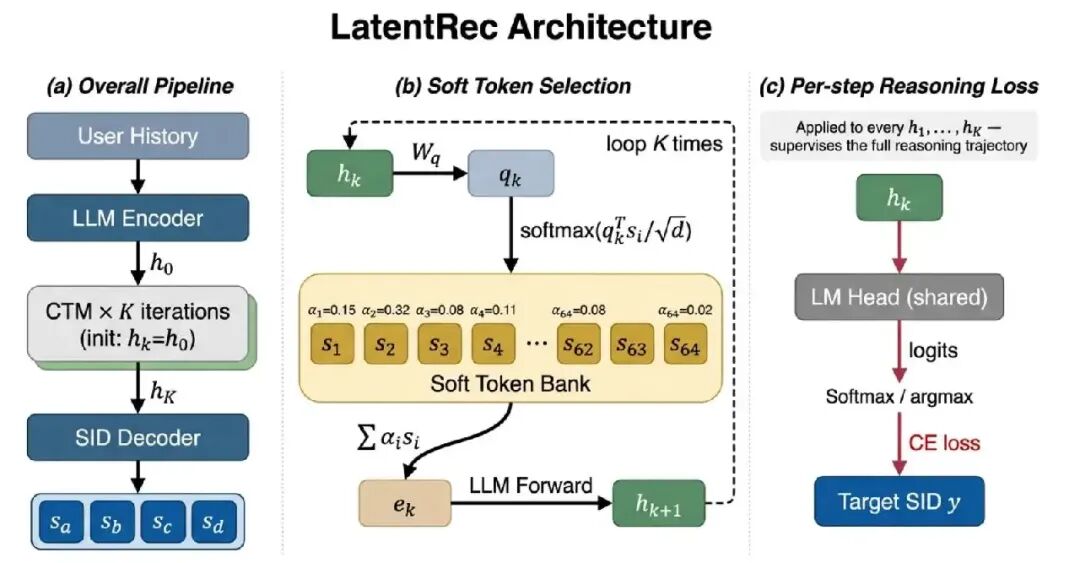
图 1:整体流程先编码用户历史,再进行 $K$ 步潜在计算并解码 SID;软 token 选择负责构造下一步输入;逐步推理损失使用目标 SID 的第一个分量监督中间状态。
第一个是连续思考模块 CTM。 这套潜在模块新增约 2.5M 参数,不到 1.7B LLM 参数量的 0.2%。训练时,它在 LLM 的隐状态上迭代 $K$ 步;每一步都通过后面介绍的 STS 将当前状态转换为输入,再送回同一个 LLM。
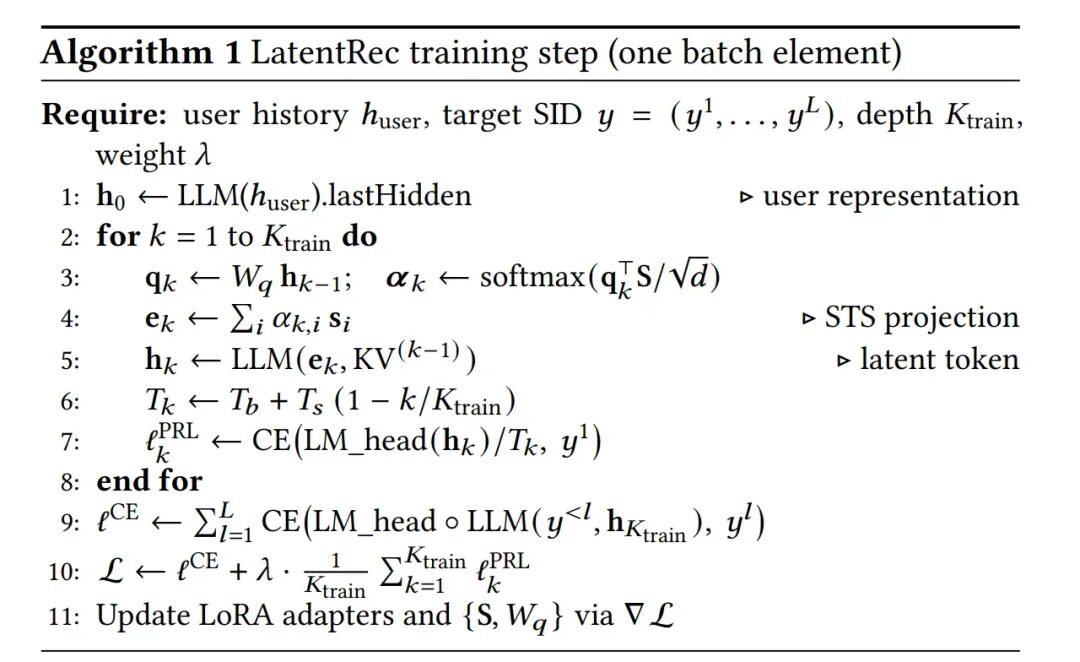
算法 1:LatentRec 的单批次样本训练步骤。
第二个是软 token 选择 STS。 它解决的是隐状态直接反馈时的尺度不匹配问题。
在 Qwen3-1.7B 骨干模型上,隐状态与输入 embedding 的尺度相差约 14 倍。作者尝试直接反馈原始隐状态,并对每一步加入预测监督,结果在第一个 epoch 就出现训练发散,触发自动停止保护。
STS 准备了 64 个可学习的软 token,初始值来自模型自身的词表嵌入。每一步,模型根据当前隐状态计算各软 token 的权重,再将它们加权组合成新的输入。这不是简单缩小向量,而是借助模型已有的嵌入空间重新表达当前状态。
第三个是逐步推理损失 PRL。 训练时,每一步的隐状态都会经过 LLM 的共享预测头,与目标 SID 的第一个 token 计算交叉熵。默认训练两步:第一步温度为 3.5,第二步降到 1,使早期预测相对宽松,随后再收紧。
为什么只监督第一个 SID token?因为 SID 是层级化的,第一个 token 是最粗粒度的路由信号,后续层级交给标准交叉熵损失处理。若监督更深的层级,就需要通过 teacher forcing 提供目标 SID 前缀,这可能将潜在 rollout 轨迹限定在目标前缀上,与推理时的自回归解码产生冲突。
训练时增加模块,部署时跳过它,收益为什么还能保留?关键在于,逐步监督也会更新 LLM 的 LoRA 参数。潜在模块在训练中提供帮助,训练收益则保留在模型参数中。因此,部署时设为 $K=0$,跳过额外潜在步骤,仍可用训练后的模型直接生成推荐结果。
03 实验:效果与推理成本
论文在 Amazon 的 Beauty、Toys、Sports 三个推荐数据集上进行了验证,主要比较对象是使用相同骨干模型的思维链微调模型。
在不展开额外潜在步骤的 $K=0$ 配置下,与 LLM-CoT SFT 相比,LatentRec 在三个数据集上的 HR@10 均有所提升:
- Beauty:从 0.0625 提升到 0.0656,相对提升约 5.0%。
- Toys:从 0.0639 提升到 0.0668,相对提升约 4.5%。
- Sports:从 0.0297 提升到 0.0309,相对提升约 4.0%。
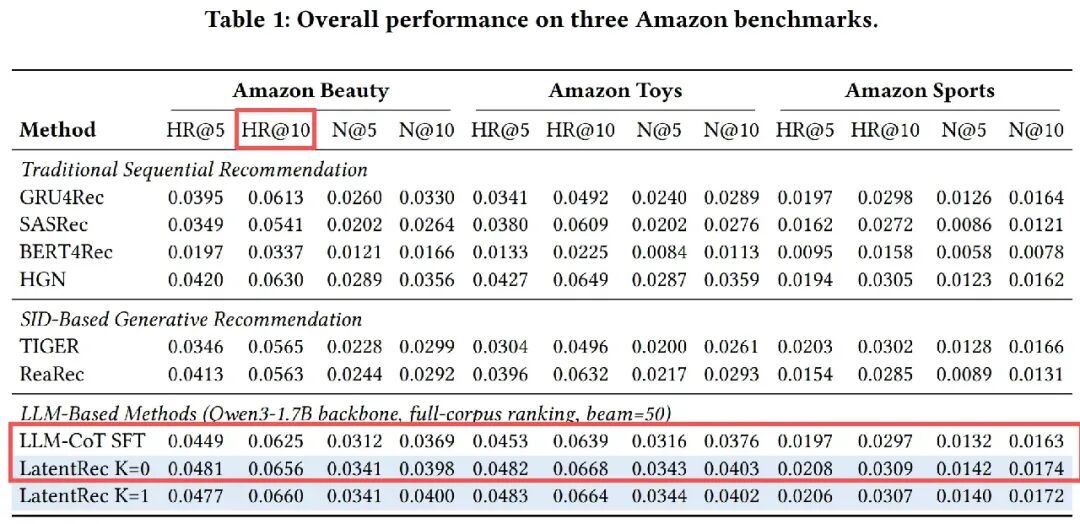
表 1:三个 Amazon 基准数据集上的整体性能。
延迟收益更直观。在 Beauty 数据集、单张 H20、batch size 为 1 的测试中,生成 128 个推理 token 的 CoT SFT 单样本耗时 10.80 秒;LatentRec 的 $K=0$ 配置耗时 0.59 秒,约为 18.3 倍加速,同时 HR@10 从 0.0625 提升到 0.0656。
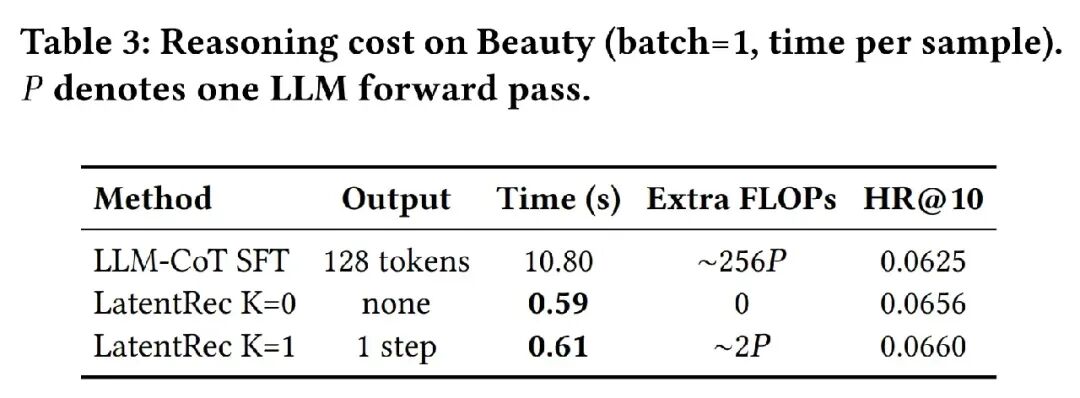
表 3:Beauty 数据集上的推理成本,测试批大小为 1。
消融实验从同一个 CoT SFT 模型出发:
- 仅继续 LoRA 训练,HR@10 从 0.0625 升至 0.0629。
- 加入不含 PRL 的潜在模块,升至 0.0633。
- 再加入 PRL,升至 0.0656。
最后一步带来约 3.63% 的相对提升,高于前两步各约 0.64% 的增益。在这组消融实验中,逐步监督是贡献最大的部分。
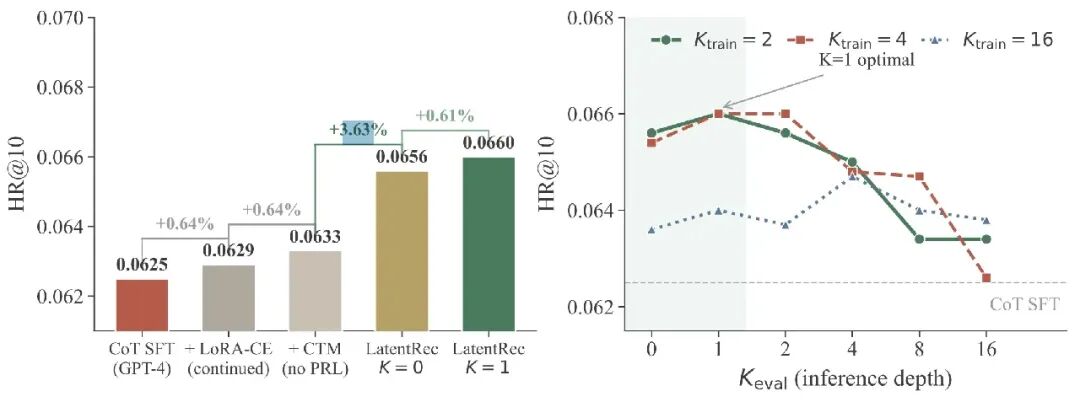
图 2:左侧为逐步推理损失的消融结果,右侧为不同训练深度和推理深度的对比。
不过,额外的潜在推理并不总能带来收益。推理时展开一步,Beauty 的 HR@10 约提升 0.6%,而 Toys 和 Sports 均约下降 0.6%,没有形成一致改善。训练深度同样需要选择:在 $K=0$ 推理配置下,训练两步优于训练十六步。
这些实验表明,在论文所测试的配置中,多步潜在计算的价值主要体现在训练阶段,而不是推理阶段。
04 工业落地:TGR-Reason 如何使用
LatentRec 是 TGR 相关研究的一部分。TGR 生成式推荐方案已集成进 TRS 推荐引擎平台,用于腾讯新闻、视频、网络小说等十多个场景,以改善观看时长、新客转化等业务指标。
TGR-Reason 将相关思路应用于线上推荐,工程重点是把耗时计算前移。
在离线阶段,Think 模型提前为用户计算一批候选物品的 SID,并将它们作为 reason tokens 存入数据库。线上收到请求后,系统读取最近存储的 tokens,将其作为辅助线索注入生成器,不必等待大模型现场完成推理。
后台异步更新这些结果,线上请求则负责读取和复用;如果没有命中缓存或记录已经过期,系统会回退到原有路径。
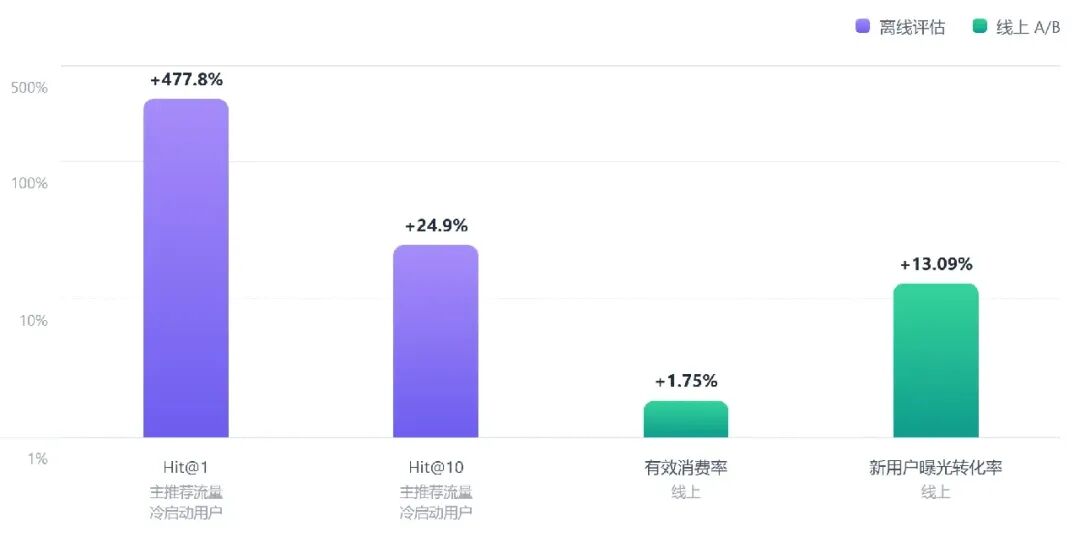
图中数据均为相对提升,纵轴采用对数刻度,来源为 TGR 报告表 16、表 17。提升属于 TGR-Reason 整体配置;报告未将其拆解为 LatentRec 单一模块的独立增益。
在主推荐场景中,历史行为稀疏的冷启动用户,其离线 Hit@1 从 4.51% 提升至 26.06%,相对提升 477.8%。线上 A/B 测试相对原有生产系统的有效消费率提升 1.75%,新用户曝光转化率提升 13.09%;据报告,这两项线上指标的提升均具有统计显著性。
05 一些感受
回到最初的问题:推荐系统一定需要用文字来“思考”吗?
LatentRec 给出的答案是,不一定。它通过训练阶段的短程潜在计算和逐步监督,让模型在部署时跳过额外推理步骤,仍能保留训练带来的推荐收益。
TGR-Reason 的实践则展示了另一层工程取舍:将部分计算放到线上请求之外,再复用提前生成的结果。两者都在探索如何减少在线推荐的推理成本,但各自的实验收益和适用范围仍需分开看待。
相关论文与报告:
 发表于 半小时前
|
查看: 6|
回复: 0
 /1


