学爬虫时,经常会遇到一条路线:先找到签名参数,再尝试还原生成逻辑。扣 JS、还原 AST、伪造 window 和 navigator,最后还要应对平台改版。
MediaCrawler 的 README 介绍了另一种思路:打开真实浏览器,登录账号,再利用浏览器上下文获取签名。不过,这并不意味着它从不使用本地签名。实际代码针对不同平台采用了不同方案,下面会逐一拆开。
MediaCrawler 是一个使用 Python 编写的多平台自媒体数据采集器,公开代码覆盖小红书、抖音、快手、B 站、微博、贴吧和知乎。
项目涉及四类采集对象:
- 内容:帖子、视频、问答正文及元数据。
- 评论:一级评论,以及可选的二级回复。
- 创作者:指定创作者的主页和作品列表。
- 媒体文件:封面、视频、图文图片及实况照片等。
采集方式包括关键词搜索、按帖子 ID 获取详情,以及按创作者主页采集。例如:
uv run main.py --platform xhs --lt qrcode --type search
uv run main.py --platform xhs --lt qrcode --type detail
其中,--platform 选择平台,--lt 选择登录方式,如扫码、手机号或 Cookie,--type 选择采集类型。
这个项目值得关注的部分,是它如何处理登录态、签名和跨平台数据存储。
先说明许可限制:原文所分析的版本使用自定义的 NON-COMMERCIAL LEARNING LICENSE 1.1,仅允许学习和研究,禁止商业用途。代码公开不等于符合所有人通常理解的开源许可条件,使用前应以仓库当前的 LICENSE 和相关条款为准。
二、传统路线:把签名算法搬到本地
浏览器请求头中常能看到平台特有的签名字段,例如小红书的 X-s、X-t、X-s-Common,抖音的 a_bogus,知乎的 x-zse-96,以及 B 站的 w_rid。
这些值可能与请求 URL、参数、时间戳或 Cookie 中的字段有关。具体依赖哪些输入,要看平台和接口;相关输入变化后,原签名可能失效。
一种常见的处理流程是:
- 在开发者工具里搜索参数名,定位相关的混淆 JS。
- 把相关 JS 提取出来,尝试放到 Node 中运行。
- 遇到
window、document、navigator、localStorage 等浏览器环境依赖。
- 逐项补环境,直到代码能够运行。
这条路线的难点不只是首次还原,还包括后续维护:平台调整参数或算法时,本地实现也可能需要跟着修改。
三、浏览器上下文:让页面参与签名
MediaCrawler 的 README 将技术原理概括为:
基于 Playwright 浏览器自动化框架登录保存登录态;利用保留登录态的浏览器上下文环境,通过 JS 表达式获取签名参数;无需逆向复杂的加密算法。
简单说,一部分签名可以在保留登录态的页面中获取,而不必由项目自行完整实现算法。
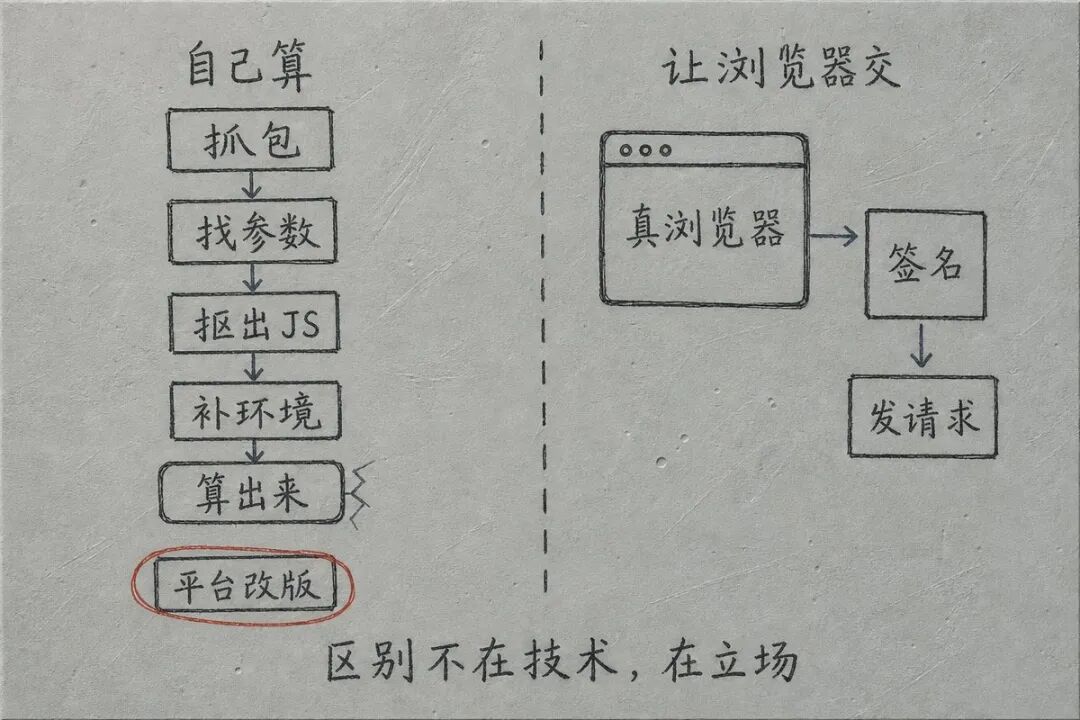
浏览器方案可以减少某些环境模拟和算法还原工作,但也有代价:浏览器占用更多资源,页面加载和运行环境会影响采集效率。使用页面内代码也不保证平台改版后永远无需维护,接口、调用方式或登录流程变化都可能影响项目。
更重要的是,这只是项目的一条技术路线。后文会看到,小红书、抖音等平台还使用了本地算法库或 JS 运行时。
四、CDP 模式:连接 Chrome
原文分析的 config/base_config.py 中,CDP 相关配置如下:
ENABLE_CDP_MODE = True
CDP_DEBUG_PORT = 9222
CDP_CONNECT_EXISTING = True
BROWSER_LAUNCH_TIMEOUT = 60
启用 ENABLE_CDP_MODE 后,项目可以通过 Chrome DevTools Protocol 连接 Chrome。CDP_CONNECT_EXISTING = True 表示尝试连接已有浏览器;能否连接还取决于远程调试是否开启以及浏览器版本等条件。
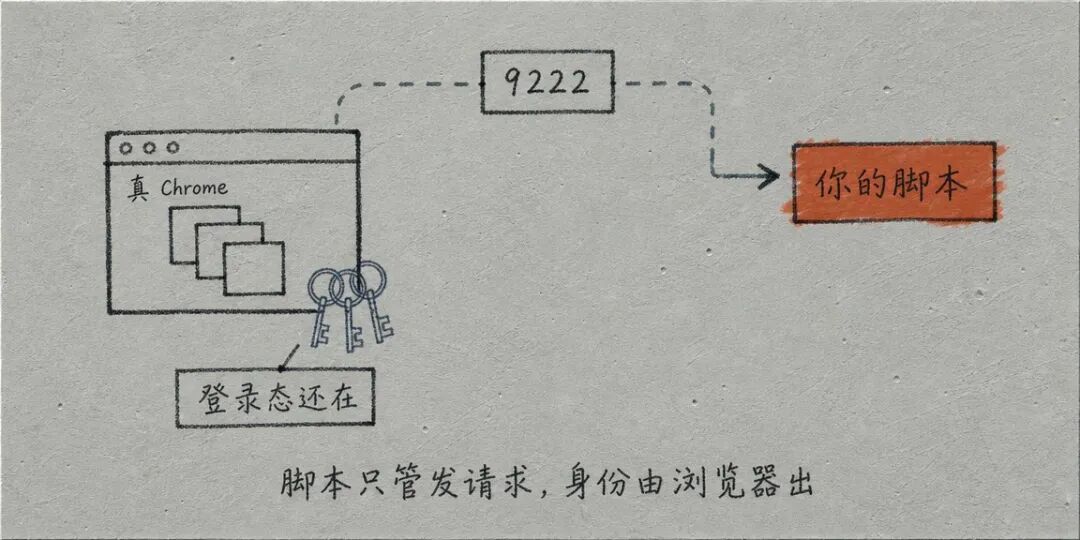
与新建浏览器配置相比,已有浏览器可能保留 Cookie、本地存储、访问历史和插件等状态。不过,使用真实浏览器并不等于一定通过平台风控,也不代表所有自动化特征都会消失。
tools/cdp_browser.py 中的连接代码为:
self.browser = await playwright.chromium.connect_over_cdp(
    ws_url, timeout=config.BROWSER_LAUNCH_TIMEOUT * 1000
)
连接前,程序会请求 http://localhost:{port}/json/version 获取 WebSocket 地址。原文所分析的实现还包含端口选择和连接等待逻辑,超时时间由 BROWSER_LAUNCH_TIMEOUT 控制。
连接后,代码还会尝试注入 libs/stealth.min.js:
async def add_stealth_script(self, script_path: str = "libs/stealth.min.js"):
该脚本用于处理部分自动化特征,但它不是绕过检测的保证。整体思路可以概括为:使用浏览器环境,通过 CDP 控制,再尝试调整部分自动化痕迹。
五、登录态:浏览器与请求客户端如何分工
模拟登录接口通常要处理签名、验证码、设备信息或短信验证。MediaCrawler 提供扫码、手机号和 Cookie 等登录方式:
LOGIN_TYPE = "qrcode"  # qrcode or phone or cookie
COOKIES = ""
扫码登录时,用户在平台页面完成扫码,程序再保存登录态:
SAVE_LOGIN_STATE = True
保存后,后续运行有机会复用登录态,但它仍可能过期或被平台撤销,不能假定一次登录就能永久无人值守。
在 media_platform/xhs/core.py 中,项目会转换浏览器上下文中的 Cookie:
cookie_str, cookie_dict = await utils.convert_browser_context_cookies(
    self.browser_context,
    urls=self.cookie_urls,
)
浏览器上下文里的 Cookie 包含 domain、path、expires、httpOnly 等字段;项目将其转换为 a=1; b=2 一类的字符串,供后续请求使用。
因此,这里的分工是:浏览器负责登录和提供必要的上下文,后续数据请求则由 httpx 等客户端处理。
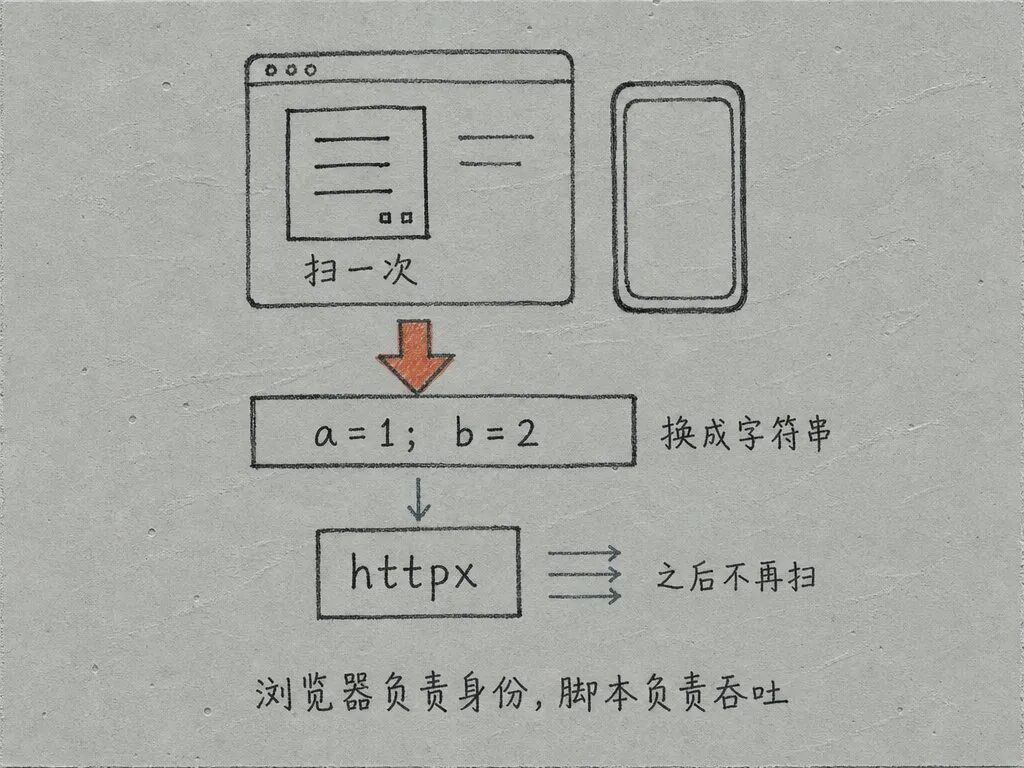
为什么不把所有请求都放到浏览器里?浏览器和 HTTP 客户端的资源开销、连接管理方式不同,httpx 支持连接池和异步请求,适合承担数据请求。但实际吞吐量取决于接口、网络、平台限制和配置,不能仅凭使用异步就保证某个请求数量。
六、七个平台的五类签名路线
既然 README 提到了浏览器上下文,七个平台是否都依赖页面计算签名?并不是。原文分析的代码采用了不同方式:
| 平台 |
签名方式 |
签名计算依赖 |
| 小红书 |
使用纯 Python 库 xhshow |
本地算法库 |
| 抖音 |
通过本地 JS 运行时执行 douyin.js |
Node、webmssdk 相关代码 |
| 快手 |
在页面上下文中求值 |
Playwright 页面 |
| B 站 |
从 localStorage 获取 key,再在本地计算 wbi |
页面提供 key |
| 知乎 |
本地调用 sign(url, cookie) |
本地签名代码 |
| 贴吧 |
参数拼接后计算 MD5 |
本地签名代码 |
| 微博 |
原文所述请求不需要签名 |
Cookie |
这里的“签名计算依赖”不代表整个平台采集流程完全不需要浏览器;登录和获取上下文仍可能依赖浏览器。
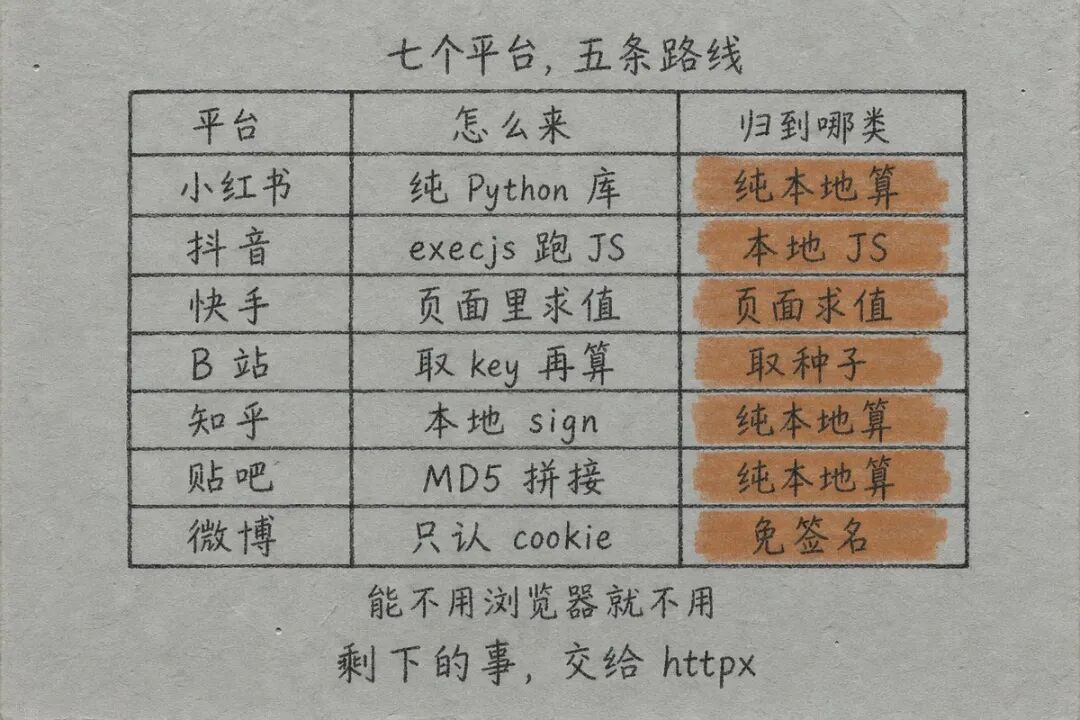
代码并没有坚持所有平台都由浏览器代算:
- 能使用本地算法库的,使用本地算法。
- 有现成 JS 实现的,可以交给 JS 运行时。
- 需要页面上下文的,再由页面求值。
这些路线各有维护成本,不能简单视为技术水平的高低。
七、小红书:从页面求值到纯 Python 库
早期方案会在页面上下文调用小红书 JS 函数,获取 X-s 等参数。原文分析的 media_platform/xhs/playwright_sign.py 则使用第三方 Python 库 xhshow:
from xhshow import Xhshow

xhshow_client = Xhshow()

headers = xhshow_client.sign_headers_post(
    uri=uri,
    cookies=cookie_str,
    payload=data if isinstance(data, dict) else {},
)
随后提取请求头:
return {
    "x-s": headers.get("x-s", ""),
    "x-t": headers.get("x-t", ""),
    "x-s-common": headers.get("x-s-common", ""),
    "x-b3-traceid": headers.get("x-b3-traceid", get_trace_id()),
}
代码注释提到依赖 xhshow>=0.2.0,原因是该版本修复了 GET 请求中的 a3_hash 计算问题,不再需要本地 monkey-patch。
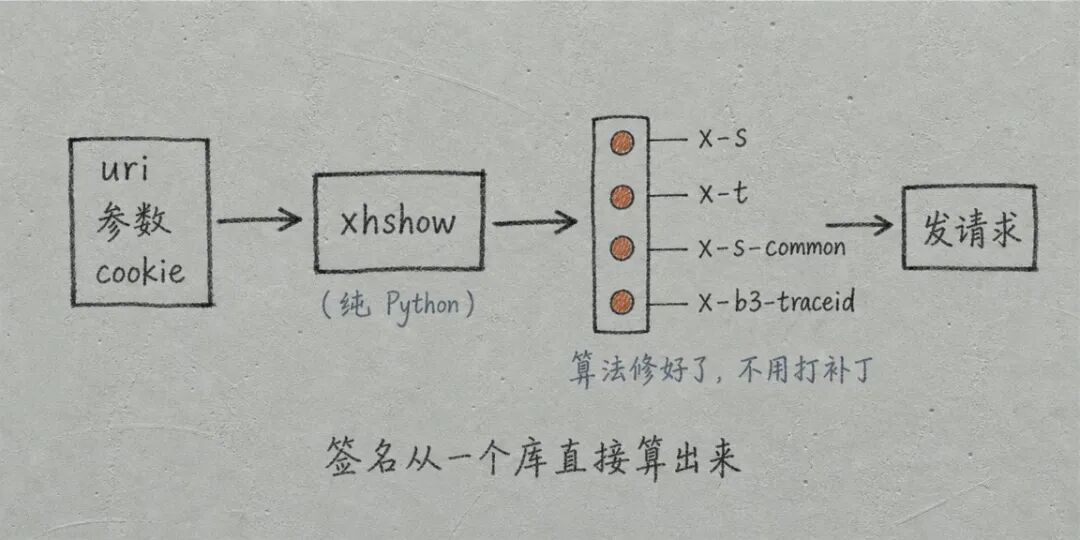
纯算法方案减少了签名计算对页面的依赖,但也增加了对第三方库维护的依赖。平台调整相关逻辑后,库和调用方可能都需要更新;更新是否及时,取决于具体改动和维护情况。
八、抖音:用 JS 运行时计算签名
抖音相关签名参数包括 a_bogus。项目通过 Python 的 execjs 加载 JS 代码。原文引用的 media_platform/douyin/help.py 中有:
douyin_sign_obj = execjs.compile(
    open('libs/douyin.js', encoding='utf-8-sig').read()
)
不同接口使用不同的函数名:
def get_a_bogus_from_js(url: str, params: str, user_agent: str):
    sign_js_name = "sign_datail"
    if "/reply" in url:
        sign_js_name = "sign_reply"
    return douyin_sign_obj.call(sign_js_name, params, user_agent)
这里保留了原代码中的 sign_datail 拼写,因为它是调用的函数名,不能仅凭拼写习惯擅自修改。代码体现出详情与回复接口使用不同入口,但仅凭这段代码,无法断言平台为什么这样设计。
media_platform/douyin/client.py 中还有关于 x-tt-argus 的注释,提示所分析代码对应的网关当时尚未校验该头的值,将来若开始校验,可能重新出现 Signature Not Found。这类注释记录的是特定时期的观察,不能保证当前平台行为不变。
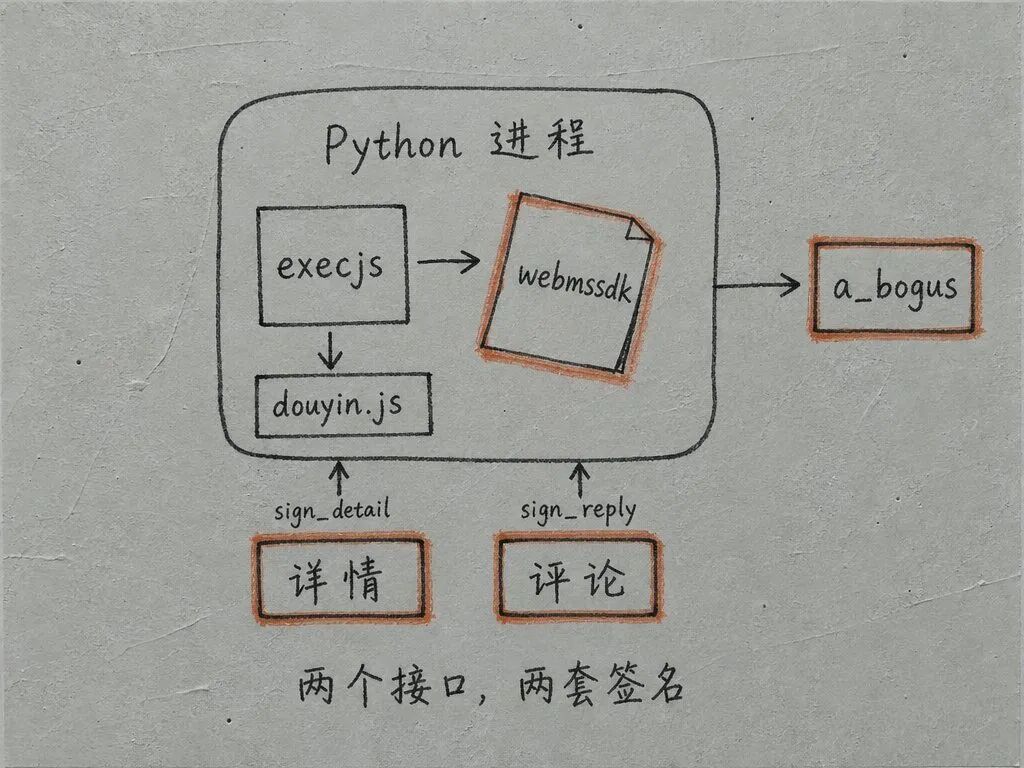
运行这条路径需要 JS 运行时。原文所述安装要求为 Node.js 16 或以上;实际使用时应以仓库当前文档为准。
九、快手:在页面上下文求值
原文所述快手 GraphQL 请求将签名放在 URL 的 __NS_hxfalcon 参数中。media_platform/kuaishou/client.py 的调用示意为:
sign = await get_ks_sign_from_playwright(
    self.playwright_page,
    ...
)
url = f"{self._rest_host}{uri}?__NS_hxfalcon={sign}&caver=2"
其中 ... 是原文省略的调用参数,不是完整可运行示例。
函数通过 Playwright 页面上下文获取签名。页面求值可以利用页面当前加载的运行环境,但也要等待页面可用,并且仍可能受到页面结构、函数接口和平台校验变化的影响。
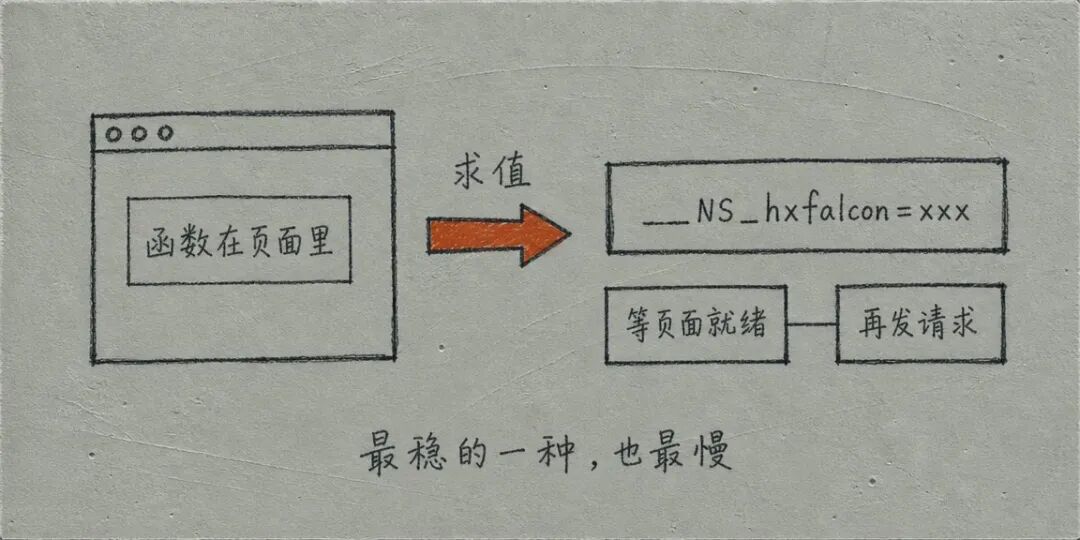
对比来看:
- 页面求值:利用页面环境,但需要维护浏览器和页面状态。
- 纯算法:签名计算可以脱离页面,但平台变化时需要更新实现。
- 本地 JS:不一定需要为每次签名打开页面,但本地 JS 文件仍需维护。
十、B 站:获取 wbi key 后本地计算
原文分析的 B 站实现先从页面的 localStorage 中读取 key:
async def get_wbi_keys(self) -> Tuple[str, str]:
    local_storage = await self.playwright_page.evaluate("() => window.localStorage")
    wbi_img_urls = local_storage.get("wbi_img_urls", "")
原文中的 wbi_img_urls 示例为:
https://i0.hdslb.com/bfs/wbi/7cd084941338484aae1ad9425b84077c.png-https://i0.hdslb.com/bfs/wbi/4932caff0ff746eab6f01bf08b70ac45.png
从两个 URL 的文件名中提取哈希,可得到 img_key 和 sub_key,再用于本地签名:
img_key, sub_key = await self.get_wbi_keys()
return BilibiliSign(img_key, sub_key).sign(req_data)
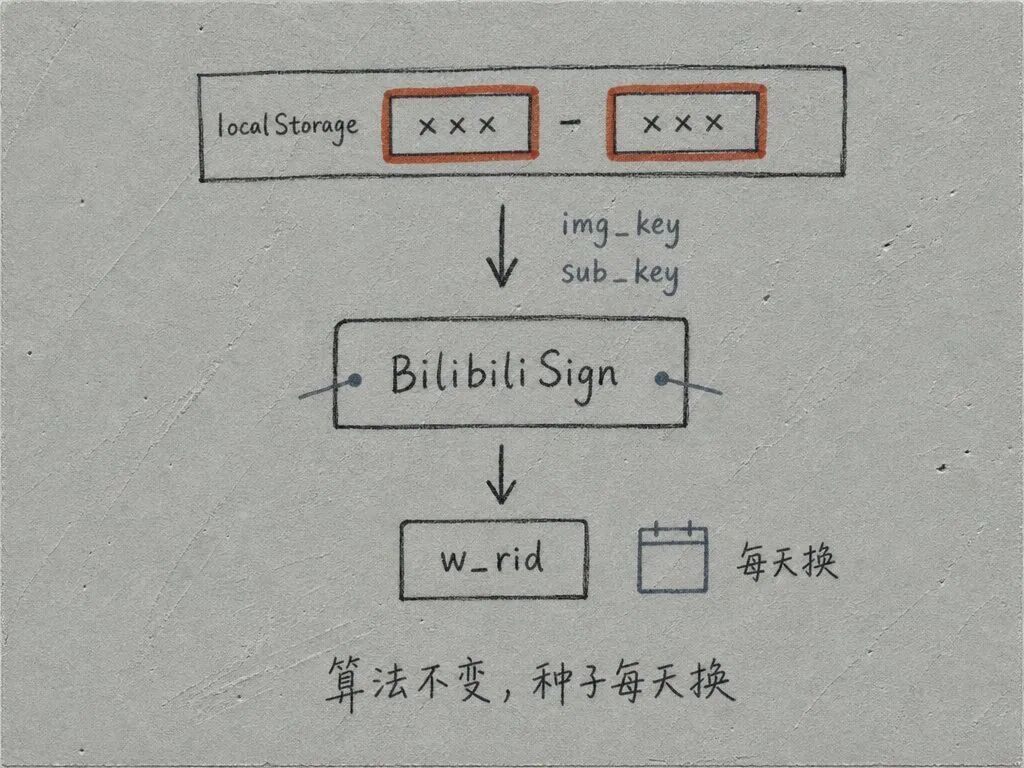
这是一种“获取动态数据,再在本地计算”的方案。原文将 key 描述为每日变化;实际刷新周期、获取方式和登录要求可能随平台调整,不宜把它们视为永久不变的接口契约。
十一、知乎和贴吧:两种本地签名
知乎相关代码将 URL 和 Cookie 字符串传给签名函数:
sign_res = sign(url, self.default_headers["cookie"])
headers['x-zst-81'] = sign_res["x-zst-81"]
headers['x-zse-96'] = sign_res["x-zse-96"]
Cookie 是签名输入之一,因此不同账号或不同登录态下的结果可能不同,不能简单复用另一份登录态的签名。
贴吧的 media_platform/tieba/client.py 则使用参数排序、字符串拼接和 MD5:
PC_SIGN_SECRET = "36770b1f34c9bbf2e7d1a99d2b82fa9e"

def _sign_pc_params(params: Dict[str, Any]) -> str:
    sign_text = ""
    for key in sorted(params.keys()):
        if key in {"sign", "sig"} or params[key] is None:
            continue
        sign_text += f"{key}={params[key]}"
    sign_text += PC_SIGN_SECRET
    return hashlib.md5(sign_text.encode("utf-8")).hexdigest()
需要注意,代码将各个 key=value 直接连续拼接,并未在字段之间插入 &。之后再追加固定字符串并计算 MD5。
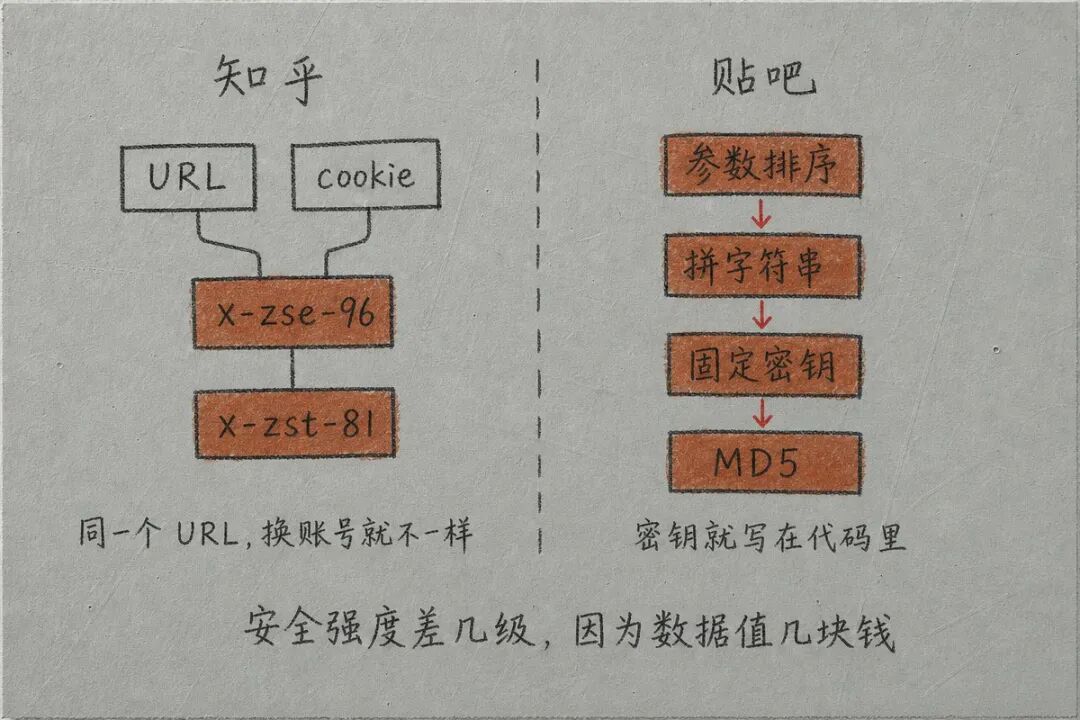
两种实现的复杂程度不同,但仅凭客户端签名代码,不能判断平台完整的风控强度或其设计原因。
十二、微博:同步 Cookie 后发请求
原文引用的 media_platform/weibo/client.py 初始化逻辑比较直接:
await self.playwright_page.goto(self._host)
await self.update_cookies(browser_context=self.playwright_page.context)
程序访问首页、同步 Cookie,再发起后续请求。原文分析的这条路径没有展示额外签名,但不代表微博所有接口都不需要签名,也不代表登录后所有数据都可访问。
账号状态、权限和访问频率仍然会影响结果。总体来看,每支持一个平台,就可能增加一套需要持续维护的接口与登录逻辑。
十三、请求层:默认配置比较保守
原文所述 config/base_config.py 中有三个参数:
CRAWLER_MAX_NOTES_COUNT = 15
MAX_CONCURRENCY_NUM = 1
CRAWLER_MAX_SLEEP_SEC = 2
它们分别控制采集数量、并发数和请求间隔相关行为。具体数量限制是否会受到分页等实现细节影响,应结合当前版本代码确认。
media_platform/xhs/core.py 中使用信号量限制并发:
semaphore = asyncio.Semaphore(config.MAX_CONCURRENCY_NUM)
原文展示的调用片段为:
async with semaphore:
    ...
await asyncio.sleep(config.CRAWLER_MAX_SLEEP_SEC)
这里的 ... 表示省略的业务代码。异步和信号量提供了并发控制能力,但默认并发值为 1。
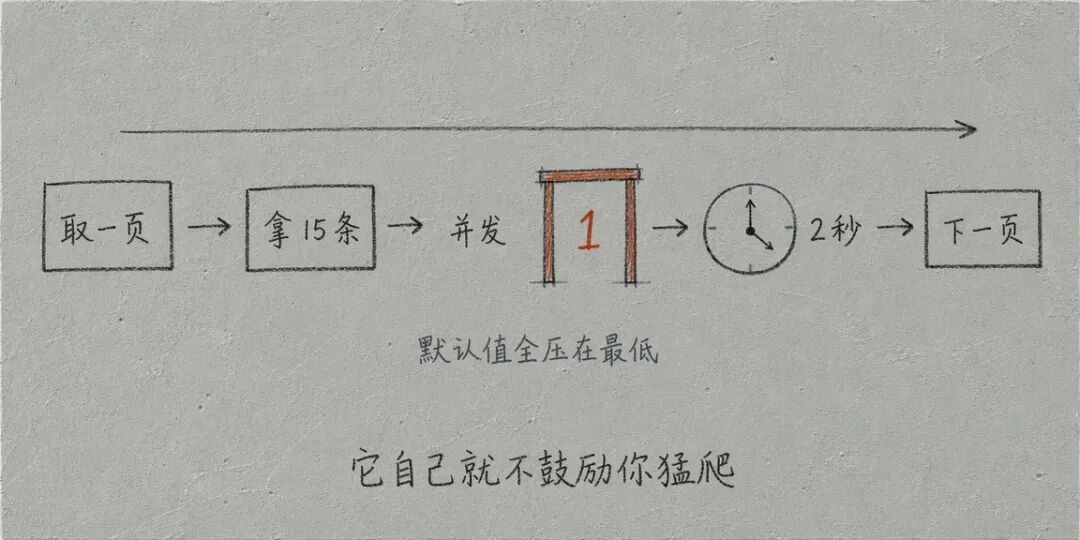
README 也要求避免大规模采集、合理控制请求频率,避免干扰目标平台。低并发并不能消除账号或合规风险,但有助于减少不必要的请求压力。
十四、代理、证书与浏览器关闭
原文中的代理配置默认关闭:
ENABLE_IP_PROXY = False
IP_PROXY_POOL_COUNT = 2
IP_PROXY_PROVIDER_NAME = "kuaidaili"  # kuaidaili | wandouhttp | static
STATIC_PROXY_URL = ""
配置列出了快代理、豌豆 HTTP 和静态代理选项。代理可以改变请求出口,但不会自动消除账号关联:使用同一个 Cookie 时,相关行为仍可能与该账号关联。
另一个需要谨慎处理的选项是:
DISABLE_SSL_VERIFY = False
原文注释指出,只有使用可能注入自签证书的企业代理、Burp Suite、mitmproxy 等中间人代理时,才可能需要调整。禁用 SSL 验证会增加中间人攻击风险,不应在生产环境中随意开启。
还有浏览器关闭配置:
AUTO_CLOSE_BROWSER = True
如果项目连接的是正在使用的 Chrome,运行结束时应注意浏览器是否会被关闭,以及当前版本如何处理已有浏览器和上下文。原文建议在意外关闭风险较高时调整为:
AUTO_CLOSE_BROWSER = False
修改后也应先用不含重要工作标签的浏览器环境验证实际行为,不能仅凭配置名假定程序一定会关闭或保留哪些上下文。
连接等待时间由下列配置控制:
BROWSER_LAUNCH_TIMEOUT = 60
如果远程调试未启用,程序可能在启动阶段等待并最终报错。原文提示可检查 chrome://inspect/#remote-debugging 中的相关设置;可用选项取决于 Chrome 版本。
十五、存储层:七种落盘方式与去重差异
原文所述默认配置为 JSONL:
SAVE_DATA_OPTION = "jsonl" # csv or db or json or jsonl or sqlite or excel or postgres
配置列出 CSV、数据库、JSON、JSONL、SQLite、Excel 和 PostgreSQL 等选项。原文还在 store/xhs/_store_impl.py 中列举了 CsvStoreImplement、JsonStoreImplement、JsonlStoreImplement、DbStoreImplement、SqliteStoreImplement、MongoStoreImplement、ExcelStoreImplement 等类。
类名和配置选项并不完全一一对应,实际支持情况应以当前版本的注册逻辑和存储文档为准。
存储抽象围绕三个方法展开:
async def store_content(self, content_item: Dict)
async def store_comment(self, comment_item: Dict)
async def store_creator(self, creator_item: Dict)
它们对应内容、评论、创作者三类对象。model/ 目录下按平台组织模型文件,例如 m_xiaohongshu.py、m_douyin.py、m_kuaishou.py、m_bilibili.py、m_weibo.py、m_baidu_tieba.py 和 m_zhihu.py。
跨平台统一入口并不意味着各平台字段完全一致。收藏数、播放时长、话题标签、回答数等字段各有差异,使用时仍需检查对应模型和实际落盘数据。
field.py 中还保存了平台枚举,例如:
class FeedType(Enum):
    RECOMMEND = "homefeed_recommend"
    FASION = "homefeed.fashion_v3"
    FOOD = "homefeed.food_v3"
FASION 虽然看起来像拼写错误,但这里是原代码中的标识符,不应未经检查就改名。
存储实现的一个关键差异是去重。原文展示的数据库分支采用先查再写:
async def store_content(self, content_item: Dict):
    ...
    if await self.content_is_exist(session, note_id):
        await self.update_content(session, content_item)
    else:
        await self.add_content(session, content_item)
JSONL 分支则以追加写入为主:
async def store_content(self, content_item: Dict):
    await self._writer.write(...)
以上两段中的 ... 均为原文省略的代码。
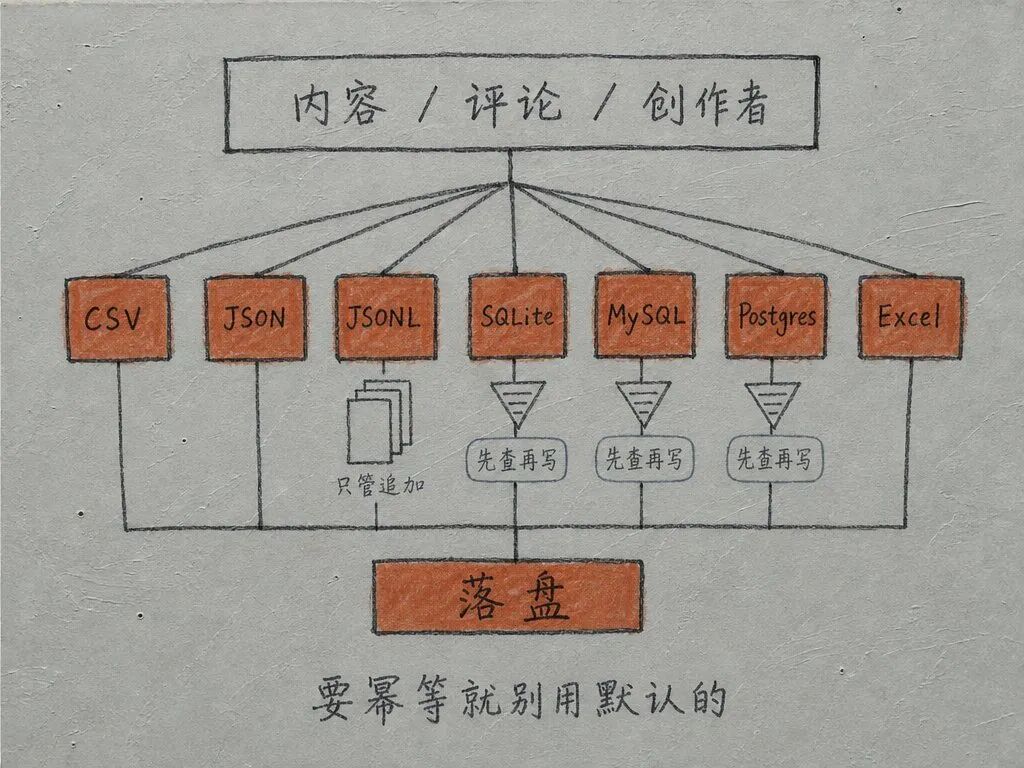
因此,重复采集相同内容时,默认 JSONL 可能产生重复记录。需要幂等时,应检查所选数据库实现的去重逻辑、唯一约束及并发行为;不能仅凭“先查再写”就认定所有并发场景都能保证不重复。
一次性分析可以优先考虑便于处理的文件格式;长期维护数据集时,则需要进一步考虑更新、去重和查询。
十六、媒体下载:合流、实况与串行处理
ENABLE_GET_MEDIA 在原文所述配置中默认关闭。开启后,媒体文件按帖子聚合,目录示意如下:
data/xhs/media/{帖子ID}/
├── cover.jpg
├── video.mp4
├── 001.jpg
└── 001_live.mp4
B 站音视频合流。 原文所述实现中,安装 ffmpeg 后可下载 DASH 音视频并合流;未安装时会尝试降级到 MP4 直链,并使用 video-durl.mp4 区分产物。可用清晰度取决于资源、账号权限和接口返回。
清晰度由 config/bilibili_config.py 中的 BILI_QN 控制,原文所述默认目标为 1080p;权限不足时可能逐档降级。
实况照片配对保存。 小红书和抖音的实况照片可以拆成静态图和随附短视频,例如 001.jpg 与 001_live.mp4。原文指出,缺失媒体会保留序号空位;项目不把两者合成为手机相册中的 Live Photo,也不转换成 GIF。
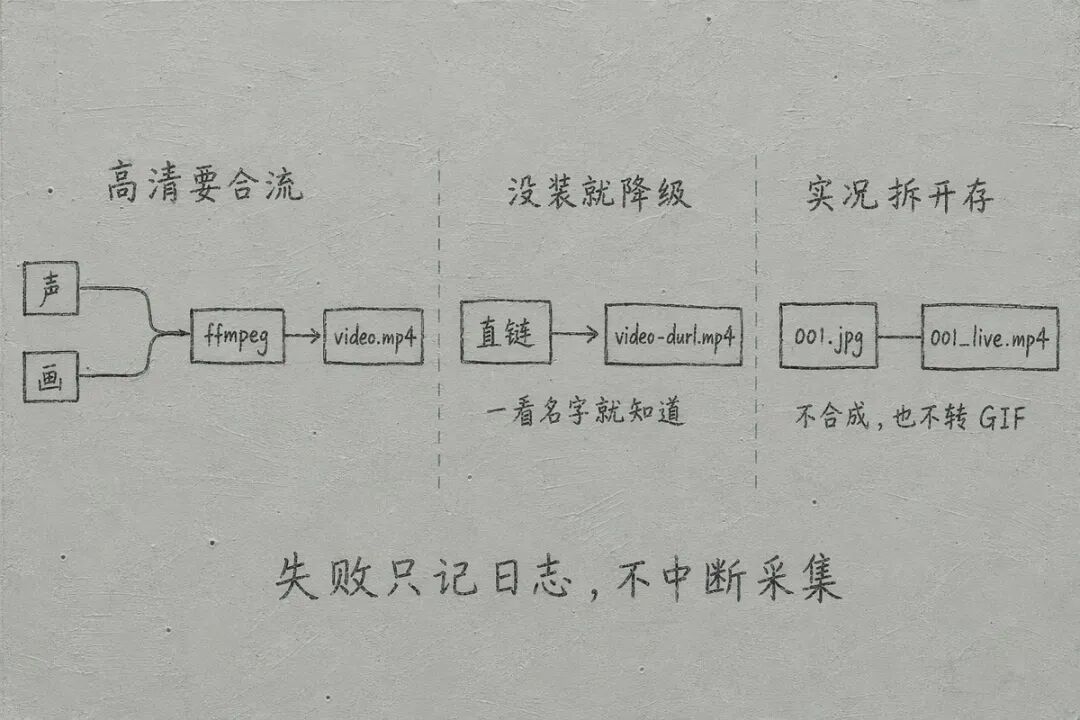
下载采用串行处理。 README 给出的理由是避免给平台 CDN 造成压力。原文还指出,下载失败会记录日志而不中断采集;已存在的文件会跳过,如需重新下载可删除相应目录。具体行为仍应以当前版本实现为准。
十七、WebUI:参数、日志和数据预览
项目还提供 Web 界面,原文所述后端使用 FastAPI,前端使用 Vite。开发模式需要分别启动:
uv run uvicorn api.main:app --port 8080 --reload
cd webui && npm install && npm run dev # 5173,代理 /api 到 8080
原文介绍,生产模式需要将前端构建结果放入 api/webui/,再启动 8080 端口上的后端服务。构建输出路径和启动步骤应以当前项目配置为准。
界面主要用于填写参数、查看运行日志与状态,以及预览和导出数据。
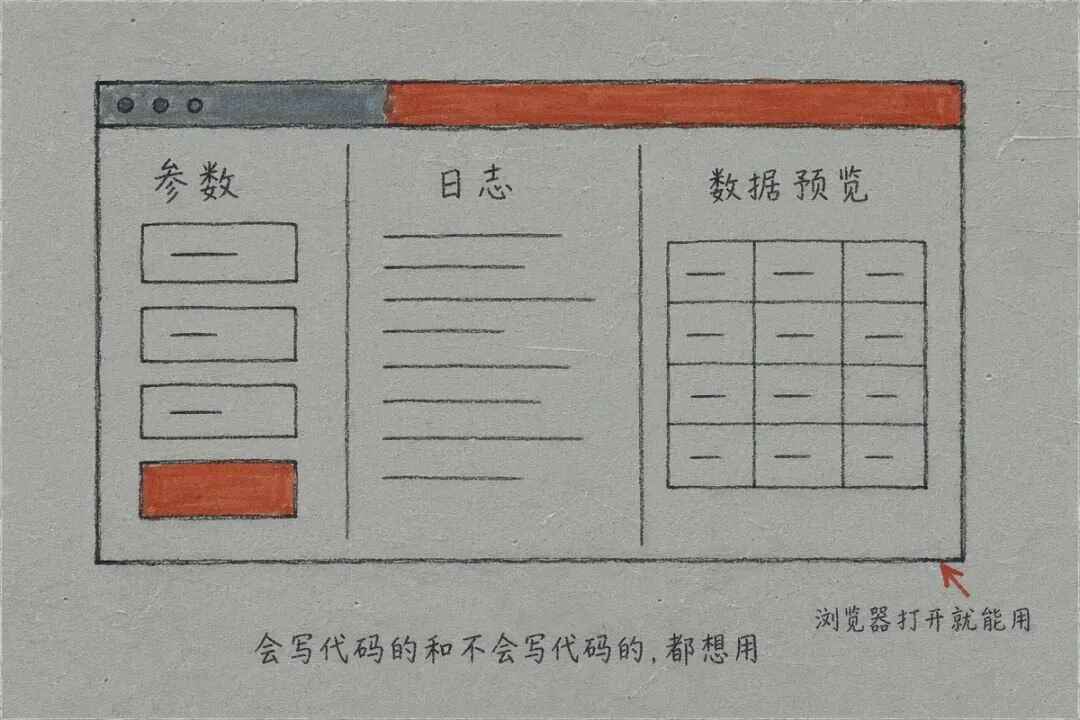
命令行适合熟悉参数的开发者,WebUI 则降低了查看状态和操作配置的门槛。不过,有界面不意味着不需要处理登录、依赖安装和运行报错。
十八、评论词云:快速查看文本
原文中的词云配置如下:
ENABLE_GET_WORDCLOUD = False
CUSTOM_WORDS = {
    "零几": "年份",
    "高频词": "专业术语",
}
STOP_WORDS_FILE = "./docs/hit_stopwords.txt"
FONT_PATH = "./docs/STZHONGS.TTF"
开启后,项目使用 jieba 分词和 wordcloud 生成评论词云。CUSTOM_WORDS、停用词文件和字体路径用于调整中文文本处理及展示效果。
词云适合快速浏览高频词,但词频本身不能直接解释情绪、观点或因果关系。要做进一步分析,还需要结合原始评论、采样范围和具体方法。
十九、维护代价:签名和接口会变化
这类项目的核心依赖之一,是平台接口在当前实现下仍然可用。常见变化包括:
- 增加字段:请求或签名输入发生变化,本地库和调用代码可能需要更新。
- 更换算法:原有本地实现失效,需要重新适配。
- 增加校验:原先未严格校验的字段开始参与验证,请求可能突然失败。
错误表现可能是 403、空结果或签名相关提示,但这些现象也可能由登录态、权限、网络等其他原因造成,不能只凭状态码断定具体原因。
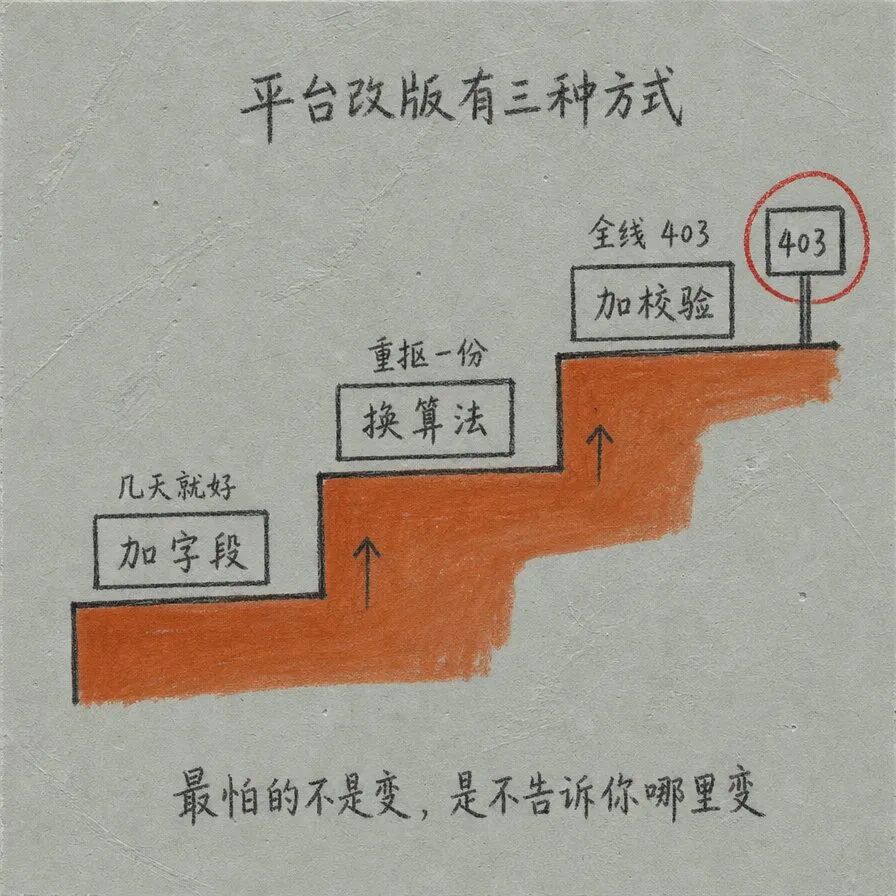
项目能否持续使用,取决于维护者和使用者对平台变化的跟进。文章中引用的代码与配置属于特定时间点的分析,阅读时应对照仓库当前版本。
二十、账号与法律风险
原文引用的 README 声明强调:
本仓库的所有内容仅供学习和参考之用,禁止用于商业用途。
原文所分析的许可证为 NON-COMMERCIAL LEARNING LICENSE 1.1。是否允许某种具体用途,应阅读当前许可证全文及相关条款,不能因为代码公开就默认可以商用。
账号方面也有实际风险:
- 登录态和访问行为可能与账号关联。
- 高频访问可能触发验证码、限流或账号限制。
- 使用个人账号时,受到影响的可能是日常使用的账号。
使用前还应考虑适用法律、平台规则、隐私和数据保护要求。登录成功或技术上能够访问,不等于可以不受限制地采集、保存或使用数据。
二十一、公开代码版本的边界
原文提到,README 中还介绍了 MediaCrawlerPro,并列举了与公开代码版本不同的功能方向,包括断点续爬、多账号与代理池、减少对 Playwright 的依赖、Linux 环境支持、签名逻辑解耦,以及部分下游分析工具。
这些描述用于区分版本边界,并不意味着公开代码版本适合商业使用,也不代表其他版本的功能和授权条件不会变化。需要判断时,应以对应版本当前文档和许可为准。
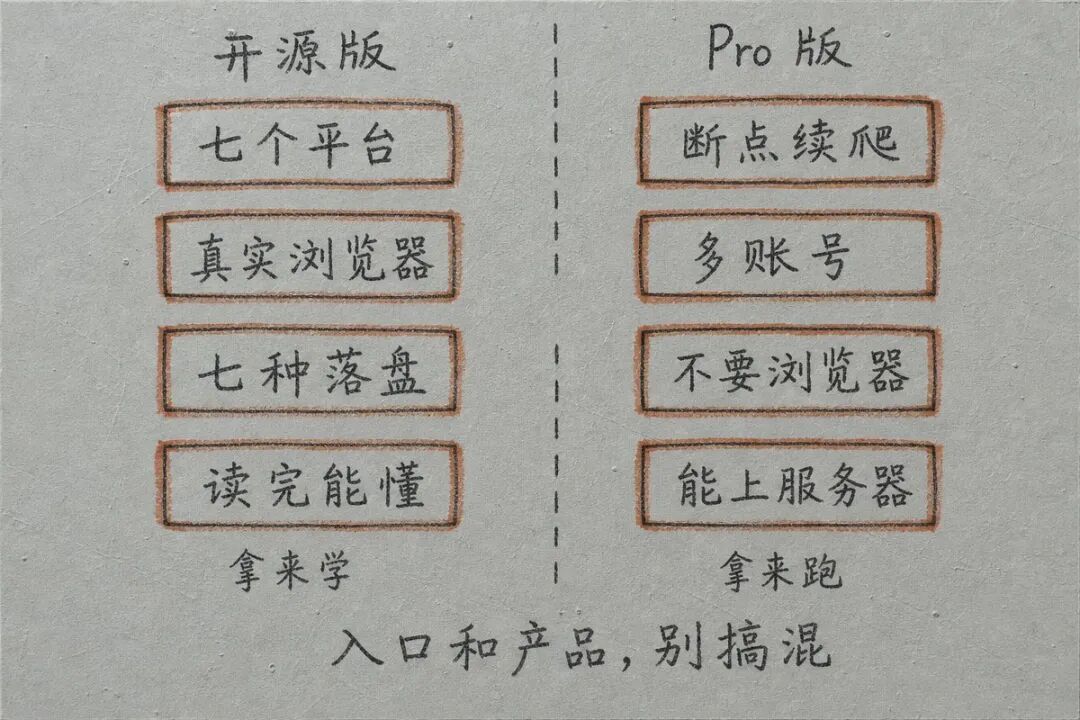
从架构角度看,浏览器降低了某些登录和上下文处理的实现难度,同时也带来了资源占用、环境配置和服务器运行方面的成本。
二十二、适合谁,不适合谁
原文认为,项目比较适合以下学习和研究场景:
- 想了解不同平台的接口组织方式和请求流程。
- 需要在许可及平台规则允许的范围内,获取少量研究样本。
- 有一定 Python 基础,愿意配置 Node、ffmpeg 和浏览器环境。
- 愿意阅读日志、排查登录态和依赖问题。
不适合直接用它来承担这些需求:
- 商业数据服务:原文所述许可证禁止商业用途。
- 无维护地长期稳定采集大量数据。
- 不安装所需运行环境,直接开箱使用所有平台功能。
- 期待“一键生成分析报告”:它主要是采集器,不是完整分析工具。
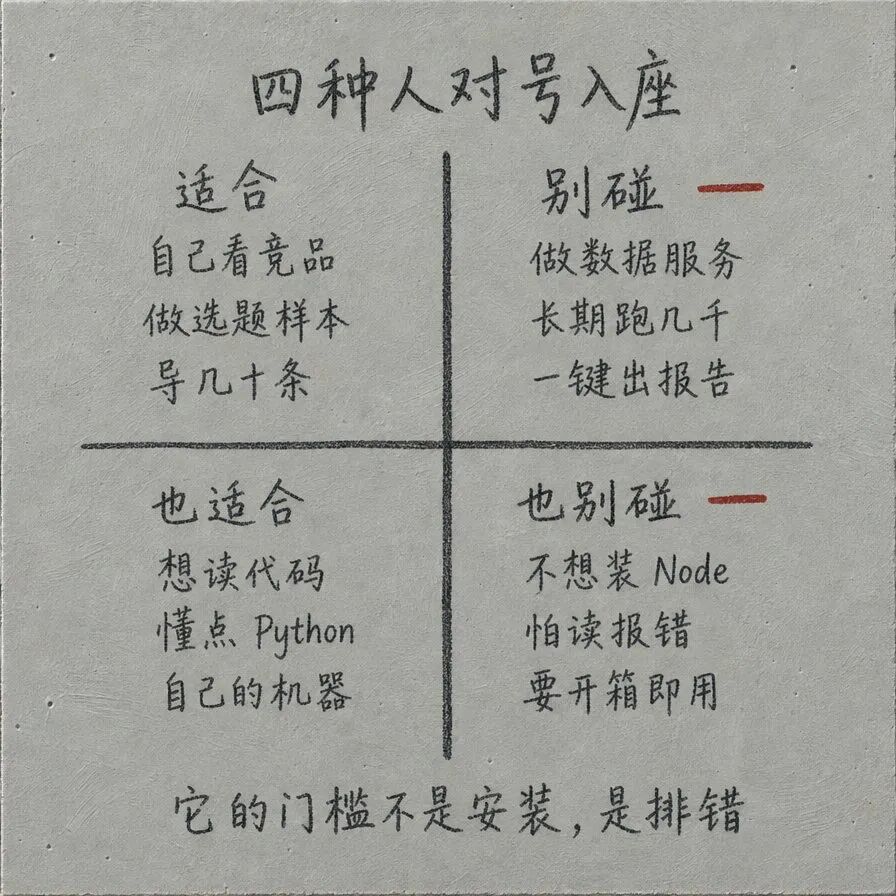
CDP 连接失败、二维码无响应、评论为空或 ffmpeg 缺失,都需要结合日志和具体配置排查。WebUI 可以简化操作,但不能替代对运行环境和错误信息的理解。
二十三、动手前的检查顺序
以下是原文提出的操作思路,并非实测结果。
第一步,先读代码。
查看 media_platform/ 下各平台目录。原文概括的常见分工是:client.py 负责请求,core.py 管理流程,field.py 保存枚举常量,login.py 处理登录,help.py 包含相关辅助或签名逻辑。不同平台和版本的文件分工可能有所差异。
第二步,按当前 README 准备环境。
- 原文所述 Node 版本要求为 16 或以上,部分平台签名依赖 JS 运行时。
- 需要 B 站高清音视频合流时,检查 ffmpeg 是否安装。
- 使用 CDP 时,检查 Chrome 版本和远程调试设置。
第三步,从最小配置开始。
先检查 PLATFORM、KEYWORDS、CRAWLER_MAX_NOTES_COUNT 和 SAVE_DATA_OPTION。原文建议从 5 条和 JSONL 开始观察数据;同时注意 JSONL 不一定去重。
第四步,先用详情模式排查。
使用 --type detail,按当前版本要求配置一个具体帖子 ID,先检查单条内容能否正常获取。评论和媒体是否返回,还取决于对应开关、权限和平台接口。
第五步,先看日志,再判断问题。
CDP 连接问题通常发生在启动阶段;签名、登录态、权限和接口变化都可能导致请求失败或结果为空。评论未获取也可能与 ENABLE_GET_COMMENTS 等配置有关,需要逐项确认,不能只靠一个现象下结论。
结语
MediaCrawler 展示的不是一种适用于所有平台的签名方案,而是一组工程取舍:有的环节使用真实浏览器和登录态,有的使用本地算法库或 JS 运行时,再由 HTTP 客户端承担数据请求。
这些选择各有边界。浏览器并不能保证算法变化时无需维护,本地签名也需要跟进平台更新;账号、许可、平台规则和数据合规问题同样需要使用者自行确认。
把它作为学习多平台采集架构的代码样本,比把它当成无需维护的通用采集器更稳妥。
参考
- MediaCrawler 项目主页:平台支持、安装、CDP 配置与 WebUI 说明。
- 主配置文件:登录、并发、存储、代理和媒体下载配置。
- 小红书签名实现:
xhshow 签名调用及相关版本说明。
- 数据存储指南:存储方式及相关说明。
 发表于 半小时前
|
查看: 6|
回复: 0
 /1


