论文中有一句核心结论精准点出了本文工作的本质:让权重驻留周期与完整草稿步长对齐,可将跨步复用转化为端到端的服务收益。
推测解码是当前大模型推理加速的核心技术路径,通过轻量草稿模型预生成多 token、目标模型并行验证的方式,大幅提升生成吞吐。随着并行草稿技术成熟,主干生成的延迟被持续压缩,原本计算量极低的串行校正头,逐渐成为不可忽视的性能瓶颈。
这个模块仅需更新极小的状态,却要反复加载词表级的大尺寸投影矩阵,带宽开销完全掩盖了计算收益。对于大模型推理服务而言,这类隐蔽的瓶颈往往比显而易见的计算热点更值得警惕。
论文信息:
针对这一问题,加州大学圣迭戈分校团队提出 WEIGHTS THAT STAY 执行方案,通过持久化 Megakernel 将词表投影分片全程驻留 GPU 片上存储,步间仅交换紧凑状态数据,从根源消除权重重复搬运开销。 方案支持全量与部分驻留模式,兼容马尔可夫与循环式串行头,适配 H100 与 B200 两代 GPU 架构。
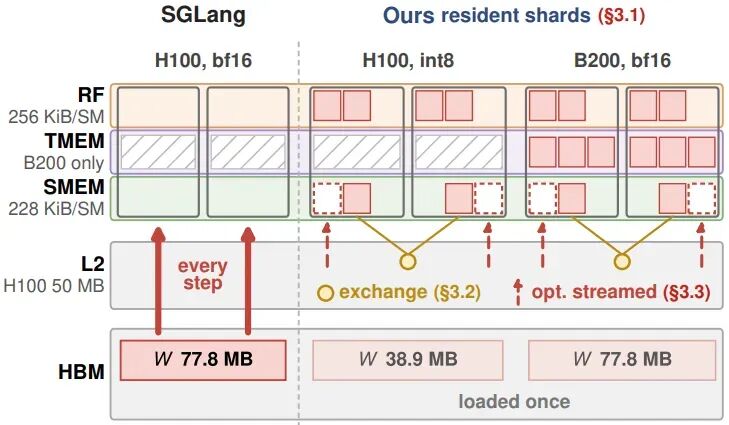
实验数据显示,H100 平台上 DSpark 串行头执行速度相比 SGLang 最快参考路径最高提升 11.6 倍;集成至 SGLang 后,Qwen3-4B 模型马尔可夫草稿的端到端吞吐最高提升 12.3%,Qwen3-8B 提升 8.6%,且几乎不影响草稿接受率。
这项工作揭示了推理优化的重要视角:当计算不再是瓶颈时,数据生命周期与执行边界的对齐,往往能释放显著的性能潜力。
一、推测解码的隐形瓶颈:轻量串行头的带宽困局
在大模型推理加速的赛道上,推测解码已经成为公认的主流技术方向。通过用轻量模型提前生成候选 token,再用目标模型一次性验证,推测解码能够在不损失生成效果的前提下,大幅提升解码吞吐。而随着并行草稿技术的出现,草稿生成的主干延迟被进一步压缩,原本不起眼的串行校正头,逐渐浮出水面成为新的性能瓶颈。
传统自回归解码逐 token 生成,每一步都需执行完整的模型前向,计算开销高、端到端延迟长。推测解码的核心逻辑是用更小的草稿模型快速生成多 token 候选,再将候选批量送入目标模型做一次前向验证,只要候选与目标模型输出一致,即可一次性接受多个 token,减少大模型的调用次数,提升整体生成效率。
早期草稿模型本身仍为自回归结构,生成候选的过程依然串行。后续出现的并行草稿技术,如 DSpark、Domino 等方案,通过一次主干前向传播即可同时生成整段候选的基础特征,大幅压缩了草稿生成延迟。但并行生成存在天然缺陷:块内每个位置的预测无法感知同一块中前面位置实际选出的 token,丢失了块内因果依赖,导致草稿质量下降、接受率降低。
为恢复块内依赖,并行草稿方案都会在主干网络后加入轻量串行校正头。 串行头沿候选块顺序逐步执行,用前面已选出的 token 修正后续位置的预测,重建因果关联。整个过程仅处理低秩特征与小规模状态更新,算术运算量极低。
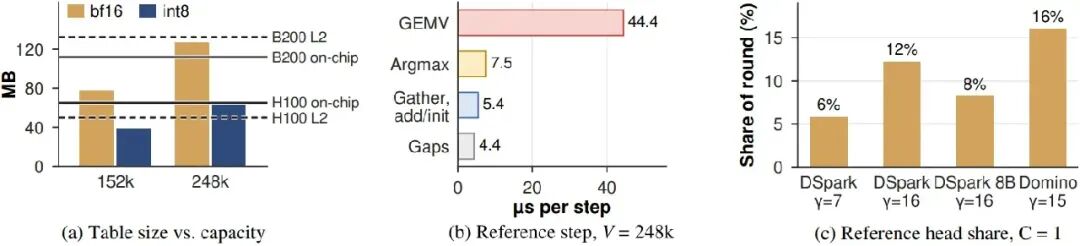
但就是这样一个计算量极轻的模块,在实际服务中可占到单轮推测解码耗时的 12%。 问题的根源不在计算本身,而在内存访问。
串行头的核心操作是将低维隐状态通过词表大小的投影矩阵,映射为完整的词表 logits。该投影矩阵行数等于词表规模,通常超过 15 万行,即便采用低秩设计,整体尺寸仍可达七八十 MB,已经超过 H100 的 L2 缓存容量。
串行头按步逐次执行,每一步都需要使用该投影矩阵做一次映射。在传统算子执行模式下,每一步 kernel 启动都会重新从 HBM 搬运权重,流经缓存层级,计算完成后便不再保留。
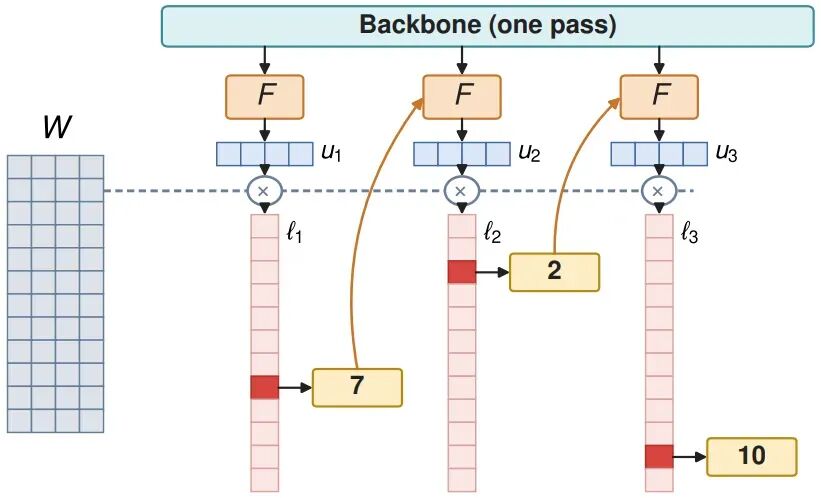
即便权重全程没有任何变化,每一步都要重复加载一次。步长越长,总搬运开销越大。小批量场景下计算量本身极低,内存带宽成为绝对瓶颈,导致这个“轻量”的头实际延迟并不低。
串行头的执行过程可以用四个公式完整描述:
- 第 k 步的隐向量 $u_k = f(s_{k-1}, h_k)$,其中 $s_{k-1}$ 是上一步状态,$h_k$ 是主干网络输出的第 k 个位置槽位特征,$f(\cdot)$ 是状态到隐向量的映射函数;
- 完整的词表 logits $l_k = W u_k + b_k$,其中 $W$ 是词表投影矩阵,尺寸为词表大小 $V \times r$,全程保持不变;$b_k$ 是主干输出的基础 logits;
- 选中的 token $t_k = \text{select}(l_k)$,贪心解码取 argmax,采样则按分布抽样;
- 下一步状态 $s_k = g(s_{k-1}, t_k)$,由状态更新函数 $g(\cdot)$ 生成。
整个流程中只有 $W$ 是大尺寸固定数据,其余均为小尺寸、逐步更新的状态。传统执行方式下每步都要重新加载一次 $W$,而优化方案让 $W$ 常驻片上,仅传递小尺寸状态,精准命中了问题的核心。
就好比需要做 16 道同类数学题,每道题都要查阅同一本厚重的公式手册。传统方式是做一道就把手册放回书架,下一道再重新取,大部分时间都消耗在往返路途中。
更高效的做法是把手册放在桌面,全程不用放回,做完一道直接开始下一道,省下所有取书的时间。 WEIGHTS THAT STAY 做的,就是把这本“公式手册”牢牢固定在 GPU 的“桌面”上。
总之,串行头的性能瓶颈本质上是数据搬运的带宽瓶颈。不变的大尺寸投影矩阵被反复加载,与执行边界的错配导致了严重的资源浪费,这也是本次优化最核心的切入点。
二、核心思路:让权重生命周期与完整步长对齐
既然问题出在权重被反复搬运,最直接的想法就是让权重一直留在片上。但 GPU 的 kernel 启动有天然的边界,寄存器和共享内存里的数据无法跨 kernel 保留。要实现权重的跨步常驻,就必须把整个串行头的多步执行,都放进同一个 kernel 里,也就是用 MegaKernel 的方式来执行完整的草稿步长。
将多步执行融合到单个 kernel 中,只是优化的第一步。如果仅简单地将多步循环写在同一个 kernel 内,每步仍从 HBM 或 L2 重新加载权重,那只能省下 kernel 启动的开销,无法解决权重重复搬运的根本问题。要真正实现权重复用,必须让权重分片在整个步长周期内,固定驻留在每个 SM 的片上存储中,并与计算单元保持稳定的映射关系。
论文提出的“步长常驻执行”的核心,就是将词表投影矩阵按行切分,分配给每个参与计算的 SM,每个 SM 负责固定的一部分词表行。 在整个串行步长执行过程中,这份分片一直保留在该 SM 的片上存储中,不会被换出。每一步执行时,仅需将更新后的隐状态传给每个 SM,SM 即可用自身常驻的权重分片,计算出对应词表行的分数。
通过这种设计,权重仅在 kernel 启动时加载一次,后续所有步均可复用,权重搬运的总数据量与步长数无关。步长越长,节省的搬运开销越多,加速效果越显著。
要实现该设计,需要解决三个耦合的核心问题:
- 稳定的两级映射:既要将词表行稳定分配到不同 SM,也要将每个 SM 的分片稳定映射到内部存储层级与对应计算指令,整个步长过程中映射关系保持不变。
- 分布式的状态推进:每个 SM 仅计算自身负责的词表分数,但 token 选择需要全局结果,状态更新也需在所有 SM 间同步,且该过程不能破坏已建立的权重映射。
- 部分驻留适配:当权重分片尺寸超过片上可用存储容量时,要有降级方案,保留部分权重常驻,剩余部分按需流式加载,尽可能实现最大化复用。
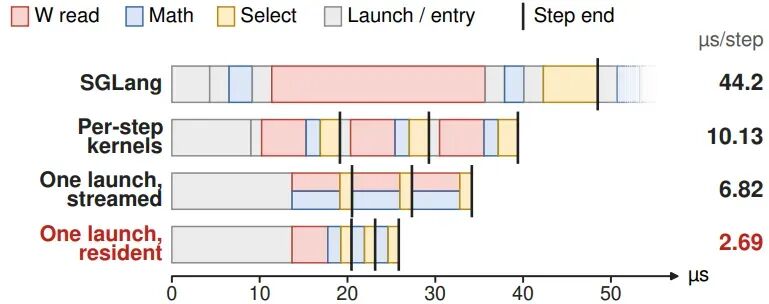
上图对比了三种执行方式的单步延迟:传统单步 kernel 方式每步耗时 44.2 微秒;仅做全步长融合、权重仍每步流式加载的方式,单步耗时降至 6.82 微秒;实现权重常驻的方案,单步耗时进一步降至 2.69 微秒。可以清晰看到,融合带来的收益有限,真正的大头收益来自权重的跨步常驻。
论文给出的拆解数据也印证了这一点:仅做 kernel 融合,即将多步放入同一个 kernel 内,性能仅提升 1.49 倍;在此基础上实现权重常驻,性能可再提升 2.53 倍。 权重重复搬运才是延迟的主要来源,kernel 启动开销仅占很小一部分。
三、分层瓦片映射:构建稳定的权重驻留布局
要让权重常驻片上,不是简单把数据放进共享内存即可。GPU 的片上存储有多个层级,不同的计算指令需要从指定位置读取操作数。合理的分层映射,既要尽可能多地放下权重分片,也要匹配计算指令的操作数路径,让计算效率最大化。
权重的映射分为两个层级:第一个层级是跨 SM 的划分,第二个层级是 SM 内部的存储层级分配。两个层级的映射关系在整个步长过程中保持固定,不随步长变化。
3.1 跨 SM 的行分片划分
整个词表投影矩阵按行划分,每个 SM 对应一个 CTA(线程块),负责固定的一部分词表行,覆盖完整的隐状态维度。例如总共有 15 万行词表、132 个 SM 时,每个 SM 约负责 1100 多行权重。
这种按行划分的方式有两个优势:一是每个 SM 的计算完全独立,拿到隐向量后即可独立计算负责词的分数,无需与其他 SM 通信;二是权重分片边界清晰,每个 SM 仅需管理自身负责的部分,常驻管理逻辑简单。
整个步长过程中,每个 CTA 持续占用一个 SM,不会被调度换出,即采用持久化 kernel 的执行方式。只有这样才能保证权重分片一直保留在片上,不会因线程块换出而丢失。
3.2 SM 内部的存储层级分配
每个 SM 内部的片上存储主要包含寄存器、共享内存,B200 架构还新增了 TMEM(张量内存)。不同存储介质的容量、延迟、访问方式均不相同,对应的计算指令也有区别。
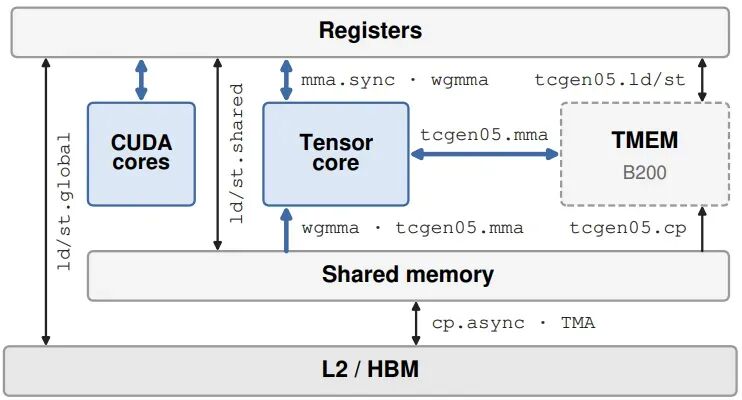
权重 tile 的存储位置,直接决定了可用指令类型、计算效率与可容纳的权重规模:
- 放在寄存器中计算速度最快,无需额外加载步骤,但寄存器容量最小,还需预留空间给计算中间结果、状态数据;
- 放在共享内存中容量更大,但计算前需加载到寄存器,存在额外开销;
- TMEM 是 B200 特有的存储,容量更大且专为张量计算优化,但对应独立的指令集。
设计的核心是在有限的片上存储内,尽可能多地容纳权重 tile,同时尽量将高频访问的瓦片放在更快的存储层级。 且所有存储位置在整个步长内保持固定,无需来回移动,每一步均可直接使用。
这种分层映射设计也为部分驻留预留了空间。当完整分片无法全部容纳时,可将部分 tile 常驻片上,剩余部分保留在 L2 或 HBM,每步需要时再加载。多驻留一片,就减少一片的重复搬运开销。
整体看下来,分层瓦片映射的核心是在容量、延迟、指令兼容性之间找到最优平衡点,用稳定的映射关系支撑跨步的权重复用,为后续的分布式状态推进打下基础。
四、分布式递推协议:固定映射下的串行状态演进
权重分片固定在各个 SM 之后,每个 SM 只能算出自身负责词表的分数。但 token 选择需要从整个词表中选出最优结果,状态更新也需要基于选中的 token 向下推进。如何在不打破权重映射、不移动权重的前提下,完成全局的 token 选择和状态推进,是第二个核心难题。
论文设计了一套分布式状态推进协议,每一步分为四个有序阶段:准备、打分、选择、提交。四个阶段均在同一个持久化 kernel 内完成,权重映射全程保持不变,仅状态与选中 token 在 SM 之间传递。
4.1 四阶段状态流转
| 阶段 |
描述 |
| 准备阶段 |
根据上一步的状态和当前步的基础特征,生成当前步的隐向量,即投影运算的输入。该隐向量全局一致,每个 SM 都需要完整的隐向量计算自身分片。 |
| 打分阶段 |
每个 SM 用自身常驻的权重分片,与准备好的隐向量做矩阵乘法,计算出负责词表行的 logits 分数。该阶段完全并行,SM 之间无需任何通信。 |
| 选择阶段 |
每个 SM 先从自身分片中选出分数最高的 token,随后所有 SM 共同执行一次全局归约,选出整个词表中分数最高的 token,并将结果广播给所有 SM。贪心解码对应取最大值操作,采样则基于分布执行抽样。 |
| 提交阶段 |
根据选中的 token 更新下一步的状态,准备进入下一轮循环。不同类型的串行头,状态更新复杂度不同,所需通信量也存在差异。 |
4.2 跨 CTA 的全局 token 选择
全局选择是整个协议中最关键的同步点,其效率直接影响单步开销。论文采用了基于原子操作的高效实现。
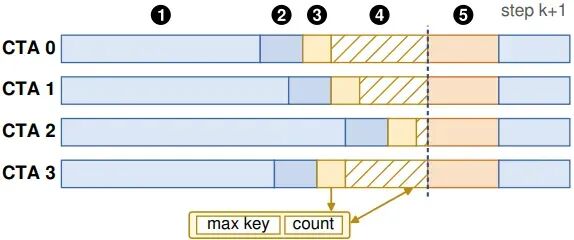
每个 SM 先将本地最优 token 与对应分数,打包为一个 64 位键值。分数部分保证数值顺序,token 部分用于处理同分情况。随后每个 SM 派出一个线程,原子更新全局最大值,同时原子递增一个到达计数器。
所有 SM 均提交完成后,每个 SM 即可读取全局最优 token。为减少读取开销,论文采用了一项优化:将最大值与到达计数器放在对齐的 16 字节空间内,通过一次向量加载同时读取两个值。当读取到的计数器达到总数量时,说明所有 SM 均已提交,同一次加载得到的最大值即为最终结果,无需单独再读一次,节省了一次 L2 往返开销。
4.3 不同头类型的状态更新
不同的串行头,状态更新复杂度不同,所需通信量也存在区别。
- 最简单的是马尔可夫头,状态即为上一个选中的 token。选中 token 后,每个 SM 可直接根据 token id 从嵌入表中查询出下一步的隐向量,无需额外的全局通信。整个过程仅选择阶段存在一次全局同步,开销最小。
- 循环类的头,如 RNN、GRU,状态为低维隐藏向量,更新逻辑更复杂。论文的实现方式是将循环权重矩阵也按行分片到各个 SM。在 token 选择的同时,每个 SM 先计算仅与旧状态相关的部分;token 确定后,再补充 token 对应的输入部分,计算出自身分片的新状态。
由于每个 SM 仅持有自身分片的状态,而下一步投影需要完整的隐向量,因此需要一次全局收集操作:每个 SM 将自身状态分片写入全局缓冲区,等待所有 SM 写入完成后,每个 SM 再读取完整状态,生成下一步的隐向量。 Domino 和 DeLS-Spec 这类 GRU 结构的头,需要两次这样的收集同步,而 DSpark 的 RNN 仅需一次。
测试数据显示,当投影权重实现常驻后,这些跨 SM 的同步与状态更新开销,成为剩余的主要延迟来源。但即便是同步最多的循环头,整体加速比仍可达 8 倍以上,收益非常显著。
总之,这套分布式协议的核心是用最小的通信开销完成全局同步,让状态的流动替代权重的流动,在固定权重映射的约束下,完整实现串行头的递推逻辑。
五、落地适配:H100 与 B200 的差异化内核实现
理论设计最终要落地到具体的硬件架构上。H100 和 B200 两代 GPU 的片上存储资源、指令集均存在差异,论文针对两代架构做了差异化适配,分别实现了最优的常驻方案。
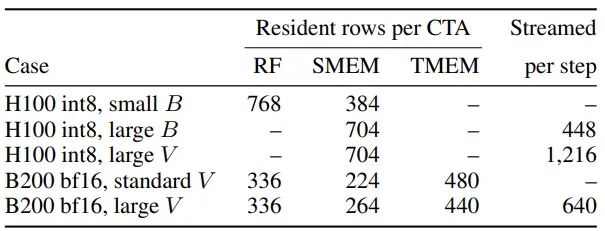
5.1 H100:int8 量化实现全量常驻
H100 每个 SM 的寄存器与共享内存总容量有限,若采用 bf16 格式存储权重,15 万词表的投影矩阵总大小为 77.8MB,已经超过 H100 所有 SM 的片上存储总和,无法实现全量常驻。要实现全量常驻,必须先压缩权重尺寸。
论文选择按行缩放的 int8 量化,将每个权重从 2 字节压缩到 1 字节,整个投影矩阵缩小到 38.9MB,刚好可以容纳在片上。
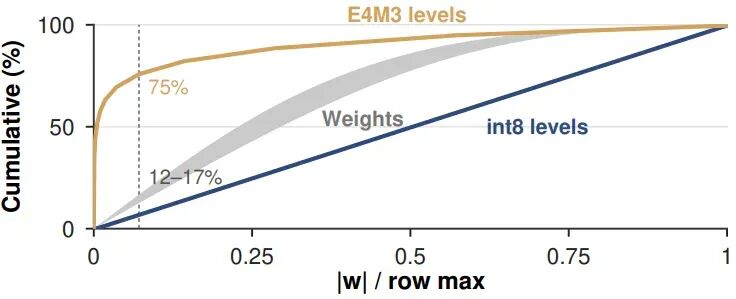
之所以选择 int8 而非 FP8,是因为投影权重呈现有界的钟形分布,不需要很宽的指数范围。int8 的量化级在数值范围内均匀分布,而 FP8 E4M3 将大部分量化级集中在小数值区域,大数值的量化间隔更粗,误差反而更大。测试数据显示,int8 的权重误差仅为 0.58%,而 E4M3 达到 2.64%,精度优势非常明显。
为避免每一步都反量化权重,内核直接使用 int8 张量核指令执行计算。但隐向量若仅用单组 int8 表示,精度可能不足。论文采用双平面 int8 编码方式:将一个 bf16 隐向量拆分为高位和低位两个 int8 向量,高位负责粗粒度数值,低位负责残差,精度相当于两个 int8 叠加,误差极小。
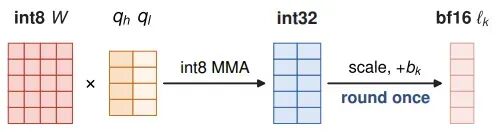
计算时,两个 int8 隐向量与 int8 权重一同通过张量核做乘加,结果用 int32 累加,最后统一执行缩放、叠加基础 logits,转换为 bf16 输出。整个过程仅在最后执行一次数值转换,中间均为整数运算,效率很高,同时保留了足够精度。
H100 上的权重分片分配在寄存器和共享内存两个层级。
- 寄存器中的瓦片可直接供
mma.sync 指令使用,速度最快;
- 共享内存中的瓦片通过
wgmma 指令计算。
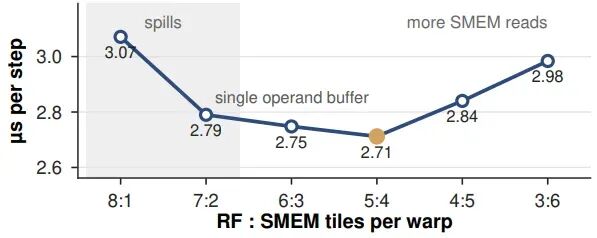
论文测试了不同分配比例,发现寄存器与共享内存按 5:4 或 6:3 分配时性能最优,过多放入寄存器会导致计算所需寄存器不足,出现溢出反而降低性能。
当词表更大时,例如 24.8 万行,即便经过 int8 量化也无法完全容纳,则采用部分驻留模式。一部分权重常驻在共享内存中,剩余部分每步通过 TMA 从 L2/HBM 加载到共享内存的暂存区,随后一同计算。能常驻多少就常驻多少,剩余部分流式加载,依然比全量每步加载快很多。
5.2 B200:TMEM 加持下的 bf16 全常驻
B200 新增了 TMEM 张量内存,片上存储容量更大,且专为张量运算优化。标准 15.2 万词表的 bf16 投影矩阵,可直接全量常驻在片上,无需量化。
每个 SM 的权重分片分配在寄存器、共享内存和 TMEM 三个层级。TMEM 中的瓦片使用 tcgen05 系列指令计算,寄存器和共享内存中的瓦片使用 mma.sync 指令。三种层级搭配,既保证了容量,又兼顾了计算速度。
对于更大的 24.8 万词表,B200 同样采用部分驻留模式,约三分之二的行常驻片上,剩余部分每步流式加载。由于 B200 的 L2 缓存也更大,参考路径本身性能更强,但常驻方案依然能保持与 H100 上相近的相对加速比。
5.3 采样功能支持
除贪心解码外,内核也支持随机采样。论文采用两级采样方案:第一级每 8 行作为一组,组内使用逆 CDF 采样;第二级使用 Gumbel-max 方式,在组之间执行全局选择。该设计既利用了组内的局部性,又将全局采样转化为全局最大值归约,可与贪心选择复用执行路径,实现效率很高。
随机数采用 Philox 算法生成,按请求、词表行、步长、图重放次数设置种子,既保证了可重复性,又能让每次重放得到不同样本,符合采样需求。
整体看下来,两代架构的适配都遵循同一个核心逻辑:尽可能多地把权重放在离计算更近的地方常驻,根据硬件的存储和指令特性做针对性优化,在保证精度的前提下最大化复用收益。
六、效果验证:从头级加速到端到端服务的全面收益
论文在 H100 和 B200 两个平台上开展了全面测试,覆盖马尔可夫头、循环头等不同类型,以及不同词表大小、步长、批量的场景,同时测试了集成到 SGLang 后的端到端服务吞吐,验证了方案的实际落地价值。
6.1 头级性能加速
头级测试单独测量串行头本身的执行延迟,最能体现优化的直接效果。
在 H100 平台上,标准 15.2 万词表的马尔可夫头,批量为 1、步长 16 时,优化后的速度达到 SGLang 最快参考路径的 11.6 倍。随着步长增加,加速比还会进一步提升,因为权重仅加载一次,步长越长,节省的搬运次数越多。具体如下图:
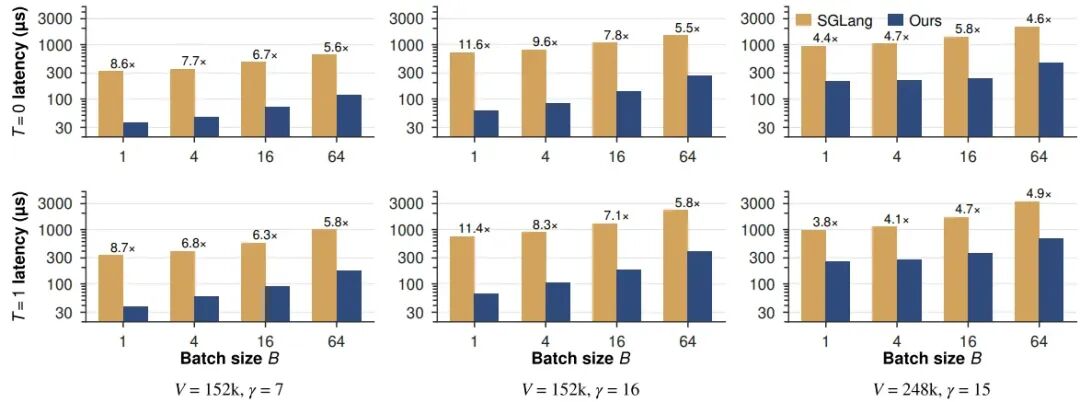
可以看到,批量越小,加速比越高,因为小批量下参考方案的带宽瓶颈更严重;步长越长,加速比越高,因为权重复用的收益更明显。即便是批量 64 的场景,依然有 3.8 到 4.9 倍的加速,收益非常稳定。
对于 24.8 万行的大词表,即便仅实现部分驻留,批量为 1 时也能达到 4.4 倍加速。随着批量增大,流式加载的开销被更多请求分摊,加速比会持续上升,直到计算和选择开销成为瓶颈。
循环头的加速比略低于马尔可夫头,因为状态更新需要额外的跨 SM 同步。DSpark RNN、DeLS-Spec、Domino 三种循环头,步长 15 时,加速比分别为 8.9 倍、8.2 倍、8.5 倍。从延迟拆解来看,投影、后处理、token 选择这几部分的开销与马尔可夫头基本一致,额外开销都来自状态更新的同步。 即便如此,8 倍以上的加速依然非常可观。
6.2 消融实验验证
论文还开展了消融实验,区分了 kernel 融合与权重常驻各自的贡献。
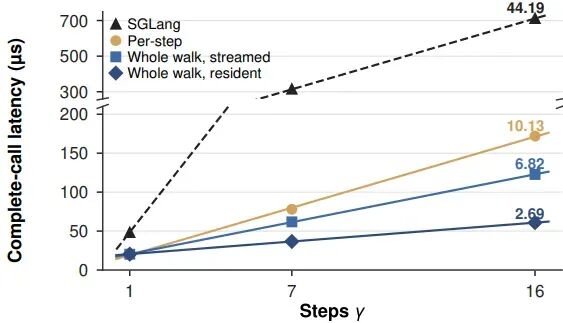
该图清晰展示了三种方案的延迟差异:传统单步 kernel 的单步延迟 44.19 微秒;仅做全步长融合、权重流式加载的单步延迟 10.13 微秒,融合带来 1.49 倍提升;实现权重常驻之后,单步延迟降至 2.69 微秒,常驻额外带来 2.53 倍提升。数据明确说明,权重常驻才是性能提升的核心来源,融合只是基础。
此外,还有寄存器与共享内存分配比例的消融实验,验证了 5:4 到 6:3 的比例为最优平衡点,过多或过少将权重放入寄存器都会导致性能下降。
6.3 端到端服务吞吐
头级加速最终转化为端到端服务收益才有实际价值。论文将优化后的内核集成到 SGLang 中,测试了真实服务场景下的吞吐提升。
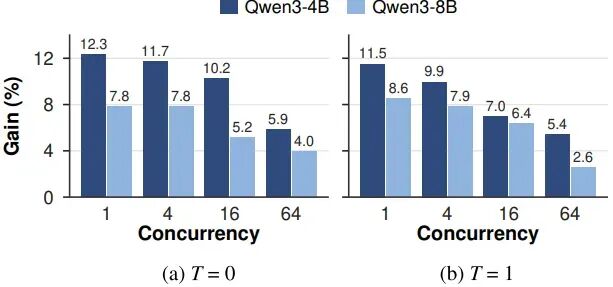
在 Qwen3-4B 模型、块长 16 的马尔可夫草稿配置下,端到端客户端吞吐最高提升 12.3%;Qwen3-8B 模型最高提升 8.6%。不同并发度下均有稳定收益,并发度低时收益更明显,并发度高时收益略有下降,因为批量变大后,串行头的占比会降低。
8B 模型的收益小于 4B 模型,是因为目标模型更大,验证耗时更长,串行头占总时间的比例更小。如果是张量并行场景,目标模型的计算被拆分到多张卡,而串行头在每个卡上都有一份副本,头的占比会更高,收益也会更大。
6.4 精度与接受率影响
由于 H100 上使用了 int8 量化,需要验证是否会影响草稿质量,进而影响接受率。
测试结果显示,int8 量化带来的权重误差仅 0.58%,投影误差 0.26%,数值极小。在真实数据集上的接受率测试中,不同步长和温度下,接受率的相对变化都在 0 附近,置信区间均包含 0,说明不存在统计上的显著差异。量化几乎不影响草稿质量,接受率与原生 bf16 基本一致。
总之,这套方案不仅在头级实现了数倍的性能提升,更能在几乎不损失精度的前提下,转化为真实服务场景下的端到端吞吐收益,具备非常强的落地价值。
这项工作提供了一种通用的优化思路:当业务逻辑中存在反复使用的固定权重,且执行单元可以被封装到单个持久化内核中时,通过权重跨步常驻、状态流式传递的方式,往往能打破传统算子边界带来的资源浪费,释放显著的性能潜力。未来该思路还有望推广到更多串行推理场景,为 GPU 推理优化带来新的视角。
如果你对 GPU 推理优化、Megakernel 设计或推测解码的工程实践感兴趣,欢迎到云栈社区与更多开发者一起交流讨论。
 发表于 昨天 21:23
|
查看: 3|
回复: 0
 /1


