在 Agent 推理负载快速增长的背景下,传统面向聊天场景的推理引擎面临新的挑战:如何在延迟约束下提高吞吐、复用长上下文缓存,并及时适配不同硬件?
TokenSpeed 围绕这些问题,采用分层系统架构,将调度、模型执行与 Kernel 实现解耦,同时探索自动并行编译、KV Cache 管理和跨平台 Kernel 设计。以下结合项目实践,介绍这些设计及其在 Blackwell 等平台上的性能表现。
为什么 Agentic 推理需要新推理引擎
TokenSpeed 立项之初,首先要回答的问题是:为什么 Agent 场景需要重新设计推理引擎?
传统 Chat 负载的优化目标相对单一:用户发起请求,模型生成一段完整回复。在这种模式下,推理系统往往侧重提高 batch 利用率和吞吐,单次请求产生的 KV Cache 在使用后释放,跨请求利用率相对有限。
但 Agent 的负载特征不同。以 coding agent 为例,模型需要持续思考、调用工具、获取结果,再基于结果继续推理。整个过程由多轮短请求构成:第一次请求可能携带几十 K 的前缀上下文,后续每轮输出却往往只有几百个 token。这要求推理引擎重新审视缓存复用、请求调度和系统优化目标。
在这种负载形态下,用户对延迟更加敏感。如果一个 Agent 工具在推理环节明显滞后,用户会直接感受到“跟手性”不足。因此,团队将优化目标设为延迟约束下的吞吐:每用户 TPS 不低于 70,并在此条件下尽可能提高每个 GPU 的吞吐。
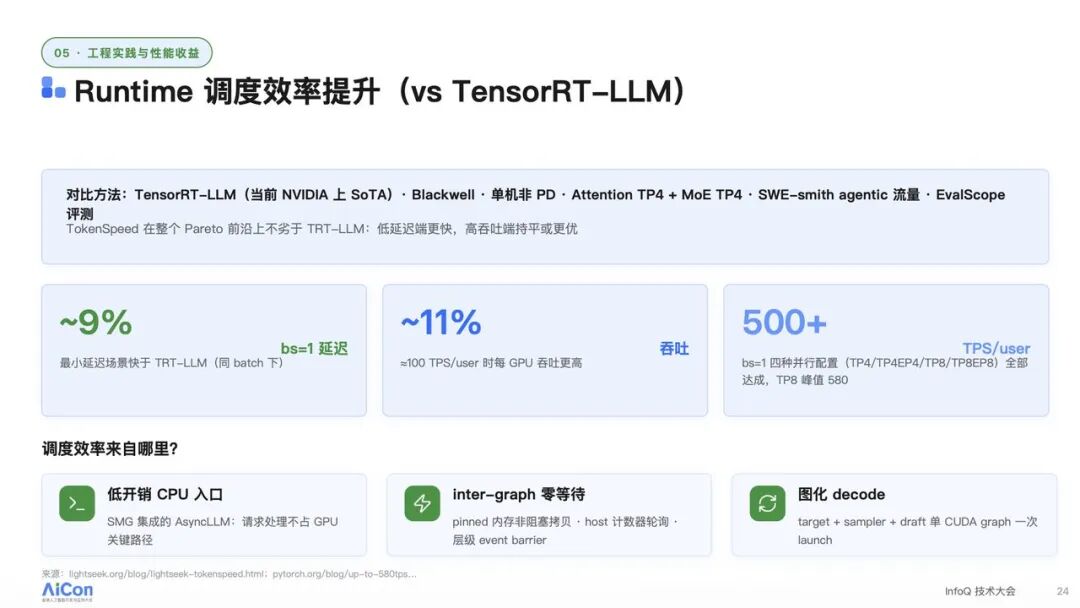
以 TensorRT-LLM 为对比基准,在团队测试中,TokenSpeed 在 batch size 为 1 的最小延迟场景下,端到端延迟降低约 9%;在每用户 100 TPS 的工作点上,每 GPU 吞吐高出约 11%。
KV Cache 复用率也是影响推理成本的关键变量。以 DeepSeek 为例,其缓存复用率据称在 99% 以上,而业界多数系统约为 70% 至 80%。在 Agent 场景下,如果几十 K 的上下文能够反复命中缓存,就可以省去命中部分的 prefill 计算。测试中,TokenSpeed 在上下文长度从 128K 扩展到 1M 时,解码吞吐仅下降 16%。
越来越多模型采用线性注意力机制,包括千问的 Gated DeltaNet 和 Kimi K3 使用的 KDA,缓存管理方式也随之变化。线性注意力模型不再维持传统的 token 与 KV 一一对应关系,而是通过持续迭代的状态表示上下文,其中包括 SSM 状态和卷积状态。如何高效更新、保存和恢复这些状态,成为新的系统设计问题。
模型架构与硬件特性的耦合也在加深。MoE 模型的优化难度不低:以 Kimi K3 为例,该模型有 896 个专家,采用 Latent MoE 降低写入成本,激活专家比例达到 16%,但路由和通信复杂度也随之增加。与此同时,Blackwell 引入了 Tensor Memory 和新一代 Tensor Core,AMD CDNA 架构也有独特的硬件能力。推理引擎只有充分利用这些特性,才能释放硬件性能。
Runtime 与 Kernel 的协同同样重要。调度器设计得再好,如果底层 Kernel 存在瓶颈或耦合过深,整体性能仍会受限;反过来,即使 Kernel 高效,调度器产生大量执行空隙,也难以提高吞吐。TokenSpeed 因此对调度、执行和底层算子进行了分层解耦。
Runtime:构建可扩展的推理引擎架构
TokenSpeed 的整体架构分为控制面、执行面和 Kernel 层。控制面使用 C++ 编写,执行 Runtime 使用 Python 实现,Kernel 独立为子包。
控制面只负责调度决策,不参与数据面的执行;Runtime 负责执行控制面下发的计划,包括缓存计划和前向计算计划;Kernel 层专注于算子实现。清晰的模块边界有助于避免调度、执行和算子逻辑相互渗透。
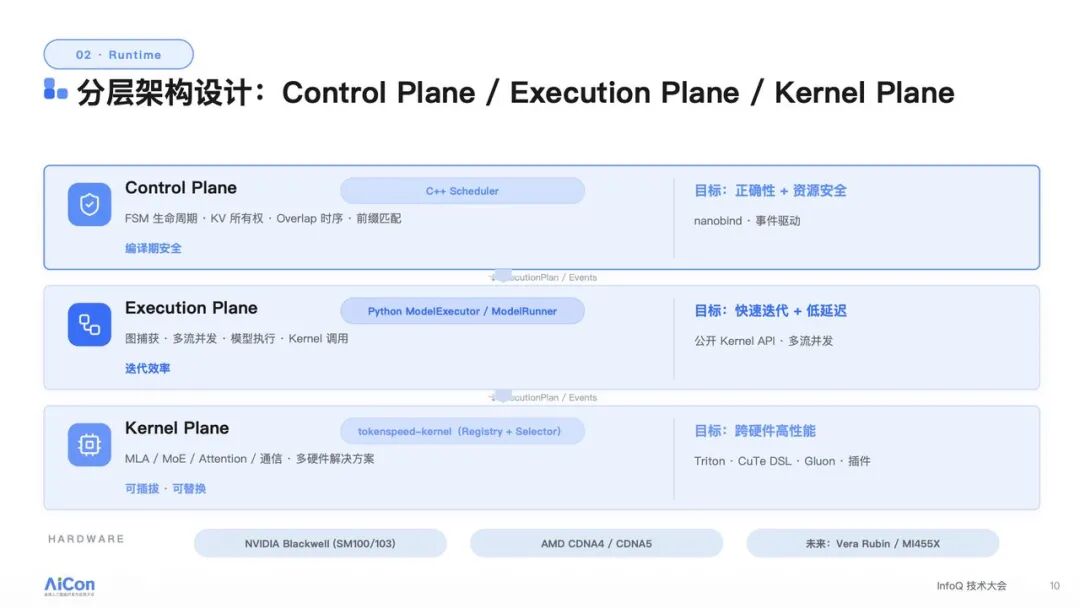
控制面选择 C++ 而非 Rust,有团队技术背景方面的考虑:团队成员更熟悉 C++,而 C++ 的性能和表达力能够满足需求。Runtime 保留 Python,则是因为 Python 的深度学习生态成熟,PyTorch、CUDA 等库的集成度高,便于开发模型适配层。Kernel 子包独立后,NVIDIA 和 AMD 的专家也可以针对各自硬件优化,而不必深入了解调度器或 Runtime 的内部实现。
自动并行编译
在过去的推理引擎开发中,模型并行切分代码往往散落在各个模型适配模块中,与注意力、MoE 和通信逻辑深度耦合。支持的模型越多,维护越困难;接入新模型也可能牵动多个模块。
TokenSpeed 将并行切分逻辑从模型适配代码中抽离,形成独立的 Placement 系统。模型开发者声明模块边界、输入输出类型,以及并行维度上的属性:replicate、shard 或 partial。系统再根据这些声明处理切分和通信。
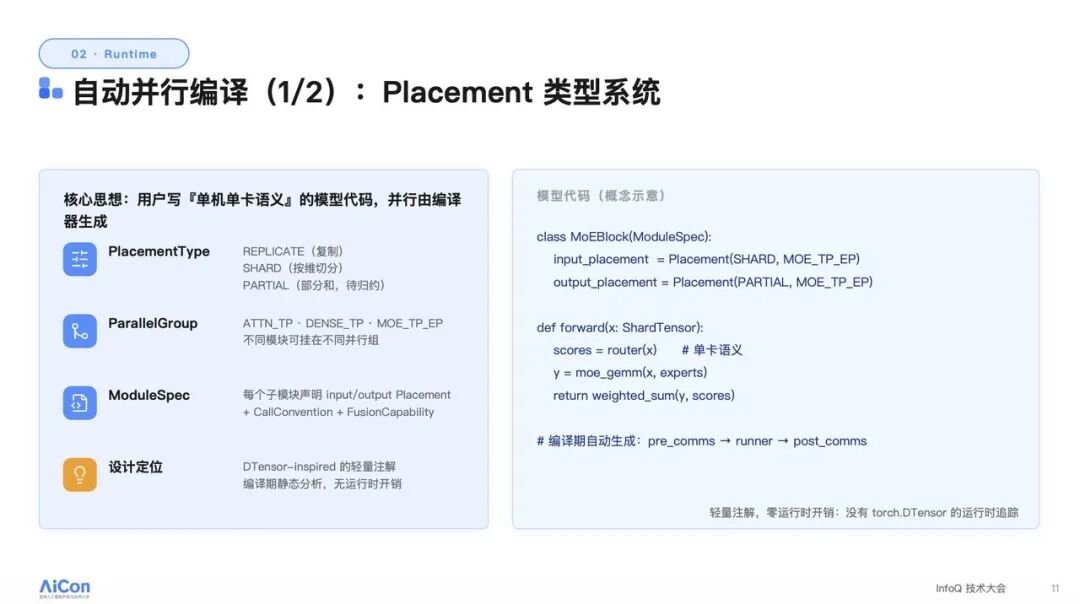
不同模块可以挂载到不同的并行组。例如,注意力模块使用 Attention Tensor Parallel 组,MoE 模块使用 MoE 并行组,各自选择并行策略。
基于 Placement 定义,类型编译系统会遍历解码层执行计划,比较相邻模块的 Placement;发现不一致时,自动插入相应通信原语,例如从 partial 到 replicate 使用 all-reduce,从 shard 到 replicate 使用 all-gather,某些切分与归约转换则使用 reduce-scatter。
编译流程输出统一的 compiled_decoder_layer 执行计划,运行时依次执行前置通信对齐、模型算子和后置通信。这样既降低了模型适配的维护成本,也为相邻算子融合提供前置信息,减少 Kernel 启动开销。
请求状态机与资源管理
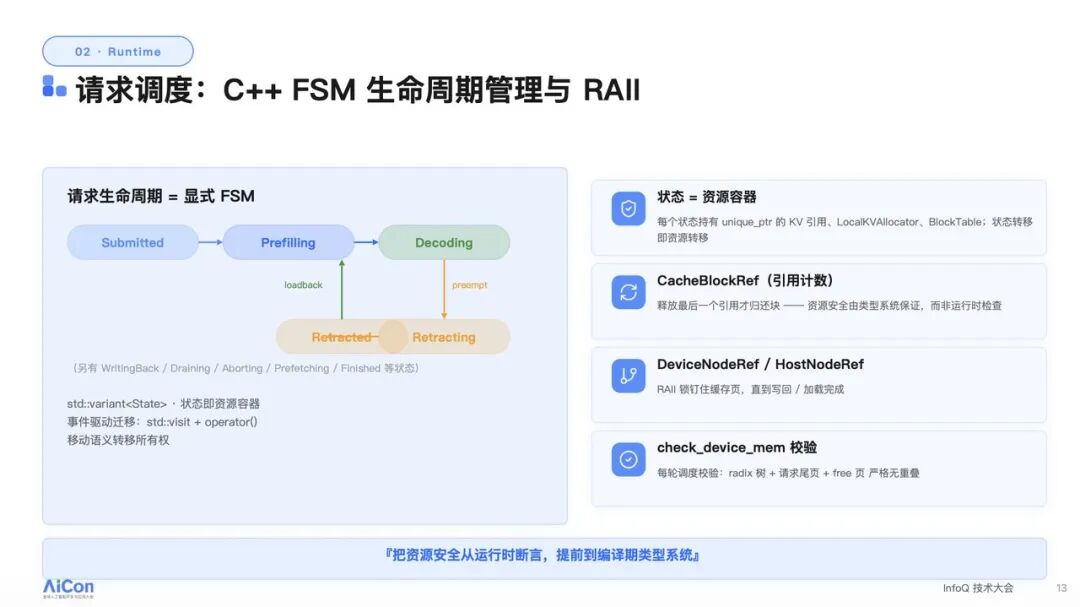
控制面的核心是覆盖单个请求全生命周期的状态机。一个请求从进入到完成,会经历 submitted、prefilling、decoding、retracting 或超时处理、finished 等状态。
每个状态都是资源容器,持有该状态所需的 KV 页引用、SSM/MLA slot 列表等资源。状态迁移时,资源所有权同步传递给下一个状态。
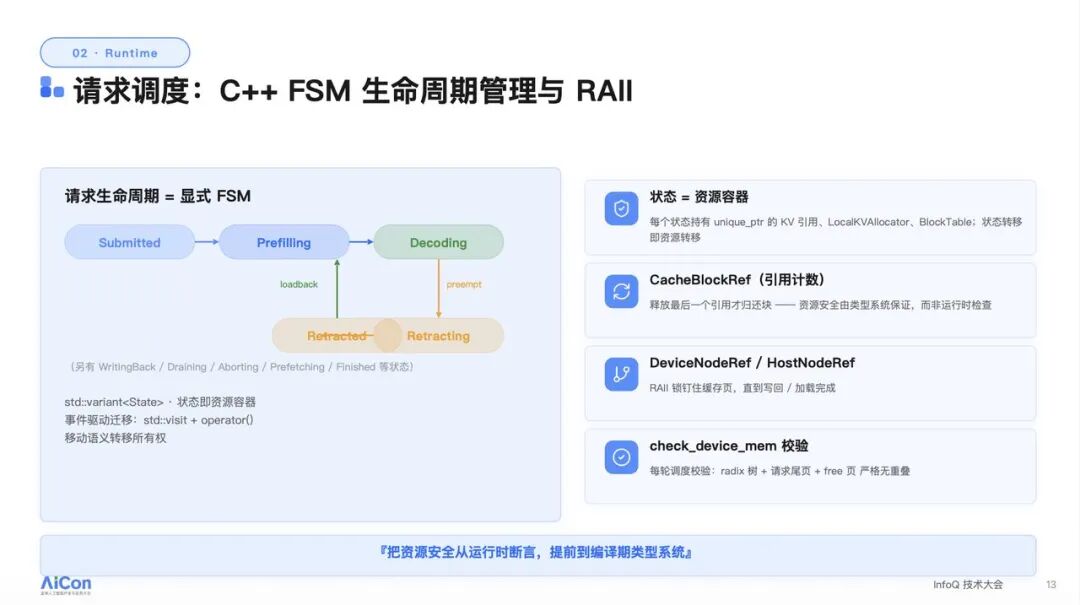
状态迁移由事件驱动,资源所有权通过 C++ unique_ptr 的 move 语义传递。RAII 用于管理资源生命周期:无论是 Cache Block 的引用计数,还是 Device Node、Host Side 的引用计数,在数据搬移或相关操作完成之前,资源都不会被提前释放。
显式所有权和类型检查可以在编译期约束部分资源转移路径,RAII 则有助于处理正常及异常路径上的资源释放;这并不意味着编译通过就能证明所有资源泄漏和分配错误均已消除。
控制面状态机与执行面解耦。调度器决定何时推进请求状态、何时触发抢占,不需要关心底层 Kernel 的具体计算;Runtime 按计划执行并返回结果,再驱动状态机继续流转。这使调度策略能够独立迭代,也有助于减少并发请求中的竞态和资源管理问题。
KV Cache 的演进
KV Cache 管理是 TokenSpeed 投入较多精力的模块。Agent 工作流会反复携带相同的前缀上下文,如果每轮都重新执行完整的 prefill,推理成本会快速上升。
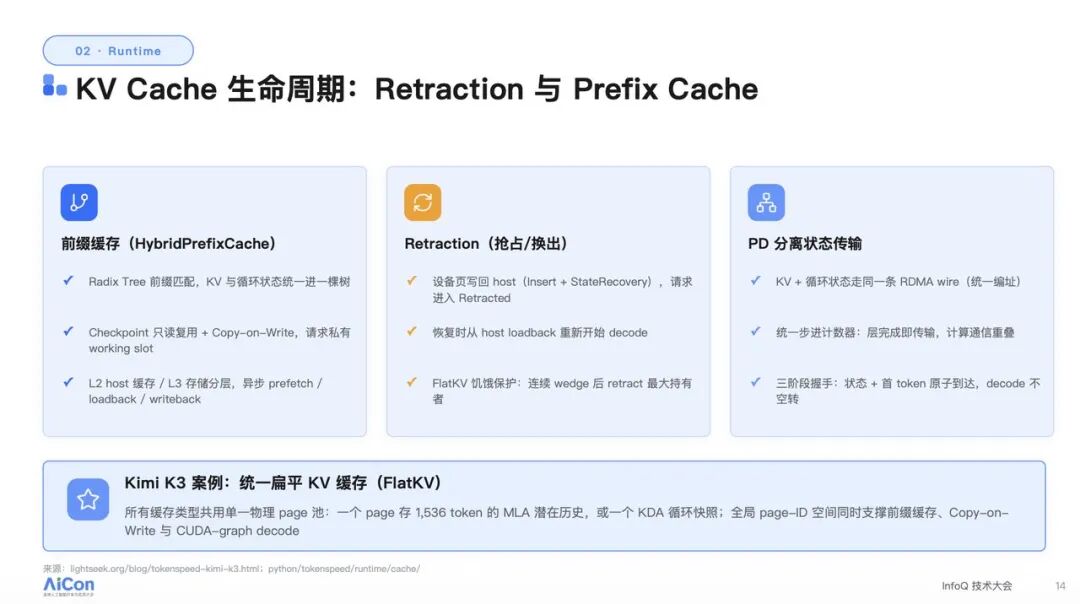
第一版实现借鉴 SGLang,使用 Radix Tree 管理前缀缓存。树中每个节点对应一段 token 序列,请求通过树进行前缀匹配。这种方式在纯 attention 场景下工作良好,但适配 Kimi K3 时,团队发现 Mamba 类模型和 Sliding Window Attention 的缓存访问方式,与 Radix Tree 所依赖的层级匹配假设存在冲突。
在支持 Kimi K3 的过程中,团队将原有缓存管理迁移到 Flat KV 设计。底层不再直接依赖具体注意力类型,而是由上层按统一格式上报缓存类型及占用空间,再将缓存打包为相同尺寸的 block,进行平面存储管理。
K3 第一版采用逻辑 block 与物理 block 相同的设计,每个 block 管理 1536 个 token。这个粒度在长上下文下带来了前缀复用效率和页内碎片问题。后续借鉴 vLLM 的做法,引入两层 block:
- 逻辑块大小为 128,用于前缀复用和更细粒度的缓存匹配。
- 物理块大小仍为 1536,保持底层存储粒度不变。
缓存抢占与恢复也是关键能力。TokenSpeed 接入 Mooncake 的 KV Store:显存不足时,将请求的 KV 状态卸载到 KV Store;请求重新调度时,通过延迟加载机制恢复状态并继续计算。
在 PD 分离方面,团队最初采用逐层传输,但较小粒度的传输会影响 RDMA 带宽利用率。后续实现允许用户将若干层打包成一个 block 传输,根据网络拓扑和模型规模调整传输粒度。
Kernel:优化 MLA 与 GPU 执行效率
TokenSpeed 的 Kernel 优化主要由团队中的 NVIDIA 和 AMD 专家推动。团队表示,项目 Kernel 在 Blackwell 上已取得较高性能,并被 vLLM 社区集成为 Blackwell 上的默认 Kernel 包。
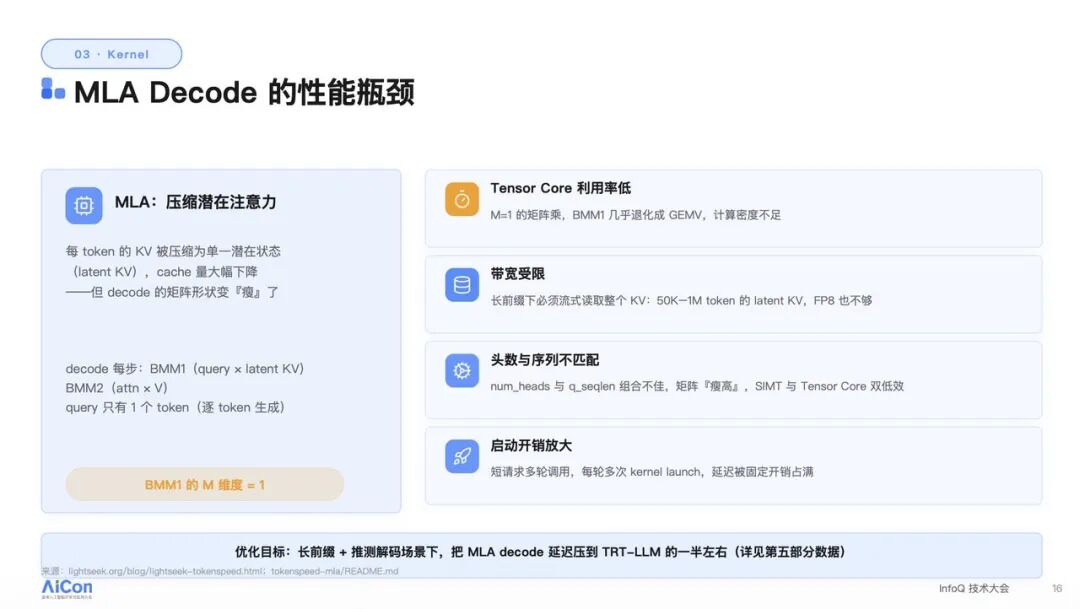
MLA(Multi-head Latent Attention)通过将 KV 压缩为潜在状态来降低缓存和写入成本,但计算模式并不天然适合硬件。
在 decode 阶段,query 与 latent key 的第一次矩阵乘法中,query 维度为 1,计算接近向量乘法,Tensor Core 利用率较低。长前缀还会带来带宽瓶颈:即便使用 INT8 量化,几十 K 到几百 K 的上下文仍需要大量数据加载。此外,head 数与序列长度的组合可能使矩阵形状较瘦,影响 SM 利用率,Kernel 启动开销也会被放大。
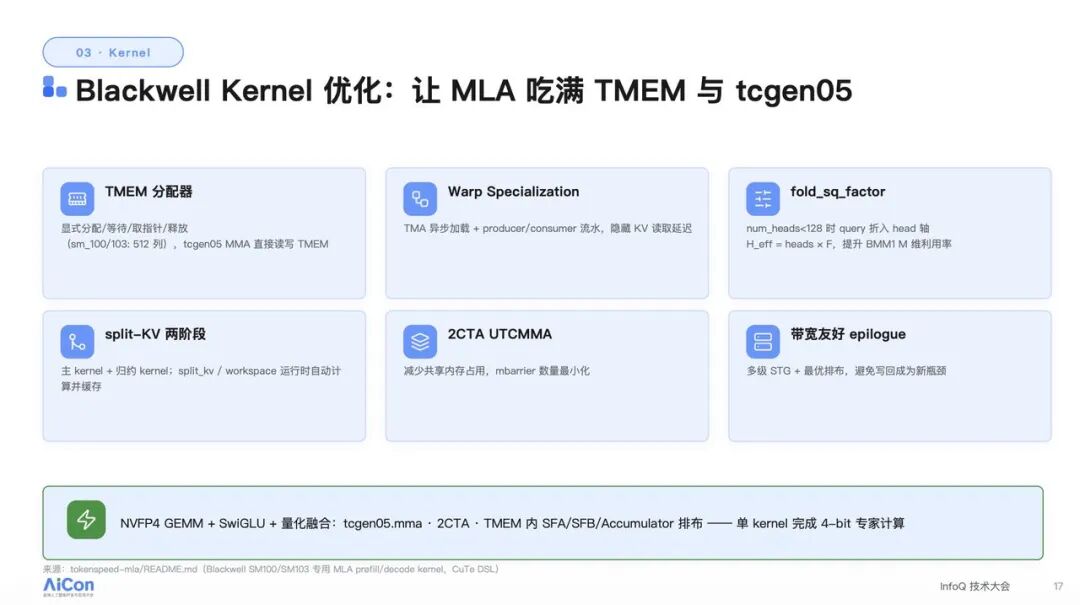
针对这些问题,团队在 Blackwell 上重新设计 Kernel:
- Tensor Memory:实现专用分配器,让 Tensor Core 直接读写 Tensor Memory,减少通过寄存器搬移中间数据的开销。
- 折叠因子:当 head 数小于 128 时,将 query token 折叠到 head 维度,提高有效矩阵维度和 Tensor Core 利用率。
- Split KV:先计算各段 KV 的部分结果,再执行归约;Split 参数和 workspace 大小在运行时自动计算并缓存。
- 执行与写回优化:优化协同执行、同步和数据写回,减少相关开销,避免写回成为新的带宽瓶颈。
投机解码与线性注意力
投机解码是提升推理吞吐的重要手段。TokenSpeed 仓库支持 MTP、EAGLE3 和 DeepSeek 等投机解码方案;团队也在推进其他相关算法的支持,并计划为开源模型训练对应的投机模型权重。
在 Inkling 975B 开源模型的四张 B200 测试中,MTP 步数为 3 时每步 TPS 为 317,步数为 8 时为 355;相对于关闭 MTP 的基线,整体性能提升 2.08 至 2.33 倍。在千问 3.5 上,MTP 带来的性能收益为 100% 至 159%。
对于线性注意力模型,状态会随着 token 生成持续更新,并需要在特定时间点保存。为降低写回开销,TokenSpeed 将每一步的状态写入请求私有的物理行,用索引标记状态位置;需要保存时,只更新索引指向,而不是搬移整个状态块。
在 prefill 场景中,Agent 负载的前缀命中率通常较高,命中后可能只需追加计算几百个 token。这时请求形状是变长的,Q 和 KV 长度也不相等。TokenSpeed 的 MLA Kernel 支持无 padding 的变长批处理,默认实现使用 QDLS,同时提供通过 TMA 接入的预编译 binary。
跨平台 Kernel 设计
NVIDIA、AMD、华为、平头哥等厂商的加速器拥有不同的硬件架构和编程模型。如果 Kernel 直接绑定特定硬件接口,支持新硬件时就可能需要大规模重构。TokenSpeed 参考 Linux 内核的抽象思路,在 Kernel 层建立了 register 和 selector 机制。
模型适配代码不直接感知底层硬件接口,而是调用公共 AI API 或 prefix API。这些 API 描述张量格式、执行约束等必要参数,并尽量保持稳定。
硬件厂商实现 Kernel 后,通过 register 机制声明支持的操作类型、capability、signature、优先级和特定 Tensor Core 特性。运行时再根据平台能力与数据格式筛选 Kernel,选择适合的实现完成前向计算。
这一设计也提供了分阶段的接入路径:新模型可以先使用 PyTorch 等编写的 reference 实现跑通,建立正确性基线,再逐步替换为定制 Kernel。reference、performance 和 specialized plugin 可以同时存在,系统依据注册优先级选择实现。TokenSpeed Kernel 包有独立的 AMD Build,AMD 团队据此完成了 GPU 适配。
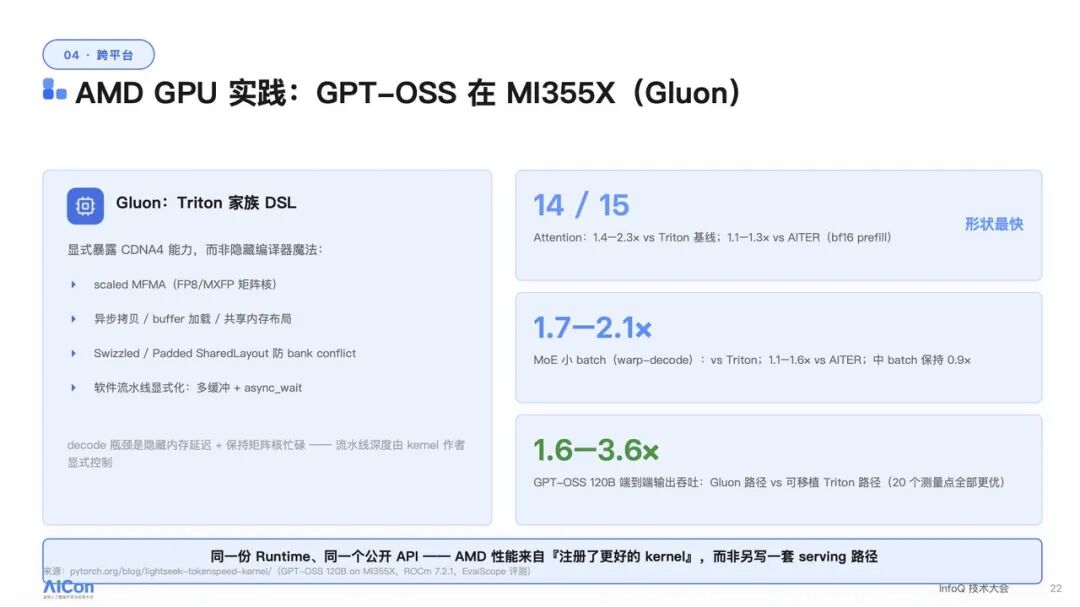
在 AMD MI355X 上,开发者可以借助面向 CDNA4 的 Gluon DSL 控制流水线和内存布局。测试幻灯片显示,在 15 种典型 prefill 形状中,Attention Kernel 有 14 种取得最快结果,相对 Triton 基线快 1.4 至 2.3 倍;MoE 小 batch 场景相对 Triton 快 1.7 至 2.1 倍。GPT-OSS 120B 的端到端测试中,Gluon 路径在 20 个测量点上均优于可移植 Triton 路径,输出吞吐提升 1.6 至 3.6 倍。
工程实践与性能收益
经过数月迭代,TokenSpeed 在 Blackwell 平台上取得了一系列性能结果。团队以 TensorRT-LLM 为对比基准,在单机 Blackwell、非 PD 分离架构下,使用 EvalScope 对 Agent 流量进行测试。
在这组测试中,TokenSpeed 在延迟与吞吐的 Pareto 前沿上不弱于 TensorRT-LLM:batch size 为 1 的最小延迟场景快约 9%,每用户约 100 TPS 时每 GPU 吞吐高约 11%。在千问 3.5 397B、八卡 B200、batch size 为 1 的配置下,测试达到 580 TPS。
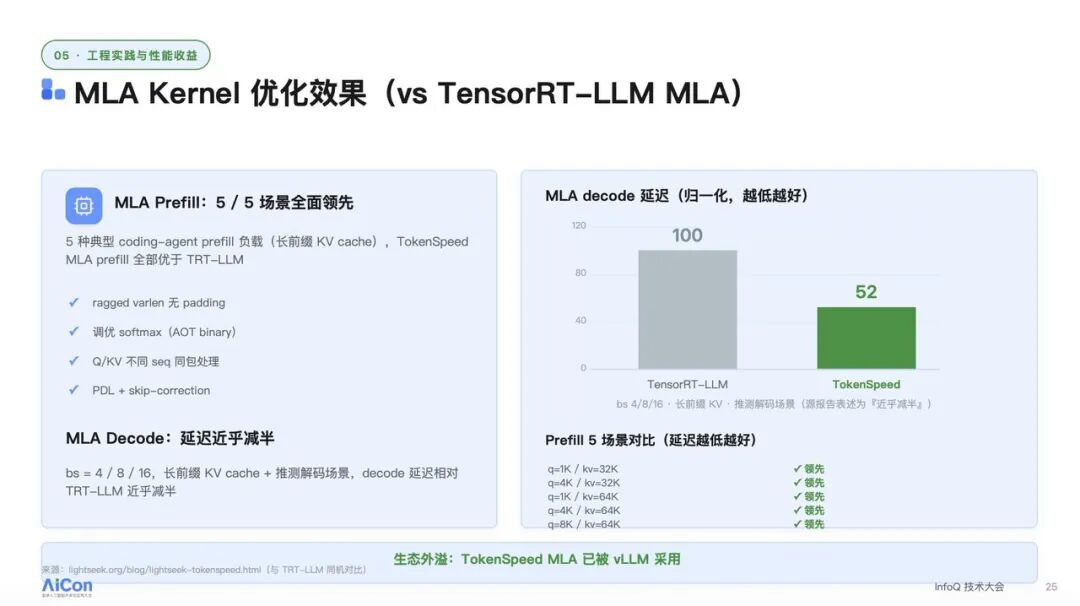
MLA Kernel 测试中,五种典型 coding agent prefill 负载均优于 TensorRT-LLM。对于长前缀 KV Cache 与投机解码组合的 decode 场景,测试幻灯片给出的 batch size 为 4、8、16,延迟相对 TensorRT-LLM 近乎减半。
跨模型支持方面,千问 3.5 的上下文从 128K 扩展到 1M 时,解码吞吐下降 16%;Kimi 2.5 的每用户 TPS 达到 423。Kimi K3 在分享时处于 Day-0 支持状态,优化仍在持续。
回顾项目实践,可以归纳出几条设计原则:以延迟约束下的吞吐和 Pareto 前沿评价 Agent 推理性能;明确控制面、Runtime 和 Kernel 的边界;通过 Placement 与自动并行编译降低模型适配成本;充分利用硬件特性,同时为多硬件生态保留清晰的接入路径。
来源
作者:尚旭春,TokenSpeed 独立贡献者
编辑:宇琪
审核:Kitty
策划:AICon 全球人工智能开发与应用大会
本文整理自尚旭春在 AICon 2026 深圳站的分享《构建面向 Agentic 推理的下一代 LLM 推理引擎》,演讲实录经 InfoQ 编辑整理。
 发表于 昨天 12:27
|
查看: 20|
回复: 0
 /1


