大模型推理时,芯片通常只需要读取已经训练好的权重,完成前向计算。但还有一种运行方式:模型一边处理长上下文,一边根据新输入更新部分权重,相当于在推理过程中持续学习。
这给 NPU 带来了新问题。原本只负责前向计算的矩阵乘法阵列,现在还要承担反向传播,训练和推理可能同时需要使用这些计算资源。如果简单地让两种任务轮流执行,训练就会拖慢推理;如果增加一套计算阵列,又会明显增加芯片面积。
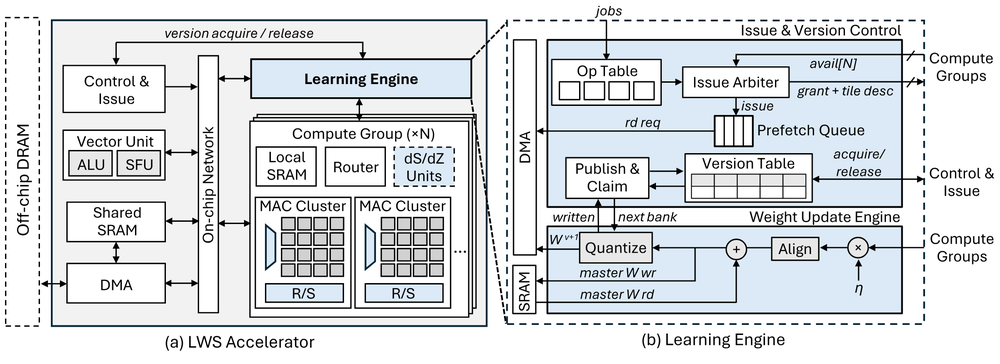
LWS 在原有 NPU 矩阵计算阵列基础上增加 Learning Engine、暂停恢复控制和权重版本管理,使推理与学习共享 MAC 资源。图源:弗吉尼亚大学,论文 Figure 5。
11 月 13 日,弗吉尼亚大学研究团队提出 Learning While Serving(LWS)架构,尝试让训练利用 NPU 原有计算阵列的空闲时间。它允许训练任务在矩阵计算中途暂停、恢复,通过权重版本管理解决两种任务的读写冲突,并增加少量专用梯度计算硬件。
在架构建模评估中,LWS 相对串行执行实现了 1.6 倍吞吐;16nm RTL 综合显示,数据中心 NPU 核心面积增加约 1.5%。方案没有增加第二套 MAC 阵列,而是重新设计了现有计算资源的调度与数据管理方式。
01|大模型为什么要边推理边训练,NPU 又卡在哪里
大模型处理长上下文时,通常需要通过 Attention 访问此前的 Token。即使有 KV Cache,随着上下文越来越长,需要保留和读取的历史信息也会不断增加。另一种思路是,让模型在读取上下文的过程中,把部分信息学习到自身权重里,后续计算就不必始终依赖完整的历史 Attention。
这就是推理时学习(Inference-Time Learning,ITL)。它把长输入切成多个数据块,每处理一块,就执行一次前向计算,再根据这一块的内容计算梯度,更新模型中的部分权重。下一块输入到来时,模型便可以利用此前更新过的权重继续处理,而 Attention 只需要覆盖一个固定长度的近期窗口。
以论文采用的 TTT-E2E 3B 为例,模型共有 32 层,其中最后 8 层的 MLP 权重允许更新。假设输入一段 128K Token 的长文档,系统会将其切成每块 1024 个 Token,依次处理。每个数据块先经过 32 层前向计算,产生用于学习的预测损失,再对最后 8 层进行反向传播,计算并更新对应的 MLP 权重。
这样一来,模型不必在每次处理新数据时都重新关注全部历史 Token,但也多出了一项工作:每处理完一个数据块,还得完成一次训练。
这个代价并不小。论文在 NVIDIA B200 上的测试显示,单看前向计算,ITL 在 128K 上下文下的 Token 处理速度达到完整 Attention 的 2.5 倍;可一旦把反向传播和权重更新算进去,学习任务占到了总执行时间的 54%,抵消了大部分加速收益。
最直接的解决办法,是让前向计算和反向传播同时执行。但传统推理 NPU 并没有专门为这种工作模式设计:它通常假设模型权重固定,矩阵计算阵列按照前向推理的顺序执行任务。训练如果也要使用同一套阵列,就可能与前向计算争抢资源。
研究团队进一步发现,这套硬件存在大量未被利用的计算时间。
在 AWS Inferentia2 上测量 TTT-E2E 的一个前向层时,Tensor Engine 只有 27% 的时间处于活跃状态。原因在于,Transformer 的 Attention 并不只有矩阵乘法,中间还穿插着 Softmax、归约等操作。当这些操作由其他执行单元处理时,后续矩阵计算必须等待结果,Tensor Engine 便暂时空闲。
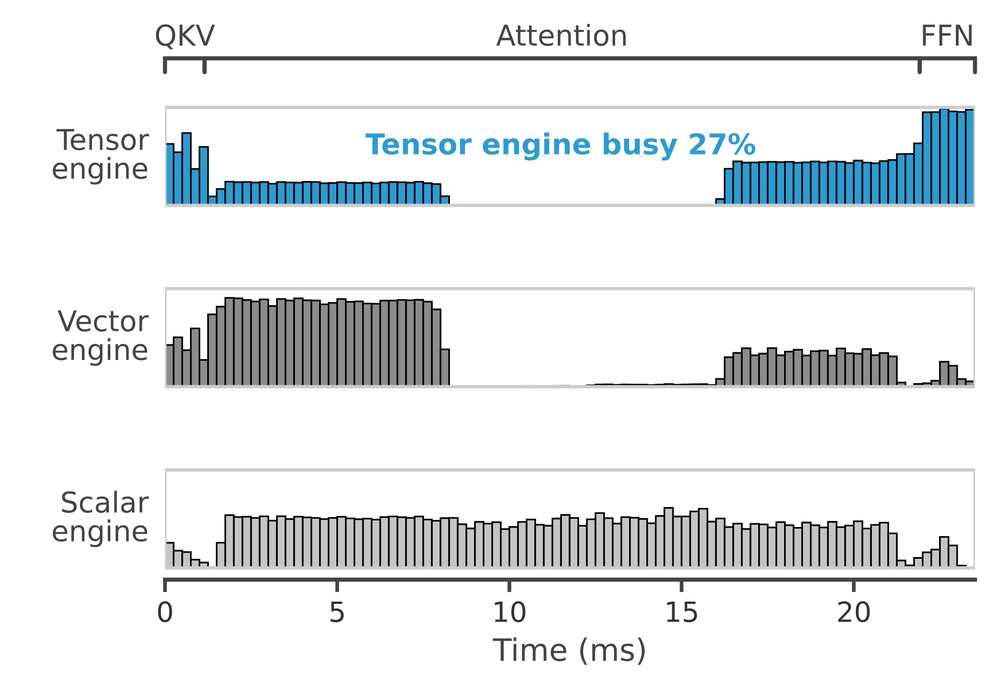
在 TTT-E2E 前向层执行期间,AWS Inferentia2 的 Tensor Engine 只有 27% 的时间处于活跃状态,Attention 中的非矩阵操作留下大量零散空闲窗口。图源:论文 Figure 3。
在论文建模的另一套数据中心 NPU 中,学习任务所需的矩阵计算时间,仅相当于前向计算剩余空闲矩阵时间的 33%。从总量上看,现有 MAC 阵列有机会同时承担两种任务,无需再增加一套矩阵计算硬件。
但这些空闲时间是零散的。一次训练矩阵计算可能需要持续执行很久,而前向计算留下的空闲窗口往往很短。如果训练占住 MAC 阵列不放,前向计算就会被迫等待;如果每次都等到有足够长的空闲时间才启动训练,又很难把这些算力利用起来。
这就形成了 LWS 要解决的第一个硬件问题:如何把较长的训练计算拆开,放进前向推理留下的短暂空闲窗口,同时保证推理任务随时能够收回计算资源。
02|训练做到一半,推理来了就暂停
LWS 首先改变了矩阵计算资源的调度方式。
传统并发方案可以把计算资源静态分成两部分,或者在推理不使用某个执行单元时暂时借给训练。但 Attention 的执行过程会形成大量短暂的空闲窗口,训练中的一次矩阵计算往往无法在单个窗口内完成。
LWS 把 MAC 计算组织为更细粒度的可调度集群,并为训练增加暂停和恢复能力。推理始终拥有更高优先级,训练利用空闲窗口执行;当推理需要收回 MAC 集群时,训练在安全的归约块边界暂停。
论文采用 32 个元素为一个归约块。每次暂停时,硬件将当前部分累加结果保存在本地 SRAM,并记录执行位置、权重版本和计算范围。等计算资源再次空闲,训练从中断位置继续执行,无需重新计算已经完成的归约块。
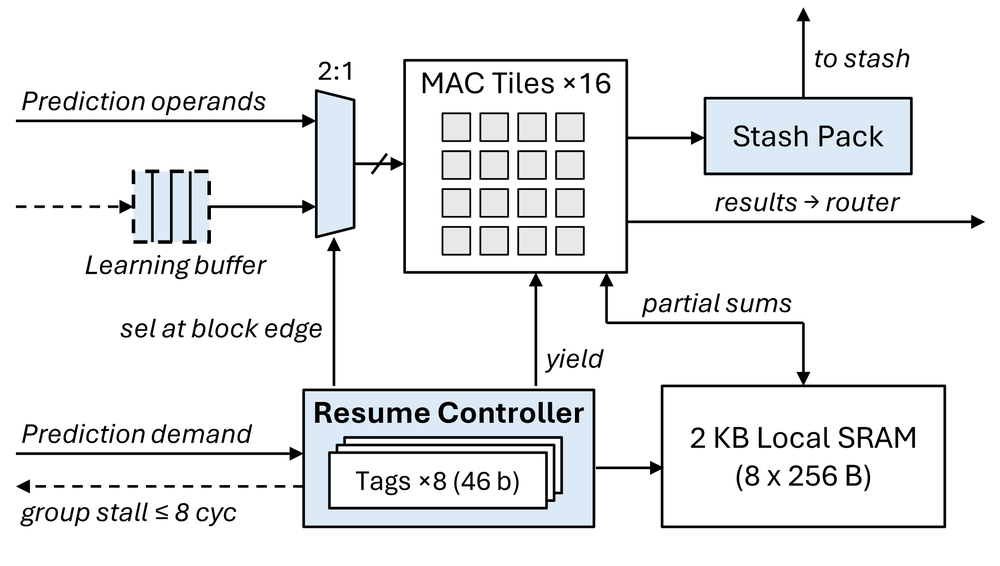
训练任务在 32 元素归约块边界暂停,将部分累加结果与执行描述符保存到本地 SRAM;MAC 资源重新空闲后恢复计算。图源:论文 Figure 7。
具体实现中,每个暂停任务保存 256 字节的部分累加结果,以及一个 46 位的执行描述符,每个 MAC 集群最多保留 8 个暂停任务。
这让原本无法容纳完整训练 Kernel 的短暂空闲时间,也能逐步完成有用计算。对 SoC 设计而言,关键是将抢占边界选在容易保存状态的位置,避免为任意时刻中断而增加大量硬件开销。
03|推理读旧权重,训练写新权重,如何避免冲突
共享计算单元之后,第二个问题是权重一致性。
假设推理正在读取第 20 层的权重,训练同时完成了这一层的更新。如果直接覆盖原有权重,推理可能在同一次计算中读到不同版本的数据。反过来,如果每次更新都等待所有读者结束,又会损失并行执行的收益。
LWS 为可更新层引入硬件管理的权重版本机制。
每层可以在外部 DRAM 中保留多个量化权重 Bank。片上的 Version Table 记录当前发布的版本、各 Bank 的版本标签和读者数量。推理进入某层时先获取一个确定的权重版本,后续计算持续使用这一版本;训练则将更新后的权重写入另一个 Bank,完成后再发布。
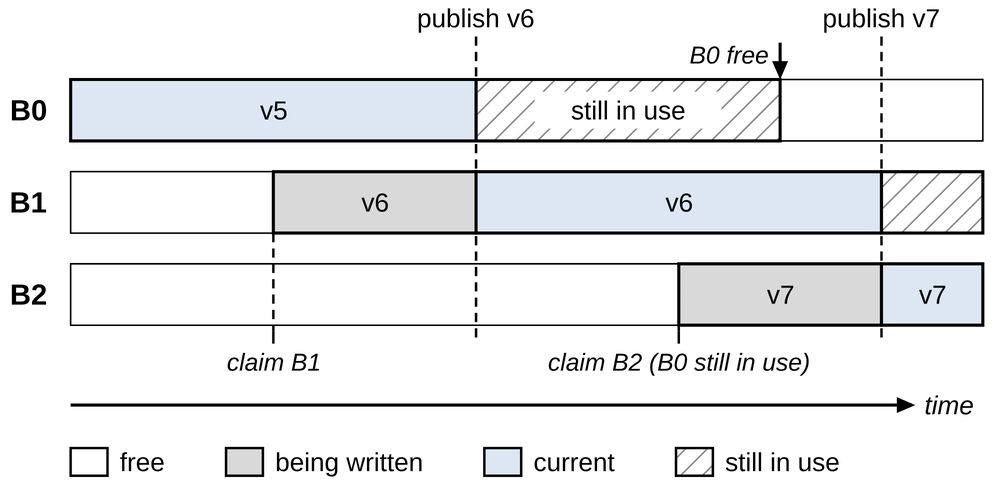
新版本写入另一个权重 Bank,完成后发布;旧 Bank 继续服务已获取旧版本的计算,直到所有读者释放后才允许复用。图源:论文 Figure 6。
旧 Bank 只有在所有读者结束后才能重新利用。这种方式允许新旧权重短时间共存,也避免了更新过程中读到不完整数据。
研究还有一个值得注意的设计取舍:并非所有层都必须立即看到最新权重。
由于反向传播与前向计算遍历网络的方向相反,靠近输入侧的可更新层往往更晚完成梯度计算,却更早被下一轮前向计算访问。允许这些层使用稍旧的权重,可以减少等待。
在 TTT-E2E 3B、128K 上下文实验中,让前 4 个可更新层延迟一个输入分块使用新权重、后 4 层保持最新版本,能够保留完全及时更新方案约 99.3% 的负对数似然(NLL)改善收益,同时恢复完整的前向处理吞吐。
这里的 99.3% 衡量的是相对于不进行推理时学习,保留了多少模型质量改善收益,并非模型准确率达到 99.3%。
这为硬件提供了新的调度空间:权重更新不仅有完成时间,还可以按层设置可接受的可见性期限。
版本管理也有存储成本。以 TTT-E2E 3B 为例,LWS 额外使用约 178 MB 存储空间保存权重版本;八个可更新 MLP 所需的高精度主权重还占用约 1.04 GB,但这部分是推理时学习本身就需要的,并非 LWS 独有开销。
04|MAC 够用还不行,反向传播会堵住向量单元
研究团队发现,即使矩阵计算能够顺利复用,反向传播仍然可能拖慢推理。
原因在于,训练不仅包含矩阵乘法,还需要计算 Attention Softmax 梯度和词表 Softmax 梯度。这些操作依赖大量逐元素计算与归约,会与前向推理争用 NPU 的向量单元。
在论文建模的 NPU 中,学习任务对向量单元的需求达到前向计算剩余空闲容量的 2.1 倍。其中,Attention 和词表 Softmax 梯度占学习任务向量工作量的 86.8%。
因此,LWS 在少量计算组中增加专用梯度数据路径:一类负责 Attention Softmax 梯度,另一类通过两遍流式处理生成词表 Softmax 梯度,避免形成大规模中间概率数组。
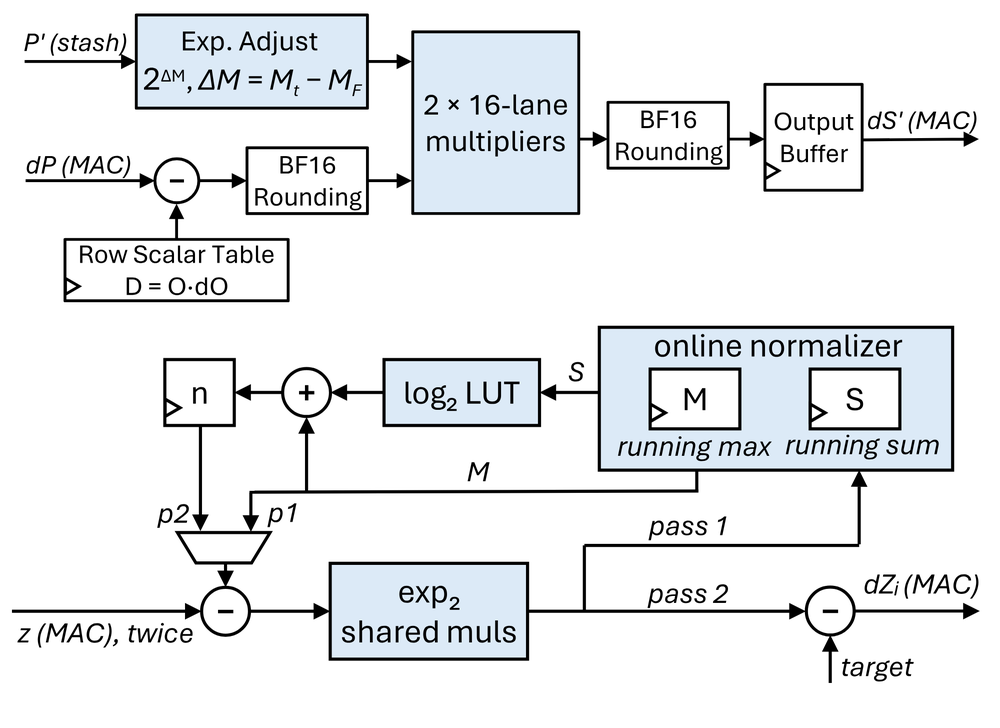
LWS 使用 dS 单元计算 Attention Softmax 梯度、dZ 单元以两遍流式处理计算词表 Softmax 梯度,减少对共享向量单元的占用。图源:论文 Figure 8。
它没有复制整套向量处理器,也没有增加第二套 MAC 阵列,而是针对最容易形成资源冲突的运算补充专用硬件。
这种设计思路对 NPU 有参考价值:增加新工作负载后,原有主计算阵列未必是第一个瓶颈,配套的向量、归约和数据准备单元反而可能先达到容量上限。
05|1.6倍吞吐、1.5%面积增幅,代价是什么
论文使用统一的操作级模拟器,对数据中心和边缘 NPU 进行评估。数据中心配置参考 TPU v5e 级别的计算与存储预算,边缘配置参考 Jetson AGX Orin 级别的资源;新增计算组则进行了 Verilog 实现、RTL 综合及部分布局验证。
在 9 个模型的评估中,LWS 相对串行执行实现约 1.6 倍吞吐,相对最优已有并发架构提升约 1.3 倍。其中 TTT-E2E 3B 是主要的推理时学习验证对象,其余八个模型通过映射相应 Learning 工作负载进行架构性能评估,并非全部原生运行同一套学习算法。
消融实验进一步说明了三项硬件机制的作用。在 TTT-E2E 3B 的建模配置中,完整 LWS 可以维持仅执行前向计算时的吞吐;如果取消训练任务的暂停恢复能力,吞吐降至 74%;取消专用 Softmax 梯度单元,降至 87%;如果要求所有层始终使用最新权重,则降至 84%。
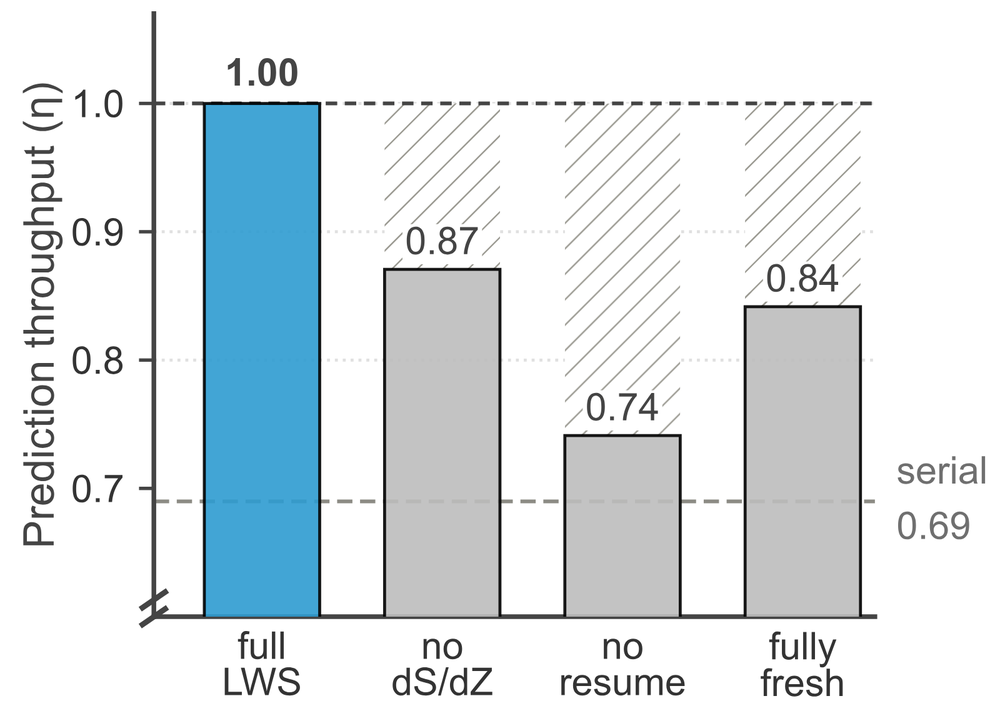
完整 LWS 维持仅前向计算的吞吐;取消暂停恢复、专用梯度单元或分层权重延迟策略后,归一化吞吐分别下降至 74%、87% 和 84%。图源:论文 Figure 11(a)。
这几组数据不能简单相加,但能说明:仅仅复用空闲 MAC 阵列还不够,训练抢占、权重可见性和向量资源争用都会影响最终吞吐。
训练也并非没有成本。它仍然需要额外读取激活、梯度和权重,也会增加存储容量与能耗。论文报告的数据中心 NPU 平均学习能耗开销为 37.6%,边缘 NPU 为 29.3%。这一指标衡量的是增加学习任务带来的额外能耗,而非芯片瞬时功耗增幅。
硬件面积同样需要区分统计口径。16nm RTL 综合显示,数据中心 NPU 新增约 1.47 mm² 逻辑,约占原有计算逻辑面积的 3.3%;将片上 SRAM 计入后,核心面积增加约 1.5%。
边缘 NPU 则新增约 0.49 mm² 逻辑,对应计算逻辑面积增加 4.3%,包含片上 SRAM 后的核心面积增加约 2.7%。这些数字并不包括前文提到的额外外部权重存储容量。
目前这些结果来自架构建模、RTL 综合和部分布局验证,并非已经流片的商用 NPU 实测。论文主要研究长上下文分块 Prefill 阶段的推理时学习,尚未覆盖批量服务和逐 Token 自回归 Decode。
LWS 给出了一套相对完整的工程方案:用细粒度抢占复用 MAC 阵列,用逐层版本管理解决读写冲突,再针对反向传播的向量瓶颈补充专用数据路径。
对于未来需要在线适应、持续更新模型的 AI 芯片,推理和训练能否共用一套计算资源,可能不再只取决于 TOPS 是否足够,还取决于计算状态能否低成本保存、权重何时对下一轮推理可见,以及不同执行单元能否真正并行工作。
 发表于 昨天 02:56
|
查看: 15|
回复: 0
 /1


