要点速览
- 规模:八台DGX Spark组集群把统一内存推到1TB,753B的GLM 5.3全量权重在NVFP4下约470GB,本地跑得起来。
- 推理:稠密Qwen3.8-27B从1节点到8节点解码11.86涨到52.58 tok/s(4.43倍),Prefill只涨1.94倍。
- 训练:nanochat预训练8节点7.79倍加速、97.4%扩展效率;推理与训练的扩展曲线形状完全不同。
把八台桌面级AI机器连成一个集群,能跑多大的模型?统一内存到1TB,753B参数的GLM 5.3全量权重在NVFP4下约470GB,可以在本地服务。这是NVIDIA在GTC柏林宣布的八节点DGX Spark集群支持。
单台DGX Spark提供128GB统一内存,四台512GB,八台1TB。容量只是门槛,真正要看的是三件事:推理怎么随节点数扩展、多模型编排能挤出多少吞吐、以及从头预训练能不能接近线性。三组基准给出的曲线形状并不一样。
先解决能不能装下:1TB统一内存装470GB模型
八节点集群最直接的收益是内存。单台128GB,八台到1TB,这让一批在四节点上根本起不来的模型变得可跑,包括Z.ai的完整GLM 5.3(753B)。
图1:DGX Spark桌面形态,八节点集群把统一内存推到1TB
不只是装得下,还要能以交互速度服务。早期测试里,团队在八节点集群上跑GLM 5.3 Flash,生成阶段测到约80 tokens/s(TPS),对本地开发一个前沿级MoE模型来说足够交互。
完整的GLM 5.3(753B)检查点在八台128GB的集群上运行,是目前能在本地服务的最大开源模型之一。该检查点的NVFP4体量约470GB,用MTP3投机解码,在并发1、4、8下测得的吞吐如下:
| 并发 |
Prefill总量(TPS) |
Prefill单用户(TPS) |
Decode总量(TPS) |
Decode单用户(TPS) |
| 1 |
1,600 |
1,600 |
31 |
31 |
| 4 |
1,600 |
750 |
51 |
21 |
| 8 |
1,600 |
473 |
67 |
18 |
这张表的信息量在于两个方向相反的趋势:Prefill总量在并发1到8之间恒定在1,600 TPS,而Decode总量从31涨到67。Prefill早早就撞到算力上限,Decode还在靠批处理继续吃吞吐。Prefill的测量条件是每请求8K输入长度(ISL)。
集合通信:一个为小消息优化的后端
张量并行推理有相当一部分时间花在all-reduce这类集合操作上。在带交换机的集群上,团队评估了一个为Spark优化的集合通信后端RoCEnante,专门针对本地AI硬件上张量并行解码的典型形态:小消息、低并发、rank数不多。
这个后端做的是先全交换再本地归约:每个rank把自己的输入发给所有其他rank,然后在本地把收到的输入加起来,整个过程由单个GPU内核协调。
主要收益是通信步数变少。环形all-reduce要沿相邻rank多轮转发数据,这个方案直接与所有对端交换,省掉了转发链。对小消息和少量rank,延迟因此下降。
代价是数据搬运量变大:每个rank把自己的完整输入发给每个对端,并自行归约所有输入。消息或节点数增长后,这份额外流量越来越贵,环形all-reduce的带宽效率反而更有吸引力。如果需要高并发、更大集群或环形拓扑,NVIDIA集合通信库(NCCL,NVIDIA Collective Communications Library)表现更好。
实测收益:四节点NVFP4下prefill提升约5%、decode提升21%;八节点非量化模型上decode提升约18%。这与前面说的延迟换带宽的取舍一致。该后端已合入FlashInfer,启动自检失败时会透明回退到NCCL。该后端只适用于交换机连接的拓扑,依赖节点间直接点对点交换;这不是要替代NCCL,NCCL仍是受支持的默认选项。
一到八节点:解码涨4.4倍,预填只涨1.9倍
为了单独观察集群扩展行为、排除上下文相关的干扰,团队用稠密Qwen3.8-27B(NVFP4)、关闭投机解码与MTP,从1节点跑到8节点:
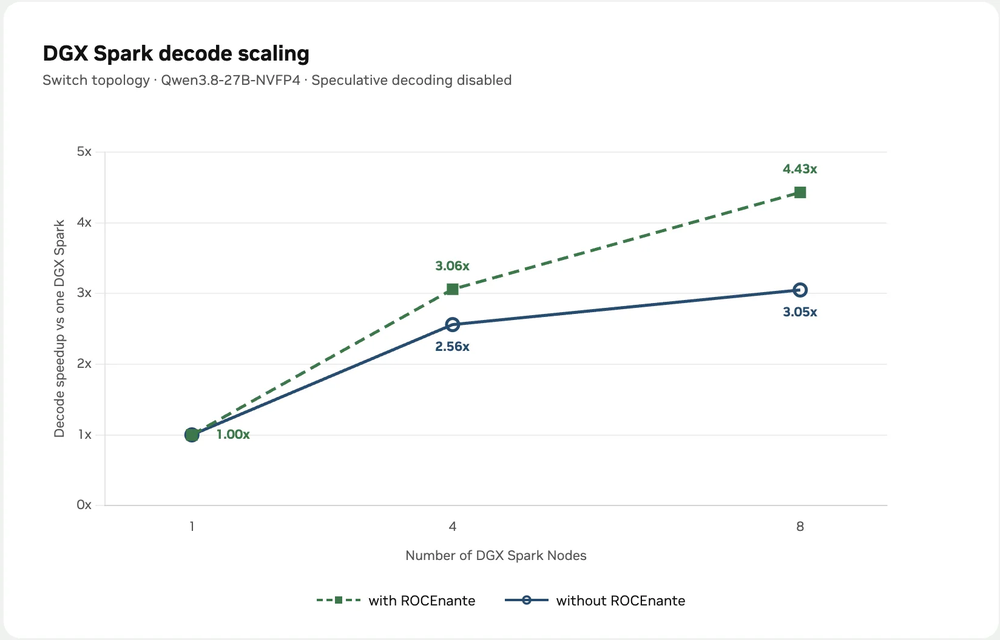
图2:Qwen3.8-27B在1/4/8节点上的解码加速比,ROCEnante后端在8节点拉开到4.43倍
| 节点数 |
拓扑 |
Prefill(TPS) |
Prefill扩展 |
Decode(TPS) |
Decode扩展 |
| 1 |
— |
2,635 |
1.00x |
11.86 |
1.00x |
| 2 |
直连 |
3,285 |
1.25x |
21.71 |
1.83x |
| 4 |
物理环 |
4,446 |
1.69x |
32.82 |
2.77x |
| 4 |
交换机(ROCEnante) |
4,556 |
1.73x |
36.34 |
3.06x |
| 8 |
物理环 |
4,962 |
1.88x |
40.11 |
3.38x |
| 8 |
交换机(ROCEnante) |
5,105 |
1.94x |
52.58 |
4.43x |
测量用llama-benchy,输入8,192 token、输出256 token、并发1,扩展倍数相对单台同精度机器。
两个模式很突出。第一,解码吞吐随节点数强扩展,从单节点约12 TPS到八节点52 TPS。第二,最优拓扑取决于负载:把所有节点铺开跑单个模型时,物理环就能给出很好的解码吞吐;一旦要把集群切成独立分组,或者需要节点间任意直连,就得上交换机。
无交换机环形:四节点的省钱选项
不是每个集群都需要交换机。DGX Spark节点可以直接串成环,成本更低、部署更简单,对爱好者与小规模部署很有吸引力。
在四节点部署里,NCCL默认对张量并行通信用环形算法,无交换机环拓扑正好与流量走向对齐,能以更低成本给出不错的吞吐。上表里四节点环的prefill与decode都表现良好。
规模上去或用途分化之后,画面就变了:
- 八节点或需要拆分分配:要把集群切成两组四台,环拓扑表达不了,必须上交换机。
- 全对全与传统HPC负载:依赖点对点模式的场景(例如基于MPI的集群)需要交换机,走环会付出跳数代价。
- 前面提到的优化集合通信后端:它要求节点间直接点对点连通,因此只适用于交换机配置。
一句话取舍:想要最简、最省的四节点推理盒子就用无交换机环;要扩到八节点、要拆分集群、或要跑环支撑不了的通信模式,就上交换机。
多模型编排:小模型接简单请求,吞吐翻三倍
不是每个请求都需要最大的模型。在共享的八节点集群上,把简单请求路由给小而快的模型、把大模型留给难请求,能显著提高总吞吐。
NVIDIA NeMo Switchyard让这件事可落地:一个轻量分类器检查每个请求(或会话),把请求路由到对应的模型池,再由负载均衡器在副本间分发。由于这套布局把八节点拆成互相独立的模型池,Switchyard必须跑在交换机连接的集群上,以获得跨副本路由所需的任意直连能力。
原型里用OpenBMB的MiniCPM5 2B做分类器兼简单任务执行模型,复杂任务交给Qwen3.8 Flash Next。在标准加困难的工具调用基准上,路由后的Agent质量与纯Qwen配置持平:
- 92个用例的工具调用基准(含困难用例)上,路由Agent得分91/100,与纯Qwen配置持平。
- 因为MiniCPM每副本的每秒请求处理能力比Qwen高约一个数量级,把部分流量挪给小模型会抬高整个集群的吞吐天花板。
在八节点上按三个Qwen副本(各占两节点)加两个MiniCPM副本(各占一节点)分配:
- 一半请求走Qwen时,总吞吐约为纯Qwen基线的1.5倍。
- 四分之一请求走Qwen、其余走MiniCPM时,总吞吐约为3.0倍。
路由策略就是一个简单的YAML文件,NVIDIA提供样例策略作起点,开发者可以按自己的负载调整切分与分类器。
从头预训练:8节点7.79倍,效率97.4%
训练的行为与推理不同。当每个节点各持一份完整模型副本时,唯一的跨节点通信是每步一次的梯度同步,因此集群扩展接近线性。
团队用nanochat从头预训练做演示:约8.965亿参数、20层Transformer、隐层1,280、序列长2,048,逐步加节点测吞吐:
| 节点数 |
TPS |
加速比 |
扩展效率 |
| 1 |
8,741 |
1.00x |
100.0% |
| 2 |
17,202 |
1.97x |
98.4% |
| 4 |
33,640 |
3.85x |
96.2% |
| 8 |
68,079 |
7.79x |
97.4% |
每步全局批量为524,288 token,每卡微批32条序列。八节点给出7.79倍加速、97.4%效率:这种近线性扩展,让八节点Spark集群成为从头训练小模型的可用平台,而不只是服务大模型。这条路径同时也是一条自然的上手路径:在本地做原型与预训练,模型长大后再横向扩展。
结语
桌面级设备组集群的意义不在峰值算力,而在把「本地能跑多大」这条线整体推高一个档次。1TB统一内存让470GB的753B模型落地,4.43倍的解码扩展让多节点不只是装得下、还能跑得动,97.4%的训练效率则把同一台机器变成训练平台。
但三条曲线也说明扩展不是免费的:预填只涨1.94倍、解码涨4.43倍,说明瓶颈已经不在内存带宽而在算力与通信;ROCEnante用小消息省下的延迟,会在节点数变多后变成带宽负担。选拓扑前先想清楚要跑的是单模型铺开、还是多模型拆分,答案不同,硬件配置也不同。
参考:https://developer.nvidia.com/blog/running-frontier-class-ai-models-across-8-nvidia-dgx-spark-nodes/
 发表于 昨天 18:46
|
查看: 2|
回复: 0
 /1


