要点速览
- 公理:最小化数据搬运——大模型超 90% 系统能耗花在内存上。
- 原则:低精度、异步、张量 DMA、大 scratchpad、高带宽、scale-out、专用通信硬件。
- 案例:TPU 脉动阵列与 Tenstorrent 不用 HBM 的赌局。
摩尔定律和 Dennard 缩放双双放缓,硬件架构师只剩一条路:领域专用架构。这篇从推理负载倒推,提出 7 条设计原则。
公理:最小化数据搬运
不久的将来,数十亿人可能在清醒时间里持续跑 AI 推理。要满足这个需求,必须对效率偏执,省下两种关键输入:能量和资本。摩尔定律与 Dennard 缩放放缓甚至停滞,硬件架构师别无选择,只能做 领域专用架构:为手头任务量身定制的架构。
GPU 在 深度学习 的主导地位很大程度上是意外:图形计算和深度学习的计算负载相似,纯属运气。图形时代的残留今天还留在 GPU 架构里。如果给 AI 推理从白纸重设计硬件,会长什么样?从推理负载倒推,能得出 DSA 该有的最优性质,也能预测推理范式会往哪转。这对硬件架构师保证投资回报至关重要。
Onur Mutlu 说过:大模型 超过 90% 的系统总能耗花在内存上。很多人看计算系统的视角,像哥白尼之前看宇宙:计算是地球,处在宇宙中心。这是理解 AI 推理的坏模型。
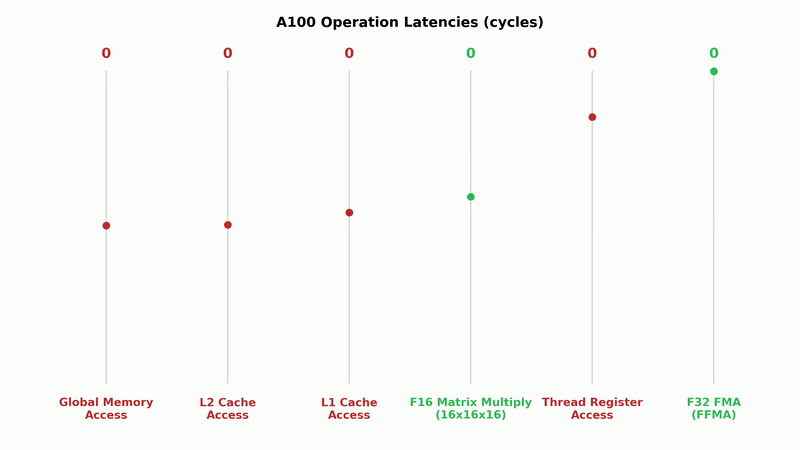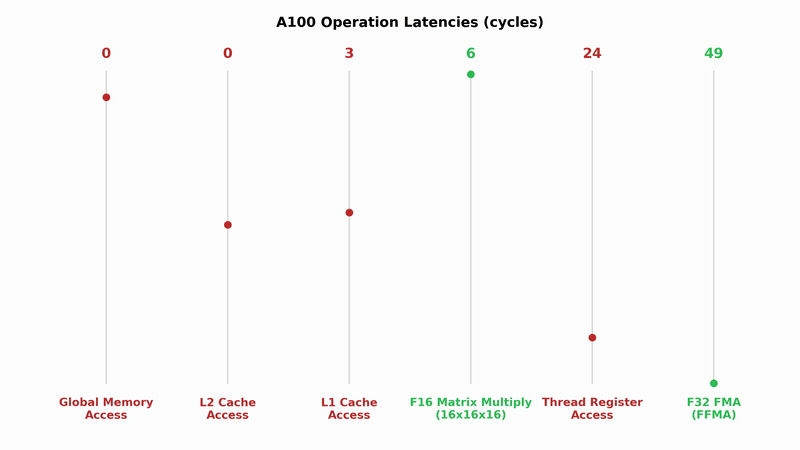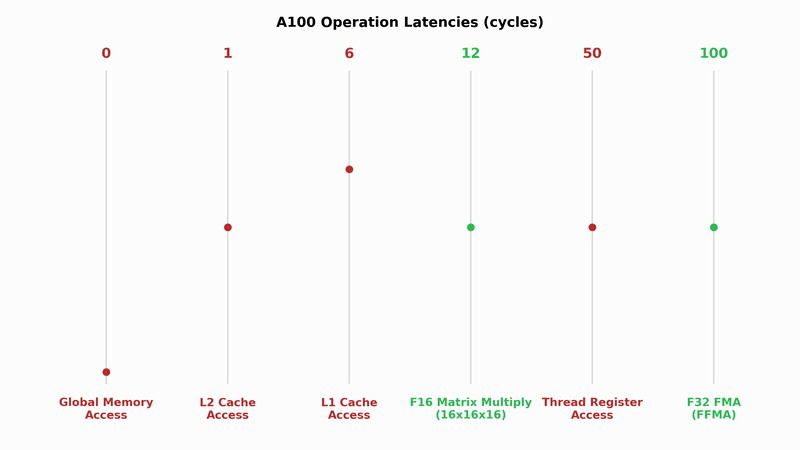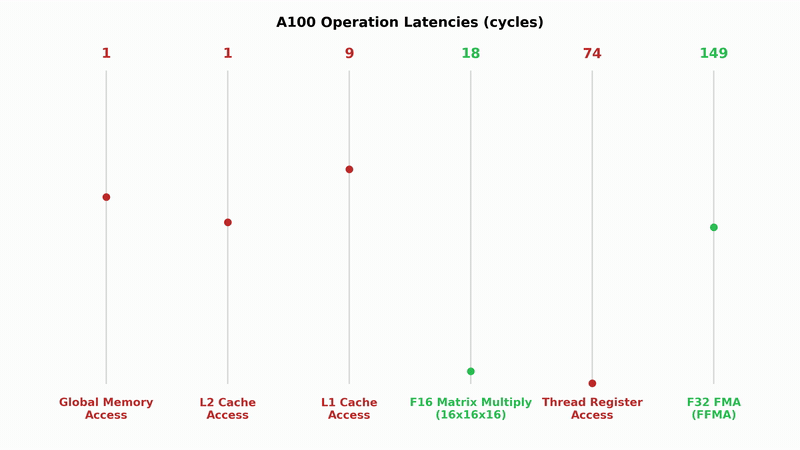
图1:A100 上不同操作的延迟,访存相对计算慢得离谱
内存的延迟和吞吐进步从一开始就落后于摩尔定律。读写真的很慢:下面动画改编自 Vrushank Desai,展示了 A100 上不同操作的延迟。注意算力和访存的速度差。
延迟和吞吐还不是全部。加速器的唯一真优化目标是每美元性能,降功耗是降总拥有成本的关键。下图是 Google TPU v4i 上不同操作、不同数据类型的能耗。注意 y 轴是对数:读写真的是天价,不管什么内存标准,跟真正的计算比都是碾压级耗能。
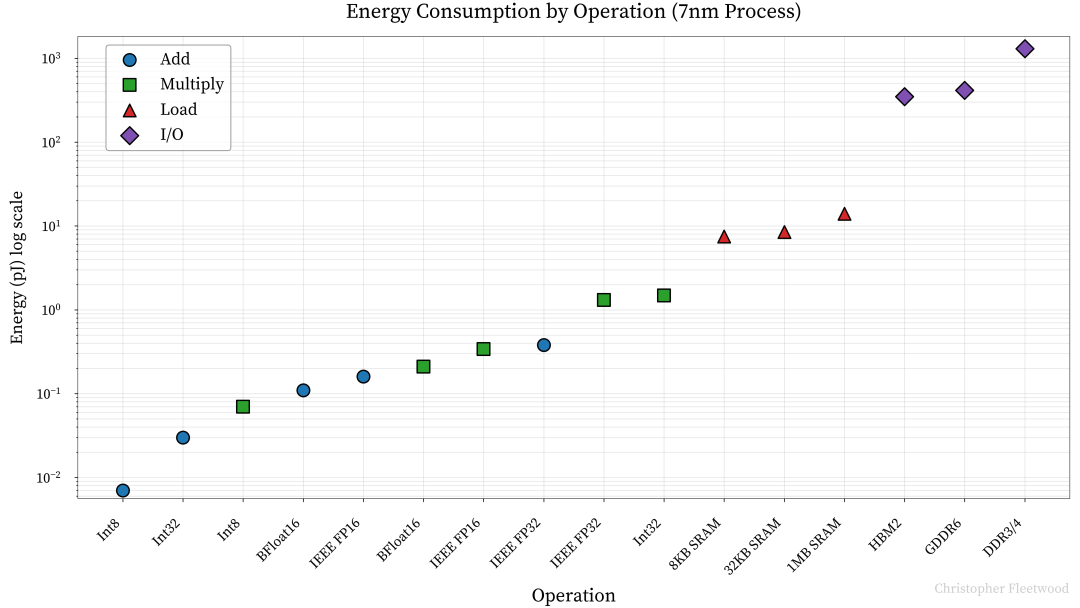
图2:TPU v4i 各操作各数据类型能耗(7nm,y 轴对数),DRAM 读写碾压计算
于是 DSA 的第一公理:最小化数据搬运。后面全文都以此为公理。
原则 1:低精度是印钞机
优化的第一招,是想办法不干这个活。最直接的是把权重张量变小:用更少 bit 表示权重,工作量直接砍半、砍到四分之一。现代加速器都支持 FP8 推理,最新一代已经摸到 FP4。要在低位宽保住数值精度,硬件要支持高精度累加和在线量化。但降位宽还有一个不明显的动机。
两个浮点数相乘需要的全加器数量,是尾数位数的二次函数。M 个尾数位的乘法要 (M+1)×(M+1) 个全加器阵列:FP32 要 576 个,FP16 是 121 个,BF16 是 64 个,FP8(E4M3) 是 16 个。每个乘法器用的加法器越少,单位面积塞的 算力 越多,或者把省下的面积换成 L1 缓存。
两股力量叠加,降精度的诱惑极大。可惜有下限:Transformer 到底需要多少 bit?智能和压缩深度纠缠,继续降精度迟早伤模型性能。Scaling Laws for Precision 的研究认为最优区在 7 到 8 bit 之间。
原则 2 和 3:异步与张量 DMA
减少搬运机会成本的简单办法,是异步数据搬运。双缓冲让计算单元在一块缓冲上算的同时,另一块在填充,计算、访存、卡间通信三重叠加,是硬件利用率拉满的前提。从 H100 起这已经是事实标准,任何自重的 DSA 都该异步优先设计。
前向里 Global Memory 到 Shared Memory 的搬运极频繁,值得做专用子系统加速。DMA 让张量在存储空间之间搬运完全不经过 CPU,Nvidia 叫它 TMA。H100 之前,Nvidia GPU 要求所有数据从 Global 到 Shared 都经过寄存器,就像把河水逼进软管。懂张量布局、能做节点内和节点间拷贝的 DMA,是未来 DSA 的核心关切。
原则 4:缓存换成超大 scratchpad
数据在系统里走多级缓存,每级在延迟、吞吐和容量之间权衡,类似人类记忆。缓存设计看两个维度:时间局部性(用过的数据很快会再用)和空间局部性(用过的数据邻居也快被用)。多处理器还要考虑一致性:H100 的 80MB 共享 L2 要多 SM 之间做同步与一致性检查,天生就慢。CPU workload 随机,3 到 4 级小缓存;GPU 批量可预测,2 级大缓存就够。
回到推理:权重张量从 DRAM 搬进 L1,一口气用完,下次再用是下一次前向。缓存(存下来为复用)的前提整个垮掉:按典型缓存层次做 AI 推理,L1/L2 里塞的都是短期不会再用的数据。
真正要的是一块高带宽低延迟的暂存,像 L1/SRAM,但跳出缓存范式:存着权重张量的块,边存边算。这就是 scratchpad,砍掉缓存管理的所有开销。理论上 scratchpad 够大,kernel 之间连中间张量都不用回 Global Memory。可惜 SRAM 一 bit 要 6 个晶体管,几 KB 就吃掉大片本可做算力的面积。Cerebras、Groq、Tenstorrent 都在拿算力换缓存。
算一算:prefill 与 decode 谁吃算力
现代 Transformer 只有 6 种操作:注意力、FFN、RMSNorm、激活函数、RoPE、残差相加。性能只看前两个,其余理想情况下能融进去。推理分两个算力需求迥异的阶段:prefill 并行处理长 prompt 填 KV cache,decode 自回归逐 token 生成。
算法有个算术强度:操作数除以访存字节。硬件有个 ops:byte:算力带宽除以内存带宽。算法强度超过硬件比值就是计算瓶颈,我们要的就是计算瓶颈,硬件才一直在干有用的活。参考点:[4096,4096] 的 BF16 矩阵是 32MiB。下表是几款硬件的 DRAM/SRAM 参数。
| 硬件 |
FP16 TFLOPs |
DRAM(GB) |
DRAM 带宽(TB/s) |
DRAM ops:byte |
SRAM(MB) |
SRAM ops:byte |
| NVIDIA H100-SXM5 |
989 |
80 |
3.35 |
295.2 |
30.81 |
31.9 |
| NVIDIA A100 |
312 |
40 |
2.0 |
156.0 |
20.72 |
16.4 |
| Tenstorrent Blackhole |
387 |
32 |
0.51 |
758.8 |
204.93 |
8.3 |
| Google TPU v4i |
138 |
8 |
0.61 |
226.2 |
144 |
10.2 |
几乎所有 FLOPs 都在矩阵乘。matmul 有个关键性质:计算量随维度立方 O(n³) 涨,访存量随平方 O(n²) 涨,维度越大算存比越好看。最常见的前向 matmul 是 [B,D]×[D,F]。什么时候变计算瓶颈?设 T_math = 2BDF / 加速器FLOPs,T_mem = (2BD + 2DF + 2BF) / DRAM带宽。H100 上 989 TFLOPs 除以 3.35TB/s,得到 B ≥ 295 = B_crit。推理时这几乎只在 prefill 发生,decode 想凑 295 batch 太难。量化到 FP8 也救不了:H100 的 FP8 算力也翻倍,回到原点。想降 B_crit,要么加 HBM 带宽(对每美元性能边际递减),要么拿算力换 SRAM:H100 的 SRAM 侧 B_crit = 32,低强度算法也能喂饱算力。
FlashAttention 下单头注意力强度 = 4BSTD/(4BSD+4BTD) = ST/(S+T),S 是已有序列长,T 是当前采样 token 数。prefill 时 S=T,化简得 T/2:H100 上 T ≳ 590 就是计算瓶颈,常见 system prompt 都够。decode 时 T=1、S 远大于 T,强度约等于 1:decode 本质是访存瓶颈。直觉也对:加载巨大的 KV cache,只对 [1,D] 做一点点操作。不改架构(MQA、GQA、MLA)shrink cache,没辙。
KV cache 还是容量问题。用 DeepSeek V3 的 61 层、7168 隐宽估算,MHA 下每 token 存 2×2×61×56×128 = 1749KB。H100 的 80GB 在 cache 到 46000 token 时就被吃光,朴素 MHA 根本做不了长上下文。MLA 把 k 和 v 压成一个 512 维隐向量:2×61×512 = 62.5KB/token,小 28 倍,撑到约 130 万 token 才爆 H100。SRAM 里 MHA 只能存 17 个 token 的 cache,MLA 能存 492 个,整页注意力可以放片上。下限还在,但层间投影可能把 cache 压得更小。
原则 5 到 7:带宽、scale-out、通信硬件
单加速器装不下前沿模型,必须多卡切分。加卡能分摊算力和内存,但卡间通信开销涨,能用来掩盖通信的计算 per chip 变少,加到某一点就不赚了。想拿计算盖住通信,ops:comms(能做的操作数除以能发的字节数)是关键。
decode 只用模型并行切。1D 模型并行里 MLP 层对输入 AllGather、对输出 ReduceScatter。两次 matmul 共 4BDF FLOPs,通信 2 个 [B,D] 矩阵:T_math = 4BDF/(Y·C),T_comms = 4BD/W,Y 是卡数,C 是单卡 FLOPs,W 是带宽。要 T_math ≥ T_comms,化简得 F > Y·C/W,C/W 正是 ops:comms。用 DeepSeek V3 的 F=18432,H100 在约 16 卡进入通信瓶颈。ops:comms 越好看,张量并行走得越远。这里忽略了延迟,小数据量时延迟主导通信时间。
MoE 标配专家并行:每卡 host 一个或几个专家,token 按路由发到不同专家子集,算完 AllToAll 聚合。AllToAll 是重切分:batch 维切分的 token 按路由结果重切分,矩阵满天飞,要低延迟高吞吐的 fabric。同样的原语反复跑,值得做专用硬件。DeepSeek V3 论文点名要通信的硬件优化:没厂商优化就自己拿 20/132 个 SM 专做通信,管 AllToAll 聚合的 reduce、专家间张量的内存布局。SM 本来是干计算的,拿来管网络,15% 的 Tensor Core 被浪费。RDMA 如果能在搬运中顺手做点变换(到目的地已规约、已转置),就很仿生:大脑的轴突也不只是被动传信号。
| 硬件 |
FP16 TFLOPs |
互连 |
双向带宽(GB/s) |
ops:comms |
| NVIDIA H100-SXM5 |
989 |
NVLink 4.0 |
900 |
1099 |
| NVIDIA A100 |
312 |
NVLink 3.0 |
600 |
520 |
| Tenstorrent Blackhole |
387 |
以太网 |
800 |
484 |
| Google TPU v5p |
459 |
ICI |
600 |
765 |
范式会往哪转:串行与并行扩展
硬件设计时,范式不会等你。test-time compute scaling 被称为下一条 scaling law,推理算力有两个扩展维度:串行和并行。
串行是拉长多步推理链,像 Kahneman 的系统 2 思维。这会暴涨推理需求,尤其是 decode:decode 的注意力本质是访存瓶颈,大 batch 才救得回来,能撑高并发的服务商会有规模经济。
并行是 n 个分身同时想,各自落在解空间不同处。decode 要 B ≳ 295 才吃满硬件,serving 里即使连续批处理也不容易凑;既然并行扩展已被证明能提质量,直接拿并行思维链把 batch 填满,利用率上去了,用户体验还免费变好。今年会是研究两个维度最优权衡的热点:token 最优的推理时扩展,很像探索利用困境。
TPU:脉动阵列把搬运压到极限
Google TPU 是计算史上最成功的 DSA 之一,细节就不展开了。结论:TPU 遵守了上面全部原则,所以按每美元性能算,它是当今第一加速器。
最值得看的是脉动阵列:128×128 权重驻留的脉动阵列,名字来自和人体循环系统的相似:数据(血液)流过很多处理单元(细胞)再回内存(心脏)。权重预载进处理单元,输出从左到右累加。
脉动阵列的核心好处是把数据搬运压到理论极限。朴素方阵乘法 n³ 次内存读,空间复杂度 3n²;分块优化到 Θ(n³/(b√M));脉动阵列干到最优的 2n² 次读。理论上每个输入和权重元素只读一次,在阵列里流动中被反复用。实际中阵列维度固定、负载尺寸多变,利用不满时整单元照样干活,伤功耗;喂饱阵列要复杂的软硬件。但 TPUv4 功耗比同代 A100 低 1.3 到 1.9 倍,理论效率在实践里兑现了。OpenAI 据报道今年也要流片自己的脉动阵列加速器。
Tenstorrent:不用 HBM 的赌局
Tenstorrent 2016 年成立,目标从零造 AI 加速器和软件栈,硬刚 Nvidia。即将推出的 Blackhole 是前面原则的实践案例。芯片布局第一眼像 GPU 的独立核心网格,但只是表面像:D 核管数据搬运,T 核是 Tensix 计算,E 核是以太网,CPU 核跑 Linux,还有板管核心。按功能特化的核心家族,正是专用硬件子系统的原则。
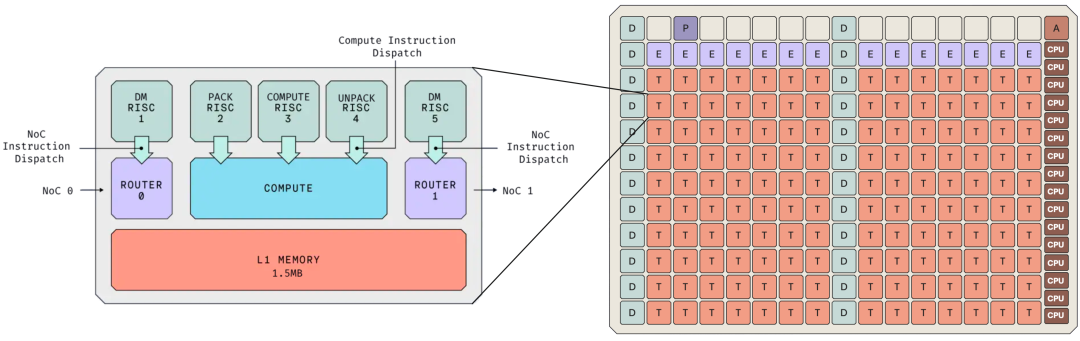
图3:Tenstorrent Tensix 核心与 Blackhole 芯片布局:D/T/E/CPU 按功能特化的核心家族
Tensix 核心对标 Nvidia 的 SM:两个数据搬运核在 NoC 上发起管理异步事务,是异步优先原则的直接实现;1.5MB 高速本地 SRAM,是 scratchpad 原则;32×32 矩阵块引擎对标 Tensor Core;三个计算核里两个专做数据类型打包解包,是低精度原则。NoC 把全片核心连起来,核间、跨以太网到别的加速器都能拷:便宜加速器加大带宽 scale-out,这就是 Tenstorrent 的 thesis。软件栈也反传统:不像 CUDA 那样 kernel 结束 L1 就未定义,中间结果可以留在 L1 里连续变换,几乎是脉动式的:反复变换再回内存,死守最小化数据搬运。
最有争议的是 Blackhole 拒绝 HBM,用 GDDR6,带宽只有 512GB/s,对比 H100 的 3.35TB/s。Jim Keller 说 HBM 太贵,做不到 commodity 定价。算账:2023 年 H100 的 BOM 约 3320 美元,SemiAnalysis 估 HBM3 按 15 美元/GB,内存占整机 BOM 约 36%,GDDR6 便宜得多。Tenstorrent 赌的是:超大 L1、异步搬运、NoC、更灵活的编程模型,HBM 可以不要。风向也在帮它:MLA 证明注意力不一定永远访存瓶颈。如果啃下低延迟高带宽互连,参数加载负担可以分摊:T_mem = 2P/(N·A_bw),P 是参数量,N 是卡数,A_bw 是单卡内存带宽。
挑战巨大。最大的是软件:CUDA 护城河常被挂在嘴边,但真正的护城河是全球上千个把 SIMT 范式内化了的工程师。从零写软件栈、透明扩展到几千卡、逼工程师从 SIMT 换到 MIMD,可能是桥太远。而且 Nvidia 账上躺着约 380 亿美元现金,行业极度资本密集:制程的好节点它先挑,范式如果更吃内存,HBM4e 起它先拿。但如果 Tenstorrent 24 个月内拿出像样的软件栈,架构风向继续往它这边吹,它会是强有力的挑战者。
下注:大脑是唯一的存在性证明
设计流片一轮 2 到 3 年,AI 范式跑得快得多,新架构新数据类型层出不穷。硬件按去年的模型优化好,三年回本期没到范式变了,hyperscaler 花 800 亿美元买的硬件就砸手里。没人能准确预测架构突破,但能不能看出点方向,对冲投资?
如果构造 AGI 的方法搜索空间又大又稀疏,就该向唯一存在性证明取经:人脑。Hassabis 2010 年的 talk 提出用系统神经科学迭代开发 AGI 组件:不是无脑模仿大脑,而是理解抽取底层算法,再创造性务实地在软硬件里重实现。2017 年的论文列了 AI 创新和大脑的对应:这不是巧合,是智能景观里的趋同演化。前沿模型全是 MoE,和大脑的区域特化如出一辙。往前看,情景记忆、海马新皮层巩固系统都可能被搬进硅片。
推理需求的增长短期不会停。在这个市场里做推理硬件想对冲注定失败:效率来自特化,特化和灵活水火不容,必须大胆赌架构风向。系统神经科学给了个看未来的 lens。程序员也一样是投资人,时间和 expertise 是资本,早押中一个成功的技术方向回报巨大,但同样要敢下注。这篇的原则,最小化数据搬运、优化内存层次、为 scale-out 设计,是给敢下注的人的路线图。大卫能不能干掉歌利亚,走着瞧。
结语
公理:最小化数据搬运,大模型超 90% 的系统能耗花在内存上。
7 条原则:低精度、异步优先、张量 DMA、超大 scratchpad、单卡带宽拉满、scale-out、专用通信硬件。
TPU 的脉动阵列把读数压到 2n² 的理论极限;Tenstorrent 赌不用 HBM,用 GDDR6 加超大 L1 和 NoC 打每美元性能。
效率来自特化,特化和灵活水火不容。做推理硬件,就得大胆赌风向。
参考:https://fleetwood.dev/posts/domain-specific-architectures
 发表于 昨天 18:51
|
查看: 1|
回复: 0
 /1


