Attention 负责让 Token 交换信息,FFN 负责对每个 Token 做非线性加工。但如果想继续扩大 FFN 的容量,又不想让每个 Token 都多算一遍,怎么办?
MoE 流行的核心原因,是模型还想继续扩大容量,但训练和每次生成的计算成本不能跟着总参数一起涨。 它让不同 Token 只调用部分专家,用更大的参数容量,争取更好的质量与计算成本组合。这里的“稀疏”指专家按需激活,不是权重里有大量零。
到了 2026 年,录友再看模型介绍,经常会看到两组参数:总参数量和激活参数量。例如 Qwen3.5-397B-A17B 的语言模型部分,总参数是 397B,每个 Token 激活约 17B。为什么参数差这么多,部署时却不能只准备装下 17B 的显存?官方模型卡给出了这两组数字。
面试官问:“为什么越来越多大模型采用 MoE?它每次只选几个专家,是不是显存、延迟、费用都能按这个比例下降?”
常见回答是:“8 个专家选 2 个,所以成本就是原来的四分之一。”这只算了专家部分,还漏掉 Attention、共享参数、数据搬运和通信。拿它估算部署资源,很容易发现模型装不下,或者装下了却没快多少。
简要回答
- 采用动机是提高计算效率。 相对总参数相近的稠密模型,MoE 减少每个 Token 的专家计算;在相近计算预算下,则有机会训练容量更大的模型。负载均衡、低精度计算和专家并行等工程进展,让这条路线更容易落地。
- MoE(Mixture of Experts,混合专家) 通常会把部分或全部 Transformer 层里的单个 FFN,换成多个独立 FFN 和一个 Router(路由器)。
- Top-K 路由 让每个 Token 只调用 K 个路由专家,再把输出加权合并;专家通常和 Router 一起训练。
- 总参数对应模型容量和权重存储,激活参数帮助估算每个 Token 的计算。 两者都不能单独决定实际延迟。
- 负载均衡 要防止少数专家过载,常见方法包括辅助损失、路由偏置调整;部署还要处理专家分布和跨卡通信。
MoE 仍是大型模型的重要路线,稠密模型也有适用场景。 MoE 把“能存多少参数”和“每个 Token 算多少参数”部分解耦,省下的计算能不能变成吞吐收益,还要看系统实现。
详细回答
1. 为什么越来越多大模型愿意采用 MoE?
先看稠密模型的矛盾:扩大参与计算的网络,通常也会增加每个 Token 的计算量。 模型要处理海量训练 Token,上线后又要持续生成答案,这笔计算开销会被反复支付。
MoE 的吸引力,主要来自三件事:
- 训练时,让容量增长不必伴随同等比例的计算增长。 增加专家数量,同时固定每个 Token 选中的专家数,就能扩大总参数,而不让专家计算量按总参数等比例上升。不同 Token 更新不同专家;通信、优化器状态和权重存储仍要付出代价。早期的 Switch Transformer 论文就验证了这种扩展路线。
- 推理时,争取以较少的激活计算提供较强能力。 服务商关心的是达到目标质量后,每生成一个 Token 要花多少资源。MoE 提供了一个折中:保留较大容量,每步只调用部分专家。长回答、多轮调用会让每步开销累积,因此这个方向很有吸引力。它不保证比任何小型稠密模型都便宜。
- 工程上,原先难以兑现的收益更容易落地了。 DeepSeek-V3 展示了负载均衡、FP8 训练和计算通信重叠的协同设计;vLLM 也提供了专家并行及负载均衡的部署能力。它们降低了采用 MoE 的工程门槛,但没有消除显存和通信成本。DeepSeek-V3 技术报告、vLLM 专家并行文档
例如,固定每个 Token 选择 2 个专家,把专家总数从 8 个增到 16 个,路由专家的总参数翻倍,单 Token 的专家计算量大致不变。这里假设专家大小相同,忽略 Router 和通信;质量能提升多少,还要靠训练与评测验证。
所以,“为什么流行”的答案是:模型厂商愿意承担更多存储和调度复杂度,换取更好的质量与计算成本组合。 不是因为专家越多就一定越聪明,也不是因为总参数可以免费增加。
2. 现在有其他更流行的架构取代 MoE 吗?
从截至 2026-11-06 核对的公开资料看,不能说 MoE 已被另一类架构全面取代。 更准确的判断是多条路线并存;下面这些例子能说明它们仍在被采用,不能据此推算全行业使用占比或热度排名。
| 路线 |
主要解决什么问题 |
公开例子与判断 |
| MoE |
扩大参数容量,同时控制每 Token 的激活计算 |
DeepSeek-V4.1-Flash 仍明确采用 MoE,说明这条路线仍在延续 |
| 稠密模型 |
用较简单的计算与部署结构满足任务质量要求 |
Gemma 4 同时提供 31B 稠密版和 26B A4B MoE 版;同一系列也会保留两种选择 |
| 混合注意力/线性注意力 |
优化序列处理、长上下文计算和缓存 |
Qwen3.5-397B-A17B 把 Gated DeltaNet 与 MoE 结合,二者可以叠加 |
这里最容易混淆:MoE 主要回答“这一层调用哪些 FFN 专家”,注意力架构回答“Token 之间怎样交换信息”。 不能看到“混合架构”四个字,就认为它替代了 MoE。推理模型、多模态模型描述的则是能力或输入输出形式,也不能直接拿来和 MoE 做二选一。
录友自己部署时,若小型稠密模型已达到质量要求,显存又紧张、并发也低,它往往更容易部署和调优。若要继续扩大容量,并且有足够的存储、互联和请求量,MoE 才更有机会体现收益。模型家族的更新,不等于架构路线的淘汰。
3. 为什么经常从 FFN 下手?
先看一个便于计算的标准 Block:隐藏维度为 $d$,普通多头注意力的四个投影约有 $4d^2$ 个参数;两层 FFN 的中间维度取 $4d$,约有 $8d^2$ 个参数。这里忽略偏置,FFN 就占这两部分参数的三分之二。
这是标准 MHA + 两层 FFN 的示意算式,不能直接套到 Llama 等现代模型。GQA 会改变注意力投影参数,SwiGLU 则有三组投影,中间维度也未必是 $4d$。
关键在于:FFN 参数通常很多,而且可以对不同 Token 独立计算。把它换成可选择的多个 FFN,比较适合扩大参数容量。
MoE 是增加独立专家网络,不是把原来一个 FFN 的权重简单切成几份。 专家的宽度、个数和激活数,都属于架构设计。
4. Router 到底在选什么?
Router 读到的是这一层的 Token 隐藏向量,里面已经带有上下文信息。最简单的做法是线性投影,再用 Softmax 给 N 个专家打分,选得分最高的 K 个。
仍用“我爱吃麻辣烫”做例子。为方便展示,暂时把它当作四个 Token;实际切分由 tokenizer 决定。下面分数和选择都是示意,不是训练观测结果。
| Token |
Expert-0 |
Expert-1 |
Expert-2 |
Expert-3 |
Top-1 选择 |
| 我 |
0.1 |
0.6 |
0.2 |
0.1 |
Expert-1 |
| 爱 |
0.3 |
0.5 |
0.1 |
0.1 |
Expert-1 |
| 吃 |
0.2 |
0.1 |
0.5 |
0.2 |
Expert-2 |
| 麻辣烫 |
0.1 |
0.2 |
0.6 |
0.1 |
Expert-2 |
这不能说明 Expert-1 就是“抽象词专家”,Expert-2 就是“具象词专家”。 路由可能形成某些偏好,但专家编号没有预先指定的语义;不同层的同编号专家也不是同一个网络。
假设改成 Top-2,“我”会选 Expert-1 和 Expert-2。若采用“选中后重新归一化”的规则,权重就是 $0.75$ 和 $0.25$:
这是本篇和《手撕 MoE-FFN》采用的规则。真实模型也可能使用 Sigmoid 打分、额外缩放或共享专家,不能只看见 Top-K 就认定计算细节完全一样。
5. 为什么不能用 K/N 算整模型的成本?
假设一层里有 $N$ 个同样大小的路由专家,每个专家参数量为 $E$;把这一层始终参与计算的共享部分记为 $S$,暂时忽略 Router:
该层总参数约为 $N \times E + S$,单个 Token 的激活参数约为 $K \times E + S$,路由专家部分单个 Token 的激活比例是 $K/N$。
所以 K/N 只对应该层路由专家部分、单个 Token 的激活比例。如果还有共享专家,它们也要算进始终激活的部分。一个 batch 里,不同 Token 还可能合起来用到全部专家。
Mixtral 8×7B 就是经典反例:它并非 8 个完整的 7B 模型拼起来。官方公布的是总参数约 46.7B、每个 Token 使用约 12.9B,因为 Attention 等部分共享。8×7B 不能直接乘成 56B。Mistral 官方说明
比较时还要说清基线。 相对总参数相近、全部参与计算的稠密模型,MoE 能减少专家计算;相对激活参数相近的小型稠密模型,MoE 的权重存储和调度反而更重。质量是否更好,要看训练和评测。
6. 负载不均衡为什么会拖慢整个模型?
假设四个 Token 都选 Expert-0。Expert-0 忙着排队,其余专家没活干;如果分布在不同 GPU 上,其他卡还得等最忙的卡算完。
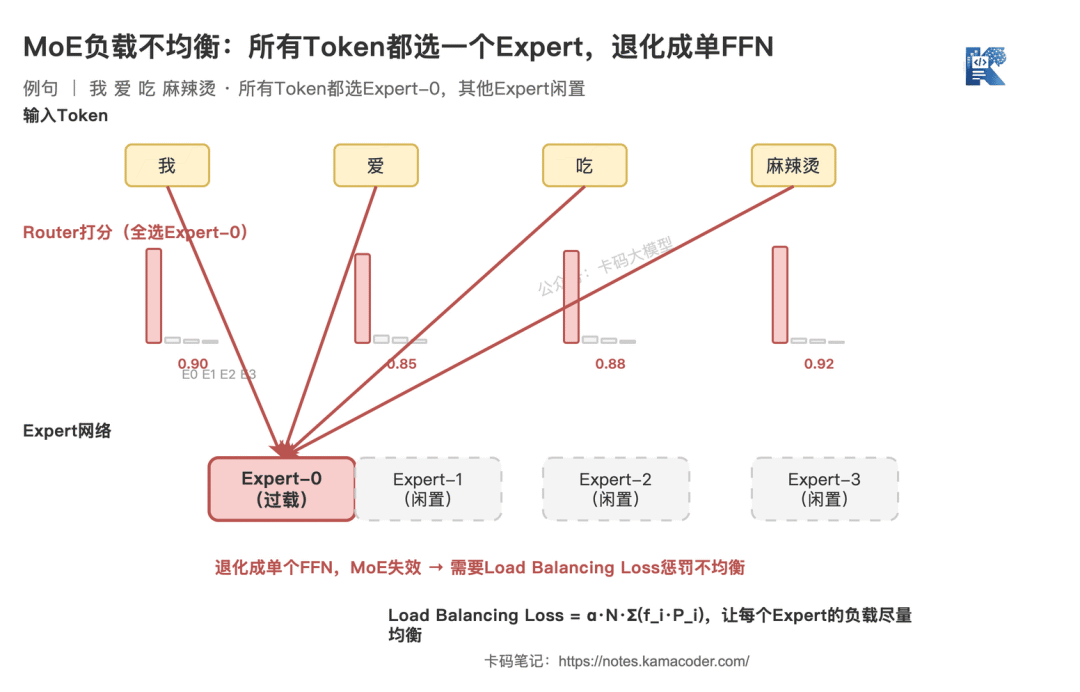
图中红色 Expert-0 接收了全部 Token,灰色专家闲置,表示一种极端的 Top-1 负载塌缩。图里的辅助损失是传统处理办法之一;多层模型仍可能保留输入相关的门控,不能把整模型严格等同于一个普通 FFN。
一种常见的辅助损失写法是:
$$
L_{aux} = \alpha N \sum_{i=1}^{N} f_i P_i
$$
这里 $T$ 是有效 Token 数,$K$ 是每个 Token 的选择数,$f_i$ 是专家 $i$ 被选中的 Token 比例,$P_i$ 是对全部专家归一化后的平均路由概率。按这个定义,所有专家的 $P_i$ 之和为 1;其他论文可能采用不同缩放,不能只抄系数。
$f_i$ 来自离散选择,通常不对它求导;梯度经由 $P_i$ 回到 Router。一个专家被选得越多,它的平均概率对应的惩罚权重就越大。这个损失在调节负载,不是在判断专家“擅不擅长”。 系数太大,还可能干扰主任务。
7. 2026 年读 MoE,哪些参数例子值得看?
下面是截至 2026-11-05 核对的公开架构示例,用于比较总参数与激活参数,不是性能排名,也不表示各家最新型号都在表里。
| 公开模型 |
总参数 |
每 Token 激活参数 |
阅读重点 |
| Qwen3.5-397B-A17B |
397B |
17B |
语言模型部分有 512 个路由专家,每次选 10 个,另有 1 个共享专家 |
| DeepSeek-V4-Flash |
284B |
13B |
激活参数较少,仍需安排全部模型权重的存储和访问 |
| DeepSeek-V3 |
671B |
37B |
细粒度专家、共享专家,以及基于偏置调整的负载均衡 |
DeepSeek-V3 的负载均衡值得单独看:它通过负载统计调整专家的选择偏置,过载专家降低被选机会,空闲专家提高被选机会。用于选择专家的偏置,不直接加进输出加权分数。 报告还保留了很小的序列级辅助损失,所以“auxiliary-loss-free”不能解读为训练里完全没有任何均衡损失。技术报告相关章节
再看 Qwen3.5,它还把 MoE 和混合注意力结合起来。读报告时要拆开看:FFN 的稀疏计算、注意力的计算和缓存优化,是不同层面的收益,不能都归功于 MoE。
工程判断:怎样判断 MoE 适不适合部署?
先确认质量达标,再估算存储,最后实测吞吐和延迟。 别先用激活参数算出“应该很快”,再去找能支撑这个结论的配置。
| 要判断什么 |
优先检查什么 |
动作与代价 |
| 权重能否放下 |
总参数、精度、每卡分片,再加 KV Cache 和运行时空间 |
量化能减少存储,但要验证质量;卸载到 CPU 会引入搬运开销 |
| 多卡有没有收益 |
专家放置、跨节点流量、各专家 Token 数 |
专家并行把专家分到不同卡上,但要用通信换容量 |
| 延迟是否稳定 |
首 Token 延迟、逐 Token 延迟、P95、最长专家队列 |
调整批量、路由或部署副本,可能增加等待或资源消耗 |
| 成本有没有下降 |
相同质量和请求分布下的有效吞吐、GPU 时间 |
联合看 prefill 和 decode,不能拿单一阶段的峰值代替线上效果 |
专家并行通常需要把选中的 Token 向量发给对应专家,算完再合并结果,不是把 Router 的全部输出无条件广播给所有设备。小 batch 时矩阵乘法可能不够大,跨卡通信又难以摊薄,所以 MoE 不保证单请求一定更快。
常见的高吞吐部署会让全部权重驻留在 GPU 集群内存中,但不要求单卡装下全部专家。也可以用 CPU 卸载等办法降低 GPU 显存需求,只是存储需求仍在,延迟取舍也随之改变。
知识拓展
Q1:MoE 是多个模型投票吗?
通常说的 Transformer MoE,是单个模型内部对 Token 的条件计算。它和同时调用多个完整模型、对最终答案投票,不是一回事。
Q2:所有 Token 都必须选相同数量的专家吗?
固定 Top-K 是常见设计。Expert Choice 则让专家挑 Token,能固定每个专家接收的数量,但不同 Token 获得的专家数可能不同,需要另外处理覆盖问题。
Q3:超过专家容量,是把原句的 Token 删掉吗?
通常指跳过或重排该 Token 的某条专家计算分支,残差路径仍可保留,不是直接删掉输入文本。是否丢弃、重路由或采用不丢弃的实现,要看具体系统。
Q4:激活参数和 FLOPs 是一回事吗?
不是。激活参数主要帮助估算权重相关的计算;序列长度、注意力计算、Router、通信和内存访问都会影响实际开销。长上下文尤其不能只看这个数字。
记住:总参数、激活参数、实际延迟,是三个需要分别解释的指标。 能把它们之间的关系和边界讲清楚,比背一句“MoE 更省钱”有用。这类部署评估,也是云栈社区里经常被拿出来讨论的话题。
 发表于 4 小时前
|
查看: 1|
回复: 0
 /1


