27B 参数,真实世界双递归迭代框架。香港中文大学 MMLab、京东探索研究院等机构的研究团队提出了 CUA-Master,让模型从教程视频中学习电脑操作,能力逼近旗舰模型,执行效率却更高。
如果让 AI 帮你整理几十份文件、核对数据,再把结果填进桌面软件,它需要跨过一道关键门槛:既得看懂屏幕,又得选择合适的操作方式,还得控制执行成本,并且能从失败中恢复过来。
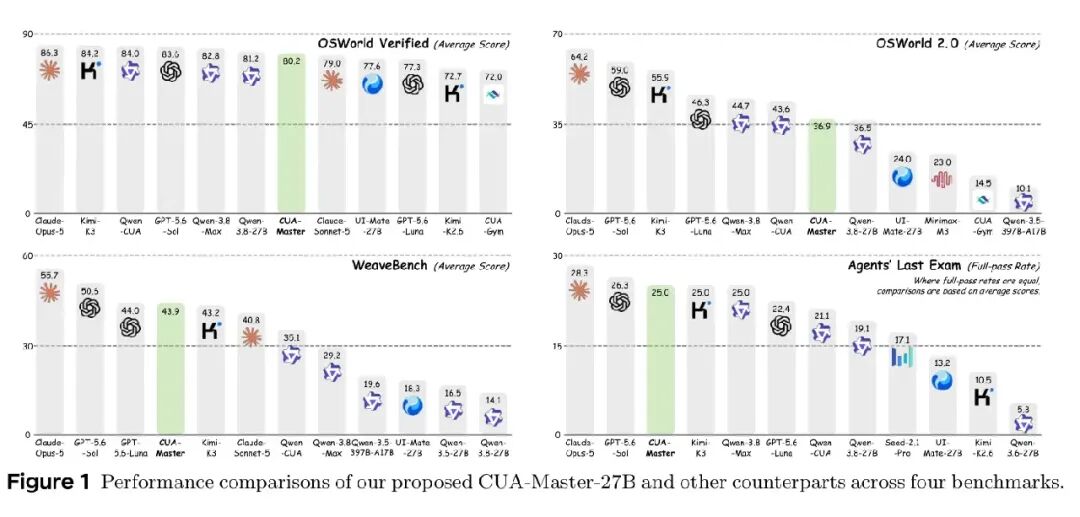
CUA-Master 给出了一种系统性的回答。研究团队以 27B 模型为基础,把开放世界知识获取、可控任务构建、真实环境执行与模型训练联结起来。在论文的四项主要评测中,它拿到了有竞争力的表现;更值得关注的是,完成任务所需的时间、步骤和能力三者如何同时改善。
01 先看结果:27B 小模型,在 CUA 领域逼近旗舰模型
CUA-Master-27B 在论文报告的四项核心基准上成绩如下:
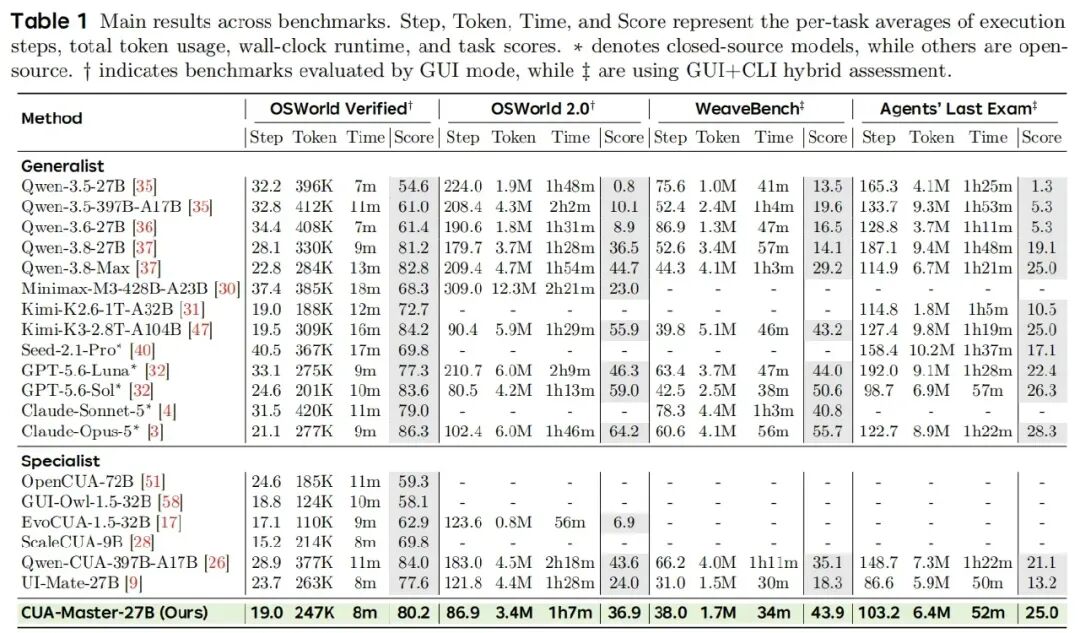
这些数字的看点,不只是分数。
在 WeaveBench 上,CUA-Master-27B 拿到 43.9 分,与论文所比较的 GPT-5.6-Luna 的 44.0 分接近,但平均执行时间从后者的 47 分钟降至 34 分钟,缩短约 28%。在 Agents' Last Exam 上,其 25.0% 的全任务通过率与 Kimi-K3、Qwen-3.8-Max 持平,平均用时则分别比这两者减少约 34% 和 36%。这些对比,体现了 CUA-Master 在真实使用场景中的优异性能。
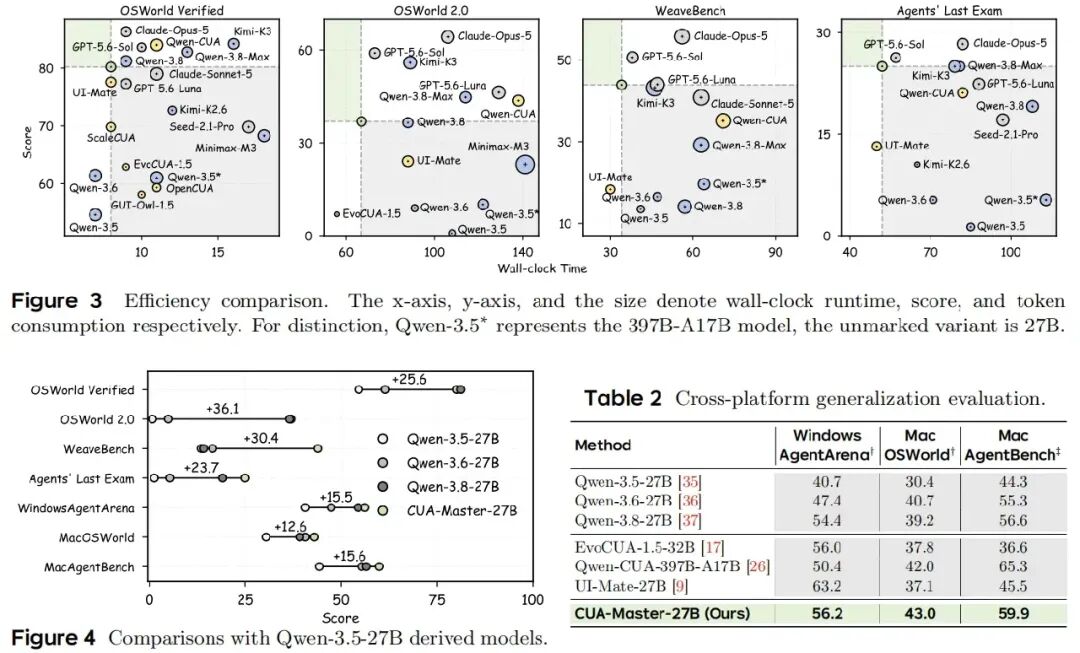
研究团队提出的模型在四个基准的分数与执行效率权衡上都落在了帕累托前沿上。论文还对比了跨 Linux、Windows 与 macOS 的效果:CUA-Master-27B 在 WindowsAgentArena、MacOSWorld、MacAgentBench 上分别取得 56.2、43.0、59.9 分。虽然不同基准的排名并不完全一致,但这表明模型能力并非只局限于单一操作系统或某一类界面。此外,与多款基于 Qwen-3.5-27B 的衍生模型对比,CUA-Master-27B 同样展现了更全面的综合能力。
02 让能力持续增长:从真实世界工作流出发,构建可扩展的 CUA 系统
高质量数据从哪里来?CUA-Master 没有把希望全部寄托在模型自己完全“编”出的新任务上。
研究团队首先从公开的软件教学视频中挖掘真实操作经验。其应用分类覆盖 8 大领域、36 个子领域、650 余种软件;通过视频筛选、任务片段识别,以及基于语义线索与画面变化的双路径重建,将非结构化的视频演示转化为可复用的 种子任务。
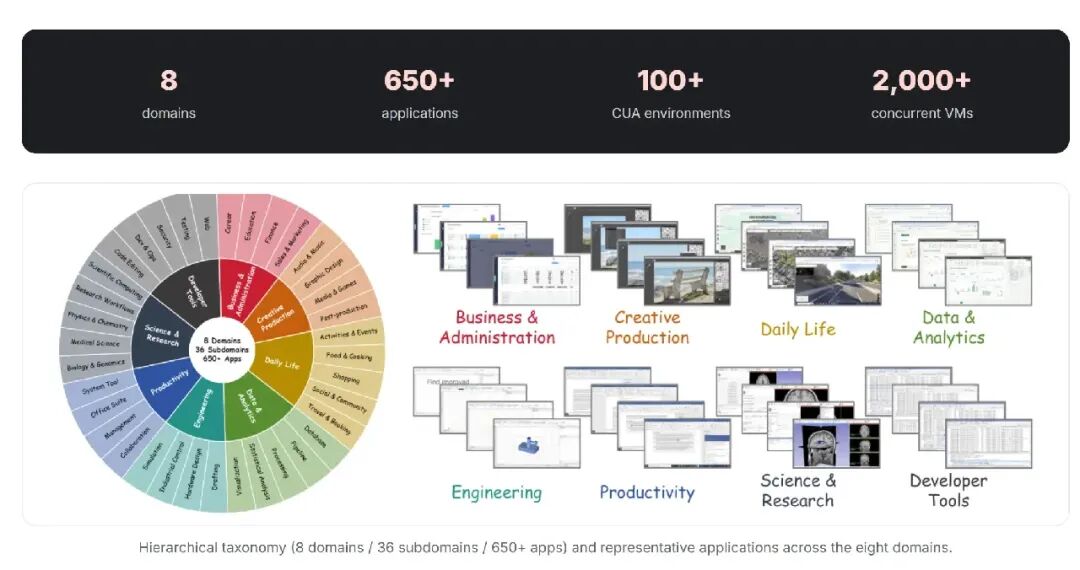
但真正关键的一步,是不止于“照着教程学会一次操作”。系统进一步把这些经验拆解为包含操作前提、环境要求和验证条件的 能力原语,再按复杂度和软件范围组合,生成新的、可以执行并验证的任务。
由此,数据构建形成了一个飞轮:
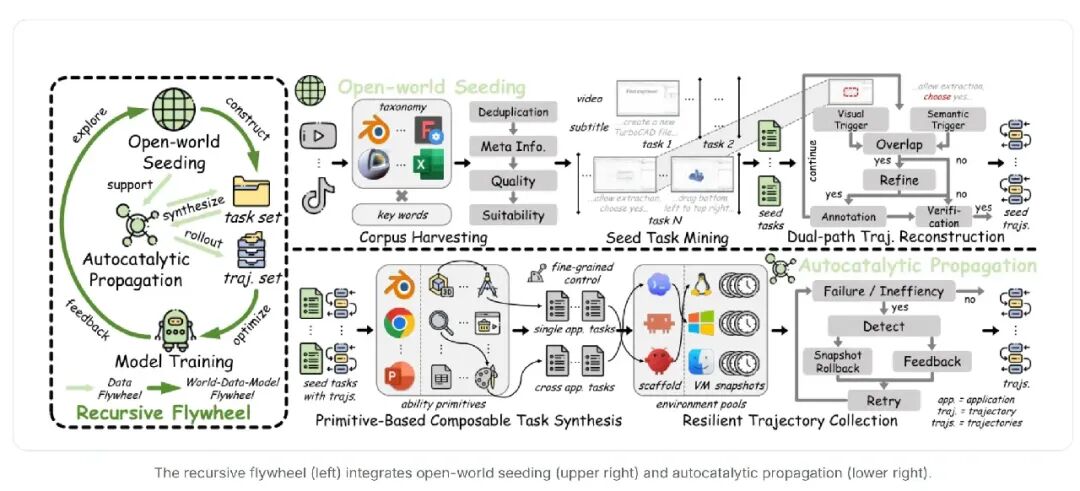
真实工作流 → 种子任务 → 可复用能力原语 → 跨应用复杂任务 → 收集的执行轨迹 → 下一轮迭代
在更外层,模型训练又反过来影响下一轮数据采集:哪里表现较弱,就更有针对性地探索相应软件、工作流和任务难度,形成一个更大的循环:
开放世界语料收集 → CUA 数据构建 → 模型训练提升 → 模型反馈 → 下一轮迭代
论文称之为 双层递归改进框架。在训练侧,论文采用了多个 SFT 阶段,累计约 115K 数据,外加 12K 高质量 RL 数据。
03 为什么更高效?先让 CUA 学会“该点鼠标时点鼠标,该敲命令时敲命令”
人使用电脑时,很少坚持只用一种操作方式。需要检查图像、调整界面参数,我们会看屏幕、点菜单;需要批量读取文件、汇总数字、处理结构化信息,我们往往更愿意调用脚本或命令行。前者直观,后者高效。优秀的 电脑操作 Agent,也应具备这种选择能力。
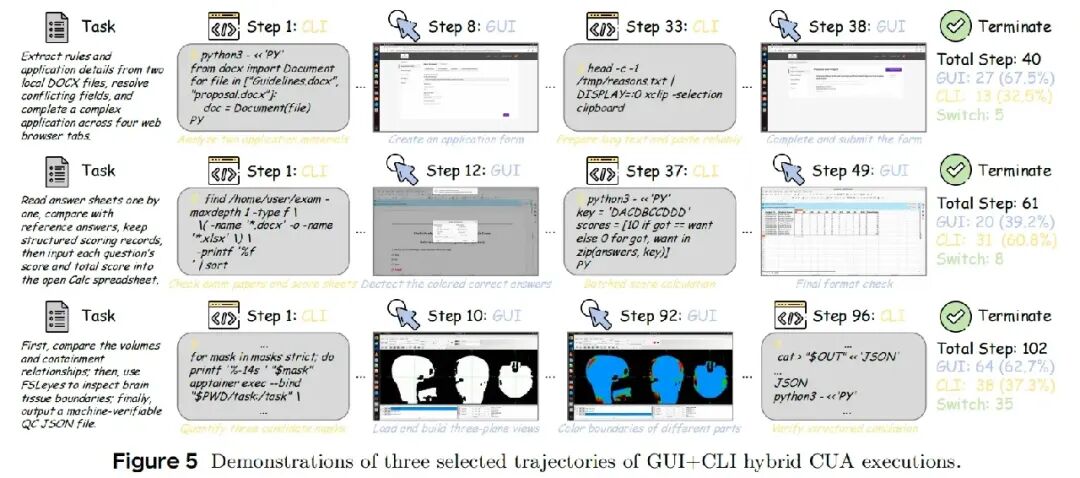
CUA-Master 将 GUI(图形界面)与CLI(命令行) 纳入统一动作空间,让模型在任务执行过程中按需切换。论文展示了批量核对答卷并录入电子表格、处理文档并完成网页表单、结合专业可视化软件检查数据等跨工具流程。
这并非简单地给 Agent 增加一个终端入口。更重要的是,它能够把文件处理、批量计算交给 CLI,把视觉检查、窗口交互交给 GUI,使两种能力在同一条任务轨迹中相互配合。混合模式相较仅 GUI 模式减少了执行步骤,有利于长链路任务的成功执行。
04 多重机制构建更多样、更可控、更可靠的大规模 CUA 训练数据
CUA-Master 不仅关注数据规模,更着重解决 CUA 训练数据的三个核心问题:多样性、可控性和可靠性。
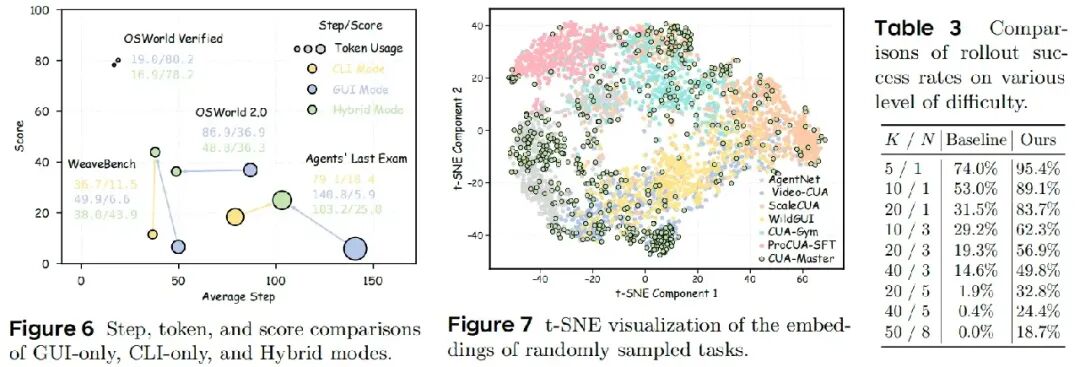
首先是多样性。通过从真实教程视频中提取操作经验,并将其转化为可组合的能力原语,CUA-Master 能够持续扩展任务类型。论文的 t-SNE 可视化显示,其生成的任务覆盖了多个现有 CUA 数据集的分布区域,并进一步拓展到数据相对稀疏的区域。
其次是可控性。系统通过两个维度精细控制任务难度:K 表示组合的能力原语数量,N 表示涉及的应用数量。通过检查操作前提、环境依赖和验证条件,系统能够构建从单应用简单操作到跨应用复杂工作流的可执行、可验证任务。
最后是可靠性。针对长任务容易因局部操作失误而失败的问题,研究团队提出反馈引导的快照回滚重试机制。当执行出现错误时,系统定位失败节点,回滚至最近的有效快照,仅重新执行失败部分,而非从头开始。
论文与代码
CUA-Master: Scaling Computer-use Agents through Open-World Recursive Improvements
https://arxiv.org/pdf/2611.03126
https://github.com/xlyu0106/CUA-Master.git
https://huggingface.co/yxl66666/CUAMaster-27B
 发表于 24 分钟前
|
查看: 2|
回复: 0
 /1


