近期上线的 Gemini 4 Argon 争议不少——编程表现似乎没有 benchmark 那么强,Antigravity Pro 订户还一度用不上——但很少有人说它写作不好。实际上,在 Claude 说话还算优雅的年代,Gemini 2.5 Pro 就已经以「说人话」出名了。
反观过去一年,OpenAI 和 Anthropic 的模型输出却越来越让人看不懂。Anthropic 顶多算连接卡壳,OpenAI 则干脆前言不搭后语。
我们过去批评 AI 写文章差,主要嫌 AI 腔太重:开口先来一段滴水不漏的场面话,紧接着就是「这不仅关乎某事,更是对某事的深刻重塑」的排比句,再加上千篇一律的起手式和没完没了的破折号。
但最近,AI 文本最大的问题已经从「腔调」变成了「读不懂」。它写出来的东西像一块干硬的「句法压缩饼干」——每个字你都认识,可只要读上三行,太阳穴就开始发紧;从头读到尾,好像有点道理,却记不住具体说了什么。
说实话,如今读某些 AI 写的东西,我已经有种生理性恐惧,像面对一袋要搬的水泥。因为我知道,读完它得死不少脑细胞。
而这,不只是我个人的主观感受。
01 微观上,意义的压缩挤爆了人类的认知带宽
很多人觉得 AI 写的东西不好读,是因为生僻词多、术语频繁。但 2026 年 10 月,纽约大学(NYU)与得克萨斯大学奥斯汀分校(UT Austin)的联合团队发表了一篇论文《Why is AI-generated language so hard to understand?》。他们把 Claude Opus 5.5、GPT-5.6 Sol、Kimi K2.5、GLM 5 等主流前沿大模型生成的文本与人类真实写作放在一起,做了一次细颗粒度的心理语言学对比。
结果发现,哪怕把词汇难度完全控制住,AI 写出的句子依然在人类大脑的生理雷区里蹦迪。因为它的信息太密了。
要理解这个现象,得先引入心理语言学里的一个规律:均匀信息密度假说。
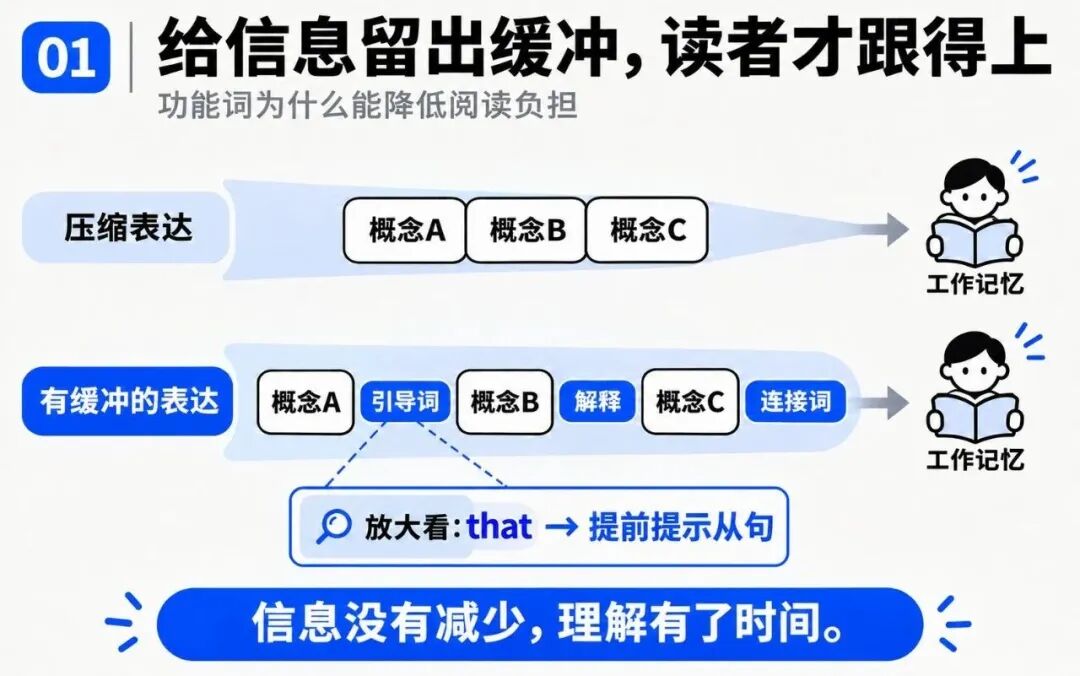
人类大脑的工作记忆就像一根口径固定的输水管,每秒能吞吐和解析的语义信息量有严格上限。当一位优秀的人类作者想表达一个极其复杂、高信息量的概念时,他会本能地往句子里掺「水」。
这里说的「水」,是语法上的功能词、虚词和显式从句引导词。比如英语里,当后面跟着一个比较难懂的主语时,人类会本能地保留那个可省可不省的连词 that。这个 that 本身不携带新信息,却像一个缓冲气囊,提前告诉读者「注意,后面要进一个完整从句了」。有了这半秒缓冲,水流就被摊平了,人读着也就不费劲了。
然而,纽约大学的学者检查大模型写出的句子时发现,模型把句子里几乎所有减速带全给拆了。
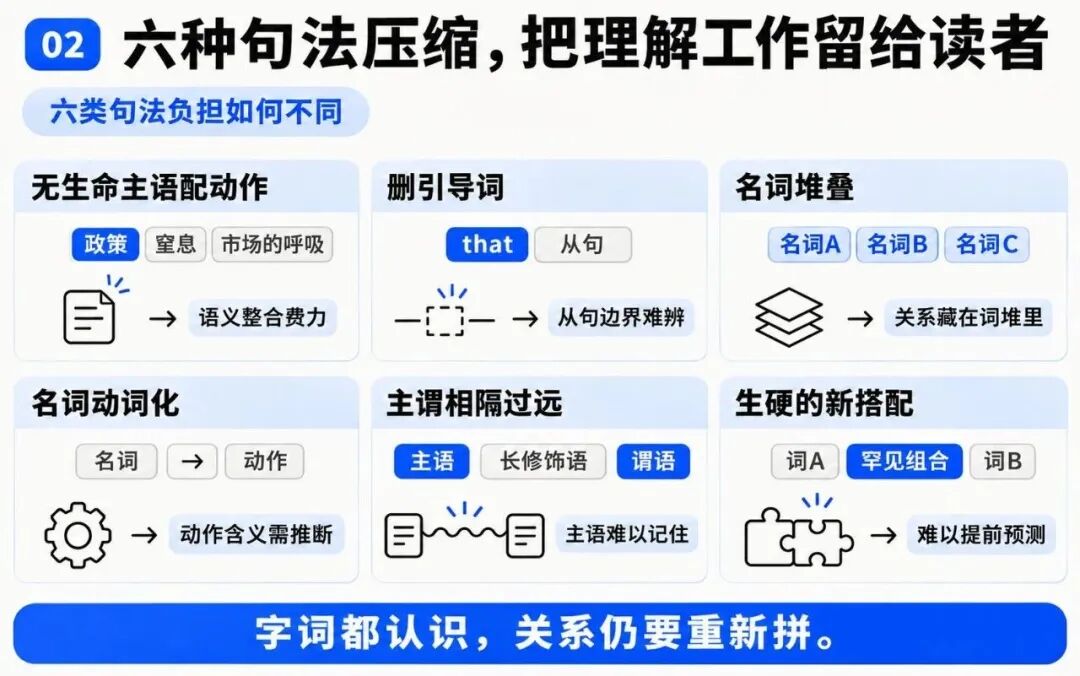
他们总结出六种 AI 常用的烧脑语法:
- 死物配动词:正常人会写「因为这项新政策出台,市场上出现了恐慌情绪」,主语顺着因果逻辑走。但大模型偏爱写「这项政策窒息了市场的呼吸」或者「沉默在房间里竖起了张力的里程碑」。心理学家早就用脑电仪测出来:当人眼扫过一个没有生命的主语,紧接着撞上只有活人才能发出的动作动词时,大脑负责语义整合的区域会瞬间亮红灯,产生剧烈违和感。偶一为之叫诗意,一段话里连着来五六个,读者的脑力第三行就耗尽了。
- 疯狂删减引导词:就是前面提到的 that 问题。
- 狂堆名词:把四五个名词像叠罗汉一样硬捆成超长复合词,把本该由动词、介词分担的逻辑关系全塞进一片密不透风的名词堆里。
- 名词不用,用动词:为了在更短字数里塞进动作,把大量本该做宾语的名词直接活用为及物动词。
- 超级长难句:主语和真正的谓语动词之间隔着十几个字的插入语或修饰成分,读者读到谓语时,主语早就从工作记忆里溢出了。
- 新词组合叠出:放弃高频、顺口的日常搭配,拼凑统计概率极低的生硬词组。
发现了病状,接下来得想想病理。
预训练语料明明来自人类,为什么模型反而学会了这种反人类的压缩饼干句法?
锅还是落在后训练上。近年来,因为 AI 输出越来越长、越来越废 token,各大厂开始不约而同地在强化学习过程中加入长度惩罚,来控制输出长度。
NYU 团队在论文中做了个实验:在开源模型 Qwen2.5-1.5B-Instruct 上做控制变量,只用 GRPO 算法配合不同的长度惩罚系数 λ 进行强化学习微调。结果发现,随着 λ 增大,模型像被无形大手挤压一样,自动开始删减可选的 that、把从句压成名词复合词、拉高单位 Token 的平均惊奇度。
这说明,为了抑制废话而在奖励函数里加入长度系数 λ 时,模型的优化目标变成了:在有限 Token 预算内,塞入最高密度的可验证信息。所以 AI 的话语自然越来越破碎、复杂。
模型为什么选择这么删,也有它们自己的道理。
另一篇 2026 年 6 月发表的研究《BabelTele: Large Language Models Do Not Always Need Readable Language》发现,对大模型自己来说,删掉所有虚词、连词和语法缓冲垫的「电报体」文本,在机器向量空间里依然具备极高的信息可恢复性。对它们来讲,删掉这些确实没漏信息,还能降低输出长度。但对人类阅读者,这确实是场灾难。
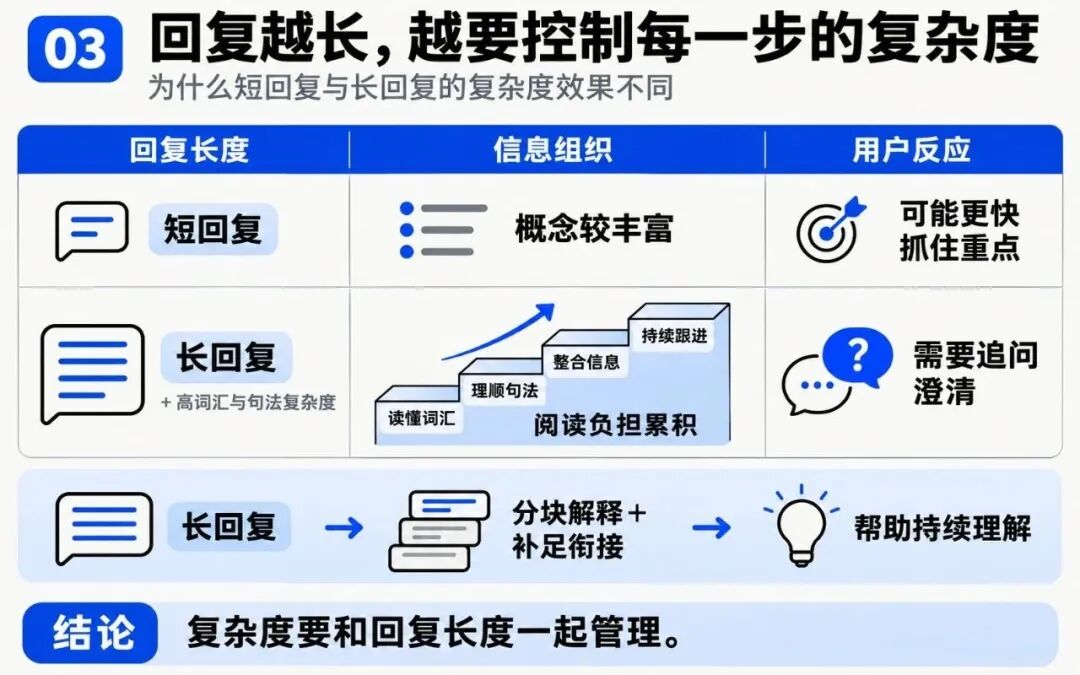
2026 年 9 月,三位来自 Stripe Partners 的研究者在论文《When AI Becomes Hard to Understand: Cognitive Demands in Real-World Human-AI Conversations》中,深入分析了医疗健康与个人理财领域超过 84,000 条真实用户与 ChatGPT 及 Gemini 的多轮对话日志。他们发现了一条支配人机交互成败的铁律,并将其命名为「对话复杂度预算」。
当 AI 的单轮回复很短时,较高的词汇多样性(Lexical Diversity,即用词丰富、概念密集)是正收益,能帮用户快速抓准概念、减少后续追问。但一旦 AI 回复变长,词汇复杂度与人类理解度之间的关系就彻底反转。在长回复中维持高词汇复杂度和高句法复杂度,会瞬间击穿用户的「对话复杂度预算」,导致用户在后续轮次里被迫反复发出澄清请求(比如要求模型「用普通人听得懂的话再解释一遍」),沟通效率大打折扣。
人类脆弱的认知语言习惯,经不起这种轰隆作响的思维块冲击。
02 宏观上,篇章的断裂并没有随模型能力提升而治愈
把视野从单句拉大到整段、整篇,大模型写作还有另一个毛病:局部顺滑,全局散架。
很多时候读 AI 写的两千字长文,单拎出每句话都通顺得挑不出毛病,可读完三大段,却完全记不住核心论点是怎么推进的。原因就是它根本不会在行文中有效推进因果逻辑。
俄亥俄州立大学、犹他大学与艾伦人工智能研究所 2026 年 6 月发表论文《Process-Oriented Evaluation of AI-Assisted Scientific Writing》。他们调取了 869 份真实科研写作过程日志、累计约 240,000 次键盘敲击与修改记录,追踪人类作者在引入大模型润色文章时到底发生了什么。
追踪结果发现,大模型在单句内部确实是个出色的语法工匠——它的改写能显著理顺单句内部的谓词—论元结构,让读者一眼看清这句话里「谁对谁做了什么」。但只要跨出句号,到了整段乃至全篇,大模型的介入非但没能提升篇章连贯性,反而经常破坏作者原本铺垫好的逻辑链条。
在语言学里,一段话好不好读,除了单句写得清不清楚(主谓清晰度 Agency、词句精简度 Economy、句内结构 Structure),更取决于两个宏观指标。一是「全局连贯性」,即上下句之间有没有靠核心概念呼应搭起锁链,每句话是不是严格遵循「以旧带新」——先在句首接住上一句刚聊熟的话题,再在句尾抛出新信息。二是「篇章框架(Framing)」,即转折、铺垫和核心结论有没有放在人类预期的位置上。
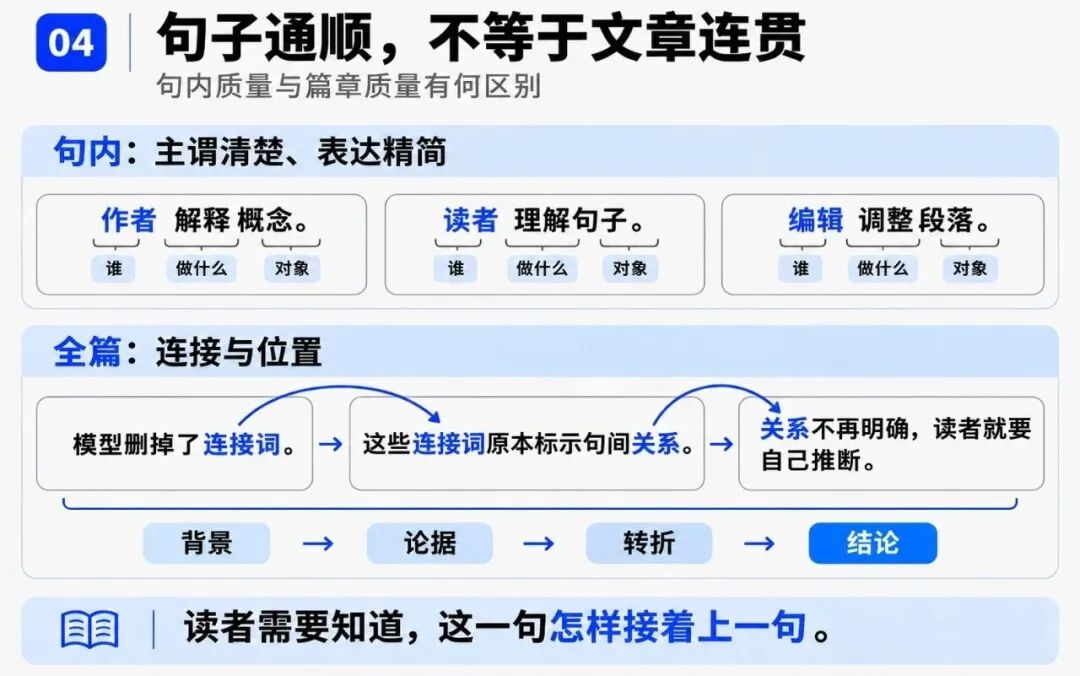
模型在这两方面都不行。当 GPT-5.4 和 Claude Opus 4.6 面对一篇「原本就写得还行」的文稿插手润色后,虽然单句被拧得更精炼了,但整段话的全局连贯性评分从 73.8 分崩到 59.9 分,篇章框架分也暴跌 12.1 个百分点。
更扎心的是,它们根本没有相关概念,你教都教不会。
当研究人员给三大前沿模型配上思维链(Chain-of-Thought),甚至把写得明明白白的五维语言学评分表直接喂进提示词时,模型在三个微观单句指标上的得分全线暴涨,唯独在宏观全局连贯性上,三大模型的提升幅度都是 0。
换句话说,哪怕手把手教顶尖旗舰模型什么叫上下文衔接,它也学不会。
那为什么模型越来越聪明,反而把篇章切得越来越碎?
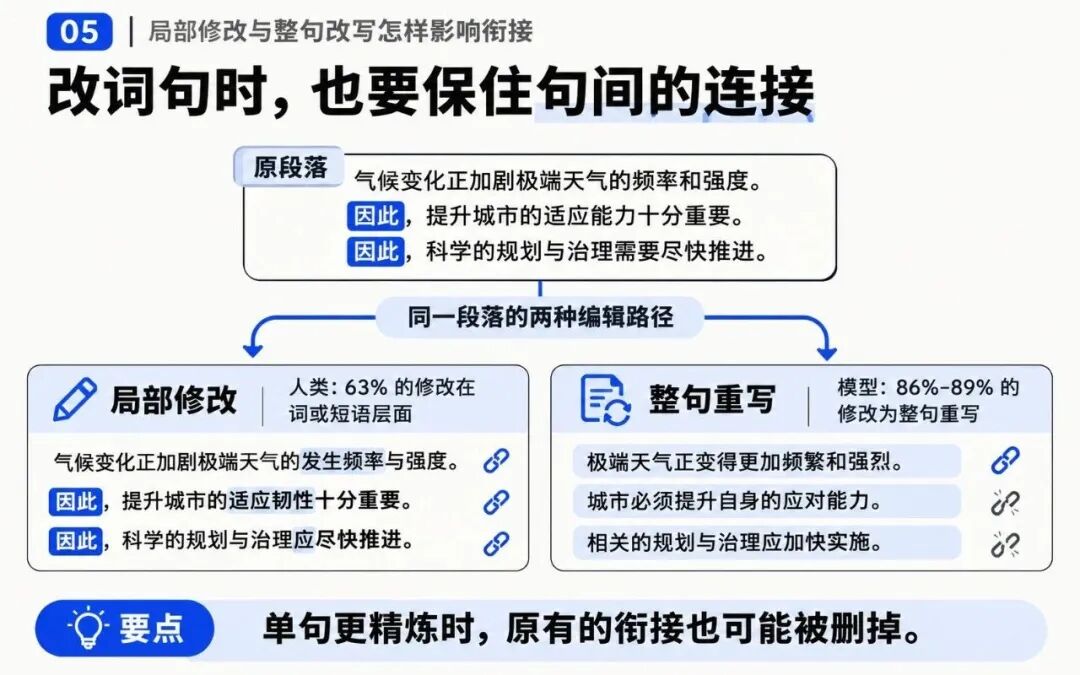
第一层原因,其实是第一篇论文的效应扩大到整个篇章的结果。模型改文章倾向删掉气口,根本不懂得穿针引线。在那 24 万次按键记录里,人类作者有 63% 的修改发生在单个词或短语级别——因为人类知道句子之间需要留出搭扣,改文章像做针线活。而三大前沿模型无论怎么调教,86% 到 89% 的修改动作都是整句推倒重来。模型把每句话都当成一道孤立考题,拼命把单句改得滴水不漏,却把上下句之间原本用来递话头的过渡词、同义呼应和旧信息钩子全铲平了。Anthropic 和 OpenAI 的模型写的东西之所以断断续续,病根就在这儿:字句之间全无粘性。
第二层原因解释的是:为什么它越强,写得越烂。因为它越强,就越难以理解人类需要的那些停顿和重复。
心理语言学家的系列研究早就发现一个著名的规模悖论:大模型参数量越大、能力越强,它对人类真实阅读停顿时间的预测反而比小模型更差。反倒是人为阉割掉一部分注意力窗口的受限模型,更贴近人类阅读习惯。
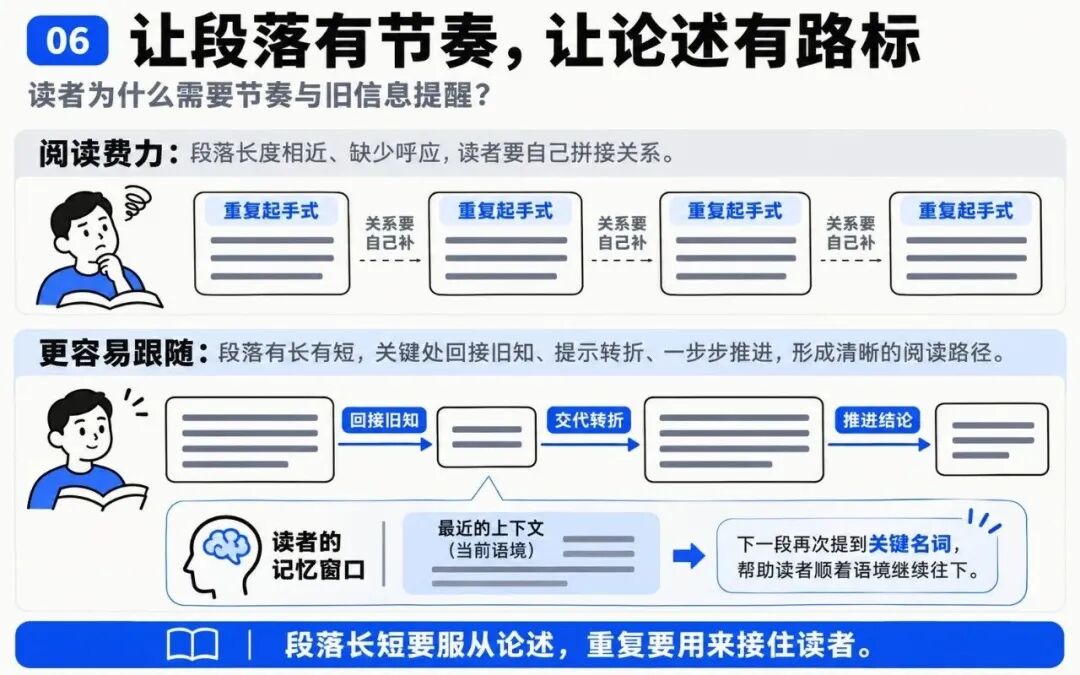
因为人类大脑是一个工作记忆只有几秒钟的「漏勺」。读到第三句话时,第一句话的字面信息已经在脑子里消散了,所以必须靠作者在句首不断铺设路标和台阶,才能继续往下走。但前沿大模型拥有几乎不随距离衰减的注意力系统——对它来说,五百字前写下的概念和当前生成的词,在注意力矩阵里是零距离直连的。一个自己永远不会忘词的超级大脑,在生成文本时根本感受不到给人类读者搭台阶的必要性。
这一点在 2026 年 9 月对 AI 写作的研究 SlopBench 里也得到了验证。研究者对 18 个模型进行评测,发现在同一模型家族内部,能力级别越高、定价越贵,宏观篇章的机械感反而越重。在 Anthropic 家族里,从轻量的 Claude Haiku 4.5 升级到 Sonnet 5、Opus 4.8,再到顶配旗舰 Claude Fable 5,长文僵化指数从 27.4 一路恶化到 32.1,段落起手式重复率从 45.9% 飙升到 65.8%。OpenAI 同样如此,从轻量的 GPT-5.4 Mini 升到旗舰 GPT-5.6 Sol,段落起手式重复率反而从 56.3% 恶化到 72.3%。
大模型还表现出严重的段落节奏扁平化。人类文章有长短段交错的呼吸感,而 AI 写出的每段字数方差极小,整齐得像一块块水泥砖。所以我们有非常多 skill 尝试教 AI 写短句、写总结,但它很多时候都拆不到点上。而且因为缺乏真正的深层逻辑连接,模型只能疯狂滥用破折号——它够短,又够显示出一种解释性的连接。
总而言之,模型确实变聪明了,但它的聪明全花在了把单句拧成高密度钢珠上。至于怎么把十颗钢珠串成一条人类能顺着摸过去的项链,它根本没学会。
况且目前单纯靠堆算力和刷推理题,这种能力不仅不会自动涌现,反而正在倒退。
微观上把句子压成又硬又难啃的五仁月饼,宏观上丢失主次骨架、缺乏连接,还以为我们能记住 500 字之前的所有细节——这就是当代大模型越升级、文字越没人味的完整病理链条。
03 Google 做对了什么?
这些研究都是相对较近才对 AI 文字能力不足的深度剖析。但早在这之前,谷歌 Gemini 的文学能力就有口皆碑。在不知道病理的情况下,他们用了什么偏方让模型写出人话?
把 Google Research 与 Google DeepMind 在 2025 年连续发表的五篇技术报告串起来看,方法其实很简单。
他们一开始就抓住了重点。2025 年,谷歌为了推进 LearnLM 这个明星项目,努力让模型在「用户可以理解的水平上,把复杂信息讲明白」,由此抓住了病根。根据病根想对策,自然能打准问题。为了做到这一点,他们做了可量化的评估器,在提示词空间做了数百次试验,用在了 LearnLM 上。最后,再把这套经验融入后训练,熔铸进 Gemini 2.5 Pro 与 Flash 的基座权重里。
用提示词探索有效微调数据集
第一步探路工程,是 Google Research 于 2025 年 5 月发表的论文《LLM-based Text Simplification and its Effect on User Comprehension and Cognitive Load》。
当时团队的目标,是开发一种极低信息损耗的文本简化能力:让普通人在阅读生物医学论文(PubMed)、法律文件或金融报告时,既能轻松读懂,又不会因为通俗化而漏掉关键的限制条件与事实细节。
项目启动时,Google 团队做的第一个关键决定,就是彻底抛弃统治西方世界近一百年的传统可读性公式——Flesch-Kincaid Grade Level(FKGL)与 SMOG Index。FKGL 这类公式只做两件机械的事:数一个句子里有多少个词(句长),以及数一个单词里有多少个音节(词长)。Google 团队实测发现,Flesch-Kincaid 分数的变化与人类真实感受到的阅读难度之间相关性很弱。一旦用这种只看词长句长的死板公式去指导大模型改写,模型就会为拿高分钻空子:直接砍掉句子间表示因果、转折、让步的逻辑连接词和必要的条件从句,把一句逻辑严密的长句生生剁成几句没头没脑的短句。这正是病理分析中展示的核心病症。当年谷歌的研究者就认识到,这些句子字面句长确实变短了,但读者反而得自己脑补句子之间的隐含逻辑,认知负荷不降反升。
为了绕开传统公式的陷阱,Google 团队搭建了一套由四个 Gemini 模型协同运转的双裁判自动评测(Autoeval)+ 提示词自迭代闭环系统。
在这个系统里,负责执行简化的生成模型是轻量快速的 Gemini 1.5 Flash,而在它对面坐着两个严苛的自动裁判模型。
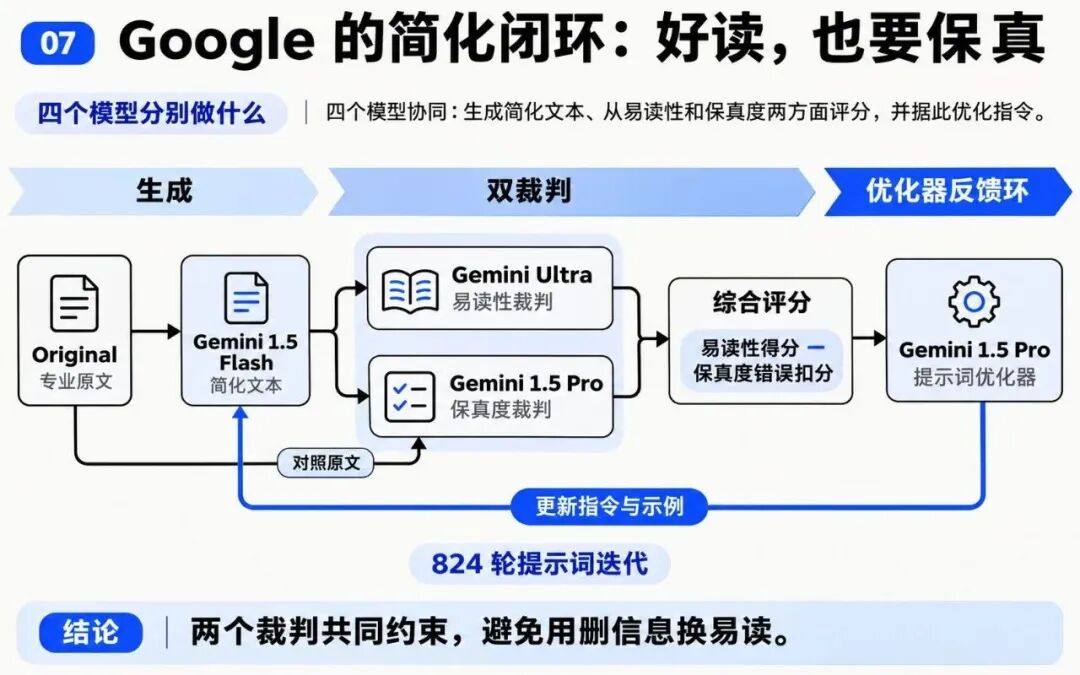
第一个裁判是主观易读性裁判(Readability Autoeval),由超大杯 Gemini Ultra 担任。它直接模拟人类读者的直觉感受,对输入文本给出 1 到 10 的整数易读性评分。为了让裁判品味与真人一致,团队先让人类评估员对 129 组原文—简化文样本对进行真实打分,再针对被判错的样本通过反馈循环不断迭代 Ultra 的评判指令,直到它能精准捕捉什么样的句子真正让人类觉得好读。
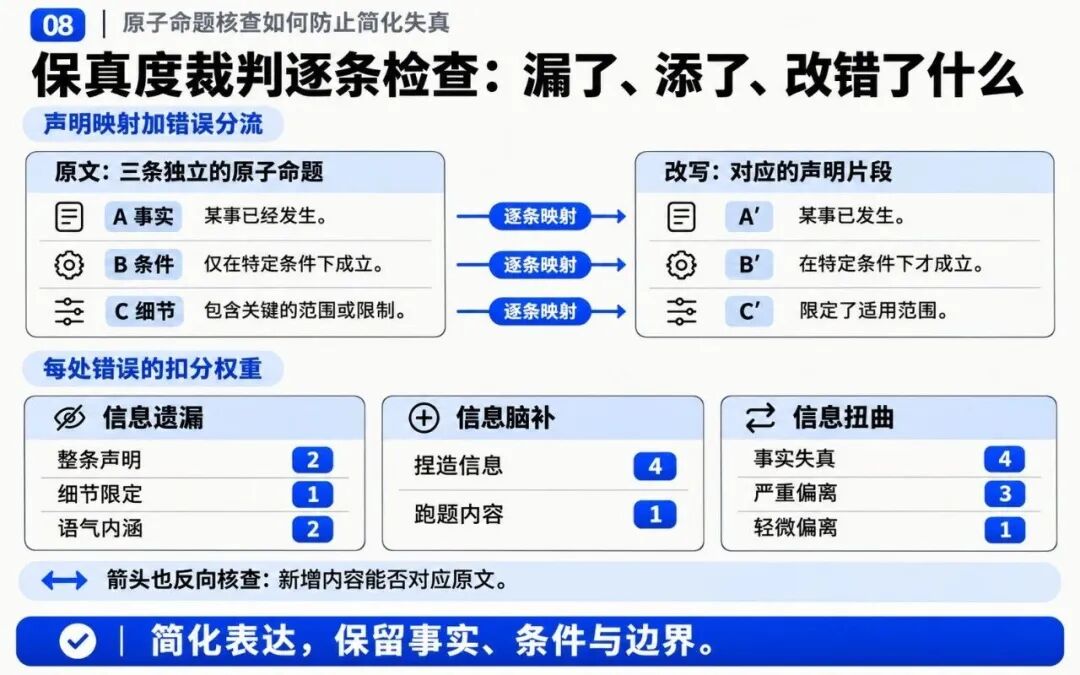
第二个裁判是原子命题级保真度裁判(Claim-level Fidelity Autoeval),由擅长长链条推理的 Gemini 1.5 Pro 担任。这是为了防止模型为了通俗而胡删乱改。它采用一套分步思维链(Step-by-step CoT)核查机制:先把原始专业文本拆解成一条条不可再分的原子事实声明(Atomic Claims),再把每条原子声明逐一映射到改写后的文本片段上,同时揪出改写文本里任何无法映射回原文的额外声明。
最后按照 3 大类、8 小项错误进行带权重的精准扣分(方括号内为每处错误的扣分权重):
- 信息遗漏(Information Loss,衡量完整性 Completeness):整条原子声明丢失 [权重 2]、具体细节或限定度丢失 [权重 1]、微妙语气或内涵丢失 [权重 2];
- 信息脑补(Information Gain,衡量蕴含性 Entailment):凭空捏造不实信息 [重罚权重 4]、加入跑题废话 [权重 1];
- 信息扭曲(Distortion,同时破坏完整性与蕴含性):事实性失真 [重罚权重 4]、严重语义偏离 [权重 3]、轻微语义偏离 [权重 1]。
二号裁判把所有查出的错误按权重相加后再除以 10,使其与一号裁判的 1–10 分易读性得分处于同一量度。每个候选改写方案的最终总分,就等于「平均易读性得分」减去「平均保真度错误扣分」。
有了这一攻一守两个裁判,团队再派出另一个 Gemini 1.5 Pro 担任提示词优化器(Prompt Refiner)。每一轮迭代,系统在 123 篇高难度样本上跑完改写和双裁判打分后,优化器就仔细分析丢分失误案例,自动修改给 Gemini 1.5 Flash 的简化指令并挑选最佳的 Few-shot 示范样本。
这个全自动的左右互搏闭环,在服务器里足足迭代了 824 轮,直到得分曲线彻底触顶收敛。
在「既要把主观易读性拉满,又绝不准丢掉任何一个原子命题」的极限挤压下,第 824 轮走出来的模型,自己摸索出了三条极其符合人类心理语言学规律的改写方法论。
第一招是「内嵌同位语随手解释法」。比如在生物医学文献里,原文讨论「肺纤维化合并肺气肿(CPFE)」综合征,一句话塞满缩略语、上下肺叶解剖定位和并发肺动脉高压的风险。如果删掉专业术语,二号裁判会判「具体度丢失」;如果原封不动照抄,一号裁判会判「易读性不及格」。经过 824 轮进化后的模型完整保留了 emphysema(肺气肿)和 fibrosis(肺纤维化)等全部核心概念与解剖位置,但在专业词刚出现的紧邻位置,顺手用半句大白话垫上内嵌定义(说明一个是肺泡受损导致呼吸困难,一个是肺组织变厚结疤),同时把挤在一个复合长句里的「病症特征」和「并发症结果」拆成两句顺着因果链条推进的短句。
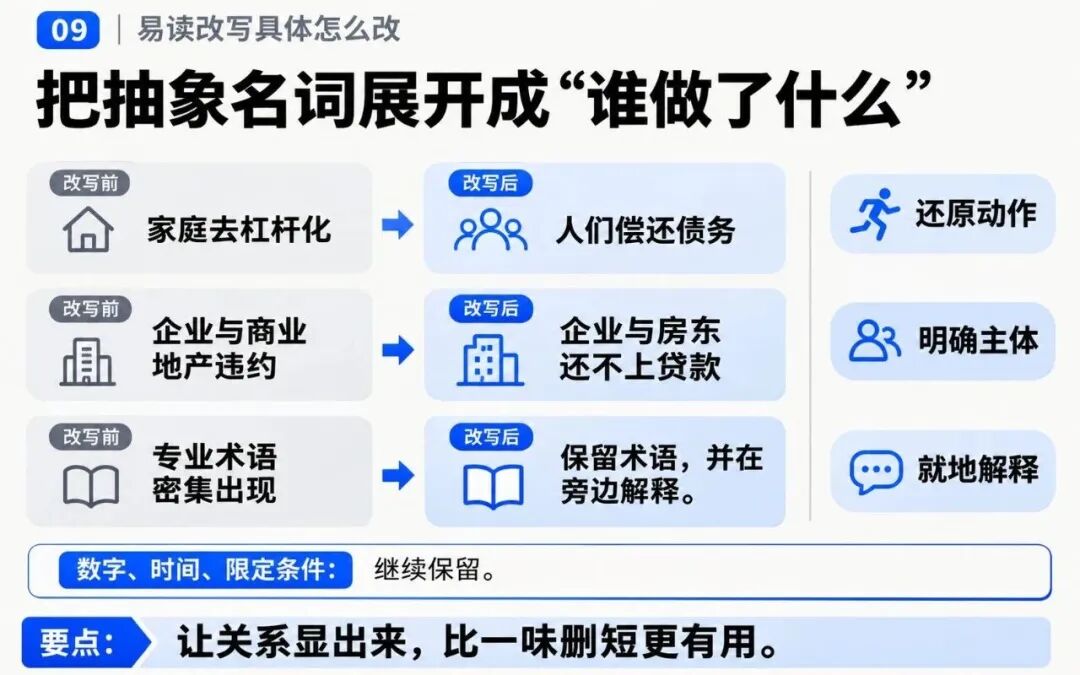
第二招是把高密度抽象名词重新解压回「具体主语 + 动作动词」的微句。第三招是理顺倒装句。
比如在改写 IMF 的报告时,它先把倒装结构顺直为「谁说了什么」。其次,把高密度抽象名词转成句子——「家庭去杠杆化」被还原成更口语化的动宾结构「人们偿还债务」;「企业与商业地产违约」同理被还原成「企业与房东还不上贷款」。这恰恰是第一部分纽约大学论文所指出问题的逆向操作:把被压缩进名词堆里的动作关系重新释放出来,恢复均匀的信息密度。最后,在句尾关于失业率 10.1%、5% 和 2014 年的时间节点上,它没有做任何模糊化删减,原子命题保真度拿了满分。
为了验证这套改写对人类大脑的真实效果,Google 团队组织了一场规模比以往同类研究大出一个数量级的随机对照双盲实验(RCT)。他们招募了 4,563 名排除相关专业背景的成年受试者,横跨生物医学、生物学、法律、金融、文学哲学、航空与计算机科学 6 大领域,在「开卷(Open-book,可对照原文答题)」与「闭卷(Closed-book,读完后收走文本凭记忆答题)」等 6 个实验组中,累计收集了 49,582 份客观阅读理解选择题(MCQ)答案与简化版 NASA-TLX 认知负荷评分。
实验数据表明,阅读简化版文本的受试者,客观题平均准确率显著提升 3.9 个百分点(在最难的生物医学文献上暴涨 14.6 个百分点,单题最高提升达 38 个百分点)。更关键的是,在闭卷测试条件下,尽管所有人整体准确率因为无法回看原文而下降约 9%,但阅读简化版文本带来的约 4% 绝对理解优势依然完好无损。这说明受试者确实 get 到了又准又易读的信息。
用后训练把能力内化
Simplify 那篇论文发表时,824 轮跑出来的成果还只是挂载在 Gemini 1.5 Flash 外面的提示词与 Few-shot 工程。但紧接着,同一批核心负责人主导的 LearnLM 团队走出了更关键的第二步:把这套「降低认知负荷 + 严保命题覆盖率」的能力,通过后训练彻底内化进 Gemini 2.5 Pro 与 Flash 的基座模型权重里。
在 2025 年 9 月发表的《Towards an AI-Augmented Textbook》中,Google 团队解释如何把复杂教材改写到不同阅读水平时明确写道:这种在保持事实性与内容覆盖率的前提下适配目标阅读等级的能力被称为 Re-leveling,它「已经是 Gemini 2.5 Pro 核心教育能力的一部分,直接调用基座模型即可完成,无需任何额外微调」。
具体怎么做的?
2024 年 12 月的论文《LearnLM: Improving Gemini for Learning》里,LearnLM 先在后训练数据里掺入了「见人说人话,见鬼说鬼话」的配方。给十岁孩子讲科学、给程序员讲算法、给老外用外语讲历史,所需要的「人话标准」完全不同,甚至互相打架。一旦把模型焊死在谆谆教导的老师人设上,平时用户只想让它干脆利落写段代码,它也会啰里啰嗦拉着你互动。
团队干脆抛弃固定人设,改走「教学级系统指令遵循(Pedagogical Instruction Following)」路线。准备训练数据时严禁使用笼统模糊的指令(因为实验发现,笼统指令会让模型在训练中学会装聋作哑),每一场训练对话开头,都必须配一条专门为这场对话量身定制、颗粒度极细的系统指令。当你让它干活写代码时,它干脆利落;一旦语境切换到需要解释复杂问题,对应的认知减负开关就会被瞬间推起。
之后就是重写强化学习的奖励规则。
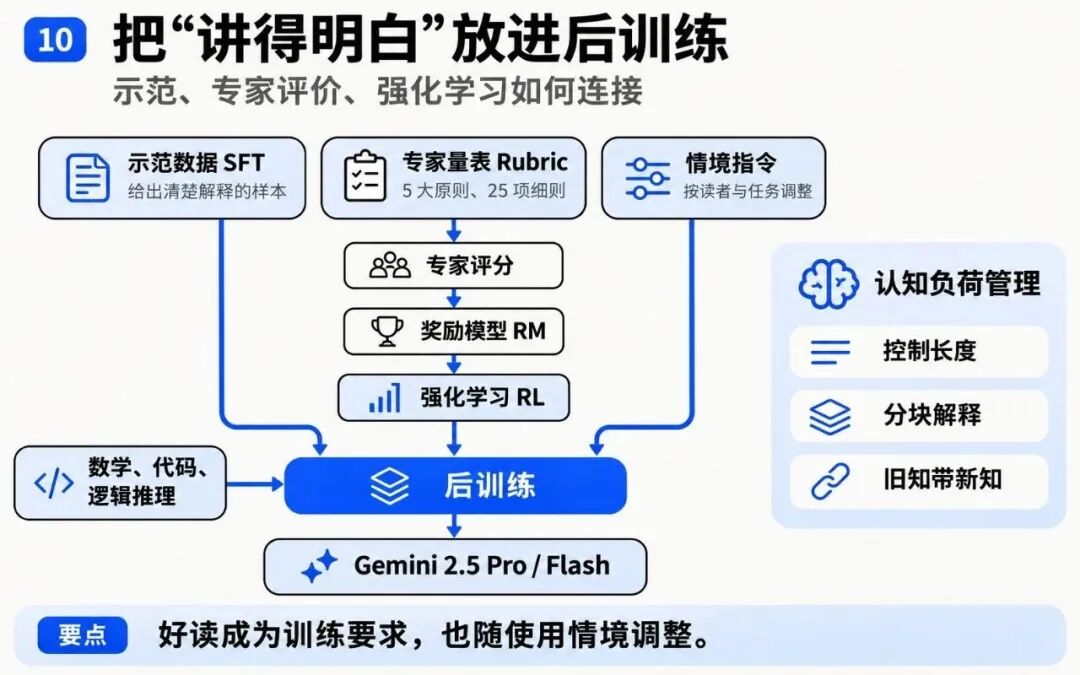
在 2025 年 5 月发布的论文《Evaluating Gemini in an Arena for Learning》中,LearnLM 团队发现,想改掉模型不说人话的毛病,光靠喂示范数据(SFT)效果还不够,真正起决定性作用的是强化学习(RLHF)阶段。
传统强化学习的奖励模型(Reward Model)一般谁写得长、谁堆专业词多,谁就拿高分。为了把这个偏心眼裁判彻底换掉,Google DeepMind 联合教育科学家制定了一套包含 5 大原则、25 项细则的严苛量表(Rubric),请来几百名有硕士以上学位和多年教学经验的专家,对多轮长对话逐轮打分,训练全新奖励模型。
论文详细记录了这套 Rubric。其中一个原则就是管理认知负荷(Manages Cognitive Load),下面埋了 9 条小规则。除了强制要求「控制单次回复长度」「把大段信息拆成容易下咽的小块(Manageable chunks)」「主动用故事和日常类比解释抽象概念」之外,还专门立下一条针对宏观篇章断裂的死规矩:信息顺序必须建立在前面刚讲明白的旧概念之上,层层递进。
当别的模型在强化学习里因为「把单句压得越密、整篇写得越满」拿高分时,Gemini 必须做到先接住读者的旧知,再拆成小块递出新知,绝不一股脑堆概念,才能拿到高分。
之后,他们把这套数据直接安排进 Gemini 2.5 的后训练主干。第一篇论文里认知减负的示范数据(SFT)、新的 25 维奖励模型(RM)和对应强化学习任务(RL),都被直接按比例倒进 Gemini 2.5 Pro 与 Flash 的主干后训练池子里,跟数学、代码、逻辑推理放在一口锅里同步混训(Co-training)。结果这不仅没拉低模型的硬核推理分,反而因为逼着模型学会把复杂思考拆成清晰、无跳跃的步骤,顺带把主模型的理工科内功也往上推了一截。
为了检验这套内功的成色,团队还攒了个大局:请来 189 名教育界行家扮演不同水平的学生,在完全盲测的情况下,分别与 Gemini 2.5 Pro、OpenAI o3、Claude 3.7 Sonnet、ChatGPT-4o 展开十轮以上深度对话,随后由 206 名独立专家对着完整聊天记录打分。
附录公开的数千条专家盲评原话里,针对 OpenAI o3、GPT-4o 和 Claude 3.7 Sonnet 出现频率最高的差评词,就是刺眼的 Info-Dumping(信息倾倒)和 Massive walls of text(令人窒息的文字墙)。
一位在盲测中扮演中学生的成年专家,先后体验 OpenAI 旗舰推理模型 o3 和 Gemini 2.5 Pro 后直言:「直到遇到了第二个模型(Gemini 2.5 Pro),我才意识到第一个模型(OpenAI o3)有多吓人。第一个模型上来就试图把十几岁孩子当专家来轰炸,满屏令人窒息的复杂推导,连我读起来都痛苦万分、一头雾水。而第二个模型把所有硬核概念都拆成适合少年的颗粒度,像搭小台阶一样一步步带着我走,体贴得让人惊叹。」
最终,Gemini 2.5 Pro 在专家眼里拿下高达 73.2% 的总体胜率:对 Claude 3.7 Sonnet 胜率 71.3%,对 OpenAI o3 更是高达 74.2%。而在专门考核「把维基百科和 MIT 科技新闻改写给不同年级读者、且不漏掉原意」的 240 项硬核盲测(Text Re-levelling)中,Gemini 2.5 Pro 在保住 94% 原文命题覆盖率的同时,阅读难度控制误差只有 0.99 个年级,成为全场唯一误差小于 1 个年级的模型(同期 OpenAI o3 误差高达 2.44 个年级,Claude 3.7 误差 2.11 个年级)。
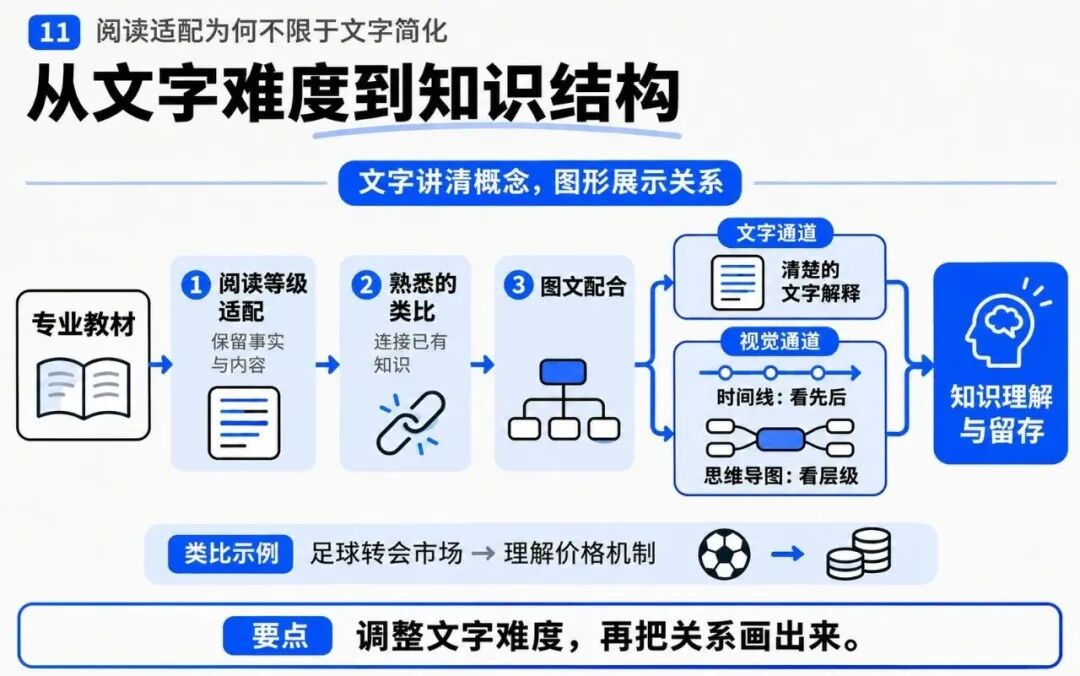
2025 年 10 月,LearnLM 论文《Towards an AI-Augmented Textbook》中,Google 更进一步将这套基座能力与认知心理学「双重编码理论(Dual Coding Theory, Paivio 1991)」结合。当纯文字简化触及人类单通道工作记忆极限时,系统会先调用 Gemini 2.5 Pro 的内置 Re-leveling 能力降低阅读年级,再将抽象概念局部替换为读者熟悉的个人兴趣领域。比如用足球转会市场解释经济学价格机制,激活读者已有先验知识网络,降低新概念编码成本。最后自动将长文中的线性序列与层级结构抽离为交互式时间线、记忆口诀与可缩放思维导图,在针对芝加哥高中生的随机对照实验中显著提升了 3 天后的远期知识留存率。
可以说,2025 年的谷歌 Gemini,在让 AI 产出人能读懂的句子这件事上,早就遥遥领先于其他前沿模型了。
04 2026,让 AI 从底层学会说人话
LearnLM 已经在 2025 年内跑完一套完整的「说人话」后训练循环,并抓住了最核心的矛盾。甚至他们自己可能都觉得问题已经解决得差不多,于是 2026 年的研究更多投入到「AI 辅导在真实课堂里究竟能让学生学会多少」这个落地课题上。
但即使 Gemini 4 Argon,叙事也远未达到完美。比如这篇文章就是 Gemini 4 Argon 与我共创,但即使提供了详细大纲,我依然不得不调整段落叙事顺序、重构逻辑、丰富语言表达,删除啰嗦语句。当然,如果让我用 GPT-6 Astra 写,这个过程可能需要拉长两倍以上。所以它确实写得相当好了。
所以我求求你们 OpenAI,学一下吧。
当然这也意味着,「写人话」这件事依然有提升空间。
在 2026 年的推进路上,第一个目标是无 Rubric 后训练。因为 Rubric 本身肯定无法做到完全完美,而且有的公司也凑不出这么多专家来写它(或者不愿意出钱)。所以我们能不能从更深层的信息表达逻辑层面,把「说人话」训练成一种结构性原理?
近期,研究者们开始尝试直接把第一、二部分提到的两大病理诊断理论——心理语言学的「均匀信息密度(UID)」与篇章语言学的「修辞结构理论(RST)」——转化为无需人工标注的算法约束,分别从微观句子和宏观篇章两头锁死「反人类文风」。
微观解药:给句子的信息装上减震器
第一项研究来自南方科技大学李永源与徐杨团队于 2026 年 10 月发表的《Uniform Information Density-Based Preference Optimization》。这篇工作直接针对前文纽约大学论文诊断出的「局部信息密度剧烈抖动与句法过度压缩」下刀。
为什么现有的偏好优化算法(比如 DPO 及其变种 SimPO)训出来的模型容易写出「句法压缩饼干」?
看一下 SimPO 的核心原理就明白了。SimPO 在判断一条回复好不好时,计算的是整条回复里所有 Token 对数概率的算术平均值,并以此作为隐式奖励(Implicit Reward)。只考核「整句话的平均概率」在心理语言学上有个致命漏洞:它完全看不见句子内部的局部剧烈波动。这就像考核司机车技只看全程平均车速是不是 60 公里/小时,至于司机是否前一秒猛踩油门飙到 120、后一秒又急刹车降到 0,平均分根本反映不出来。
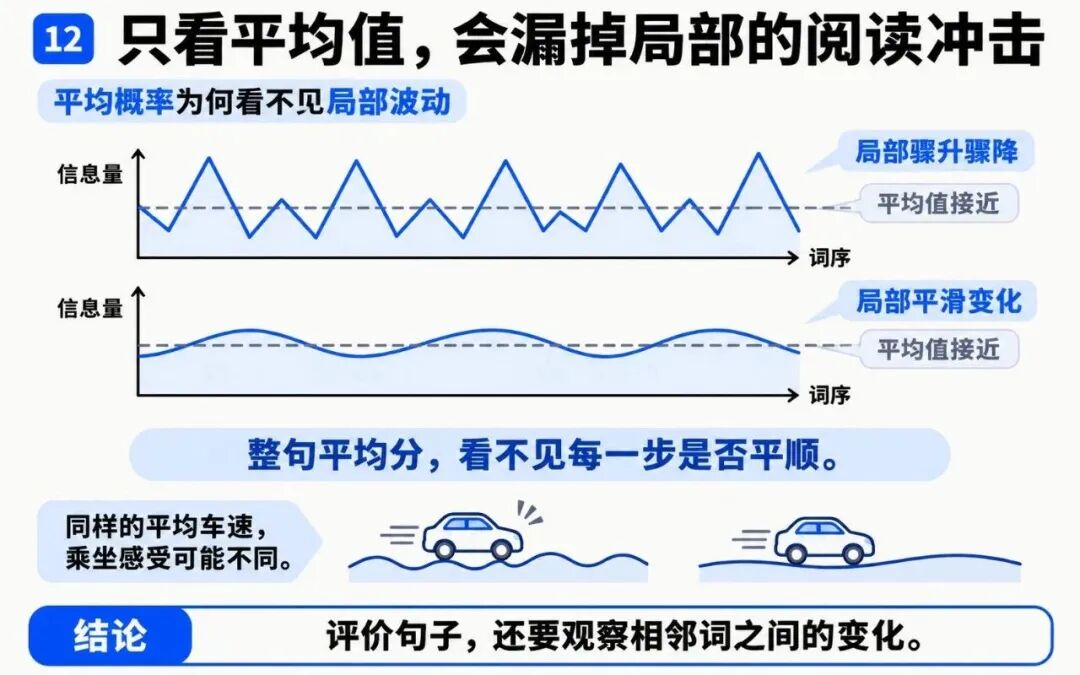
结果模型在强化学习压力下,为了在局部塞进高密度信息,频繁制造局部的「惊奇度尖峰(Surprisal Spikes)」,把读者晃得头晕眼花。
可如果为了求稳,直接惩罚整篇回答里所有 Token 概率的总体方差(也就是逼着模型从第一个字到第一千个字,每个词的信息量都像尺子量出来一样绝对平均),模型就会退化成一潭死水的「车轱辘话」。
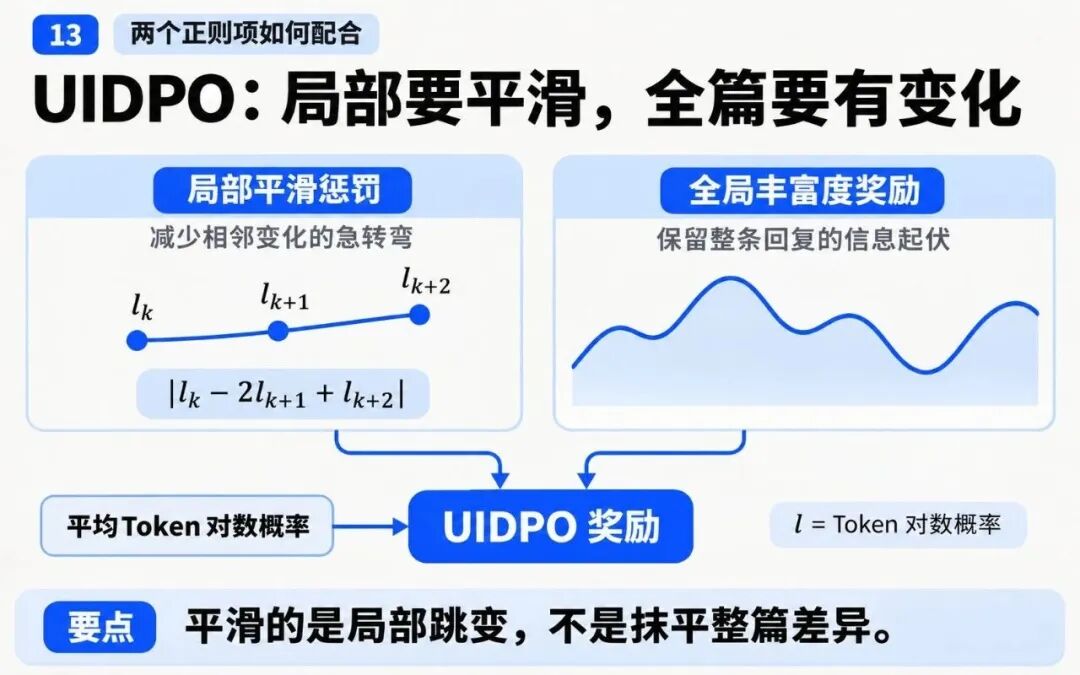
南科大团队在 UIDPO 中设计了一个双向约束机制:局部严禁急刹急停(惩罚局部二阶差分),全局鼓励跌宕起伏(奖励全局标准差)。
具体来说,他们在 SimPO 原本的「平均 Token 对数概率」隐式奖励基础上,直接用模型自身的概率分布加了两个正则项。
第一项叫「局部信息平滑惩罚项」。它不再孤立地看单个词,而是以滑动窗口检查句子中任意相邻的三个连续 Token,计算它们对数概率的二阶差分(即第 k 个词与第 k+2 个词的对数概率之和,减去中间第 k+1 个词对数概率的两倍)。二阶差分的值,就是这三个词的信息量变化率。惩罚二阶差分绝对值过高,就相当于给句子的信息流装上一套液压减震器:它完全允许文章信息密度像上山或下山的缓坡一样分段平滑升降,但严厉禁止相邻两三个词之间出现锯齿状的剧烈折线跳变。一旦模型想在某个位置删掉缓冲虚词、突然甩出一个极难预测的高密度复合词组,导致局部二阶差分瞬间飙升,就会立刻遭到损失函数的重罚。
第二项叫「全局信息丰富度奖励项」,直接计算整条回复所有 Token 对数概率的全局标准差,并将其作为正向奖励加进目标函数里。这保证了整篇文章在宏观尺度上依然拥有充沛的信息张力与话题转换空间,绝不会因为局部平滑而变得单调乏味。
训练完成后,当作者把模型拉去跑心理语言学经典的 Switchboard 英语宾语从句测试集(复现 Jaeger 2010 的可选引导词 that 省略实验)时,发现标准 SimPO 模型严重偏离了自然的句法缓冲分布,而 UIDPO 模型为了压平局部二阶差分的剧烈跳变,竟然无师自通地恢复了人类的心理语言学本能:当从句开头信息密度较高时,主动保留那个可选的连词 that 来为读者缓冲惊奇度。
在硬核的通用指令跟随基准 AlpacaEval 2(基于 Llama-3-8B-Instruct 训练,以 Llama-3.3-70B 为裁判)以及 Arena-Hard、MT-Bench 上,UIDPO 的长度控制胜率(LC Win Rate)达到 63.2%,全面超越 SimPO(60.8%)与 DPO(55.6%),而且生成的平均回复长度比 SimPO 更短。
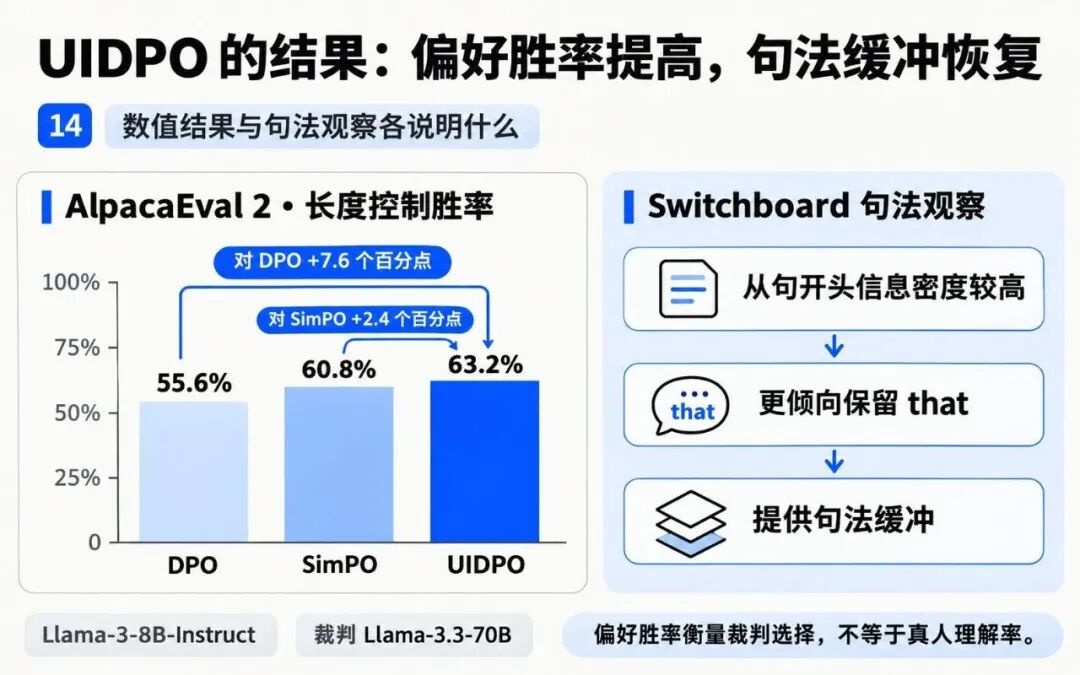
它用极其干净的实验证明:只要让局部信息流符合人类大脑的均匀密度偏好,模型根本不需要靠注水拉长篇幅,就能在盲测中赢得压倒性胜利。
宏观解药:用「修辞结构树」给长文搭起钢筋骨架
其实仔细观察 LearnLM 的 Rubric,它虽然处理了句子之间连接不畅的问题,却没有真正着力让 AI 学会搭建更大的论述骨架。
明尼苏达大学与亚马逊科学团队(Amazon Science)在被人工智能顶会 AAAI 2026 录用的论文《Align to Structure: Aligning Large Language Models with Structural Information》中,给出了宏观层面的算法闭环,即 Structural Alignment(结构对齐)。
为什么传统的 PPO 强化学习训不出结构严密的千字长文?
作者指出两个卡脖子难题:第一,通用奖励模型只看表面好恶,根本没有「篇章结构」的概念;第二,在生成超过 1000 个 Token 的长文时,传统 PPO 只在全文结束的最后一个 Token 上给一个笼统的标量分数(稀疏奖励 Sparse Reward)。这就像一个学生写了篇两千字议论文,老师只在卷尾打了个「75 分」,模型根本搞不清楚自己到底是第三段的转折写得好,还是第五段的论据掉了链子。
为了同时攻克这两个难题,团队将计算语言学经典的修辞结构理论(Rhetorical Structure Theory, RST,Mann & Thompson 1987)直接嫁接进 PPO 强化学习的奖励机制中。
在 RST 中,一篇有逻辑的文章绝不是句子的线性排队,而是一棵层层嵌套的层级篇章树。树的最小叶子节点叫基本篇章单元(EDU,Elementary Discourse Units),每个 EDU 是一个独立的语义小句(在分词器里平均包含约 20 个 subword tokens)。相邻 EDU 通过明确的修辞关系边(如 Elaboration 阐述、Contrast 对比、Cause-Effect 因果、Background 背景等)向上合并成更大的树节点,直至覆盖全文。最核心的是,树上每个连接都严格区分主次角色:谁是立论的「主核(Nucleus,核心观点)」,谁是围绕主核转的「卫星(Satellite,辅助论据或让步背景)」。
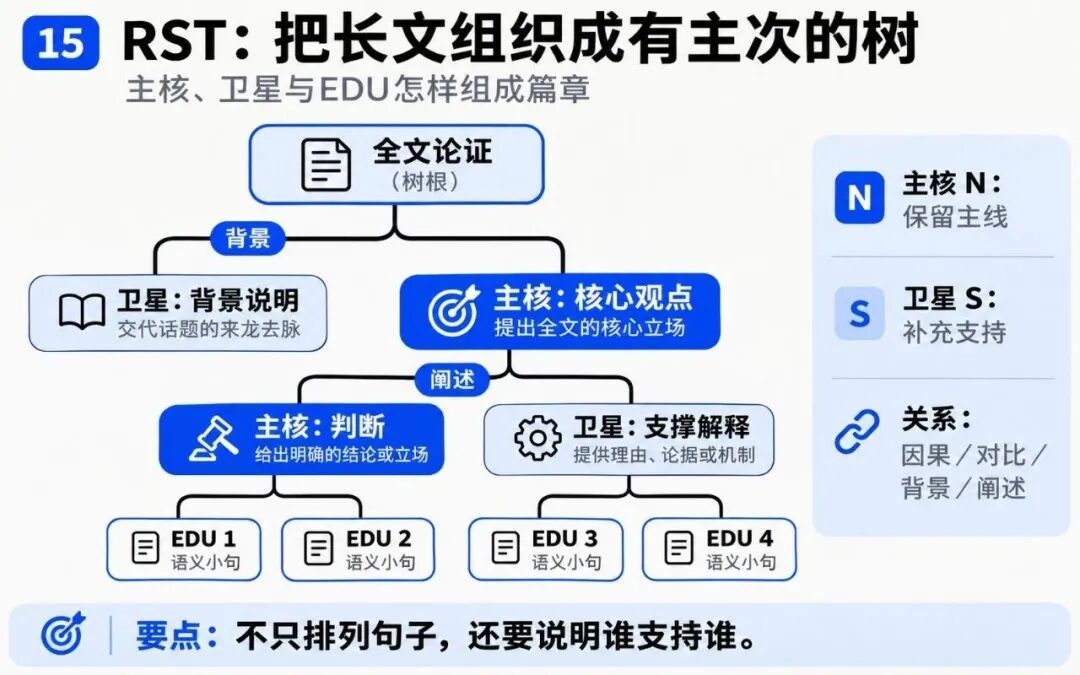
作者团队此前研究发现一个机器文本检测规律:如果用 DMRST 解析器把长文解析成 RST 修辞树,再将其转化为递归超图(Recursive Hypergraphs)提取里面反复出现的局部修辞拓扑子图——即「篇章结构模体(Discourse Motifs)」——就会发现无论大模型表面用词怎么改写伪装,AI 生成的修辞树拓扑往往是扁平、顺拐、缺乏层次纵深的。而人类作者的文章,「主核—卫星」组合模体呈现高度丰富且独特的层级结构。
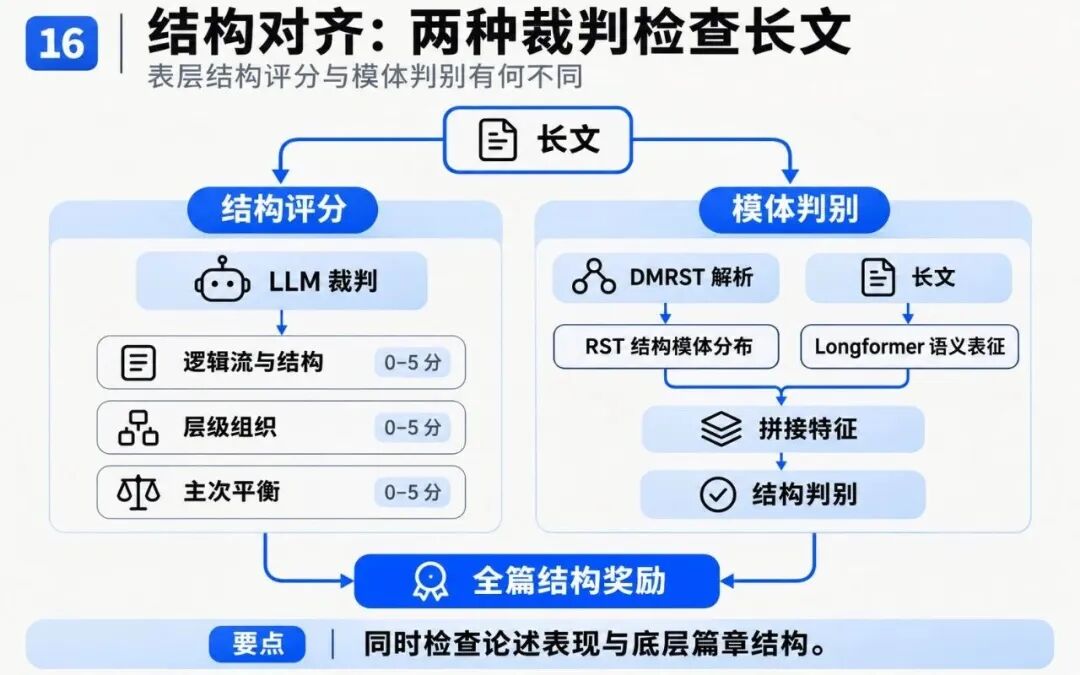
于是,在 Align to Structure 中,团队为 PPO 训练设计了双轨结构奖励与一项极其精妙的 Token 级稠密奖励塑形(Dense Reward Shaping)机制。
一方面,在全篇层面,他们提供两套互补裁判。一套是用大模型按语用学三要素(逻辑流与结构 Logical Flow、层级组织 Hierarchical Organization、核心观点与次要细节的平衡强调 Balance and Emphasis)打 0–5 分的表层结构裁判。另一套则是将长文按段落切块后用 DMRST 解析出全局篇章模体分布向量(Motif Distributions),拼接到 Longformer 的语义表征上,直接判别这篇长文的底层修辞树到底像不像人类高手。
另一方面,为了解决长文训练「不知道哪句话写得好」的信用分配难题,作者仿照信息检索里的 TF-IDF,发明了一个衡量修辞结构含金量的指标——MF-IDF(Motif Frequency–Inverse Document Frequency,模体频率—逆文档频率)。
他们在大型语料库上预先统计出哪些 RST 修辞树子结构(模体)是人类高水平写作中极具代表性、而大模型平时极少写出来的。在 PPO 强化学习生成长文的过程中,系统不再傻等全文结束,而是直接定位到基本篇章单元(EDU)级别。每当模型生成的某一个 EDU(约 20 个 Token)在篇章树里恰好参与构成了这种「极具人类修辞特色的漂亮模体」,系统当场就向属于该 EDU 的每一个 Token 对应的奖励张量位置,直接注入一笔稠密奖励。
这就相当于在模型写长文时,导师不等它写完收笔,当场就把奖励精准打到构成好转折的那 20 个 Token 上。
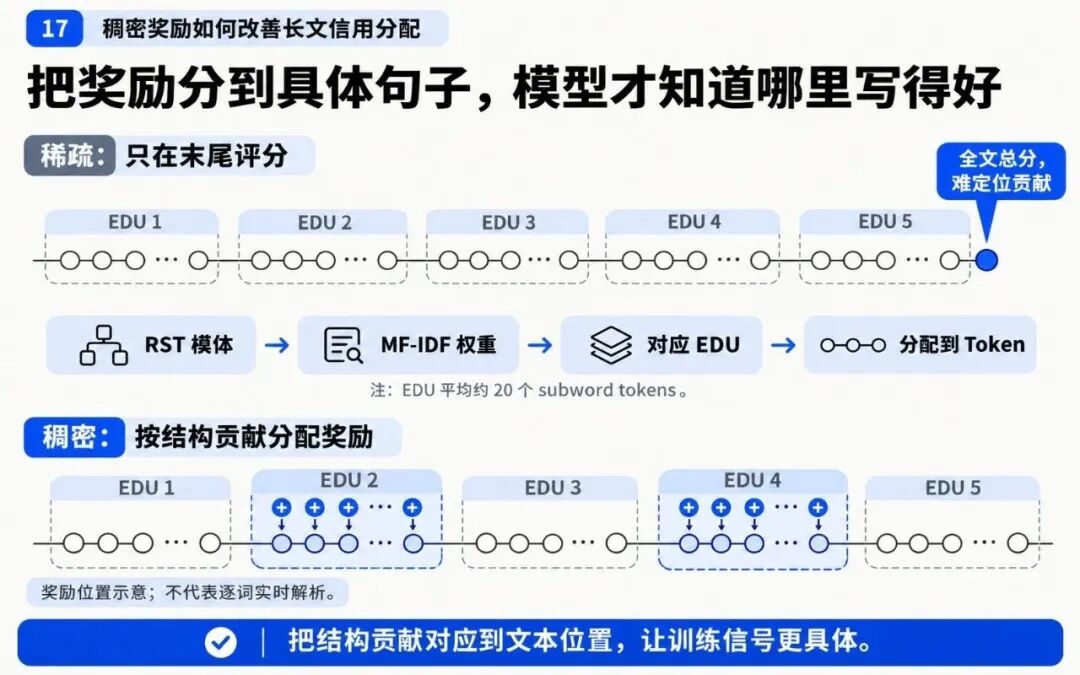
实验结果证明了这套结构对齐的威力。哪怕只拿轻量级的 Qwen2-1.5B-Instruct 作为策略模型进行训练,在超过 1000 个 Token 的长篇议论文写作以及长文档摘要任务上,经过结构对齐的模型不仅在人类与裁判评估的逻辑连贯性、论证层次感上都全面击败标准 RLHF 基线,而且生成文本的底层 RST 修辞树模体分布真正向人类写作者收敛,有效缓解了大模型「单句优等生、全篇流水账」的顽疾。
05 AI 越聪明,越需要和我们做「认知对齐」
回望这一切,AI 写作所谓的「人味」,从来不是在开头加一句热情寒暄,也不是华丽辞藻和押韵诗行。真正的「人味」,是对人类大脑生理局限的深刻体察。
人类的眼睛每秒只能扫视几个词块;人类的工作记忆每次只能同时周转三四个新概念;人类读长句时需要靠那些看似不起眼的虚词、连词和同位语换气;人类读长文时需要靠清晰的「主核与卫星」落差来锚定方向。
如果说大模型对齐(Alignment)的上半场,是让模型学会「算得对(RLVR)」和「守规矩(传统 RLHF)」,那么以 Gemini 2.5 的认知负荷后训练以及 2026 年的 UIDPO、结构对齐为代表的技术转向,则标志着大模型正式迈入「认知对齐」的下半场。
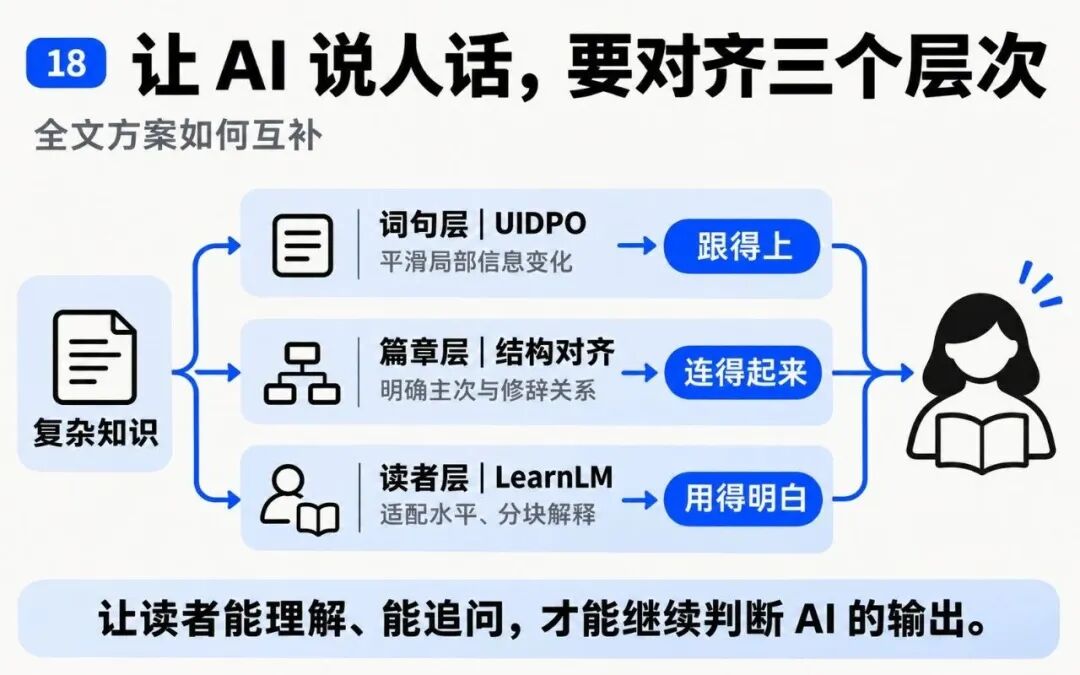
在 AI 越来越聪明、越来越强的当下,为了让人类还能对它的工作起到那么一点点监督职能,我们必须找到让它收敛锋芒、迁就人类脆弱认知带宽的方法。这样,它研究出来的复杂深邃知识,才可能化作人类思维河道里一泓平缓的活水。
如果你也在关注大模型如何把话说利索,或者被某些 AI 输出折磨过,欢迎到云栈社区和更多开发者一起聊聊。
 发表于 昨天 18:40
|
查看: 6|
回复: 0
 /1


