用 LLM 这么久,估计很多朋友都遇到过同样的问题:你刚让模型做完一件事,换个会话它就彻底忘了;你的偏好、项目背景、之前踩过的坑,又得从头讲一遍。今年年初我意识到了这个问题的严重性,所以给自己定了一个核心目标——搞定模型的记忆能力。
后来,大家开始把上下文窗口慢慢加到 1M,把更多历史硬塞进去;再往后,RAG 和各种外部记忆系统开始普及,把历史记忆留存下来,用的时候检索相关文本放进上下文。虽然这些方案能解决不少问题,但 Agent 的演进把大模型的记忆问题推到了最前沿:我们希望模型能够记住的,不仅是过去说过什么,更是过去做过哪些事情。
现在 Agent 领域已经不缺各种外挂式的记忆方案了,但最近发布的开源模型 MemT 1.0,最有意思的地方在于它开始把记忆的读写直接放进了模型的计算过程中。
这便引出了一个贯穿始终的核心问题:当记忆不再只是外挂的一段检索文本,而是直接参与模型自身计算时,会给 Agent 带来什么变化?
认识 MemT
MemT 是一个记忆原生大模型(Memory-Native Foundation Model),它刚刚发布了 1.0 版本。虽然上线才 8 天,总下载量就已经到了 100K,相当火爆。于是我把 MemT 仔细研究了一遍,来跟大家聊聊。
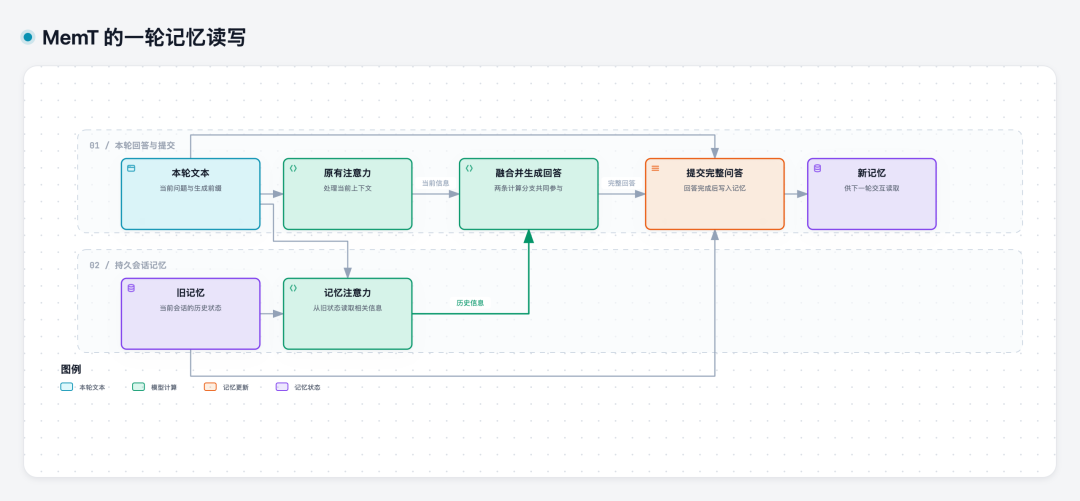
它采用 MoE 架构,将记忆的写入、保持、更新和读取深度纳入了模型的前向计算过程中。也就是说,模型会在实践交互中保留关键经验,转化为内部数值状态写进会话记忆中,并在后续步骤中直接参与计算与调用。
MemT-1.0 背后,是做 MemOS 的记忆张量团队。他们之前做的 MemOS,是面向大模型和 Agent 的记忆系统,涉及记忆的存储、更新、检索,以及跨任务的经验复用。
今年 7 月,他们还发表了 Metis,这是全球首个记忆原生模型,在底座里加入持久、可以动态更新的记忆状态,让模型通过自身计算来存储和利用历史。
这次的 MemT-1.0,就是在 Metis 的路线上进一步推进。
在拆解具体的模型架构之前,我们不妨先来看一个最直观的编程实验,看看把相关经验写入原生记忆后,Agent 的行动模式到底发生了怎样的改变。
MemT-1.0 提出了一种 Agent 框架,专门用于在长程编程任务中复用程序性经验(Procedural Experience):
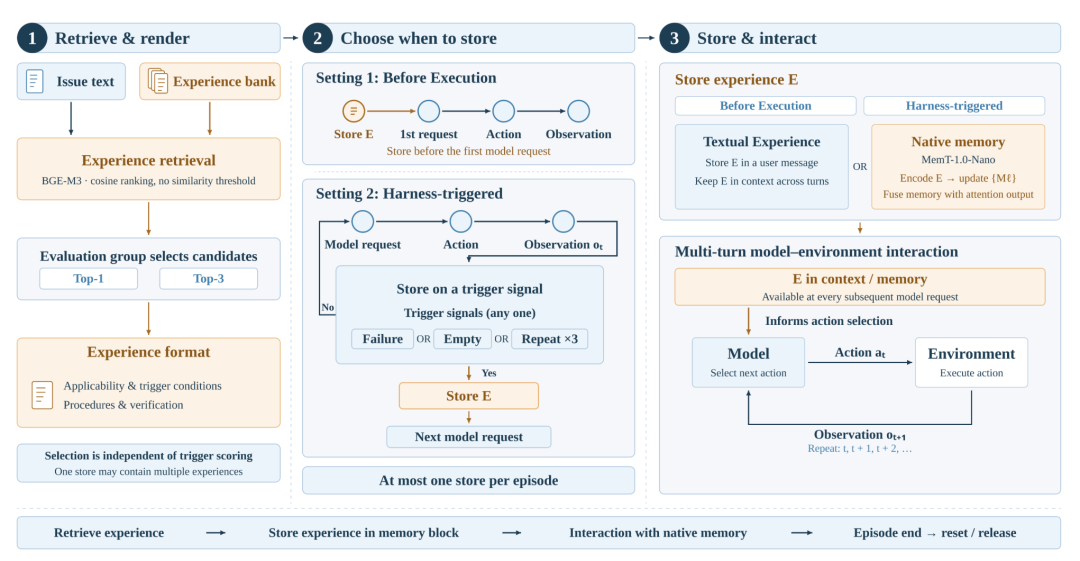
以软件工程评测中极具代表性的开源大项目 Django 为例:
-
没有经验引导时:Agent 往往像一个毫无章法的新手,在代码库里检索定位到目标函数后,就急于直接上手修改实现逻辑。这种改法不仅排查路径长,而且极易引入 bug,往往等到多轮报错后才仓促补写验证,试错成本非常高。
-
当把相关经验写入记忆后:Agent 的执行步骤发生了质的改变。它像一位经验丰富的资深工程师一样,受到过往排错逻辑的启发,形成了条理分明的行动闭环:先主动编写一个能够稳定复现问题的测试用例,确定 Bug 并锁死验收基准后,再去精准修改核心业务代码;最后专门回过头来校验边界条件。
反映到数据上,在衡量真实代码修复能力的基准 SWE-bench Verified 中,衡量 Agent 解题一致性与可靠性的关键指标,三次尝试全部成功的比例(All 3 Trials / pass^3),直接从无经验时的 54.0% 大幅提升到了 62.8%(整体平均成功率也从 66.07% 提高到了 69.73%)。
下面我们再来看一下它的底层架构:MemT 到底是如何通过模型内部计算来实现这一切的?
三种记忆路线的区别
在进入细节前,先横向对比一下目前主流的三种记忆方案:
| 路线 |
历史信息放在哪里 |
回答时怎样使用 |
| 长上下文 |
当前输入及对应的历史缓存中 |
通过注意力机制逐 token 访问完整历史 |
| RAG 外部记忆 |
文本、向量库、知识图谱等外部存储 |
检索找出相关片段,拼进当前上下文提示词中 |
| MemT 原生记忆 |
模型内部持续更新的数值隐状态 |
在模型前向计算过程中直接读取与融合 |
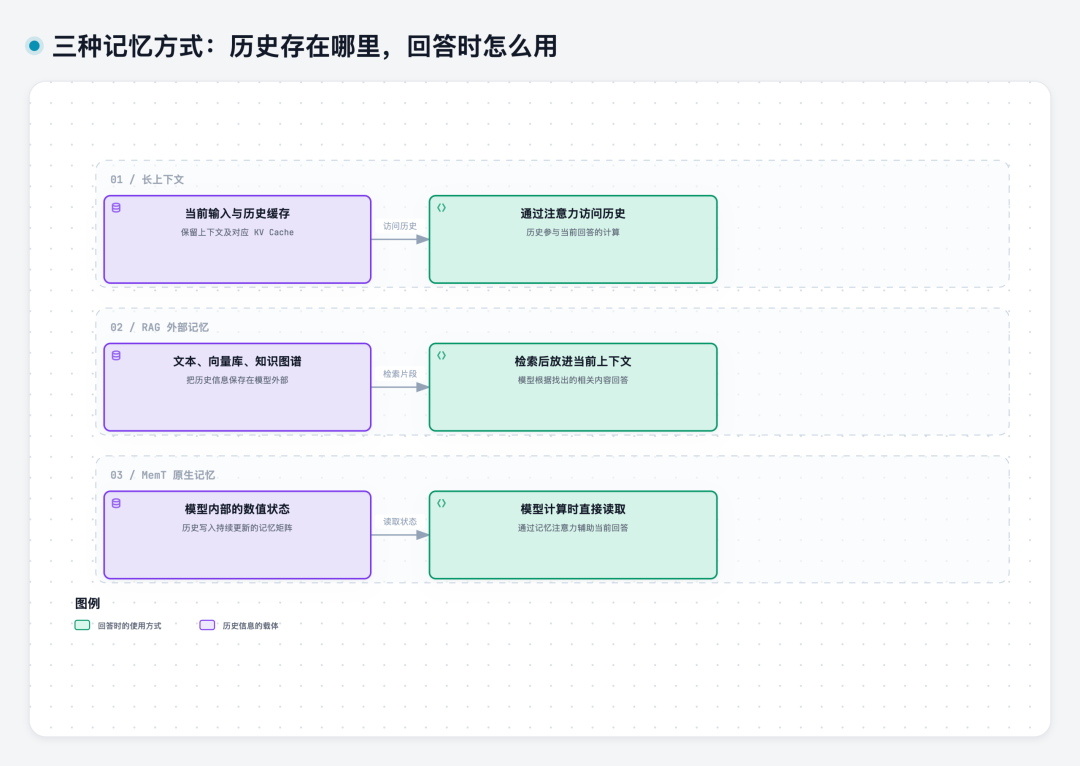
这三条路线并非完全割裂。MemT 在实际使用中也可以有机结合:例如编程 Agent 可以先从外部经验库中检索相关的程序性知识,再通过模型计算把这些经验注入到自身原生记忆中,让其成为内化状态参与后续推理。
架构解析
在 MemT 中,整个记忆机制围绕两个核心概念运转:
目前 MemT 提供了两个开源版本,分别基于不同的模型底座:
| 模型 |
底座 |
总参数 / 激活参数 |
| Nano |
Qwen3.6-35B-A3B |
36B / 3B |
| Flash |
DeepSeek-V4-Flash |
288B / 17B |
下面这张图展现了 MemT 的完整核心架构:
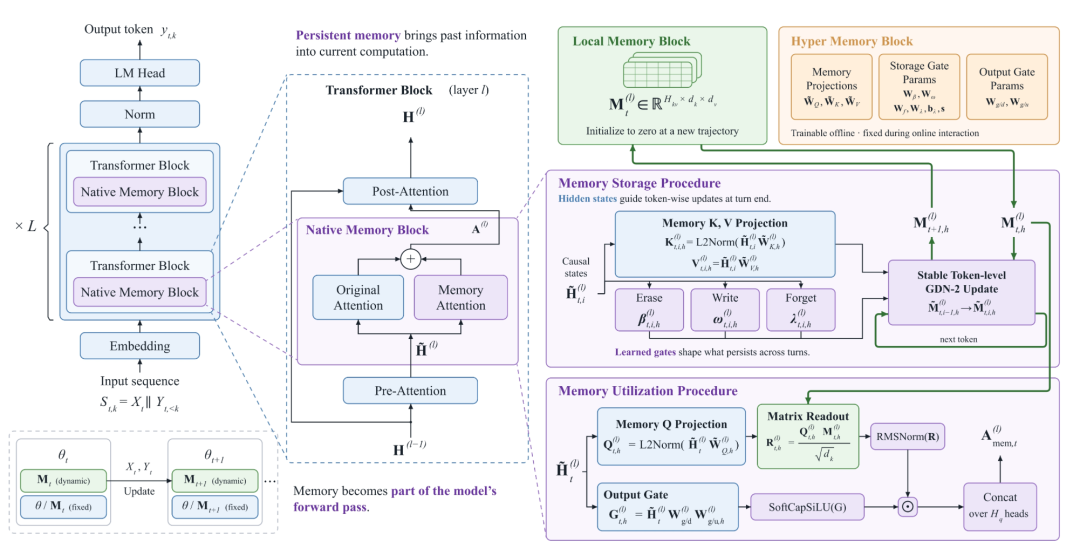
我们可以把整个计算过程连贯地串成一个读写闭环:
-
并行结构(图左与图中央):MemT 在选定的 Transformer 层中嵌入了 Native Memory Block。在处理输入时,原生的 Self-Attention 负责处理当前上下文文本,而 Memory Block 则并行负责与历史记忆交互;
-
记忆的读取与融合(图右下角):根据当前文本特征生成查询向量(Query),直接从 Local Memory 矩阵中读取相关的历史状态。读出的结果经过归一化和门控加权后,与原生的文本注意力表征融合成统一的特征向量,参与下一步的回答与决策生成;
-
记忆的写入与修订(图右上角与右中部):一轮交互结束或处理每个 token 时,系统不会简单地把文本机械追加到历史列表末尾,而是把当前交互表征送进基于 Stable GDN-2 的状态演进规则中。由 Hyper Memory 提供的门控参数精确控制写入多少新特征、擦除多少旧冗余、遗忘多少过时关联,从而动态完成对 Local Memory 的状态更新。
这套读写机制并不是简单的规则启发式,而是在预训练和后训练两个阶段经过了合计约 340 亿 token 语料的专门训练,确保模型具备稳健的记忆保持与提取能力。
评测表现
官方给出的一组测评数据如下:
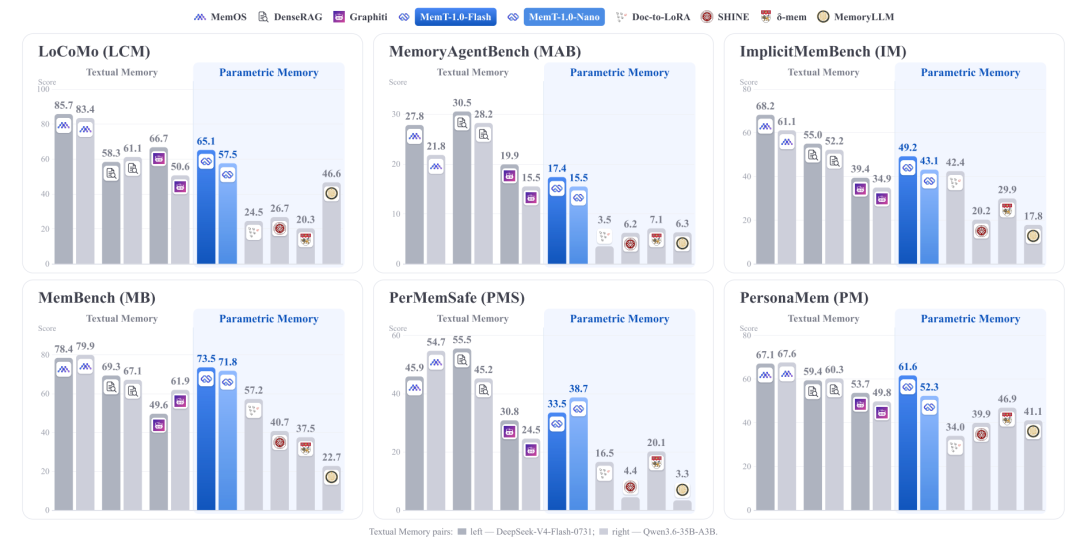
在已评测的参数化记忆(Parametric Memory)方法中,MemT-1.0-Flash 和 MemT-1.0-Nano 分别取得了第一和第二名。
除了前面在 SWE-bench 上表现出的任务决策质量与稳定性提升,MemT 在存储与推理开销上的优势同样非常显著:
-
传统的长上下文方案依赖不断增长的 KV Cache,显存占用与历史长度成线性正比;
-
而 MemT 的动态 Local Memory 结合可训练的 Hyper Memory,其持久隐状态的大小保持恒定;
-
当历史长度达到 128K 时,与保存完整上下文的 KV Cache 相比,MemT 的存储开销可减少约 66 倍。
这使得 Agent 在面对超长周期、连续多轮的排查与执行任务时,既能牢牢记住关键经验,又彻底摆脱了长文本二次计算膨胀与显存爆炸的困扰。
本地安装与部署
那么 MemT 该如何部署呢?
其实官方提供了清晰的推理部署指南,下面以 Nano 版本在 SGLang 框架下的单节点部署 为例:
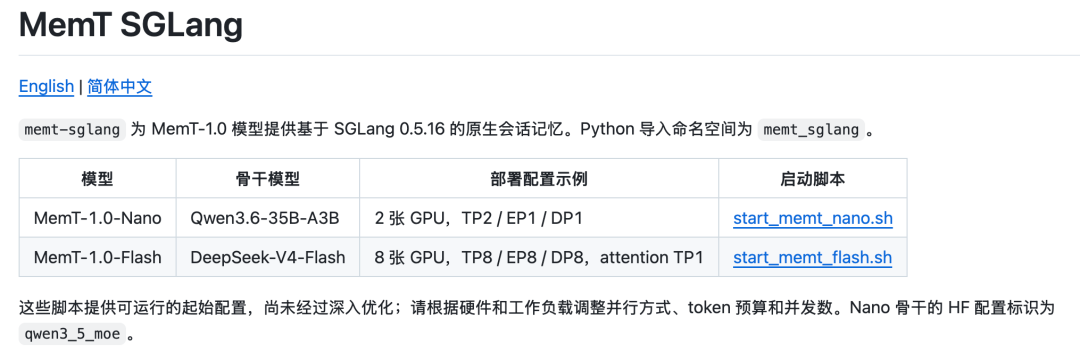
服务端环境要求:Linux、NVIDIA CUDA 以及 Python 3.11 或更高版本。起始硬件配置建议为 Nano 两张 GPU,Flash 八张 GPU。
首先在装好 uv 的环境中拉取仓库、创建虚拟环境并安装服务端依赖:
git clone https://github.com/MemTensor/MemT-1.0.git
cd MemT-1.0/inference

uv venv --python 3.11
source .venv/bin/activate
uv pip install '.[server]'
接着下载完整的 Nano checkpoint。使用安装依赖自带的 Hugging Face Hub 客户端,存放到当前目录的 models 文件夹下:
python - <<'PY'
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="MemTensor/MemT-1.0-Nano",
    local_dir="./models/MemT-1.0-Nano",
)
PY
完整的模型目录需包含 BF16 权重、配置文件与 tokenizer 文件。Nano 仓库文件约 70 GB,下载前请预留充足磁盘空间。
下载完成后启动服务:
sh start_memt_nano.sh ./models/MemT-1.0-Nano
默认服务端口为 http://127.0.0.1:30000,会话的记忆快照将保存在服务端的 ./memt-state 目录下。
保持后台服务运行,新开一个终端,进入同级目录并激活虚拟环境,运行官方提供的记忆保存与恢复示例脚本:
source .venv/bin/activate
python examples/commit_history.py ./models/MemT-1.0-Nano
如果你手头暂时没有合适的 GPU 环境,也可以先通过 RouteFast.ai 这类模型 API 中转服务在云端验证记忆效果,等本地环境就绪后再按上面步骤完成私有化部署。
如果已经准备好了上述 Linux GPU 环境,也可以把下面这句话直接复制给能操作终端的 AI 助手:
请按照官方推理文档 https://github.com/MemTensor/MemT-1.0/blob/main/inference/README_zh.md,在这台 Linux GPU 服务器上部署 MemT-1.0-Nano,先检查 CUDA 和显存,再创建 Python 3.11 环境、安装依赖、下载完整 BF16 权重、启动 SGLang,并运行官方的记忆保存与恢复示例验证结果。
写在最后
回到最初抛出的那个问题:把记忆的读写放进模型计算里,到底意味着什么?
过去很长一段时间,模型变强的主要路径是堆参数量、灌海量数据和拉长上下文窗口。在长上下文和外部检索方案的帮助下,模型已经能记住用户说了什么,或者在被问起时临时找来一段历史参考来回答。
但当大模型演进为需要连续行动的 Agent 时,这就不一样了。
用户关心的不仅是聊天记忆,更是 Agent 在一次次尝试中积累下来的程序性经验:面对同类 Bug 怎么改能最有效?排查问题应该遵照哪些步骤?哪些实现方案曾经踩过坑?
如果每一次任务启动,Agent 都像初生婴儿一样从零开始盲改试错,就无法形成真正的经验积累;这也正是最近技术圈密集讨论 RSI(递归自我改进,Recursive Self-Improvement)的原因。AI 要想不断改进自己,首先必须有办法把做过的事情内化为持续可复用的能力,否则每一轮都是一次性的原地打转,谈不上真正的递归与进化。
MemT 探索的,正是让记忆的存、取、改直接沉淀在模型中。这或许才是记忆原生大模型最值得我们期待的未来。这种把记忆从“外挂”变成“内建”的思路,也是 云栈社区 上不少开发者正在关注的 Agent 方向。
Hugging Face 和 GitHub 可以查看完整开源代码与技术报告:
 发表于 昨天 22:34
|
查看: 5|
回复: 0
 /1


