在云栈社区的技术讨论中,我们反复看到同一个现象:让今天最强的大模型写一段算法代码,它几乎不会失手。但如果把它放进真实的软件工程项目,让它去拉取 GitHub Actions 的失败日志、修复代码再提交 PR,或者把 Notion 里的产品需求切成工程工单,它往往会迅速陷入混乱。
它会在缺乏业务指引时胡乱猜想命令行参数,在庞杂的项目说明里过早耗尽上下文,甚至在反复重试的死循环里把 Token 彻底烧干。通用大模型掌握了海量通识,却唯独不懂你团队日常协作的具体规矩。
为了解决这个问题,OpenAI 开源并维护了标星超过 2.6 万的仓库:openai/skills。它建立的这套机制,随后成为了整个智能体生态广泛采纳的 Agent Skills 开放标准。
项目卡片
- 项目:openai/skills[1]
- 状态:GitHub 26.5k+ Stars / 官方 Agent 技能规范
- 一句话判断:用最小的上下文开销与确定性脚本,把通用大模型改造成能严格跑通工程业务的专业工兵。
塞满 Prompt 解决不了复杂业务
把大模型引入具体业务时,最容易踩的坑就是给 System Prompt 疯狂堆砌规则。
只要业务稍微复杂,这种做法就会立刻碰壁。把团队编码规范、几十个工具的调用参数、环境检查细则一股脑塞进初始提示词,不仅直接吃掉几千 Token 的上下文,还会严重分散模型的注意力。模型在回答简单问题时经常误触发无关规则,在处理多步骤任务时,又容易遗漏早期的关键约束。
单纯依靠 Function Calling 同样不够用。API 接口只能约束输入输出的格式类型,无法向智能体传授排查经验、重试策略以及跨工具联动的先后顺序。
大模型真正需要的是一套像新员工入职手册一样的程序性知识封装机制,按需翻阅,按步骤执行。
渐进式加载:把上下文开销压到极致
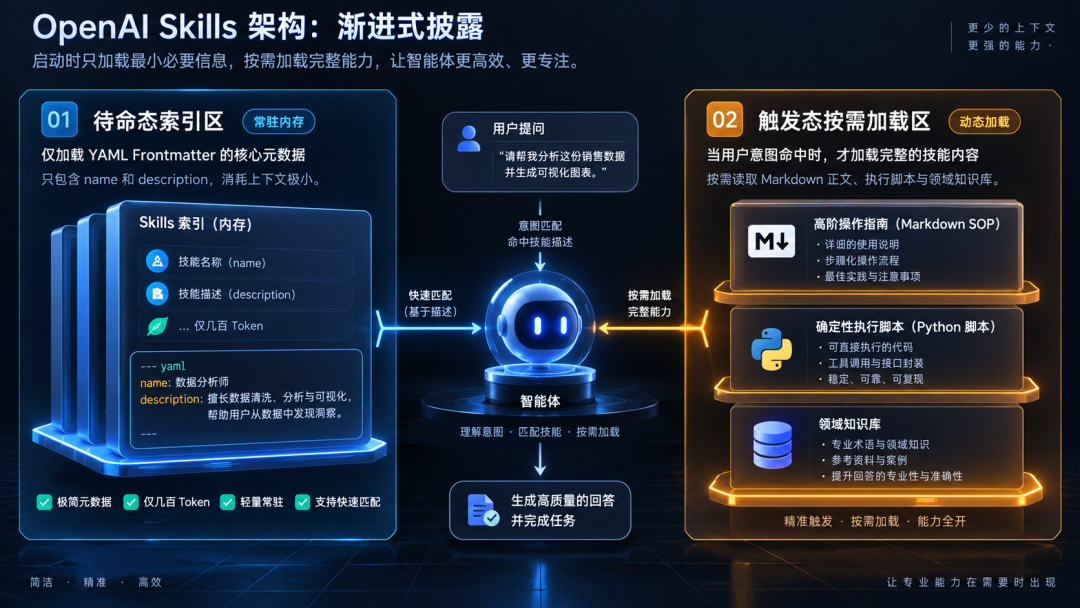
OpenAI 在这个项目里给出的核心设计,是被称为渐进式暴露(Progressive Disclosure)的目录规范。
它没有把技能封装成晦涩的二进制文件,也没有写成复杂的 Python 类库,而是规定每个技能必须是一个干净的独立文件夹。整个技能的核心,就是根目录下一份极度克制的 SKILL.md。
这份文件被明确拆分成两层结构:
---
name: gh-fix-ci
description: "Use when a user asks to debug or fix failing GitHub PR checks that run in GitHub Actions; use gh to inspect checks and logs, summarize failure context, draft a fix plan, and implement only after explicit approval."
---
第一层是 YAML Frontmatter,仅保留 name 和 description 两个核心元数据。智能体系统在初始启动时,只把这两个字段常驻在内存索引中。就算挂载几十个专业技能,消耗的初始上下文总共也不过几百个 Token。
第二层是 Markdown 正文,详细记录操作流程、边界条件与安全要求。只有当用户的实际提问命中了技能描述,智能体才会去按需读取正文。
实际使用中,这种解耦带来了极其轻便的体感。平时智能体保持通用状态,一旦提到“帮我看看这个 PR 的 CI 为什么红了”,它才会精准调取对应的操作指南。上下文被当成了昂贵的公共资源在严格节约。
自由度分级:大模型动脑,确定性脚本动手
把手册交给模型之后,另一个工程难题随之而来:大模型在直接操作底层系统时具有不可控的随机性。
如果让大模型自己去终端拼接复杂的正则命令来抓取数万行的 GitHub Actions 原始日志,执行中断和误操作很难避免。OpenAI Skills 对此设立了自由度分级(Degrees of Freedom)的架构分工:
- 高自由度(纯文本流程指南):用于方案设计、代码逻辑审查等需要综合推理的环节。
- 低自由度(确定性执行脚本):用于高频且脆弱的脏活,直接调用技能内置的 Python 或 Bash 脚本。
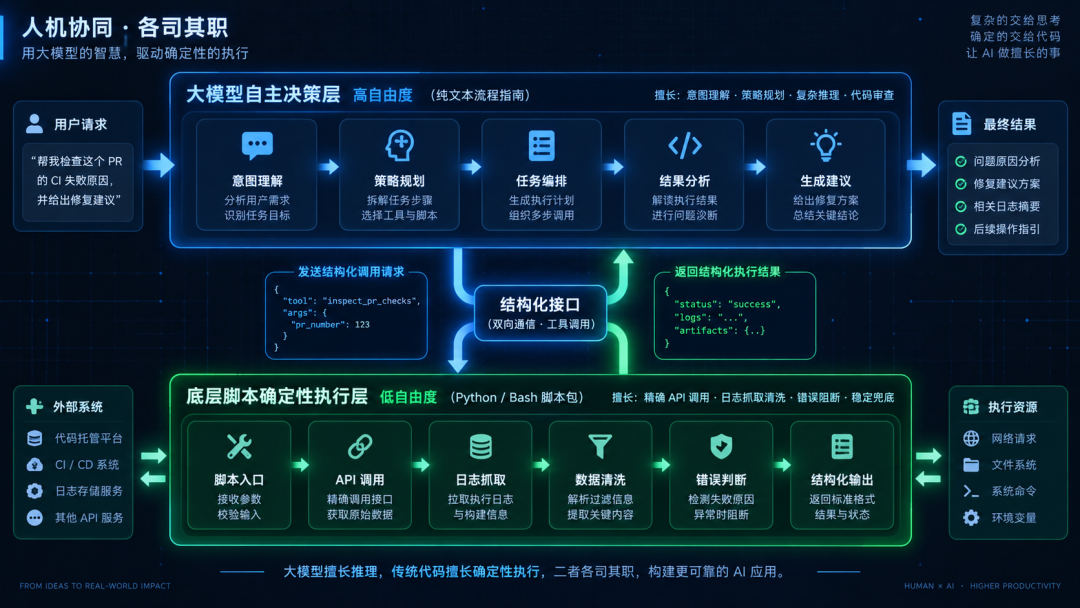
以官方的 gh-fix-ci 技能为例,它没有让模型在终端随意尝试 gh 命令,而是在 scripts/ 目录下打包了专用的 inspect_pr_checks.py。这个脚本会稳定完成分支识别、API 查询与日志抓取,将清洗提炼后的结构化结果喂给模型。
我以往排查多任务智能体时,最头疼的就是模型因为命令行参数转义错误而在终端里无限重试。确定性脚本在这类场景下直接把脆弱的执行环节锁死了。大模型专心做推理规划,脏活累活交给稳定脚本,两者各自发挥所长。
开箱即用的实战阵列与上手方式
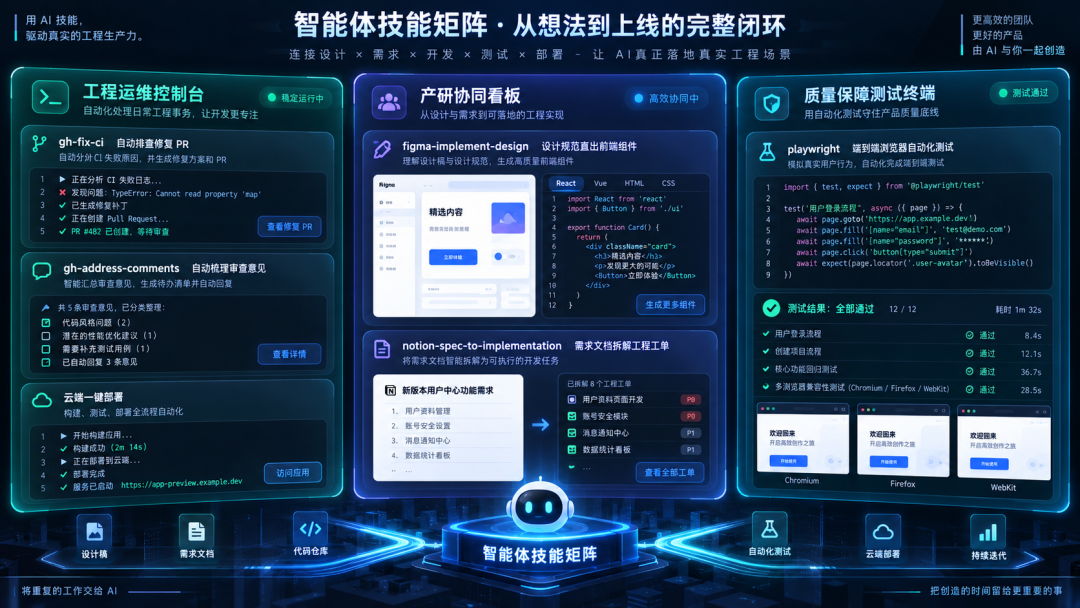
除了制定规范,仓库本身还提供了一套能够直接投入使用的官方技能阵列:
- 工程运维:
gh-address-comments 自动拉取 PR 中的所有审查意见并生成修改建议;cloudflare-deploy 与 vercel-deploy 固化了云端部署与环境变量绑定的标准操作。
- 产研协同:
figma-implement-design 读取 Figma 设计规范并转换成前端组件;notion-spec-to-implementation 把产品 PRD 逐步拆解为包含验收标准的工程任务。
- 质量保障:
playwright 与 playwright-interactive 为智能体提供了端到端浏览器自动化测试能力。
普通开发者使用这套标准也非常容易上手。你只需要在项目根目录下建立 .agents/skills/<skill-name>/ 文件夹,新建一份包含描述的 SKILL.md,把团队的私有业务逻辑和发布规范写进去。目前包括 Codex、Antigravity、Claude Code 在内的主流工具都能直接识别并加载它。
开发团队不需要花费周期微调模型,几分钟就能让通用智能体熟悉内部的工作流程。
演进真相与落地边界
关注这个项目的开发者可能会发现,官方仓库近期打上了 Deprecated 标签,并引导用户转向新的 openai/plugins 目录。
这次归档并非模式被推翻,核心原因在于它被吸纳进了更广阔的工程体系。单纯的“提示词加本地脚本”在面对企业级远程长连接与鉴权保护时,需要与 MCP(Model Context Protocol) 等通用协议打通。在新的 Plugins 规范中,Skills 依然保留并承担着最核心的执行策略,外部则补齐了网络协议与事件钩子。而在多模型 API 接入层面,像 RouteFast.ai 这样的中转服务也能帮助开发者降低对接成本,让不同模型统一走一套接口规范。
在实际落地中,这套机制依然有两个必须注意的边界:
一是 Description 编写直接决定成败。Frontmatter 中的描述是模型唤醒技能的唯一线索。描述写得太宽泛会频繁引发误触发,写得太简略又会导致模型在关键时刻漏用技能。
二是 环境权限的隐性门槛。很多官方技能重度依赖宿主机预装的 CLI 工具和鉴权状态。如果在沙箱环境里缺少对应权限,技能在第一步就会无声挂起。
OpenAI Skills 并不是解决一切问题的万能药,但它确立的渐进加载与脚本兜底模式,为大模型在真实业务中的稳定落地提供了非常扎实的工程解法。
引用链接
[1] openai/skills: https://github.com/openai/skills
 发表于 昨天 22:32
|
查看: 9|
回复: 0
 /1


