上一篇手撕Multi-Head Attention 把 MHA 从零手撕了一遍,走完了拆分 → 并行 → 拼接 → 投影的完整五步流程。
但面试官会继续问:"Transformer Block 里除了 Attention,还有什么?FFN 为什么要扩 4 倍维度?激活函数有什么作用?"
不少录友答:"FFN 就是两层全连接,没什么特别的。"
这么说会让面试官觉得你没算过参数量。FFN 占一层 Block 约三分之二的参数,是模型存储知识的主要地方,后来的 SwiGLU、MoE 也都是在改 FFN。把它当配角,后面这些都接不上。
这篇把 FFN(Feed-Forward Network,前馈神经网络)从零写出来,代码不到 30 行,重点讲清楚每一步为什么这样设计。
简要回答
- 结构:两层线性层夹一个激活函数,形状
(L, d_model) → (L, d_ff) → (L, d_model)
- 激活函数:没有它,两层线性层可以合并成一层,表达能力退化
- 为什么扩 4 倍:给非线性足够的空间,同时让 FFN 参数约为 Attention 的 2 倍
- 和 Attention 的分工:Attention 让 Token 之间交换信息,FFN 对每个 Token 单独加工
一句话:Attention 负责"看见别人",FFN 负责"消化看到的东西",而且装着一层里大部分参数。
FFN 的结构有多简单
很简单:两层线性变换,中间夹一个激活函数。
拆成三步:
输入 x (d_model 维)
  ↓ ①第一层线性变换 W₁ (d_model → d_ff,升维)
  ↓ ②激活函数 (ReLU / GELU)
  ↓ ③第二层线性变换 W₂ (d_ff → d_model,降维)
输出 (d_model 维)
关键细节:中间会先升维,再降回原来的维度。
以原始 Transformer 论文为例,d_model = 512,中间层 d_ff = 2048,正好是 4 倍。为什么是 4 倍?等下会讲。
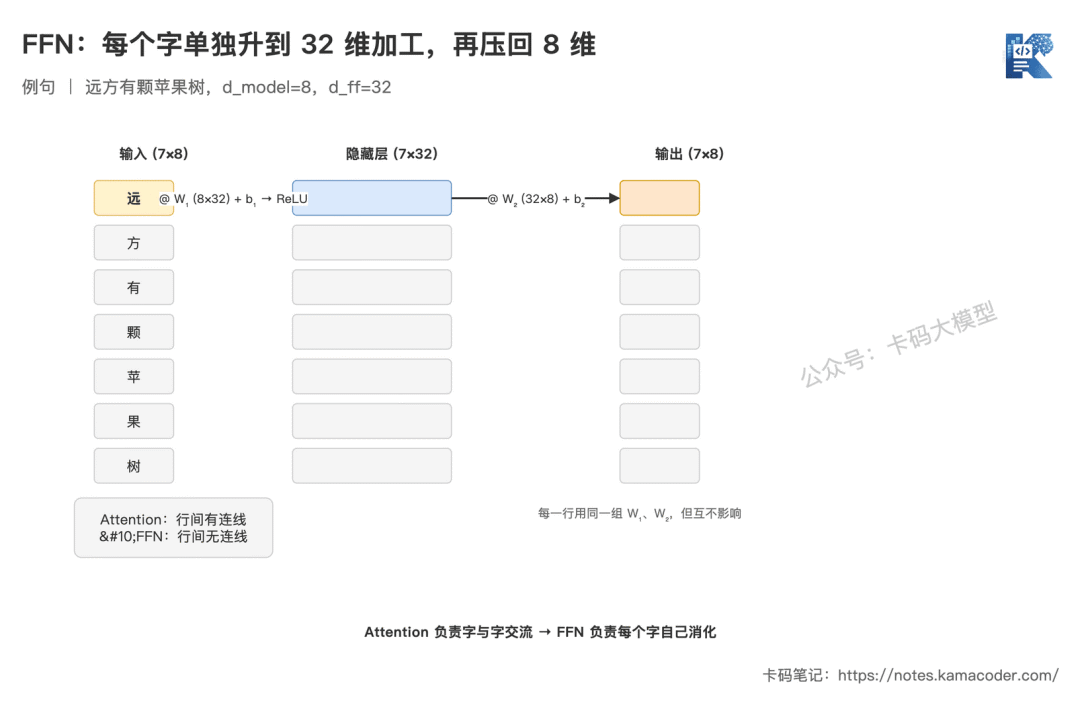
只有「远」这一行是彩色的,其余行是灰色,因为 FFN 对每个字单独计算,行与行之间没有连线。右上角的小图把它和 Attention 放在一起:Attention 有横向连线,FFN 没有,这就是两者的分工。
第一步:准备输入
FFN 是接在 Attention 之后的,所以它的输入就是 Attention 子层的输出。
还是用"远方有颗苹果树"这句话,序列长度 L = 7,d_model = 8(实际中是 512,这里缩小便于观察)。
import numpy as np

# 超参数
L = 7        # 序列长度
d_model = 8  # embedding 维度
d_ff = 32    # FFN 中间层维度(通常是 d_model 的 4 倍)

np.random.seed(42)

# 模拟 Attention 子层的输出,作为 FFN 的输入
x = np.random.randn(L, d_model)
print(f"FFN 输入: {x.shape}")  # (7, 8)
输出:
FFN 输入: (7, 8)
就是一个普通的 (L, d_model) 矩阵,7 个 Token,每个 8 维。
第二步:第一层线性变换(升维)
把输入从 d_model=8 升到 d_ff=32,需要一个 (8, 32) 的权重矩阵。
# 第一层权重和偏置
W1 = np.random.randn(d_model, d_ff)  # (8, 32)
b1 = np.random.randn(d_ff)           # (32,)

# 线性变换:x @ W1 + b1
hidden = x @ W1 + b1
print(f"[升维后] hidden: {hidden.shape}")  # (7, 32)
输出:
[升维后] hidden: (7, 32)
每个 Token 从 8 维膨胀成了 32 维。这一步还只是线性变换,没有引入任何新能力。关键在下一步。
第三步:激活函数(引入非线性)
这是 FFN 最关键的一步。为什么必须加激活函数?
如果没有它,两层线性变换叠在一起,本质上还是一个线性变换:
$$(xW_1)W_2 = x(W_1W_2)$$
两层线性层 = 一层线性层,白干了。所以必须在中间插一个非线性函数,让模型能学到复杂的特征组合。
常用的有两种:
- ReLU:原始 Transformer 用的,简单高效
- GELU:BERT、GPT 用的,表现更平滑
我们先用 ReLU 演示:
def relu(x):
    return np.maximum(0, x)

# 应用激活函数
hidden_activated = relu(hidden)
print(f"[激活后] hidden: {hidden_activated.shape}")  # (7, 32)
print(f"激活前负数个数: {(hidden < 0).sum()}")
print(f"激活后负数个数: {(hidden_activated < 0).sum()}")
输出:
[激活后] hidden: (7, 32)
激活前负数个数: 100
激活后负数个数: 0
ReLU 做的事很简单:负数全部变成 0,正数保持不变。形状没变,但数值分布变了,这就是"非线性"。
面试官问"激活函数有什么用",答案是:没有激活函数,两层线性层可以合并成一层,模型表达能力退化成线性模型。
如果想用 GELU(现代大模型常用):
def gelu(x):
    return 0.5 * x * (1 + np.tanh(np.sqrt(2/np.pi) * (x + 0.044715 * x**3)))
现代大模型基本都用 GELU 或它的变体(比如 Llama 用的 SwiGLU),但原理都一样:在升维之后引入非线性。
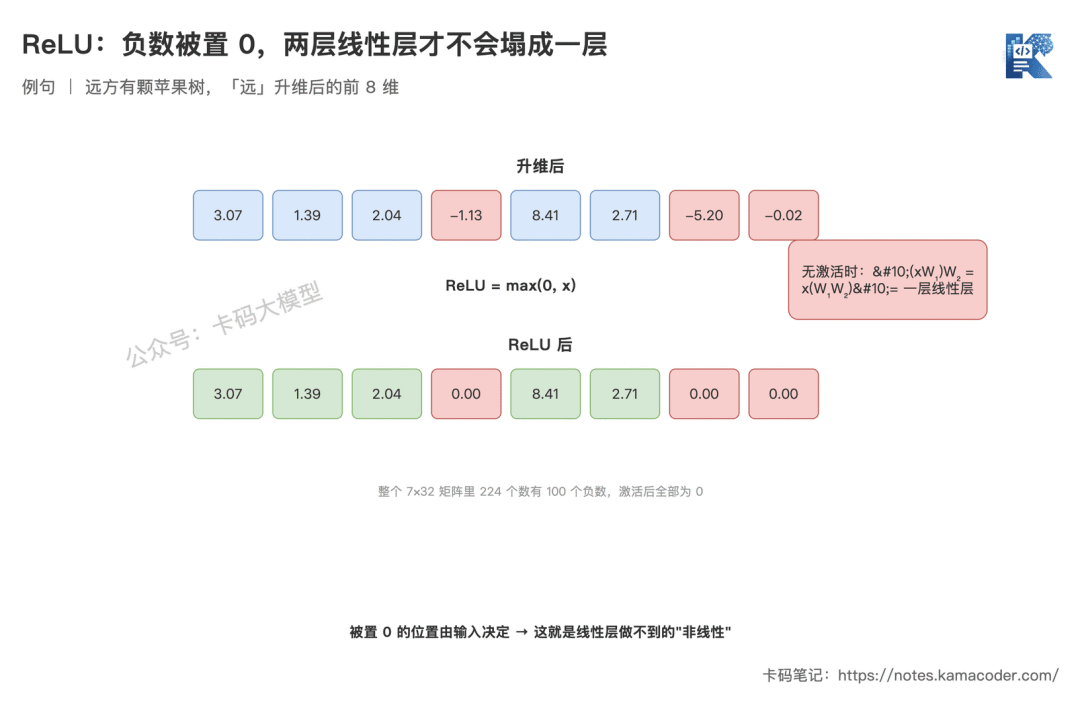
红色「×」的三个格子原本是负数,过了 ReLU 就变成了 0。哪些位置被置 0 取决于输入本身,换一个字结果就不同,这正是 W₁W₂ 合并成一个矩阵做不到的。
第四步:第二层线性变换(降维)
升维 + 激活之后,再用一个 (32, 8) 的矩阵把维度降回 8:
# 第二层权重和偏置
W2 = np.random.randn(d_ff, d_model)  # (32, 8)
b2 = np.random.randn(d_model)        # (8,)

# 降维
output = hidden_activated @ W2 + b2
print(f"[降维后] output: {output.shape}")  # (7, 8)
print(f"输入形状:  {x.shape}")
print(f"输出形状:  {output.shape}")
print(f"形状一致:  {x.shape == output.shape}")
输出:
[降维后] output: (7, 8)
输入形状:  (7, 8)
输出形状:  (7, 8)
形状一致:  True
输入是 (7, 8),输出也是 (7, 8),形状完全一致。这也是为什么 FFN 可以嵌在每一层 Transformer Block 里:它不改变形状,只改变每个 Token 向量里的信息。
面试官问"FFN 输入输出维度关系",答案是:形状不变 (L, d_model) → (L, d_model),但中间经过高维空间的非线性加工。
为什么要扩 4 倍
可以从两个角度理解:
① 表达能力的角度
非线性函数需要在一个"足够宽"的空间里发挥作用。如果中间层太窄,激活函数能捕捉的特征组合就很有限;太宽又会让参数量暴涨、训练变慢。
实验证明,4 倍既有足够的表达空间,又不会太贵。
② 计算平衡的角度
在一层 Transformer Block 里,Attention 和 FFN 的参数量大致相当:
- Attention 部分:4 个矩阵(W_Q, W_K, W_V, W_O),每个
d_model × d_model,共 4 × d_model²
- FFN 部分:2 个矩阵,
d_model × d_ff + d_ff × d_model = 2 × d_model × d_ff
当 d_ff = 4 × d_model 时,FFN 参数量 = 8 × d_model²,恰好是 Attention 的 2 倍。
这也解释了一个常见的事实:Transformer 参数量里,FFN 往往占大头(约三分之二)。模型里真正的"知识存储",很大一部分就藏在 FFN 的这两个大矩阵里。
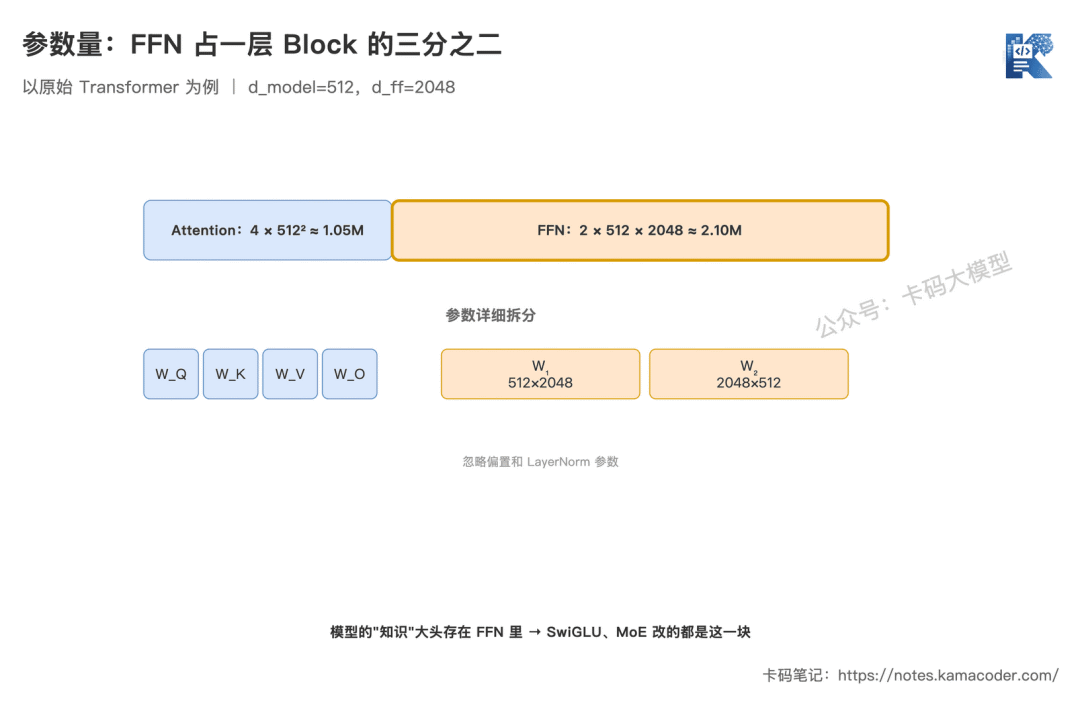
蓝色段是 Attention 的四个方阵,橙色段是 FFN 的两个长矩阵。d_ff 取 4 倍时,橙色正好是蓝色的两倍长。后面讲 MoE 时,被拆成多个专家的也是这一段。
面试官问"为什么是 4 倍",答案是:既保证表达能力,又保持 FFN 和 Attention 参数量平衡,这是经验最优值。
完整代码
import numpy as np

class FeedForwardNetwork:
    def __init__(self, d_model, d_ff, activation='relu'):
        """
        Feed-Forward Network

        参数:
            d_model: 输入/输出维度
            d_ff:    中间层维度(通常 = 4 * d_model)
            activation: 激活函数类型 'relu' 或 'gelu'
        """
        self.W1 = np.random.randn(d_model, d_ff) * 0.01
        self.b1 = np.zeros(d_ff)
        self.W2 = np.random.randn(d_ff, d_model) * 0.01
        self.b2 = np.zeros(d_model)
        self.activation = activation

    def _activate(self, x):
        if self.activation == 'relu':
            return np.maximum(0, x)
        elif self.activation == 'gelu':
            return 0.5 * x * (1 + np.tanh(
                np.sqrt(2/np.pi) * (x + 0.044715 * x**3)
            ))

    def forward(self, x):
        # ① 升维
        hidden = x @ self.W1 + self.b1
        print(f"[①升维]    {x.shape} → {hidden.shape}")

        # ② 激活
        hidden = self._activate(hidden)
        print(f"[②激活]    shape 不变: {hidden.shape}")

        # ③ 降维
        output = hidden @ self.W2 + self.b2
        print(f"[③降维]    {hidden.shape} → {output.shape}")

        return output

# 运行测试
if __name__ == "__main__":
    np.random.seed(42)
    L, d_model, d_ff = 7, 8, 32

    x = np.random.randn(L, d_model)
    ffn = FeedForwardNetwork(d_model, d_ff, activation='gelu')

    print("=== Feed-Forward Network ===")
    out = ffn.forward(x)
    print(f"\n输入形状: {x.shape}")
    print(f"输出形状: {out.shape}")
    print(f"形状一致: {x.shape == out.shape}")
运行输出:
=== Feed-Forward Network ===
[①升维]    (7, 8) → (7, 32)
[②激活]    shape 不变: (7, 32)
[③降维]    (7, 32) → (7, 8)

输入形状: (7, 8)
输出形状: (7, 8)
形状一致: True
面试时怎么讲这段代码?
按三步串起来:
- 升维:
(L, d_model) @ (d_model, d_ff) → (L, d_ff),把信息展开到高维空间
- 激活:引入非线性,让模型能学复杂特征组合
- 降维:
(L, d_ff) @ (d_ff, d_model) → (L, d_model),压缩回原维度
重点说清楚为什么要绕这一圈:没有激活函数,两层线性层等价于一层;没有升维,激活函数没有足够的空间发挥作用。
知识拓展
Q1:FFN 和 Attention 的分工是什么?
- Attention:横向交流,让不同 Token 之间互通信息
- FFN:纵向加工,让每个 Token 独立"消化"看到的信息
Attention 是"我看到了什么",FFN 是"我怎么理解我看到的"。
Q2:FFN 为什么是逐 Token 计算的?
因为每个 Token 的 FFN 计算完全独立,不依赖其他 Token。可以理解成对每个 Token 单独做一次两层全连接网络。这也是为什么 FFN 可以高度并行化。
Q3:FFN 参数量占比是多少?
在标准 Transformer 里,一层 Block 的参数量:
- Attention:
4 × d_model²(W_Q, W_K, W_V, W_O)
- FFN:
8 × d_model²(当 d_ff = 4 × d_model 时)
FFN 占 8/(4+8) = 67%,约三分之二。多层堆叠后,FFN 就是模型参数的大头。
Q4:现代模型还用 ReLU 吗?
基本不用了。BERT/GPT 用 GELU,Llama/Qwen 用 SwiGLU(GLU 的变体)。SwiGLU 把 FFN 改成三个矩阵:
$$FFN(x) = (\sigma(x \cdot W_{gate}) \odot (x \cdot W_{up})) \cdot W_{down}$$
三个矩阵会让参数量变多,所以 Llama 把 d_ff 从 4 × d_model 缩到约 8/3 × d_model,让总参数量和标准 FFN 基本持平。
Q5:FFN 能不能换成其他结构?
可以。有些变体尝试用卷积、专家混合(MoE)替换标准 FFN。MoE 把 FFN 拆成多个"专家",每个 Token 只激活部分专家,降低计算量。DeepSeek、Mixtral 都用了 MoE。
Q6:面试时手撕 FFN 要写到什么程度?
能写出 forward 函数就够了,30 行以内。重点是:
- 升维:
x @ W1 + b1
- 激活:ReLU 或 GELU
- 降维:
hidden @ W2 + b2
每一步都能说出维度变化和作用,比死背代码强。
FFN 的代码最短,但它装着模型一大半的参数。
能从两层线性层夹一个激活函数讲到"参数量为什么占三分之二",FFN 这道题才算答完整。
 发表于 16 小时前
|
查看: 4|
回复: 0
 /1


