上一篇我们沿着 Transformer 的数据流动走了一遍:编号、Embedding、Block,再到预测下一枚 Token。不过那条链路走的是 Decoder-only 路线,不能直接套用到所有 Transformer 架构上。
面试时经常会被问到:BERT、GPT、T5 都在用 Transformer,为什么一个习惯做分类,一个适合续写,一个常用于翻译?三种架构的差异究竟在哪里?
「Encoder 负责理解,Decoder 负责生成」这句口诀容易记,但没讲清信息到底怎么流动。只背口诀,很容易误以为 Decoder-only 不负责理解输入,或者 Encoder-Decoder 不能像聊天模型一样逐步生成。
这篇只抓两件事:每个位置能读取谁的信息,模型又拿这些信息产生什么输出。把这两条线索理清,再谈任务和选型。
简要回答
- Encoder-only:用双向自注意力编码输入,每个有效位置都能读取完整输入。BERT 是代表,得到的上下文表示可以交给分类、实体识别等任务头。
- Decoder-only:用因果自注意力处理前缀,每个位置只能读取自身和前面的位置。GPT 是代表,用当前位置的输出预测下一枚 Token,再追加到前缀继续生成。
- Encoder-Decoder:Encoder 编码完整原文,Decoder 处理目标前缀,再通过交叉注意力读取原文表示。T5 是代表,适合把输入序列转换为输出序列。
- 任务偏好不等于能力边界:Decoder-only 也能做分类、翻译;Encoder-Decoder 也能自回归生成。架构、训练目标、训练数据和任务适配要一起看。
比较三种架构,先看注意力的可见范围和信息来源,再看输出方式。
同一句话,先约定位置和可见范围
拿「远方有棵苹果树」举例。为了和图对应,这里假设分词结果是 [远方, 有, 棵, 苹果, 树],只为演示,并不对应某个真实 Tokenizer。
沿用上一篇的记法:序列长度记为 L,隐藏维度为 d,批次维度先省略。五个 Token 经过 Embedding 后得到 5 × d 的表示;Attention 只是更新这些表示,并不会直接增加 Token 数量。
下面的矩阵统一按「行代表发起查询的位置,列代表被读取的位置」来画。「苹果」这一行的可见范围,就是计算它的表示时,允许从哪些位置取信息。
另外要分清两件事:掩码决定哪些位置可以参与,注意力权重决定可见位置各占多少。图里的色块只表示可见范围,别把它理解为「每个位置权重都一样」。实际模型通常还会屏蔽 Padding 位置。
Encoder-only:为什么右边的词也能帮助理解?
既然整句话已经给定,编码时就没必要假装右侧内容还没出现。以 BERT 这类编码器为例,「苹果」位置可以同时读取左侧的「远方、有、棵」和右侧的「树」,得到一个结合完整上下文的表示。
这就是双向自注意力。「双向」指左右上下文都可见,而不是把一句话从左到右、再从右到左各读一遍。
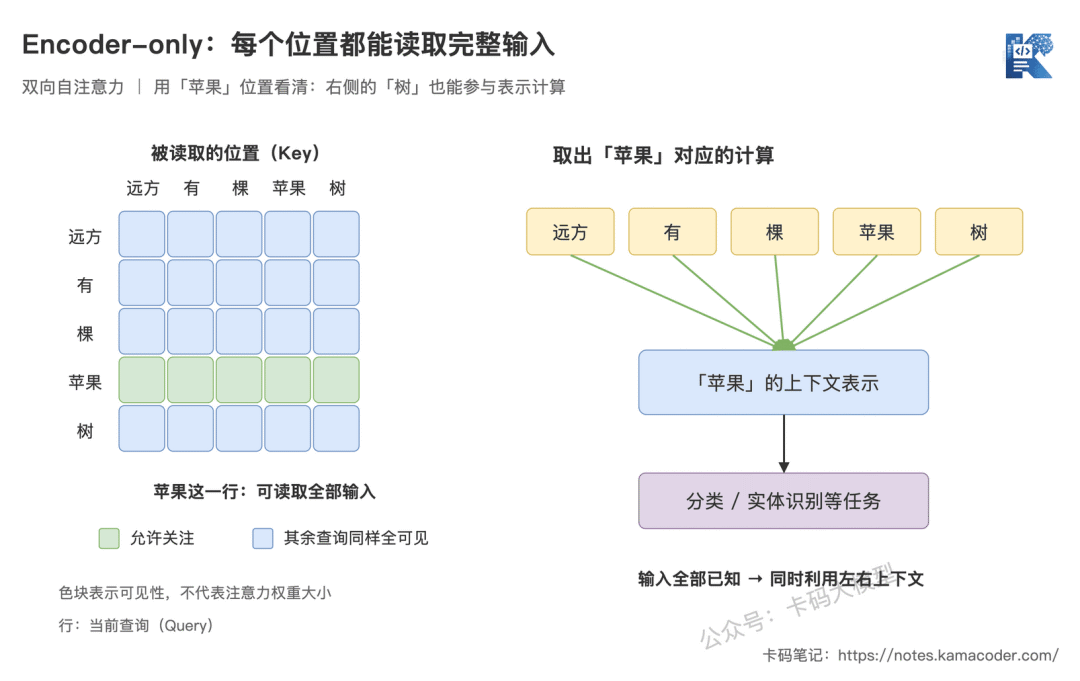
这张图回答的正是:Encoder-only 架构中,一个位置能读取哪些输入?矩阵里「苹果」这一行全部可见,右侧连线把这些位置的信息汇入「苹果」的上下文表示。其余位置同样可以读取完整输入,只是最终聚合的注意力权重可能不同。
编码器主干输出仍然对应五个位置,即 5 × d。之后怎么用要看任务头:文本分类可以取特定位置或池化后的表示来预测类别;实体识别则给每个位置预测标签。
所以更准确的说法是:编码器先产出上下文表示,任务头再把表示转成任务结果。「Encoder-only 的输出就是一句分类结果」并不成立,分类只是它的一种用法。
训练方式也要单独看。BERT 的代表性预训练任务是掩码语言模型(MLM):遮住或扰动部分输入,让模型恢复原始 Token。它可以借助左右上下文完成填空,这和「只凭前文预测下一枚」不是同一个任务。
Decoder-only:为什么看得到自身,却不能看未来?
假设模型已经拿到前缀 [远方, 有, 棵, 苹果],现在预测下一枚 Token。「苹果」本来就在输入里,自然可以参与计算;还没生成的「树」不在可用前缀里,不能提前拿来当线索。
因此,标准因果自注意力允许第 i 个位置读取第 1 到第 i 个位置。限制的是未来位置,不是自身位置。按前面的行列约定,被遮住的部分位于矩阵上三角,对角线仍然可见。
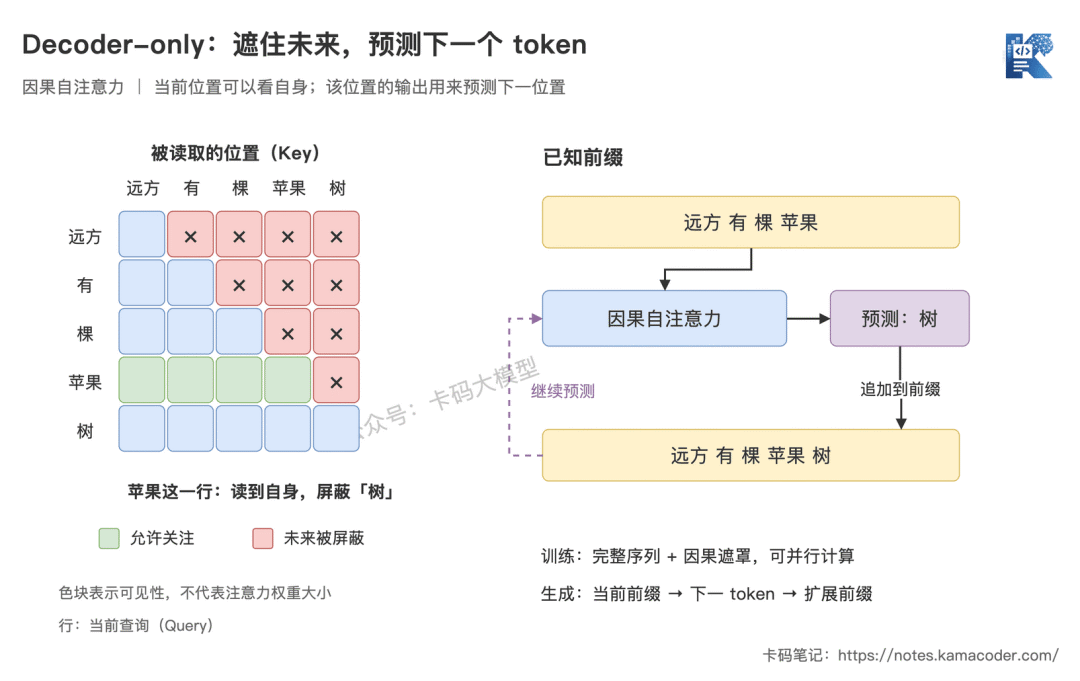
这张图回答的是:因果遮罩和逐步生成如何配合?左侧矩阵限定信息可见范围;右侧用「苹果」位置的表示预测「树」,再把「树」追加到输入前缀,继续预测下一枚。让序列变长的是追加动作,不是多经过了一层 Block。
训练时,整段文本已经准备好,可以把输入和预测目标错开一位。比如一个训练片段可以写成:
输入:远方   有   棵   苹果
目标:有     棵   苹果 树
第一行的四个位置各自预测下一枚 Token,再一起计算损失。因果掩码保证「有」位置不能读取后面的「棵」,也就不会从输入中直接偷看到自己的预测答案。
训练时目标已知,各位置可以并行计算;生成时后续 Token 未定,必须等上一枚选出来。因果掩码描述的是信息依赖,并不意味着训练时也要把每个位置排队算完。
Decoder-only 通常也不会包括原版 Transformer Decoder 中读取独立编码器输出的交叉注意力子层。提示词和已生成内容都放在同一条序列里,模型靠因果自注意力使用它们。具体生成循环和 KV Cache 可以回看数据流教程。
Encoder-Decoder:Decoder 怎么读到另一段输入?
翻译场景中,原文和译文是两条不同的序列。以把 I love apples 译成「我爱苹果」为例:原文已经完整给定,译文则需要逐步生成。两条序列的信息可见范围并不相同。
Encoder 先用双向自注意力编码全部原文,保留各位置的表示。Decoder 则先用因果自注意力处理目标前缀,例如「〈起始〉我爱」,再通过交叉注意力读取原文表示。
这里的「交叉」指:查询和被读取的信息来自不同序列。Decoder 当前表示提供 Q,Encoder 输出经投影提供 K、V。Q、K、V 的直觉可以对照 Attention 到底在干嘛。
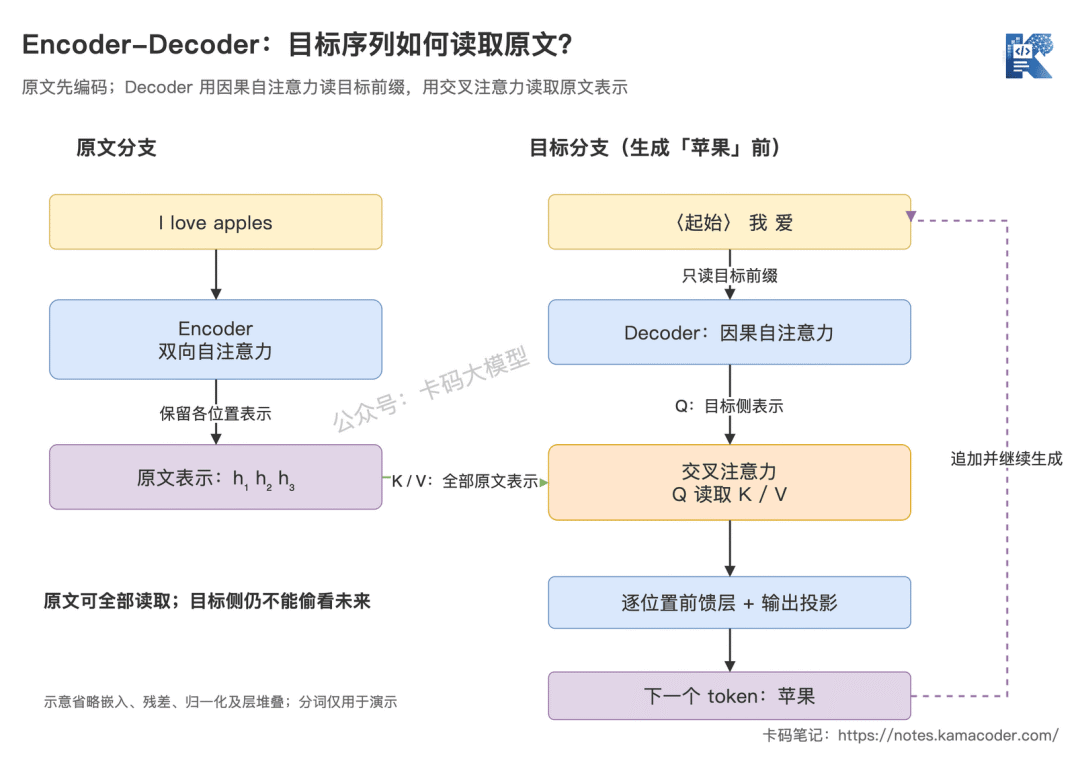
这张图回答的是:Decoder 如何一边读原文、一边生成译文?左侧原文表示送入交叉注意力作为 K/V 的来源,右侧目标前缀产生 Q。Decoder 可以读取完整原文,但目标侧仍不能提前读取尚未生成的「苹果」。
假设原文长 S,目标前缀长 T,那么 Encoder 输出对应 S × d,Decoder 主干表示对应 T × d。单个注意力头中,交叉注意力的权重矩阵是 T × S——每个目标位置分别决定如何读取原文各位置的信息。
原文和译文的 Token 数不必相同,也不是一个原文 Token 硬配一个译文 Token。生成一枚译文 Token 时,完全可以综合原文多个位置的信息。
生成阶段,原文编码结果可以复用,Decoder 持续扩展目标前缀。T5、BART 都采用编码器与解码器协作的结构,这类模型同样可以逐 Token 自回归生成,并不会因为多了 Encoder 就一次性输出整段译文。
都能生成,为什么通用语言模型常采用 Decoder-only?
先纠正一个前提:不是「只有 Decoder-only 能生成」,也不是「用了因果掩码就一定更强」。Encoder-Decoder 的目标侧同样使用因果掩码,照样可以逐步生成文本。
Decoder-only 适合通用生成,关键在于它把很多任务塞进同一种接口:给定前缀,继续预测后面的 Token。普通文本可以直接构造下一 Token 训练样本;问答、翻译、摘要和代码补全,也可以组织成「任务说明与输入在前,回答在后」。
这种统一接口便于复用训练和推理流程,也便于一个模型适配多种生成任务。配合大规模训练、指令微调等环节,它形成了一条实用的通用模型路线。但「能继续预测 Token」本身不保证模型会遵循指令,更不保证答案正确。
这条路也有取舍:标准因果掩码下,提示词中较早的位置不能反过来读取较晚的位置;Encoder 则可以对完整输入做双向编码。不能只凭架构名字,就断定谁在所有任务上精度更高、推理更快。结果还取决于模型规模、训练数据、输入输出长度和实现方式。
实际选型,先看输出需求,再看成本
下面是一组常见起点,不等于能力边界:
| 需求 |
可以优先评估的路线 |
需要验证什么 |
| 固定类别分类、实体抽取、文本表示 |
Encoder-only + 对应任务头 |
准确率、F1、吞吐和延迟;向量检索还需匹配相似度训练目标 |
| 对话、开放续写、代码生成 |
Decoder-only |
任务正确率、指令遵循、首 Token 延迟和生成速度 |
| 输入输出明确分开的翻译、摘要、改写 |
Encoder-Decoder,也可比较 Decoder-only |
信息保真、任务质量、不同输入输出长度下的总延迟与显存 |
如果只需要固定的几个标签,不妨先测试一个小型任务模型,别默认让大模型生成一段话再解析标签。反过来,如果需要自由回答、多轮上下文和多种任务共用接口,就该评估生成式模型的适配能力。
比较时先固定测试集和硬件条件,设好任务质量门槛,再比较成本。生成模型还要尽量统一输出长度和解码设置,否则「更快」可能只是因为输出更短。
已有模型能完成任务时,通常先评估现成模型或适配方案,不必为了换一个架构重新预训练。架构只是选型依据之一,最终还是要由同一批真实样本上的质量和成本说话。
面试官继续追问,怎么答?
问:Decoder-only 能理解完整提示词吗?
它能利用提示词完成任务,末尾位置可以读取前面的完整前缀。但在标准因果注意力下,提示词中较早位置的表示不能读取后面的内容,这与 Encoder 的双向编码方式有区别。不能把「会理解」与「用了双向注意力」画等号。
问:把 BERT 接一个词表输出头,就能像 GPT 那样续写吗?
有词表输出头不等于具备同样的生成方式,BERT 的 MLM 本来就需要预测词表候选。其双向可见范围和填空训练目标,与逐步续写不同;要获得相应的自回归行为,还需要匹配的注意力约束和训练。
问:Self-Attention 和 Cross-Attention 怎么区分?
看信息来源。自注意力的 Q、K、V 来自同一条序列的表示;交叉注意力的 Q 来自目标侧,K、V 来自另一条序列。有没有掩码是另一个问题,不能用它来区分这两种注意力。
问:Encoder-Decoder 的 Decoder 能看到全部原文,会不会泄漏答案?
原文本来就是条件输入,读取完整原文符合任务设定。需要防止偷看的是未来目标 Token;训练时即使完整译文已知,Decoder 的目标侧自注意力仍要遵守因果掩码。
最后建议大家重新看一遍三张图:指出每条连线从哪条序列来、哪些位置被遮住、下一枚 Token 在哪里产生。能讲清这三件事,BERT、GPT、T5 就不只是三个要背的名字了。如果还有疑问,也可以来云栈社区和开发者们一起讨论。
 发表于 前天 06:21
|
查看: 12|
回复: 0


