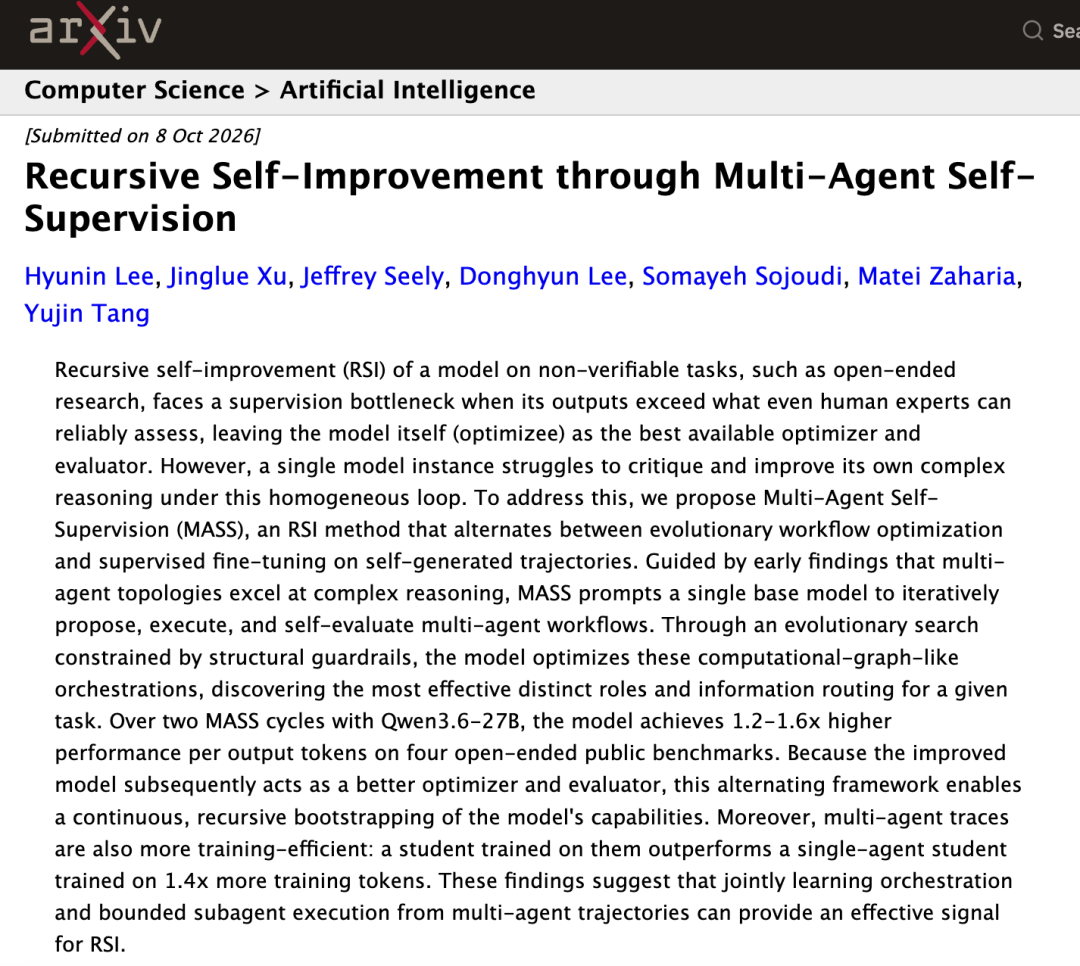
由 Transformer 奠基论文核心作者 Llion Jones 创办的 Sakana AI,这次联手 UC Berkeley 带来了递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。
他们让同一个开源模型自己“分身组队”,类似《火影忍者》里的漩涡鸣人那样,自己学会给分身派活、挑毛病、做训练,最后再把所有经验灌回本体,让下一轮自己更能打。
跑完两轮自我进化后,模型在多项开放式科研任务中的输出 Token 效率直接提升了 1.2~1.6 倍,自我评估准确率也从 73% 一路涨到了 93%。
不愧是 Transformer 作者联合创办的公司,连“自己卷自己”都卷出了新花样,而且不烧心。
这项研究还说明了一件事:想要实现 RSI,未必需要依赖更强大的人类训练师,也不需要更大体量的导师模型。
AI 自己分身组队,就能在内部把自己卷上天。
一个模型分饰三角,自己给自己搭班子
模型自己教自己,最头疼的问题是什么?
同质化盲区。
如果让单个模型自己写答案、自己打分、自己改错,它很容易在自己的偏见里打转。毕竟它原本就不知道错在哪里,所谓的自我反思,常常只是把错误答案换个语气再强化一遍。
为了打破这个死循环,研究团队搬出了明斯基在《心智社会》里的经典构想:把一个复杂智能体拆成多个简单组件的协作系统。
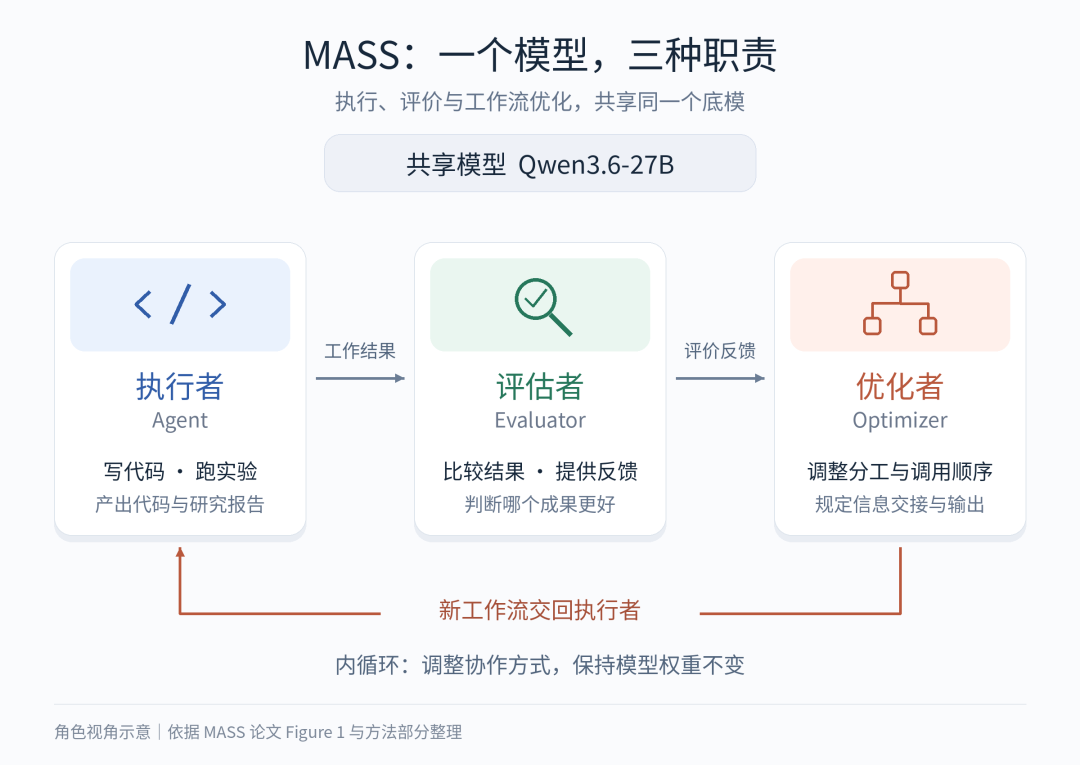
在 MASS 框架里,研究团队基于 Qwen3.6-27B,让同一个模型同时扮演三个角色:
- 执行者(Agent):负责老老实实写代码、跑实验。
- 评估者(Evaluator):对执行者产出的工作结果进行横向打分和挑刺。
- 优化者(Optimizer):根据评估者的反馈,动态调整团队里各个分身的角色分工、调用顺序和信息交接规则。
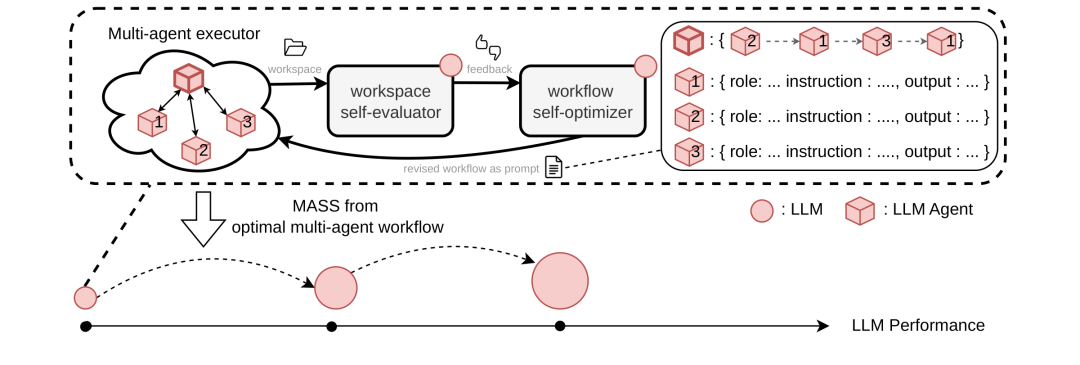
整个训练被切成了内圈和外圈两个循环。
内循环 在模型权重完全固定的状态下进行。优化者不断调整由纯文本定义的多智能体工作流,规定谁向谁汇报、每个子节点要交付什么输出契约。
评估者则负责在旁边当裁判,一路优胜劣汰,筛选出当前版本最擅长搞科研的黄金工作流。
外循环 则是把这套黄金工作流跑出来的优秀多智能体协作轨迹收集起来,对模型底模做一次监督微调(SFT)。
把这套分身协作的本领内化进模型权重后,新一代模型出炉,立刻无缝接管执行者、评估者和优化者三个角色,接着开启下一轮套娃。
卷完两轮,效率飙升但偏科严重
自己跟自己组队卷了两轮,效果到底怎么样?
研究团队把模型拉到了金融、机器人、制药等长程研究任务,以及多个公开基准里遛了一圈,数据相当惊艳。
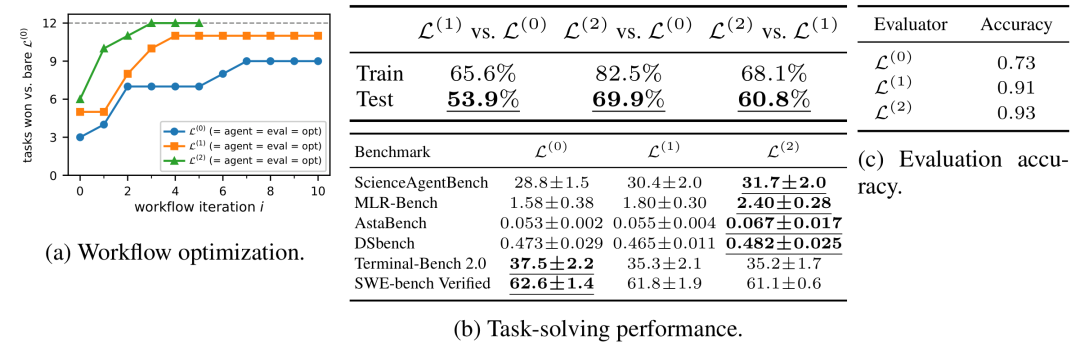
在三个测试任务里,第二代模型面对初始基模的胜率,从第一代的 53.9% 直接冲到了 69.9%。
在 ScienceAgentBench、MLR-Bench、DSBench、AstaBench 四个开放式研究基准上,第二代模型每输出一个 Token 带来的得分提升了 1.2~1.6 倍。
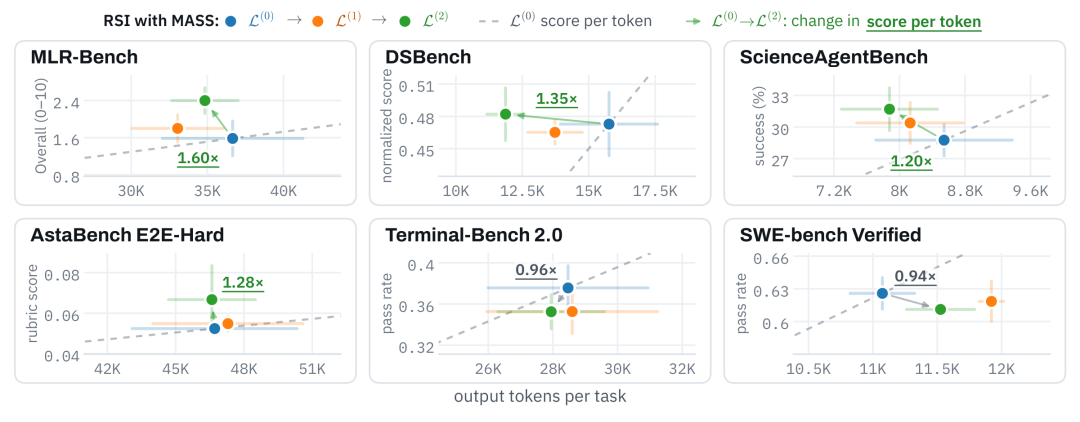
这说明它干科研不再像以前那样车轱辘话连篇,而是学会了直奔主题。
更神的是自评能力的迁移。
微调过程只用了任务求解的轨迹数据,根本没专门训练模型的裁判能力。但第二代模型的自我评估准确率,却从初始模型的 73% 一路蹿到了 93%,找高质量工作流的速度也明显变快了。
不过研究团队并没有把成果吹上天,而是直接在论文里交代了局限:
- 他们只验证了两轮循环。 到底能套娃迭代多少代而不发生模型崩溃,目前还是未知数。
- 偏科现象很明显。 在开放式科研和数据分析上进步神速,但在 SWE-bench Verified 和 Terminal-Bench 2.0 这类硬核软件工程与终端基准测试中,成绩并没有同步改善。
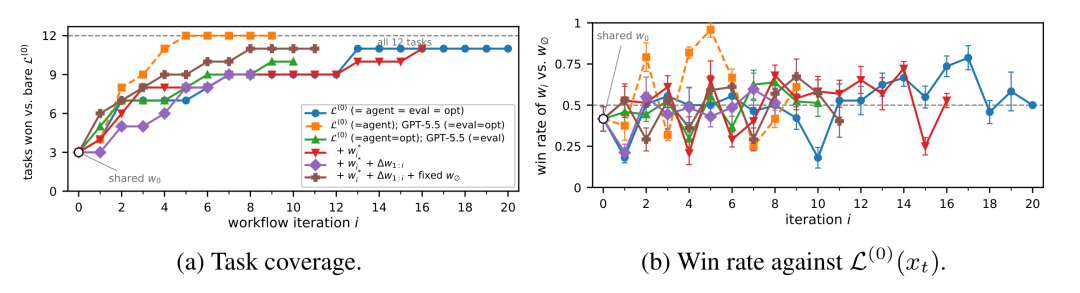
- 工作流搜索容易翻车。 优化器改动工作流时偶发性能暴跌,文本上微调几个词,结果却可能天差地别。
这么看来,当前制约 RSI 进化速度的核心瓶颈,依然卡在优化器本身的生成水平上。
为什么多智能体轨迹能打赢单智能体?
多智能体的数据,凭什么就能比单智能体强?
为了摸清底细,研究人员做了一组对比实验。他们用不同的轨迹数据去微调同一个 Qwen3.6-27B 底模,结果有点“恐怖”:
- 喂给模型多智能体轨迹(M+),消耗了 28.82M 训练 Token,对基模的胜率达到 68.3%。
- 喂给模型单智能体轨迹(S++),足足灌了 42M 训练 Token(多用了约 1.4 倍数据),胜率却只有 64.0%。
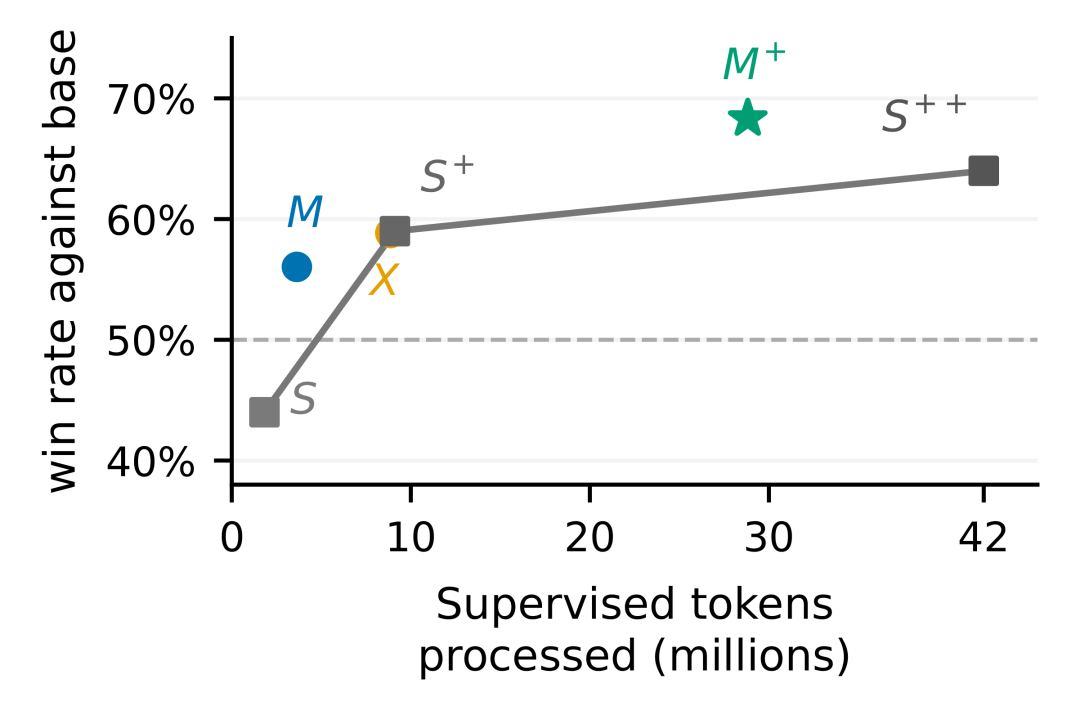
少用了 31.4% 的 Token,多智能体数据训练出来的模型依然把单智能体按在地上打。
为什么会出现这种降维打击?
秘密或许在于任务的认知解耦。
在单智能体轨迹里,模型既要想宏观架构,又要抠具体代码,长程上下文混在一起极难学习。而在多智能体协作里,总指挥只管拆解任务和核对产出,子智能体只管在局部边界里写代码。两类轨迹共同更新同一个权重,模型同时掌握了宏观调度和局部攻坚两种本领。
更关键的是,微调后的模型真正把这种协作直觉内化了。
在完全不给工作流提示词的“裸奔”状态下,初始模型自主发起子任务调用的概率只有 1/110,而第二代模型直接暴涨到了 87/110;跨子智能体的代码交接行为也从 1/110 飙升到了 83/110。
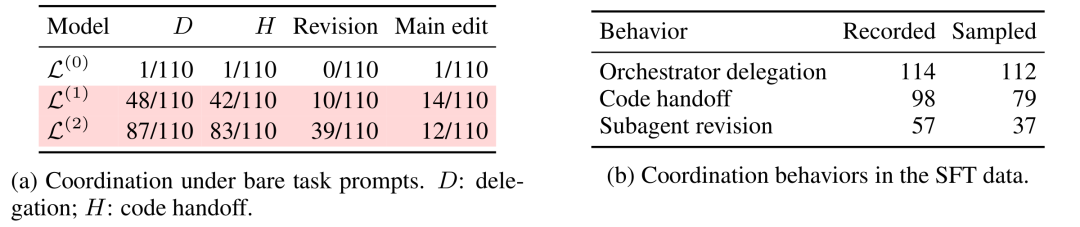
它不再需要人类在 Prompt 里苦口婆心地教怎么分工,自己提笔就知道该叫分身出来干活了。
搞出这项研究的 Sakana AI,在业界一直是个画风独特的物种。2023 年成立于东京,名字在日语里就是“鱼”的意思。
比起硬堆算力和暴力美学,他们更痴迷于从自然界、生物演化和复杂系统里找灵感,专门研究进化算法、模型融合和自主智能体。
而这份独特的学术基因,很大程度上源自豪华创始团队:
Sakana AI 联合创始人兼 CTO Llion Jones,前谷歌老将,是改变整个 AI 时代历史的 Transformer 奠基论文《Attention Is All You Need》八位核心作者之一。
△ Llion Jones
离开谷歌创办 Sakana AI 后,他带领团队持续探索超越传统前馈训练的新范式。
CEO David Ha 曾领导 Google Brain 东京研究团队,是进化算法与创意 AI 领域的全球顶尖专家。
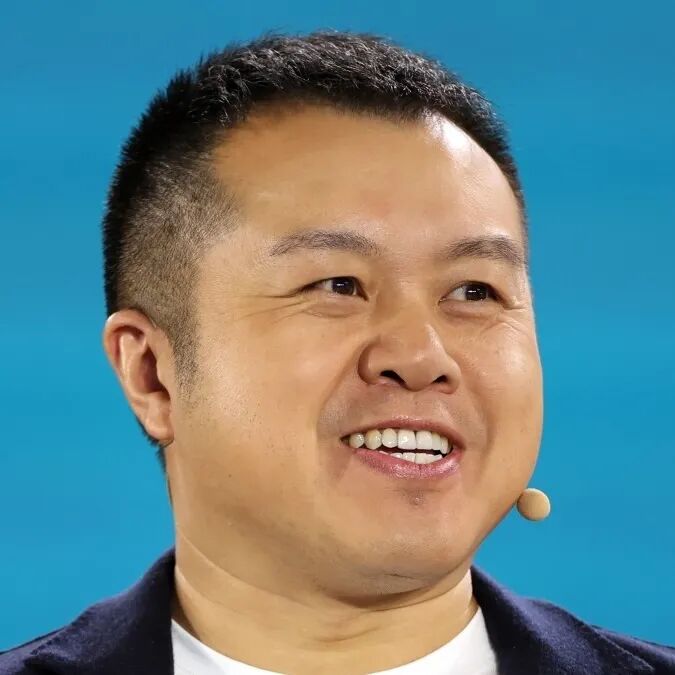
△ David Ha
除了创始人带来的 Transformer 正统底蕴与进化计算基因,这篇论文的具体作者阵容同样堪称“全明星”,深度融合了 Sakana AI 与 UC Berkeley 的顶尖科研力量。
篇幅有限,只提两位。
论文一作 Hyunin Lee,是加州大学伯克利分校机械工程系博士候选人,也曾以最高荣誉毕业于韩国首尔大学,先后在 OpenAI 和 Meta 担任研究实习生,拥有顶尖工业界与前沿学术界的复合背景。
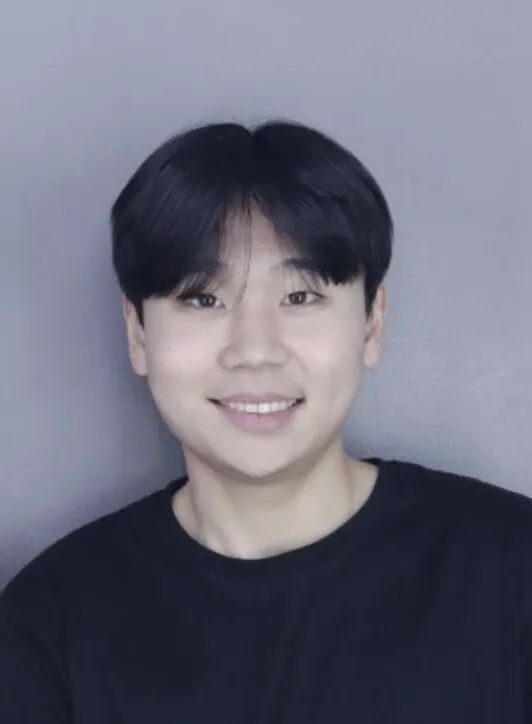
△ Hyunin Lee
另一位是 Matei Zaharia,伯克利 EECS 副教授,Databricks 联合创始人兼 CTO,也是 Apache Spark 项目的发起人。
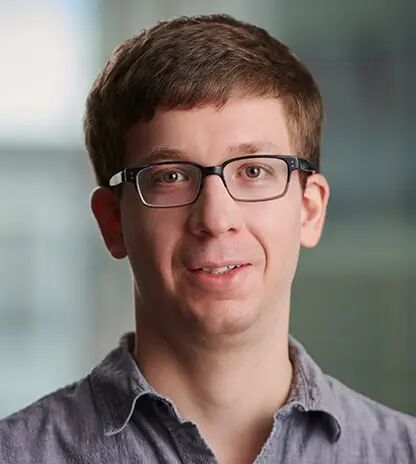
△ Matei Zaharia
真是大神齐聚,amazing。
参考链接:
 发表于 11 小时前
|
查看: 1|
回复: 0


