同一个问题,向 DeepSeek 问两次,只是多敲了几个空格,答案却一个像“天才”,一个像“智障”。
9月底,字节团队的最新论文 《Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression》,直接把 DeepSeek V4 系列模型的“神鬼二象性”问题摆上了台面。
图注:论文链接 https://arxiv.org/pdf/2609.36322
本质上看,这是底层算法“偷懒”引发的周期性失忆。分块 KV Cache 压缩技术把长上下文切块压缩处理,随之带来一个棘手的现象:“位置决定命运”。一旦核心词落在切块交界的“信息盲区”里,模型就只能胡言乱语。
设想一下:让大模型审阅几十页合同,关键条款恰好卡在信息盲区,模型直接无视这条条款,给出完全相反的结论。而你只是不小心多加了几个空白字符,模型就翻了车,整个过程你还被蒙在鼓里。
更要命的是,这种“神鬼二象性”并非 DeepSeek 一家独有。在当下这个高喊“把长文本成本打下来”的时代,只要采用分块压缩或稀疏化技术的模型,或多或少都逃不掉类似问题,比如开源的 Llama 3 系列。
01 字节论文抓住 DeepSeek 小辫子
字节最初的发现,源于一个让 DeepSeek-V4-Flash-Base 补全代码的实验。
任务是补全一段 FP8 量化函数的最后一个 Token。按照代码逻辑,正确结果应该是 8。但因为研究人员在代码最前面加了一串纯装饰用的等号,模型输出变成了 32。
更蹊跷的是,这种错误不是随机的,而是和等号数量直接挂钩:
当等号数量除以 4,如果余数是 0 或 1,模型大概率答错,错误率高达 71.3%;如果余数是 2 或 3,模型又能答对,正确率高达 91.5%。
字节团队顺藤摸瓜,发现这是大模型采用分块压缩机制后留下的先天短板。
分块 KV Cache 压缩技术是 DeepSeek 用来解决长上下文显存压力的杀手锏。它把连续的 Token 按固定长度切割,每一段里的 Token 再通过一个可学习的门控层压缩成“小摘要”,长上下文的显存压力确实一下子减轻了。
显存问题解决了,新问题却随之而来。
标准 Transformer 的注意力只依赖 Token 之间的相对距离,不关心绝对位置。一句话无论放在哪里,只要词序不变,语义就不变。
但 DeepSeek 采用分块 KV Cache 压缩之后,每个 Token 在压缩段中的位置就变得至关重要,这个位置被称为“相位”。门控层会给不同位置的 Token 分配不同权重,这个权重叫槽位增益因子。
排到强势槽位的 Token 会被加权保留,模型能精准作答;落入盲点槽位的 Token 几乎被忽略,模型就会出错。这种对排位极其敏感的现象,就是相位敏感性。
进一步解剖模型内部,研究人员还发现注意力头形成了自然分工——有的专门处理段内靠前的位置,有的专门处理靠后的位置。正是这种相位专门化,让某些排位成了薄弱环节。
为了验证这不是巧合,字节团队又做了一次“大海捞针”测试。
研究人员构造了一段长达 128K Token 的上下文,里面包含约 1.6 万个键值对,每个 Key 都对应一个 Value。在键值关系不变、问题不变、上下文总长度也保持一致的前提下,如果把其中一个键值对放到不同的位置,模型还能正确回答出对应的 Value 吗?
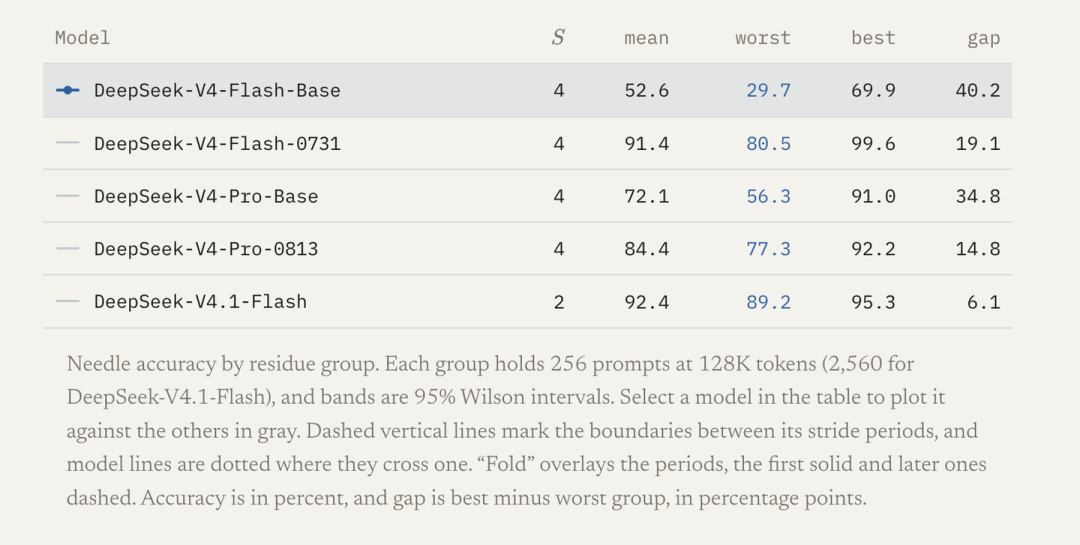
结果令人意外:DeepSeek-V4-Flash-Base 在不同位置之间的准确率最大差距达到 40.2%。换成 DeepSeek-V4-Pro-Base,差距仍有 34.8%。即便经过后训练优化,问题依然存在,差距分别维持在 19.1% 和 14.8%。
面对这种周期性盲区,DeepSeek 在 DeepSeek-V4.1-Flash 上做了一个关键调整:直接把压缩步长砍半。
压缩步长设为 4 时,每一轮压缩会划分出 4 个槽位,不同槽位分配到的信息权重差距很大。处在边缘位置的 Token,很容易在连续两轮窗口压缩中被无情丢弃。
把步长降到 2 之后,压缩变得更加精细,每次只合并 2 个 Token。一个压缩周期内,Token 仅有两种相对位置。哪怕关键信息落在偏弱的奇数位置,因为相邻位置只差 1 个 Token,上下文也很难被完全丢掉。
DeepSeek-V4.1-Flash 确实把准确率差距进一步收窄到 6.1%,但问题并没有被彻底根除。
于是,字节团队用 Qwen3-0.6B 架构从头训练了一批模型,其他所有配置完全一致,只改压缩机制。结果发现:
- 所有采用分块压缩的模型,都出现了周期性准确率波动;全注意力基线模型则完全没有这种现象。
- 波动周期严格等于压缩步长。
- 去掉 RoPE 位置编码,波动依然存在,说明这不是位置编码带来的偏差。
- 把可学习的门控权重换成最简单的平均分配,照样出现周期波动,证明不是参数没调好。
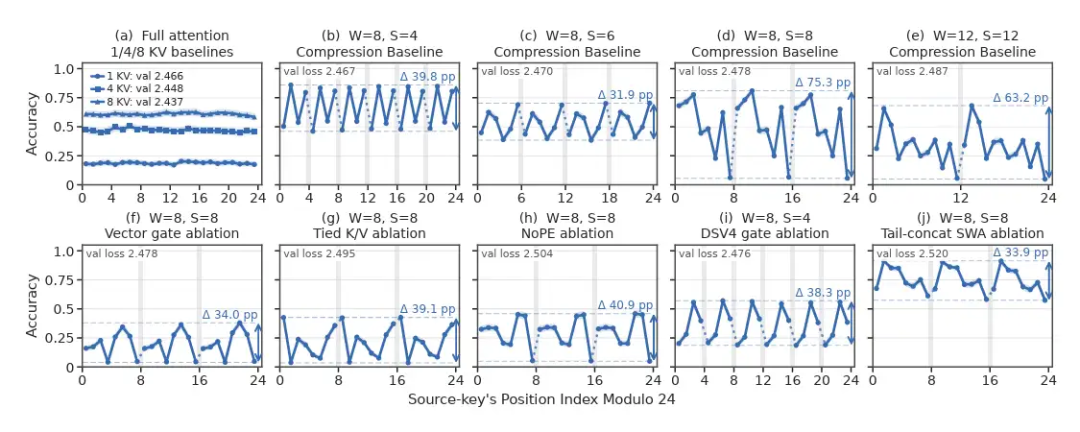
图注:把压缩步长分别设为 4、6、8、12,准确率波动的周期同样是 4、6、8、12。
也就是说,只要按固定长度做分块压缩,这个问题就无法回避。 这是方案本身的结构性缺陷,不是调参、换位置编码或后训练能根治的。
有网友指出,想要彻底解决这个问题,得让切块本身“活”起来,根据内容的重要程度动态决定边界。当 Token 不再拥有固定的相位,相位差自然也就无从谈起。
这在 AI 领域确实已有相关研究,被称为“动态分块”。
02 “动态分块”技术是解药吗?
动态分块的核心,是抛弃按固定 Token 数量一刀切的模式,转而根据语义和重要性灵活调整。
这条技术路线,对从算法数学、显存管理到底层硬件的完整技术栈,进行了一次自上而下的重构。
▎第一层:重构注意力的数学基础
动态分块到底该怎么切?核心是“大小跟着内容走”。信息密度低的冗余内容,直接大块合并;遇到关键转折和高密度信息,就拆分得足够细,精准计算。这样一来,无论关键信息藏在哪个位置,模型都能敏锐捕捉——这在数学上重构了被固定分块打破的平移不变性。
更进一步,这赋予了模型一种“预判能力”:先扫一眼信息密度,再决定切多大。推理过程不再是一个节奏读到底,而是该快读的地方快,该细品的地方慢,在架构底层长出了“快慢思考”的本能。
▎第二层:倒逼显存管理的演进
以前为了让矩阵算得快,KV Cache 都按固定大小的块来管理。这种方式简单、规整、好操作,但显存利用率上不去,算力容易被白白浪费。
动态分块之后,底层传统的“静态连续矩阵”撑不住了,必然要向“拓扑稀疏矩阵”演进,靠一层动态索引来完成寻址。
更妙的是,研究发现不同 Transformer 层之间的动态分块边界高度相似,可以直接复用。这就大幅摊薄了动态寻址的开销。
最终,上层切得聪明,底层存得更省,中间寻址还不慢。
▎第三层:破解硬件对齐的难题
这也是三层中最难突破的一层。GPU 天然偏好规整、边长能被 8、16、32 整除的矩阵运算,这也是整个行业此前长期坚持固定分块最现实的硬件原因。如果分块大小参差不齐,专为矩阵计算打造的加速单元(如 Tensor Core)会大量空转。
针对这一问题,业界已经摸索出了可行的解法。比如,零填充算法既能在物理显存层面,把长短不一的动态语义块紧密拼在一起、不浪费空间,又能在逻辑上保留每个语义块的边界。
目前,全球顶级 AI 实验室正从“语义连续性”和“稀疏计算”两个方向推进动态分块技术,它已经成为新一代长文本大模型提速、提质的核心突破口。其中最具代表性的成果是香港科技大学(广州)团队提出的 ChunkKV,它走的是“语义连续性”的路线。
过往,主流 KV 压缩方法——无论是 H2O、SnapKV 还是 PyramidKV——核心思路都是给单个 Token 打分,保留重要的、丢弃不重要的。这种筛选很容易把一句完整的主谓宾拆得支离破碎。
ChunkKV 的思路则完全不同:以连续的语义块为基本压缩单位,要么整块保留,要么整块丢弃。留下来的都是完整的短语和句子。
在最考验长文本检索能力的 NIAH(大海捞针)基准测试中,当 KV 缓存大小限制在 128 时,基于 LLaMA-3 的 ChunkKV 准确率达到 73.8%,而传统方法 SnapKV 只有 58.9%。这项技术直接补齐了大模型在长文本场景下“读不懂、找不准”的短板。
除了 ChunkKV,Jina AI 肖涵博士团队聚焦检索场景优化,提出了延迟分块方案,解决了传统智能检索“先切分文本、再解析内容”的致命缺陷——让模型先完整读完整篇文本,吃透全局内容和上下文逻辑,直到最后输出结果前,再按照语义自然分界切分文本,最大程度保留完整信息。
在“稀疏计算”方向,微软亚洲研究院研发的 MInference 框架,专门适配百万字级别的超长文本推理场景。
团队研究发现,大模型读取长文本时,并不是每一处内容都需要精细计算,注意力矩阵存在可利用的固定稀疏规律。基于这个特点,这套框架会为不同注意力头匹配最合适的稀疏计算方式。在完全不降低检索准确率的前提下,百万字长上下文的 prefill 预填充阶段最高可实现 10 倍加速。
在长上下文竞赛的上半场,大家为了比“谁能处理更长”,KV 压缩技术功不可没。但长上下文的本质,从来不是为了长而长。当用户开始真正用长上下文处理真实任务时,能用、好用、不丢信息,就成了新的 KPI。
参考链接:
 发表于 13 小时前
|
查看: 3|
回复: 0


