2025 年春节前后,DeepSeek R1 横空出世,相关热度持续攀升,带动 DeepSeek 一体机迅速走红。所谓大模型一体机,就是集成了 AI 加速硬件(GPU / 国产 AI 加速卡)、服务器硬件、推理框架、大模型权重以及配套运维与应用平台的一体化设备,主打开箱即用,面向政府、企业和科研机构完成本地私有化大模型部署,省去自行组装服务器、适配框架、调试模型等复杂环节。
DeepSeek 一体机可在单机环境下完成 671B 满血版大模型的部署,一时间,各地机构、企事业单位与中小企业纷纷采购,市场热度高涨。然而,随着市场变化和模型进化,大模型一体机市场也出现了深刻变革。
01 饱受争议的 DeepSeek 一体机
2025 年春节前后,DeepSeek R1 带动了 60 多家厂商推出 DeepSeek 一体机,但随之而来的争论也不断:到底该不该部署?一台满血版一体机往往要卖到上百万,财务支出巨大;而如果直接调用云端大模型,同等预算可能几百年也用不完。加上大模型持续迭代、参数量不断膨胀,单机硬件的算力上限逐步显现。
仅仅三个月,市场便迎来降温。行业逐渐形成一种共识:DeepSeek 有用,但 DeepSeek 一体机真没用。原因很直接——标准 DeepSeek 一体机至少需要搭载 8 张 GPU,受限于单机架构,无法享受集群部署的规模效应,综合使用成本居高不下。更关键的是,早期不少一体机本质只是硬件打包,软件层面优化不足,仅完成模型简单安装部署。虽然标称支持 671B 大模型运行,实际并发能力却很差,多用户同时访问极易卡顿。部分厂商重硬件交付、轻后续运维,设备交付后缺少模型持续更新服务,用户往往还要投入额外人力进行二次改造,结果就是硬件到位了,业务却跑不起来。
满血版一体机普遍标价 120 万到 150 万,用国产卡因单台显存不够,往往要两台并联,预算直逼 400 万。到 2025 年下半年,“满血版卖不动了”已经不再是秘密,中小厂商的成单主力悄悄换成了 32B 和 70B 的中小模型。
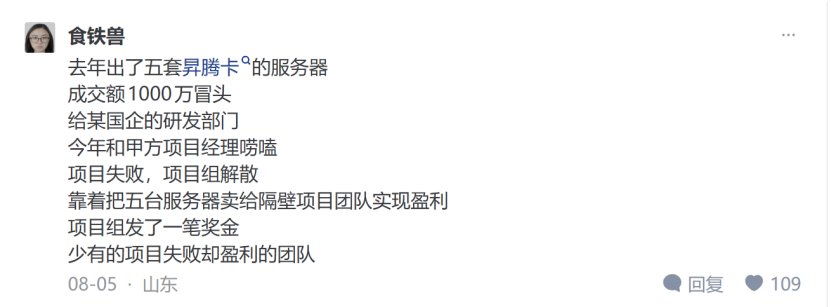
时间来到 2026 年,市场环境再度变化。内存、存储(SSD、机械硬盘等)、GPU 芯片相继涨价。从资产角度看,2025 年初购入的一体机,如今二手处置甚至可以收回全部采购成本,还能实现盈利。有网友透露,公司去年出了五套昇腾卡服务器给某国企研发部门,成交额 1000 万冒头;今年和甲方项目经理聊起,项目失败、项目组解散,但靠着把五台服务器转卖给隔壁项目团队反而实现了盈利,项目组还发了一笔奖金,成了少见的“项目失败却盈利”的团队。
不过需要客观看待硬件增值现象。账面升值并不等于适合当下新项目采购。二手一体机普遍面临保修失效、固件驱动兼容性、功耗过高等现实问题;老旧硬件架构想要跑通 DeepSeek V4.1 Flash 这类新一代 MoE 模型,还需要完成推理框架改造,并非拿到设备即可直接满血运行,这也抑制了机构大规模囤积二手设备的意愿。
02 大模型一体机集体“缩水”
今年的行业风向已经转变,市场不再追捧能跑 671B 满血大模型的一体机,AI BOX 这类轻量化本地部署设备开始兴起。相比去年的满血高端一体机,今年市面一体机的硬件配置、可承载模型参数量均明显下调,多数中端设备最多只能运行 70B 级别模型。
缩水的原因并不复杂。一是需求端在挤泡沫:大量实践证明,绝大部分用户需要的多是知识库问答、公文写作这类场景,依靠蒸馏小模型已经够用,671B 的能力大部分时间属于过剩。二是模型端的能力密度在提升:MoE稀疏激活、蒸馏、量化等技术成熟,达到同样效果所需的参数量大幅变小。三是高端芯片供给受限:2025 年 4 月 H20 芯片被无限期停售,彼时国产加速卡虽然经过迭代在显存和吞吐性能上有提升,但单卡依然跑不动超大 MoE 模型;要满血运行还需多台设备并联,除采购成本外,多卡并联还带来调试复杂、软件生态适配工作量大等麻烦。四是内存涨价,本地部署满血版的成本上涨过高,性价比不足。
整个一体机市场由此劈成两半:轻量化缩水版主打走量,撑起市场出货大盘;满血高端一体机依然存在,但采购群体高度集中于有强合规要求的央国企、金融机构,高端机型整体出货量大幅下滑。
03 内存、Token 涨价,Agent 爆火
在一体机普遍轻量化的当下,高端一体机是否还有市场价值?实际上,特定场景下仍然存在需求。
首先是复杂生产场景,小模型能力有明显短板。 Agent 长链路任务、Vibe Coding 工程级代码开发、AI 专业视频生成,这三类当前增长最快的 AI 应用,对模型的推理深度、逻辑链条、多模态理解能力要求极高。要稳定支撑这类生产级任务,必须部署满血版大模型。也正因如此,高端一体机并没有因轻量化产品流行而消失,反而在生产环节的价值更加凸显。
其次,云端调用成本飙升,本地部署性价比开始凸显。 随着 Token 价格上涨,叠加海量多模态生成消耗,大规模使用云端大模型的成本快速攀升。Vibe Coding 需要反复迭代、大量生成调试;AI 视频生成更是按秒计费,单条视频成本可达数元至数十元。业务量上来之后,云端订阅费用相当惊人,年投入很容易突破百万级别,本地部署大模型的成本优势重新显现。与此同时,数据安全的重要性愈发突出——海外曾曝出公开用户数据的安全事件,海外闭源 AI 产品也开始嵌入隐形水印等机制,企业与机构对数据本地化的诉求持续增强。
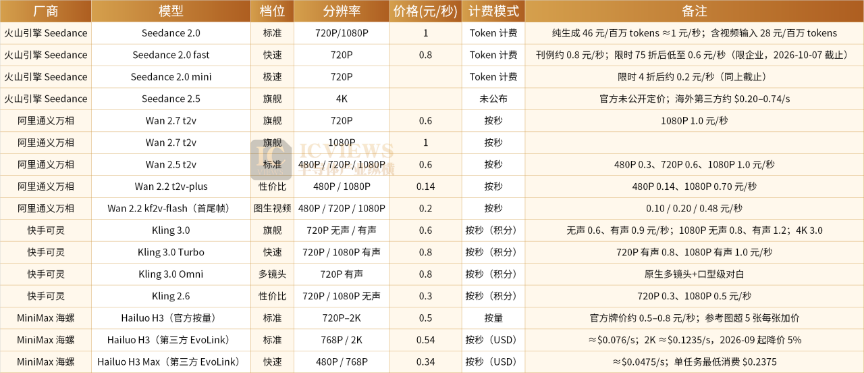
最后,Agent 普及推高本地部署利用率。 过去一体机最被诟病的一点就是利用率不足,百万级设备大部分时间闲置。Agent 的流行让一体机可以连续工作,理论上大幅拉高设备利用率。通过工作流编排与业务系统深度对接,一体机可以承载持续运转的 Agent 任务,实现 7×24 小时不间断推理。
04 开源模型更新,一体机迎来能力升级拐点
真正的行业转折点来自新一代模型迭代。Kimi K3 虽然性能出众,但参数量庞大,很难在一体机硬件上落地部署。而新模型的出现改变了这一局面。
首先是 DeepSeek V4.1 Flash 正式发布。 它以接近 Pro 版本的能力,提供 Flash 档位的使用成本。根据官方介绍,V4.1 Flash 在性能、开销、推理速度、任务总耗时等多项指标上全面超越 V4 Pro。该模型采用全新架构,原生支持视觉理解,承接上一代 Pro 模型的定位。尤为关键的是,V4.1 Flash 基于 CausalEncoderDecoder(因果编码器解码器)架构打造,总参数量 552B 的 MoE 混合专家模型。
552B 的模型大小小于 DeepSeek R1 满血版 671B 的参数规模,这意味着去年花 150 万买的满血一体机,不用加一张卡就能原地升级。能力更强、上下文更长、模型反而没变大;而且模型与 Harness 框架联合训练,强化了长周期连续任务处理能力。
其次,MiniMax H3 开源模型快速走红。 MiniMax H3 是 MiniMax 发布的通用全模态生成模型,于 2026 年 7 月 31 日正式发布,8 月 3 日开源。其开源许可明确排除美国、欧盟、英国及韩国的使用权限。华为昇腾、摩尔线程、沐曦、海光信息、昆仑芯、天数智芯、壁仞科技、AMD、Intel 等国内外芯片厂商,以及 Hugging Face、魔搭 ModelScope、ComfyUI、RunningHub、fal 等社区和云推理平台,另有 vLLM-Omni、SGLang 等推理框架完成适配支持。该模型在 Artificial Analysis 榜单中视频编辑能力排名第一。
云端服务商的 AI 视频生成有多费钱无需赘述。H3 模型综合能力突出,让 AI 视频的本地生成成为现实,降低企业对商用云端视频生成服务的依赖。社区优化后,MiniMax H3 甚至可以在 9700x + 32G 内存 + 5070ti 的配置上运行,大概 5 分钟生成一个 5 秒视频;一体机优化后输出速度会更快。最近一条消息称,同样生成 5 秒、1344×768 的视频,在 4 张 RTX 6000D 上,原始 BF16 50 步方案耗时 348.8 秒(约 6 分钟);RunningHub H3 Lightning 完整加速之后只需要 28.7 秒,约 12 倍提速,生成耗时减少约 92%,仍保留 BF16 数值精度。RunningHub 已把整套方案在 GitHub 开源,开箱即用。在 8 张 RTX 6000D 环境下,让 H3 生成 15 秒、768×1344 的视频,纯文字生成约 48 秒,双参考图生成约 73 秒——一条 15 秒的图生视频,已经能进入“1 分钟出结果”的时间尺度。
05 总结
综合来看,去年上半年入手高端一体机的采购方,在本轮硬件涨价周期中收获了资产层面的收益。2026 年市场呈现两极分化:满血高端一体机硬件成本抬升、性价比有所下降,仅建议有刚性业务和合规隔离需求的机构采购。同时必须注意,一体机采购并非一劳永逸——除硬件采购预算外,机构还需持续承担机房供电散热、运维人力、模型版本迭代、推理框架调优、故障维护等隐性成本。不少单位只核算硬件支出而忽略后续运维开销,最终造成项目落地不及预期。
轻量化 AI BOX 类设备迎来普及,更适配具备本地保密诉求、AI 能力要求不高的业务场景。未来一体机行业不会简单走向“越做越小”,产品分层格局还会持续演化:一方面轻量 AI BOX 进一步下沉,覆盖更多边缘、部门级业务;另一方面随着国产芯片和 MoE 推理框架持续迭代成熟,高端满血一体机的综合成本存在下探空间。一体机赛道的竞争,不再比拼谁能部署最大参数量的模型,而是硬件、推理框架、模型适配、业务应用与运维服务整套方案的综合实力。
 发表于 11 小时前
|
查看: 2|
回复: 0


