昨晚 DeepSeek 发布了新模型 DeepSeek V4 Pro,过程虽然有些波折,但性能提升并不让人意外。真正让人眼前一亮的是同时推出的 DeepSeek Harness——这也是 DeepSeek 的第一个 Agent 产品。开源才一天,GitHub 上已经涨到 8 万多星,增速比当初 R1 开源时还猛。
不少人以为 DeepSeek Harness 是又一个 Codex 复刻品,但真跑起来就会发现,它和 Codex 这类工具的思路完全不一样。
简单说,Codex 更像一体机,模型、工具、循环、权限全都焊死在一起。想更换模型,只能用 Codex 支持的格式;想移除用不到的工具省点 token,也没有入口。DeepSeek Harness 则是组装机——模型是插件、工具是插件、会话是插件,连 Agent 循环等等,一切皆插件。
为了支撑这套设计,DeepSeek 还专门发了一篇 88 页论文,把插件装卸做成了一套有数学证明的形式化系统。这也是我第一次看到有人用数学证明来定义 Agent Harness 到底该怎么组装。
下面就从安装开始,带你一步步把它跑起来。
一行命令跑起来
首先,机器需要装 Node.js,版本要求 22.19 以上;没有的话,也可以让别的 Agent 帮你装。接着在命令行执行:
npx @deepseek-ai/dsh web
稍等片刻,终端会出现 dsh web: http://127.0.0.1:3080。用浏览器打开这个地址,就进入 DeepSeek Harness 的主界面了。
第一次使用前,它会提示你输入 API Key。先去 DeepSeek 开放平台(platform.deepseek.com)创建一个:
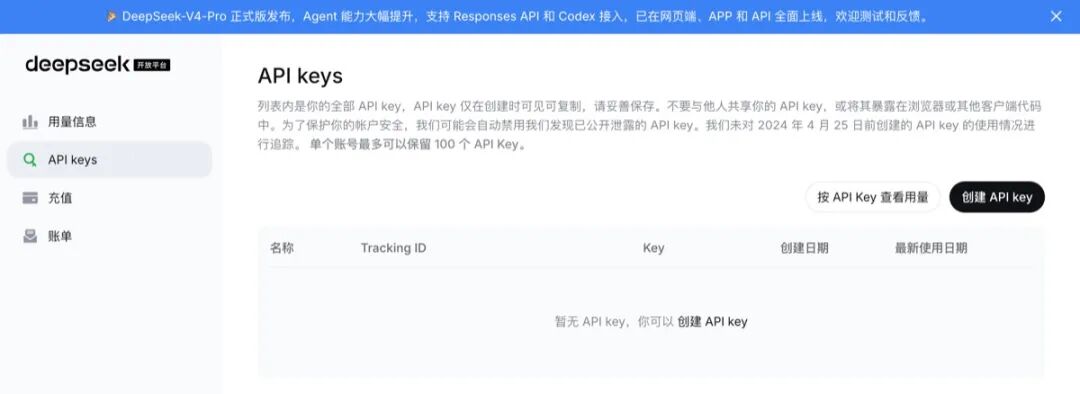
复制 API Key,回到 Harness 界面粘贴,就能看到下面的主界面:
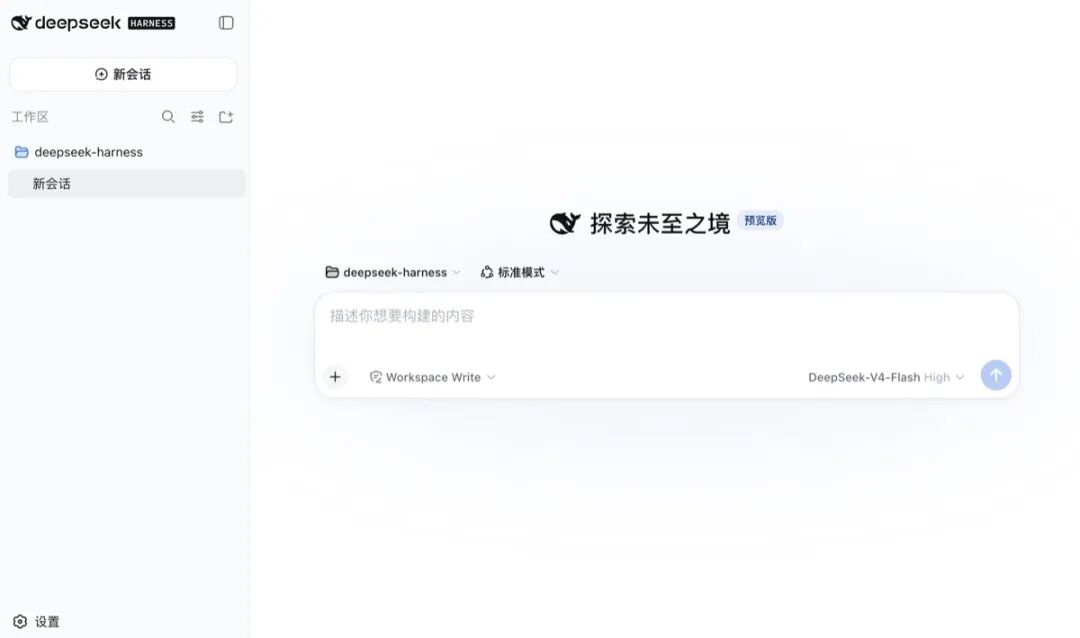
这时输入框还不可用。你需要先选择一个工作区,也就是要让 Agent 操作的项目目录;比如我直接选了 deepseek-harness 的源码目录,选好后输入框才解锁。
开始第一个任务
配好之后,我先试了个简单任务:让它总结自己的源码仓库。我发了一句“总结此代码库并识别其主要工作原理”,它读了 AGENTS.md,扫了 packages 目录,又翻了设计文档,一分钟左右就给出一份架构概览,核心包及各自职责列得很清楚。
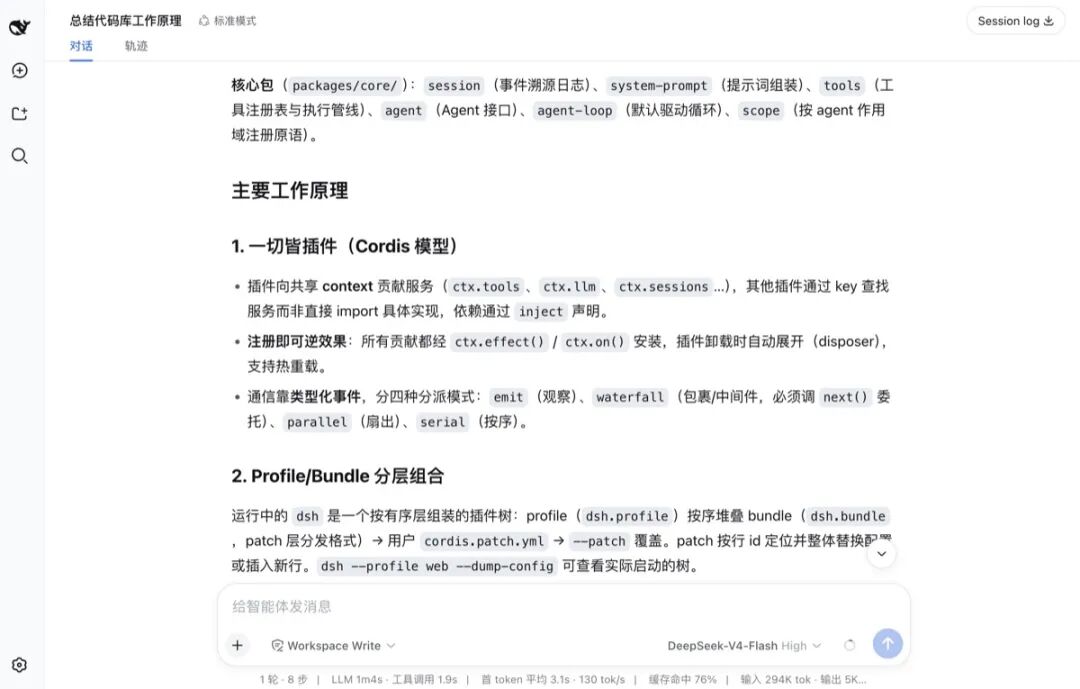
直观用下来,它和 Codex 的区别挺明显:
第一感受是快。用惯了 Codex 再切过来,对比非常明显:响应速度和工具调用周转都很快。这当然和 DeepSeek V4-Flash 本身的推理速度有关,但 Harness 端在开销控制上做得也不错。
另一个亮点是轨迹视图。点开“轨迹”标签页,能看到模型每一步看到了什么、调用了哪个工具、传了什么参数、返回了什么结果;连 system prompt 和 context 注入都能展开查看。
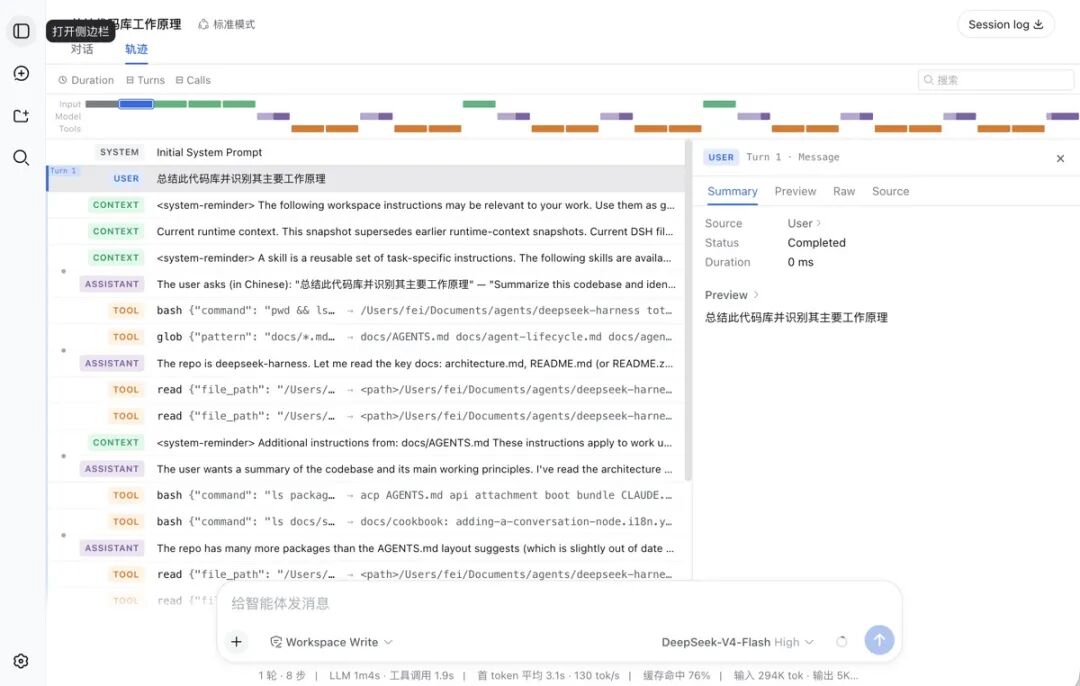
这些信息都记录在 append-only 的会话日志里,恢复、分叉、回放都从这份日志派生。这种“模型可见即已记录”的做法,在其他 Agent 工具里并不多见。
装备 Agent 预设
DeepSeek Harness 对 Agent 的灵活控制,集中体现在它的 Agent 预设功能。所谓 Agent 预设,就是一个会话的 Agent 实际运行的那组插件组装,包含工具、提示词和能力等。
打开设置里的“Agent 预设”,可以看到内置了四种预设:
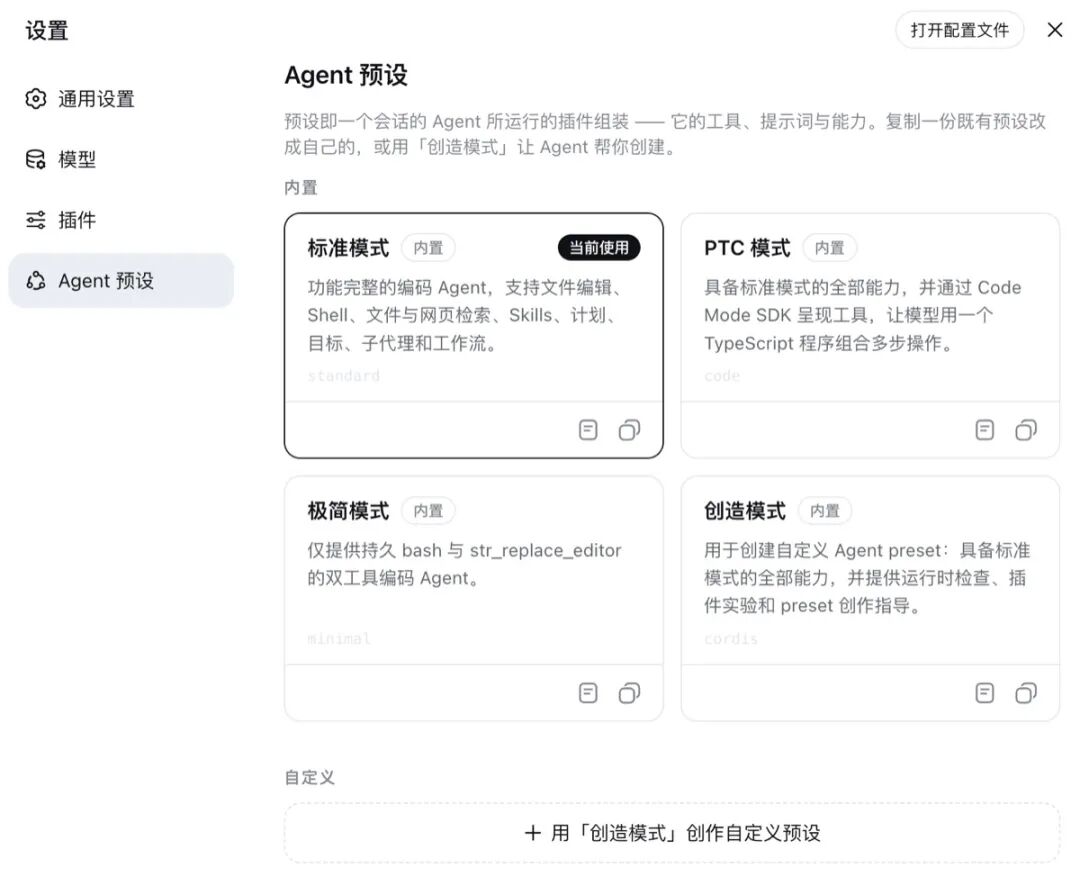
标准模式是日常默认项,工具组合最完整。PTC 模式让模型用 TypeScript 程序编排多步工具调用,思路跟 Claude Code 的 thinking tool use 类似。极简模式只保留 bash 和编辑器两个工具,适合基准测试。创造模式则在标准模式的基础上,多了自检、插件实验和预设创建能力,专门用来生成新的 Agent 预设。
这四种模式本身就在演示“一切皆插件”的核心思想:不同模式不过是不同的插件组合,你完全可以复制一份再改成自己的。
入门阶段,标准模式已经够用。等你玩熟练了,想针对特定场景或项目做定制,再切换到创造模式,让它帮你装备上特定的工具、Skill、知识库等私有配置。
一切皆插件
前面提到 DeepSeek Harness 是组装机,那它到底能组装哪些部分?翻源码发现,整个项目由 50 多个独立的 Cordis 插件组成,每个插件负责一个具体能力。插件之间没有核心与外围之分,官方原话是 “There is no privileged core to patch”——所有插件地位平等。
下面这张图展示了主要的服务插件,以及各自的可替换选项:
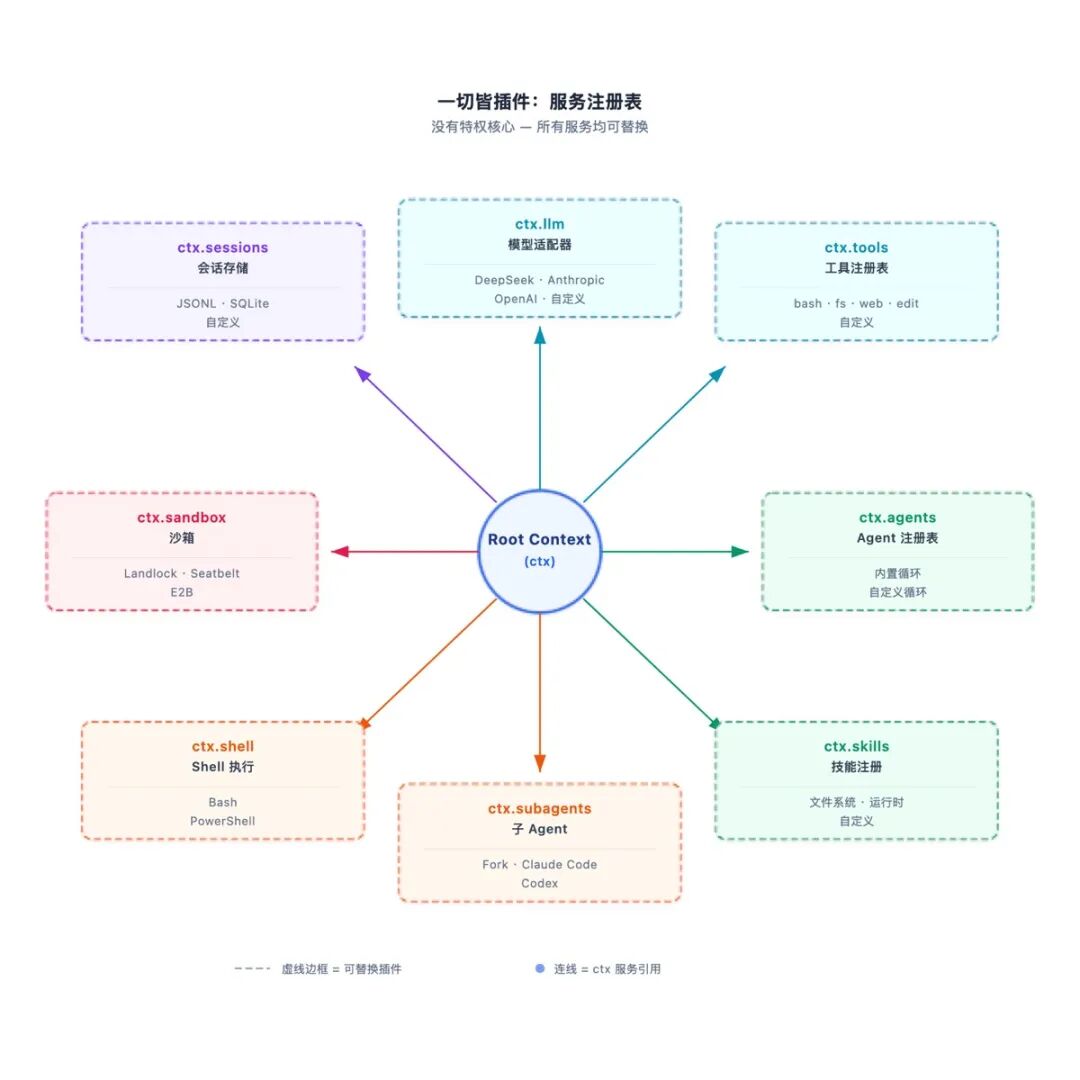
从图中可以看到,模型、工具、会话、沙箱、技能、子 Agent 这些能力全部挂在同一个 Root Context 下,而且每个都可替换。下面挑几个最实用的场景展开说:
- 换模型:在设置页添加自定义 OpenAI 兼容端点,指向公司网关或 vLLM,下一次请求直接生效,不用重启。
- 换沙箱:默认为本地沙箱(Linux Landlock / macOS sandbox-exec),代码里带有 E2B 云端沙箱适配器,换个配置就行。
- 删工具:Claude Code 每次都会把几十个工具 schema 塞进提示词里白吃 token;DSH 中每个工具是独立插件,在配置里禁用即可。
- 换 Agent 循环:这是它与现有 Agent 工具最大的不同。Claude Code 和 Codex 的 agent loop 都写死在运行时里,哪怕能在预留的 hook 点做定制,循环本身仍换不了。DSH 的 agent loop 只是一个普通插件,写个新的替换它就行。而且循环里的每个关键节点(模型请求前、工具执行前、轮次结束时)都是 waterfall 事件,写一个审批插件或日志插件,监听这些事件就能拦截和改写,完全不用碰循环代码本身。
说白了,其他 Agent 能做的 DSH 都能做;反过来,agent loop 本身可替换这件事,是其他 Agent 加再多 hook 也做不到的,因为这属于最底层的架构决策。
Cordis 运行时安全装卸
既然一切都是插件,就必须回答一个问题:插件在运行中装上、卸下,怎样才不会把其他插件搞挂?这正是 Cordis 框架要解决的核心问题。
对比一下,VSCode 也有插件系统,但每次卸载插件都要重启整个编辑器。Cordis 的目标则是让插件能随意热插拔,并且用数学证明来保证安全。
下图展示了 DeepSeek Harness 的分层架构,从上到下每一层都可以被上一层覆盖:
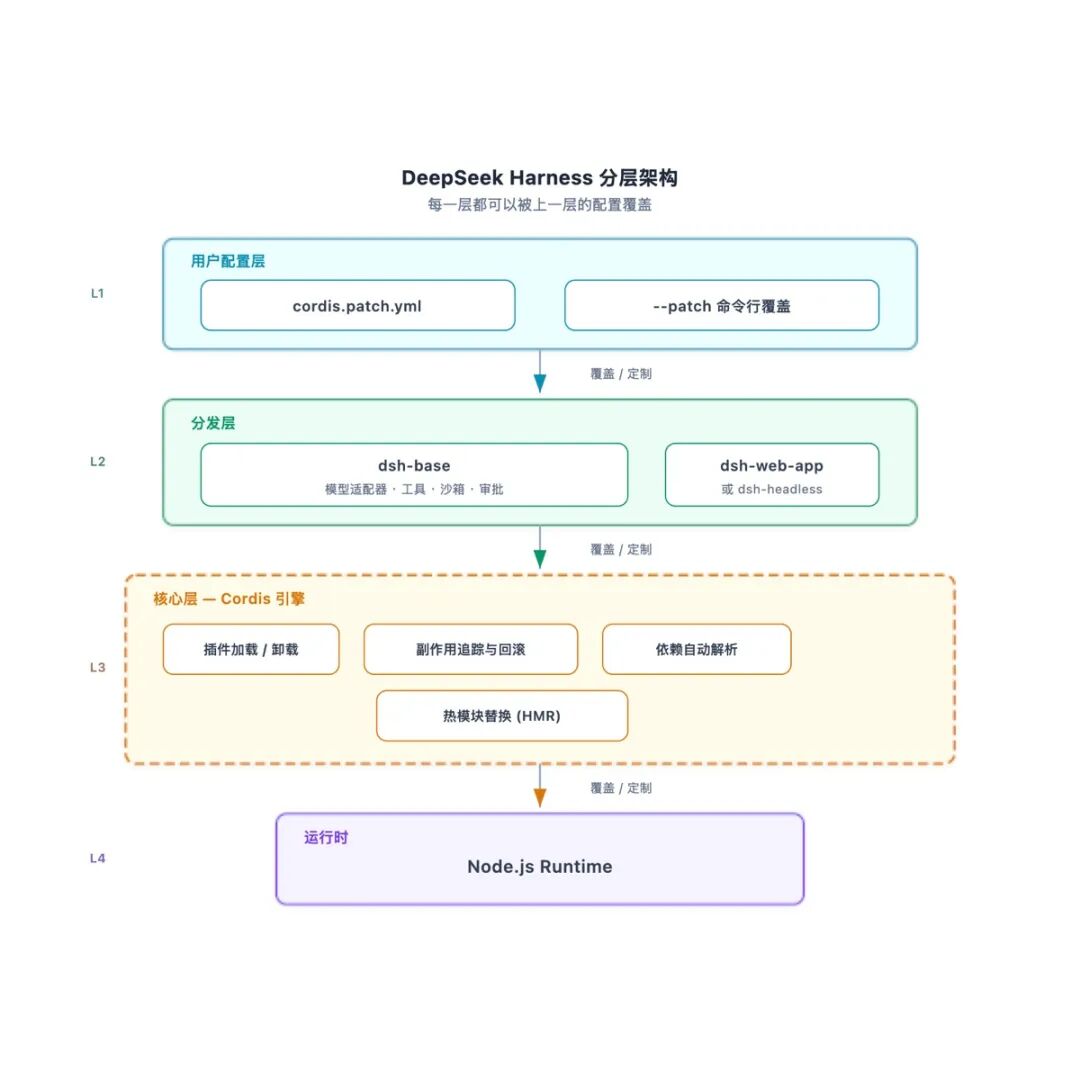
论文把安全装卸拆成两个维度来解决:
- 时间维度:插件卸载时所有副作用必须可撤销。每个注册的事件监听器、服务、工具 schema 都通过
ctx.effect() 安装,运行时追踪逆操作,卸载时反序执行。
- 空间维度:插件间依赖自动管理。通过
inject 声明需要哪些服务,框架等依赖就绪再激活。被依赖的服务卸了,依赖它的插件自动暂停。
有了这两个保证,你可以在 Agent 运行时换模型、加工具、改沙箱,既不会丢上下文,也不会丢会话。论文还证明了 confluence 定理:无论以什么顺序装卸插件,最终状态都等价于把最终配置从头加载一次。
还不够好的地方
DeepSeek Harness 刚开源一天,生态却已经相当热闹。内测阶段招募在 Twitter 上引发了一场开发者路演,最终 964 人报名、提交了 897 个项目。开源之后,awesome-deepseek-harness 这样的精选列表也迅速冒了出来。
有意思的是,翻 GitHub commit 历史能发现,不少代码是通过 Codex worktree 提交的。DeepSeek V4 原生支持 Responses API,可以无缝接入 Codex;团队直接拿竞争对手的工具来开发自家产品,确实挺务实。
目前官方暂不接受外部 PR,但可以通过 Discussion 反馈问题,也鼓励社区做独立插件来丰富生态。官方表态很有意思:“我们不认为官方仓库中的包,比社区创建的包更重要。”
不过问题也不少。当前 v0.1 仍处于开发者预览状态,后续大概率会有破坏兼容性的变更。安全方面,已经有研究者发现几个严重漏洞,比如 read-only 沙箱对读操作并不设防、动态插件的 vm 沙箱存在逃逸路径等;在实际使用时一定要留意这些问题。
写在最后
如果把 DeepSeek Harness 当成产品来看,它现在有没有 Codex 好用?UI 成熟吗?体验顺不顺畅?这些问题的答案,恐怕都还是“差得远”。
但 DeepSeek Harness 看重的,可能并不是当下的使用体验。模型能力仍在高速变化,Harness 的最佳范式还远未收敛;这时候过早押注一个封闭产品,等于用一家公司的判断去赌一个仍在移动的终局。DeepSeek 的做法是把门打开,尽量保留选择权,让社区去探索哪种组合更有效。
哪种上下文策略跑赢了,它就能成为默认插件;PTC 如果比传统工具调用更有效,就继续强化;未来模型强到不再需要复杂的多 Agent 编排,那些组件也随时可以卸掉。社区跑出来的问题、插件和经验,会不断暴露模型在真实任务中的短板——这些反馈既推动 Harness 迭代,也能告诉模型团队下一代该朝哪个方向训练。
你现在不必急着把全部任务都切过来,但可以考虑把中文写作、超长上下文任务,以及日常跑量较大的工作先丢给它试试;等后续版本稳定了,再逐步切换更多工作过来。
相关链接:
 发表于 13 小时前
|
查看: 3|
回复: 0


